Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Die Ausführung adaptiver Abfragen (Adaptive Query Execution, AQE) ist die Erneute Optimierung der Abfrage, die während der Abfrageausführung auftritt.
Bevor eine Abfrage ausgeführt wird, wählt der Optimierer einen Abfrageplan basierend auf Schätzungen der Datengröße. Diese Schätzungen könnten falsch sein, wenn Tabellenstatistiken fehlen oder veraltet sind, wenn die Daten verzerrt sind oder in späteren Schritten einer komplexen Abfrage. Ein Plan, der auf falschen Schätzungen basiert, könnte eine langsame Join-Strategie verwenden, nach einem Shuffle zu viele kleine Aufgaben erstellen oder einige übergroße Aufgaben erzeugen, die die ganze Stage aufhalten. AQE behebt diese Probleme, indem AQE den Plan während der Abfrage basierend auf der tatsächlichen Datengröße neu optimiert.
Am Ende jedes Shuffle- oder Broadcast-Austauschs bietet Azure Databricks genaue Statistiken für die bisher produzierten Daten. AQE verwendet diese Statistiken, um eine bessere physikalische Strategie zu wählen, eine optimale Anzahl und Größe von Post-Shuffle-Partitionen auszuwählen oder Optimierungen anzuwenden, die sonst Abfragehinweise erfordern, wie z. B. Skew Join Handling.
AQE ist standardmäßig aktiviert. Du musst deine Anfragen nicht ändern, um davon zu profitieren. Überprüfen Sie, ob AQE einen Abfrageplan geändert hat, wenn Sie eine langsame Abfrage beheben. Passen Sie die AQE-Einstellungen nur an, wenn die Standardeinstellungen nicht zu Ihrer Arbeitsbelastung passen. Siehe Abfragepläne und Konfiguration.
Fähigkeiten
AQE hat vier Hauptmerkmale:
- Dynamische Änderung von Sort-Merge-Join in Broadcast-Hash-Join.
- Dynamische Zusammenführung von Partitionen (Kombinieren kleiner Partitionen zu Partitionen mit angemessener Größe) nach dem Shuffle-Austausch. Sehr kleine Vorgänge haben einen schlechteren E/A-Durchsatz und neigen dazu, mehr unter dem Planungsoverhead und dem Einrichtungsaufwand zu leiden. Das Kombinieren kleiner Vorgänge spart Ressourcen und verbessert den Clusterdurchsatz.
- Dynamische Behandlung von Datenschiefe bei Sort-Merge-Join und Shuffle-Hash-Join durch Aufteilung (und ggf. Replikation) von Aufgaben mit Schiefe in ungefähr gleichgroße Aufgaben.
- Erkennt und propagiert dynamisch leere Relationen, also Teile einer Abfrage, die keine Zeilen zurückgeben.
Unterstützte Abfragen
AQE gilt für Anfragen, die beide Bedingungen erfüllen:
- Die Abfrage ist keine Streaming-Abfrage.
- Die Abfrage enthält mindestens einen Exchange-Operator (meist aus einem Join, Aggregat oder Window), mindestens eine Unteranfrage oder beides.
AQE optimiert jede unterstützte Abfrage erneut, aber das Ergebnis könnte derselbe Plan sein, den der Optimierer vor der Abfrage erstellt hat. Um zu überprüfen, ob AQE den Plan einer Abfrage geändert hat, lesen Sie Abfragepläne.
Abfragepläne
AQE-angewendete Abfragen enthalten einen oder mehrere AdaptiveSparkPlan Knoten, in der Regel als Stammknoten der Haupt- oder Unterabfragen. Jeder AdaptiveSparkPlan Knoten hat ein isFinalPlan Flag. Das Flag ist vor und während der Abfrageausführung false und ändert sich bei Abschluss der Abfrage zu true.
Um einen Abfrageplan anzuzeigen, verwenden Sie die Spark-Benutzeroberfläche, DataFrame.explain(), oder SQL EXPLAIN. Jede zeigt unterschiedliche Informationen darüber, wie AQE den Plan ändert.
Spark-Benutzeroberfläche
Das Abfrageplandiagramm in der Spark-Benutzeroberfläche zeigt den aktuellsten Plan und aktualisiert sich, während die Abfrage läuft. Knoten, die bereits ausgeführt wurden und Metriken haben, ändern sich nicht. Knoten, die noch nicht ausgeführt wurden, könnten sich ändern, wenn AQE den Plan neu optimiert.
Dieses Beispiel zeigt ein Abfrageplan-Diagramm:

DataFrame.explain()
DataFrame.explain() zeigt unter jedem AdaptiveSparkPlan Knoten zwei Pläne: den Anfangsplan, bevor AQE Optimierungen anwendet, und den aktuellen Plan. Der aktuelle Plan ändert sich, während die Abfrage läuft, und wird zum endgültigen Plan, wenn die Abfrage abgeschlossen ist.
Die Ausgabe enthält Datenstatistiken für jede Shuffle- und Broadcast-Stufe. Die Statistiken hängen davon ab, ob die Phase ausgeführt wurde:
- Vor und während des Stage-Runs ist
isRuntimefalseund die Statistiken sind Schätzungen zur Kompilierungszeit. Beispiel:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false) - Nachdem die Phase ausgeführt wurde, ist
isRuntimetrueund die Statistiken sind Laufzeitmessungen. Beispiel:Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true)
Diese Screenshots zeigen DataFrame.explain() die Ausgaben vor, während und nach der Ausführung:
Vor der Ausführung

Während der Ausführung

Nach Ausführung

SQL EXPLAIN
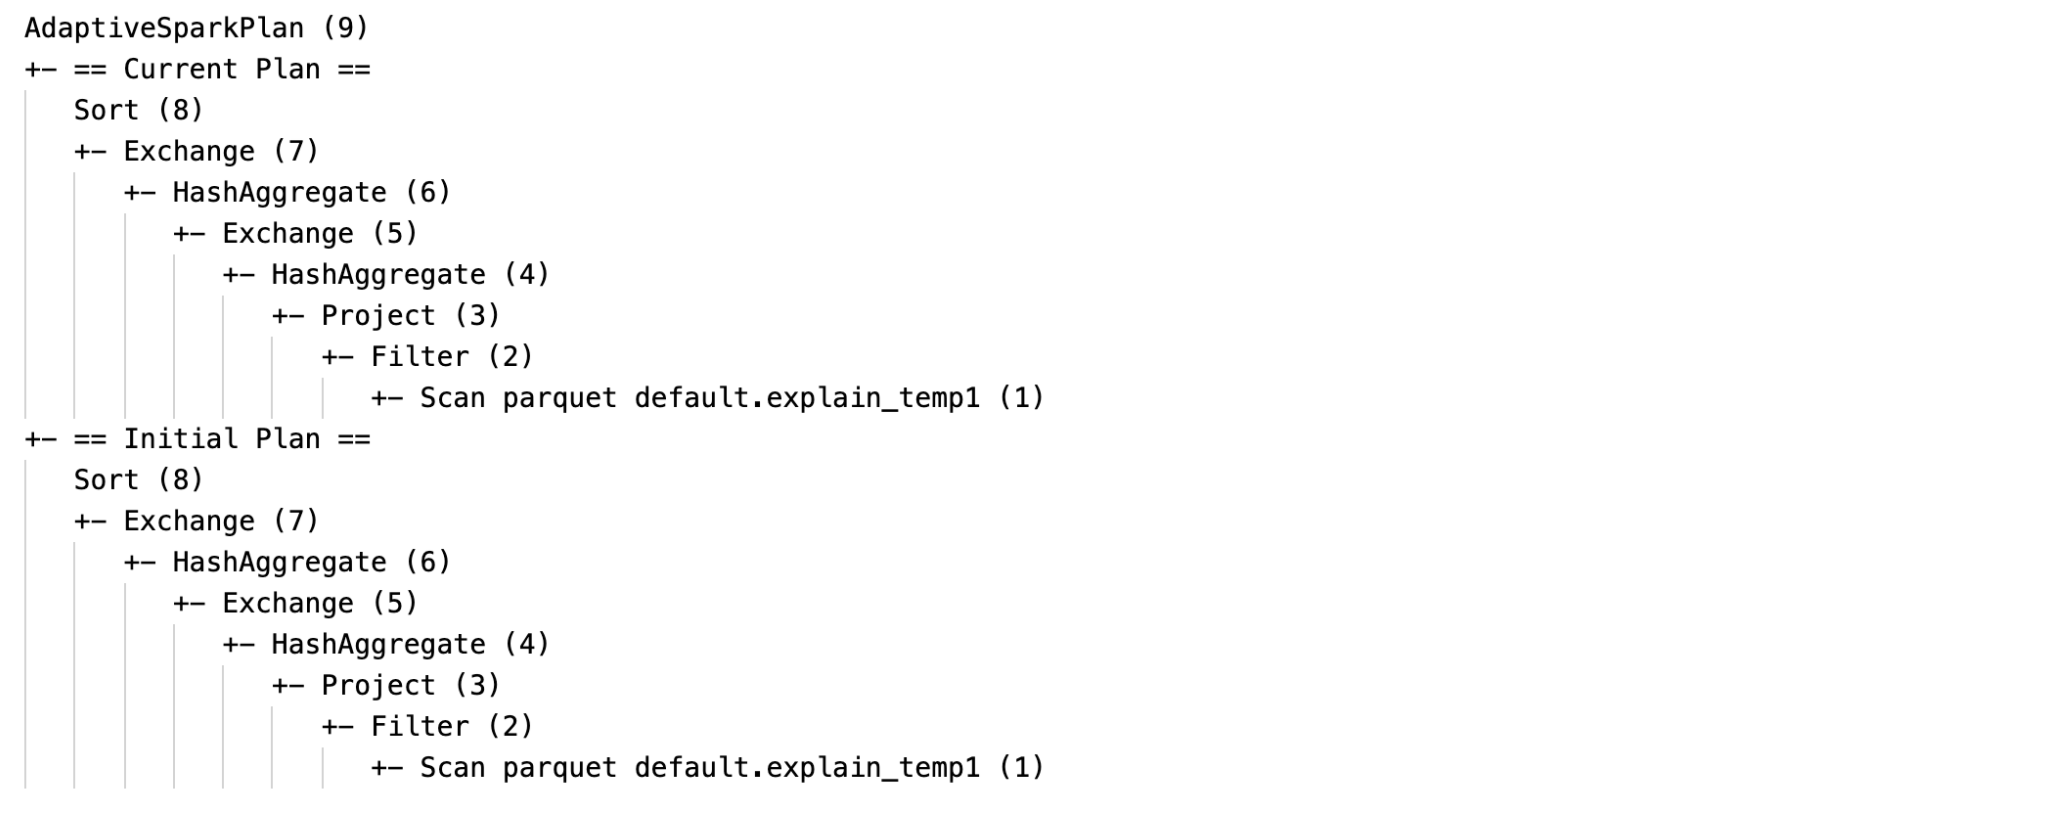
SQL EXPLAIN führt die Abfrage nicht aus, daher kann AQE sie nicht neu optimieren. Die Ergebnisse zeigen nur den ursprünglichen Plan, der sich von dem Plan unterscheiden kann, den AQE ausführt.
Dieses Beispiel zeigt SQL EXPLAIN Ausgabe:
Identifizieren Sie angewandte Optimierungen in einem Abfrageplan
Wenn AQE eine Optimierung anwendet, ändert sich der Abfrageplan. Um festzustellen, welche Optimierungen in Kraft getreten sind, vergleichen Sie den aktuellen oder endgültigen Plan mit dem ursprünglichen Plan. Jede Optimierung verändert den Plan auf eine bestimmte Weise:
Join-Strategie ändern Der aktuelle oder endgültige Plan hat einen anderen physischen Join-Knoten als der ursprüngliche Plan.

Zusammenführung von Partitionen. Der Plan enthält einen
CustomShuffleReaderKnoten mit der EigenschaftCoalesced.

Behandlung von Skew Joins. Der Plan enthält einen
SortMergeJoinKnoten mit dem FeldisSkew, das auftruegesetzt ist.

Weitergabe leerer Beziehungen. Ein
LocalTableScanKnoten mit leerem Relationsfeld ersetzt einen Teil oder den gesamten Plan.

Konfiguration
Diese Apache Spark-Konfigurationseigenschaften steuern AQE. Die meisten Workloads müssen die Standardwerte nicht ändern.
Aktivieren Sie AQE und passen Sie einzelne Optimierungen an
Verwenden Sie diese Eigenschaften, um AQE ein- oder auszuschalten und um auto-optimiertes Shuffle, Broadcast Join Switching und Empty Relation-Propagation abzustimmen:
| Eigentum | Typ | Voreinstellung | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Schaltet die Ausführung adaptiver Abfragen ein- oder aus. |
spark.sql.shuffle.partitions |
Integer |
200 |
Die Standardanzahl der Partitionen, die beim Mischen von Daten für Verknüpfungen oder Aggregationen verwendet werden sollen. Stellen Sie den Wert auf auto ein, um automatisch optimiertes Mischen zu aktivieren, das diese Zahl basierend auf dem Abfrageplan und der Größe der Abfrageeingabedaten festlegt.Bei Structured Streaming kann man diesen Wert zwischen den Neustarts von Abfragen vom selben Checkpoint-Standort nicht ändern. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
Die Größenschwelle für den Wechsel von einem Sort-Merge-Join zu einem Broadcast-Hash-Join zur Laufzeit. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Aktiviert oder deaktiviert die dynamische Propagation leerer Relationen. |
Dynamische Zusammenführung von Partitionen
| Eigentum | Typ | Voreinstellung | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Schaltet das Partition-Coalescing ein oder aus. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Die Zielgröße nach dem Zusammenwachsen. Koaleszierte Partitionen sind nahe an dieser Größe, aber nicht größer als diese. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Die mindeste Größe der Partitionen nach dem Zusammenwachsen. Koaleszierte Partitionen sind nicht kleiner als diese Größe. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Zweimal so viele Clusterkerne | Die Mindestanzahl der Partitionen nach dem Verschmelzen. Setzen Sie diese Eigenschaft nicht, denn das Festlegen dieser Eigenschaft überschreibt spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Dynamische Behandlung von Skew-Joins
| Eigentum | Typ | Voreinstellung | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Aktiviert oder deaktiviert die Verarbeitung von Skew-Joins. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
Der Multiplikator für die mediane Partitionsgröße, die eine Partition überschreiten muss, um als unausgewogen zu gelten. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
Die Mindestgröße, die eine Partition überschreiten muss, um als unausgeglichen zu gelten. |
AQE behandelt eine Partition nur dann als verzerrt, wenn beide Bedingungen erfüllt sind: (partition size > skewedPartitionFactor * median partition size) und (partition size > skewedPartitionThresholdInBytes).
Häufig gestellte Fragen (FAQ)
Warum hat AQE keine kleine Join-Tabelle übertragen?
Wenn die Tabelle kleiner als spark.databricks.adaptive.autoBroadcastJoinThreshold ist, aber AQE sie nicht überträgt, überprüfen Sie diese Ursachen:
- Der Join-Typ unterstützt kein Broadcast. Manche Join-Typen können eine Seite nicht übertragen. Zum Beispiel kann AQE die linke Seite eines
LEFT OUTER JOINnicht übertragen. - Die Tabelle hat viele leere Partitionen. Die meisten Aufgaben im Sort-Merge-Join sind schnell abgeschlossen, oder die Skew-Join-Behandlung optimiert den Join. AQE ändert keinen Sort-Merge-Join zu einem Broadcast-Hash-Join, wenn der Prozentsatz der nicht-leeren Partitionen niedriger als
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoinist.
Sollte ich trotzdem einen Broadcast-Join-Hinweis mit aktiviertem AQE verwenden?
Ja, wenn du deine Frage gut kennst. Ein Broadcast-Join, den der Optimierer vor der Abfrage plant, schneidet in der Regel besser ab als einer, den AQE zur Laufzeit plant. AQE wechselt möglicherweise erst zu einem Broadcast-Join, nachdem es beide Join-Seiten umverteilt hat, und dann erfährt es die tatsächlichen Tabellengrößen.
AQE respektiert Abfragehinweise genauso wie die statische Optimierung und wendet weiterhin die dynamischen Optimierungen an, die von den Hinweisen nicht beeinflusst werden.
Sollte ich den Skew Join Tipp oder AQE Skew Join Handling verwenden?
Verwenden Sie die AQE-Behandlung von Skew-Joins. Es erfolgt automatisch und funktioniert in der Regel besser als der Skew Join Hinweis.
Warum hat AQE meine Joins nicht neu sortiert?
AQE ordnet die Joins nicht zur Laufzeit neu an. Um die Join-Reihenfolge zu verbessern, sammeln Sie Tabellenstatistiken, damit der kostenbasierte Optimierer einen besseren Plan auswählen kann. Siehe kostenbasierter Optimierer.
Warum hat AQE meine Daten-Schieflage nicht erkannt?
AQE behandelt eine Partition nur dann als verzerrt, wenn beide Bedingungen erfüllt sind:
- Die Partition ist größer als
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(Standard256MB). - Die Partition ist größer als
spark.sql.adaptive.skewJoin.skewedPartitionFactor(Standardwert5) mal die mittlere Partitionsgröße.
AQE behandelt auch Skew nur in shuffle-basierten Joins, das sind Sort-Merge- und Shuffle-Hash-Joins. Es optimiert nie Skew bei Broadcast-Joins. Für shuffle-basierte Joins bestimmt der Join-Typ, welche Seite AQE optimieren kann:
| Join-Typ | Auf der linken Seite für Datenschiefe optimiert | Auf der rechten Seite für Datenschiefe optimiert |
|---|---|---|
INNER |
Ja | Ja |
CROSS |
Ja | Ja |
LEFT OUTER |
Ja | Nein |
RIGHT OUTER |
Nein | Ja |
LEFT SEMI |
Ja | Nein |
LEFT ANTI |
Ja | Nein |
FULL OUTER |
Nein | Nein |
Erbe
Spark 1.6 führte eine Funktion namens adaptive execution ein, aber AQE in Spark 3.0 ist eine andere Funktion. Die adaptive Ausführung von Spark 1.6 fügt Partitionen nur dynamisch zusammen. AQE ist ein Framework, das Abfragen auf Basis von Laufzeitstatistiken plant und neu plant, und es unterstützt alle Optimierungen auf dieser Seite.