Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Releases werden phasenweise durchgeführt. Ihr Azure Databricks-Konto wird möglicherweise erst eine Woche nach dem Datum der ersten Veröffentlichung aktualisiert.
Hinweis
In den Versions- und Kompatibilitätshinweisen von Databricks Runtime finden Sie jetzt Hinweise auf die Einstellung von Databricks Runtime.
Geheimnis-CLI
26. April 20180
Databricks CLI Version 0.7.0 bietet Ihnen die Möglichkeit, geheime Schlüssel über die Befehlszeile zu verwalten. In der Dokumentation zu geheimen Schlüsseln wird nun gezeigt, wie Sie die geheimen CLI-Befehle zum Erstellen und Verwalten von geheimen Schlüsseln verwenden.
Siehe Verwaltung von Geheimnissen.
Deep Learning-Leitfäden
24. April 2018
Wir haben dokumentation für Deep Learning für Azure Databricks mithilfe von CPU-Clustern hinzugefügt.
Sehen Sie sich Deep Learning an.
Update für Geheimnis-API: Erstellen von Geheimnisbereichen
25. April – 1. Mai 2018: Version 2.70
Der Endpunkt zum Erstellen eines Geheimnisses (2.0/preview/secret/scopes/create) ersetzt ab sofort das Feld initial_manage_acl und verwendet stattdessen initial_manage_principal. Das neue Feld bietet die gleiche Funktionalität, aber eine bessere Semantik.
Weitere Informationen finden Sie unter "Geheime API".
Tipps zur Fehlerbehebung in Spark
24. April – 1. Mai 2018: Version 2.70
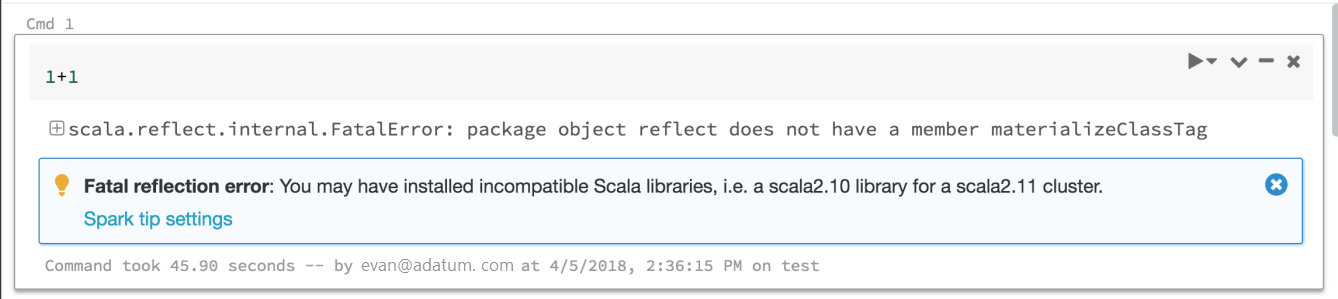
Azure Databricks bietet jetzt Tipps, mit denen Sie viele der Fehler interpretieren und beheben können, die beim Ausführen von Spark-Befehlen auftreten können. Und es werden weitere Tipps hinzukommen.
Databricks CLI 0.7.0
24. April 2018
Databricks CLI 0.7.0 enthält Fehlerbehebungen.
Außerdem stellt sie eine Befehlszeilenschnittstelle für die Secrets-API bereit.
Siehe Legacy Databricks CLI.
Heraufgesetztes Limit für die Kürzung der Initialisierungsskriptausgabe
24. April – 1. Mai 2018: Version 2.70
Wir haben den Ausgabeabkürzungsgrenzwert für init-Skripts auf 500.000 Zeichen erhöht.
Weitere Informationen finden Sie unter Was sind Initskripts?.
Cluster-API: UPSIZE_COMPLETED-Ereignistyp hinzugefügt
24. April – 1. Mai 2018: Version 2.70
Der neue UPSIZE_COMPLETED Clusterereignistyp gibt an, dass Knoten dem Cluster hinzugefügt wurden.
Siehe Cluster-API in der Cluster-API-Referenz.
Befehl „AutoVervollständigen“
10. - 17. April 2018: Version 2.69
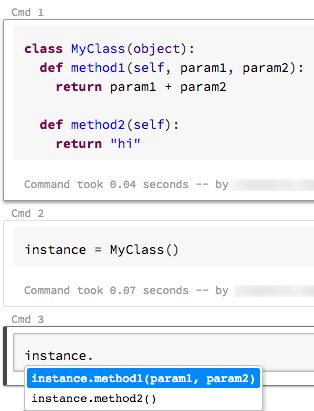
Azure Databricks unterstützt jetzt zwei Arten von AutoVervollständigen in Ihren Notizbüchern: lokal und server. Lokale Autovervollständigung ergänzt Wörter, die im Notizbuch vorhanden sind. Das AutoVervollständigen des Servers ist leistungsstärker, da er auf den Cluster für definierte Typen, Klassen und Objekte sowie SQL-Datenbank- und Tabellennamen zugreift. Um das AutoVervollständigen des Servers zu aktivieren, müssen Sie Ihr Notizbuch an einen ausgeführten Cluster anfügen und alle Zellen ausführen, die kompletierbare Objekte definieren.
Serverlose Pools, die auf Databricks Runtime 4.0 aktualisiert wurden
10. April 2018
Die Serverlose Pools-Laufzeitversion wurde von Databricks Runtime 3.5 (einschließlich Apache Spark 2.2.1) auf Databricks Runtime 4.0 (einschließlich Apache Spark 2.3.0) aktualisiert. Sie müssen Ihre Cluster neu starten, um diese Änderung aufzunehmen.
Das Upgrade stellt ein kleineres Apache Spark-Versionsupdate dar und ist abwärtskompatibel.