Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Interaktive Schulung erfordert explizite Zugriffsgenehmigung. Fordern Sie den Zugriff über das Vorschau-Registrierungsformular an, und warten Sie vor dem Erstellen einer Schulungssitzung auf die Genehmigung.
Verwenden Sie dieses Cheatsheet, um Ihre Schulungsschleife den Funktionen und Parametern des Python SDK in Microsoft Foundry zuzuordnen. Die Beispiele konzentrieren sich auf die synchrone FineTuningSession Komfort-API. Asynchrone Clients und Cookbookwrapper verwenden unterschiedliche Schnittstellen und Vervollständigungsmuster.
Prerequisites
- Vollständige Installation, Authentifizierung und Zugriffseinrichtung.
- Verwenden Sie
azure-ai-finetuningsessions==1.0.0b1die öffentliche Vorschauversion, die vom Cookbook installiert ist. - Die Rolle " Foundry User " für Schulungen oder die Rolle " Foundry Owner ", wenn Sie auch das fein abgestimmte Modell bereitstellen. Siehe rollenbasierte Zugriffssteuerung für Microsoft Foundry.
- Wählen Sie ein berechtigtes Modell und eine unterstützte Adapterkonfiguration aus. Bereiten Sie Token mit der entsprechenden Tokenizer- und Chatvorlage vor.
- Festlegen
AZURE_AI_PROJECT_ENDPOINTund Bestätigen eines genehmigten Schulungsbudgets. Das Erstellen einer Sitzung und das Ausführen von Schulungen oder Samplingvorgängen kann zu Gebühren führen.
Die Schulungs-, Sampling- und Prüfpunkt-Komfortmethoden warten auf die Betriebsergebnisse. Unformatierte Vorgänge und asynchrone Hilfsprogramme weisen unterschiedliche Rückgabetypen und Vervollständigungsverhalten auf; verwenden Sie die vollständige SDK-Referenz für diese Schnittstellen.
In den Beispielen wird das synchrone SDK verwendet, es sei denn, es wird anders bezeichnet. Bereiten Sie die Hilfsfunktionen einmal vor, und führen Sie dann Vorgänge in with open_session() as session:. Verwenden Sie echte tokenisierte Daten; die Codeausschnitte stellen kein Dataset bereit oder implementieren einen vollständigen Schulungsalgorithmus.
Überwachte Feinabstimmung
Überwachte Feinabstimmung (SFT) Züge auf Eingabeaufforderungen und gewünschten Antworten.
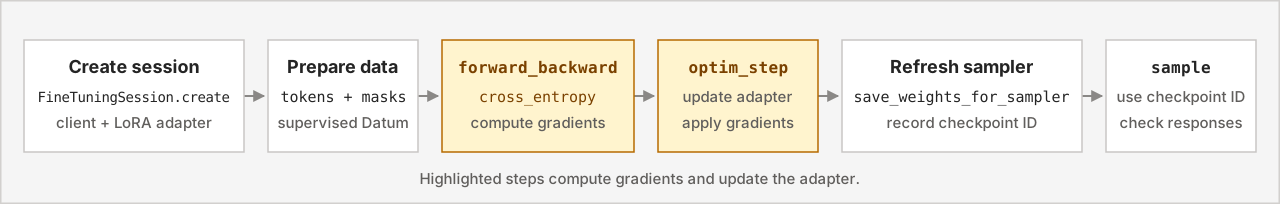
Die Sequenz wird erstellt, > um überwachte Daten > vorwärts/rückwärtsoptimierer > Schritt > auswerten Prüfpunkt zu erstellen>. Das Sampling ist für jeden überwachten Batch nicht erforderlich.
Vertiefendes Lernen
Verstärkungslernen (RL) züge aus bewerteten Modellantworten.

Die Sequenz ist das Erstellen eines > Aktualisierungs-Samplers>, der Rollouts berechnete Belohnungen und Vorteile > des Schritts > "Forward/Backward > Optimizer". Wiederholen Sie die Aktualisierung des Samplers, um Antworten aus der aktualisierten Richtlinie zu sammeln.
Gruppierung, Benotung und Vorteilsberechnung gehören zu Ihrem Treiber, nicht zu einem automatischen SDK-Schulungsalgorithmus. Vollständige Schulungsbeispiele finden Sie im Repository für Feinabstimmungsbeispiele.
Erstellen Sie eine Sitzung
FineTuningSessionClient stellt eine Verbindung mit Ihrem Projekt mithilfe von und endpointcredential.
FineTuningSession.create initialisiert ein Modell und einen Adapter und startet den Sitzungstakt.
Dieser Hilfsprogramm authentifiziert sich mit DefaultAzureCredential, erstellt eine Sitzung und entlädt sie, wenn der Kontext beendet wird. Verwenden Sie Ihr genehmigtes Modell und den LoRA-Rang. Der explizite Anmeldeinformationsbereich dient Microsoft Entra Authentifizierung.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Referenz: FineTuningSession.create, FineTuningSessionClient und DefaultAzureCredential.
Erwarten Sie einen Sitzungsbezeichner nach Abschluss des Modellladevorgangs. Halten Sie die Sitzung für die folgenden Vorgänge geöffnet; Durch schließen des Kontexts wird der Takt beendet und eine Unload-Anforderung übermittelt.
| Parameter | Dies bedeutet |
|---|---|
base_model |
Exakt unterstützte Trainingsmodell-ID. |
lora_config |
Explizit LoRAConfig mit einer unterstützten rank. |
type |
Sitzungstyp; verwenden training. Das Sampling erfolgt über die Schulungssitzung, nicht durch einen separaten Ableitungssitzungstyp. |
timeout_sec |
Maximale Zeit bis zum Laden des Modells. Ein Timeout bestätigt die Remotebereinigung nicht. |
from_checkpoint |
Optional FromCheckpoint mit der Quelle source_session_id und checkpoint_id. Verwenden Sie den kompatiblen gespeicherten Schulungszustand. |
user_metadata |
Optionales Wörterbuch der Ausführungsmetadaten, die der Sitzung zugeordnet werden sollen. |
training_type |
Optionaler Leistenmarkierer; Bekannte Werte sind GlobalStandard, DatazoneStandardund DeveloperTier. Die Berechtigung hängt weiterhin vom Modell und Projekt ab. |
Zeichnen Sie auf session.session_id , wenn Sie das SDK direkt verwenden. Informationen zum Ausführen eines End-to-End-Schulungsrezepts finden Sie unter "Erste Schritte".
Vorbereiten von überwachten Daten
Datum Gruppen model_input und loss_fn_inputs für ein Beispiel.
| Typ oder Feld | Dies bedeutet |
|---|---|
ModelInput |
Sortierte Modelleingabeblöcke. |
ModelInputChunk.tokens |
Texttoken-IDs aus dem Tokenizer des Modells. |
LossFnInputs.target_tokens |
Ziele des nächsten Tokens, die an den Eingabepositionen ausgerichtet sind. |
LossFnInputs.weights |
Explizite Gewichtungen pro Token; Null schließt ein Ziel aus dem cross-entropy Training aus. |
TensorData.data |
Ganzzahlige Ziele oder Gleitkomma-Lernsignale. |
Verschieben Sie Eingaben und Ziele um ein Token, und richten Sie die Gewichtungen an den Zielen aus. Trainieren Sie die vorgesehenen Assistententoken, keine Eingabeaufforderungen oder Beobachtungen. Siehe Verlustfunktionen und Tokengewichtungen.
Übergeben Sie Eingabeaufforderungs- und Abschlusstoken vom gleichen modellspezifischen Chatrenderer an diesen Helfer. Es erstellt ein SFT-Beispiel mit einer einzelnen Drehung und maskiert Eingabeaufforderungsziele.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Referenz: Datum, LossFnInputs und ModelInput.
Erstellen Sie batch als Liste dieser Datum Werte. Die Eingabe-, Ziel- und Gewichtungsarrays weisen die gleiche Länge auf. Bewahren Sie bei Multi-Turn-Daten die Masken des Renderers bei, anstatt jedes Token nach der ersten Eingabeaufforderung als Assistententoken zu behandeln.
Vorbereiten von RL-Daten
Verwenden Sie für RL Stichprobenantworten und belohnungsbasierte Lernsignale:
| Feld | Dies bedeutet |
|---|---|
SampledSequence.tokens |
Generierte Token-IDs. |
SampledSequence.logprobs |
Tokenprotokoll-Wahrscheinlichkeiten aus der Richtlinie, die die Antwort generiert hat, wenn angegeben. |
LossFnInputs.logprobs |
Rolloutprotokoll-Wahrscheinlichkeiten, die an Schulungszielen ausgerichtet sind. |
LossFnInputs.advantages |
Vorteile pro Token; Null schließt Eingabeaufforderungs- und Beobachtungspositionen aus dem RL-Signal aus. |
Beibehalten der Ausrichtung zwischen Zielen, Protokollwahrscheinlichkeiten und Vorteilen. Ersetzen Sie die Rollout-Wahrscheinlichkeiten nicht durch diejenigen aus einem neu aktualisierten Modell.
LossFnInputs Python Konstruktor erfordert außerdem explizitweights; Die RL-Maskierung nutzt die Vorteile.
Übergeben Sie bei einem Rollout mit einer einzelnen Drehung eine Stichprobe sequence und einen advantage vom Treiber berechneten Wert. Dieses Hilfsprogramm stellt null Vorteile und Protokoll-Wahrscheinlichkeiten an Eingabeaufforderungszielpositionen fest.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Referenz: SampledSequence und LossFnInputs.
Verwenden Sie für Toolaufrufe oder Multi-Turn-Rollouts den Renderer des Rezepts, um beispielbasierte Aktionstoken von Umgebungsbeobachtungen zu unterscheiden.
Berechnen von Farbverläufen
session.forward_backward(batch, loss_fn=...) berechnet das Ziel und sammelt Farbverläufe. Die Adaptergewichte werden nicht aktualisiert.
batch enthält Datum Werte.
loss_fn
cross_entropywählt , , importance_sampling, ppo, cispooder sapo. Optional loss_fn_config verwendet das SDK-Modell LossFnConfig . Verwenden Sie keine akzeptierten Konfigurationsschlüssel aus einem Algorithmuspapier.
Vollständige Farbverlaufsberechnung vor dem Update des Optimierrs. Halten Sie die Reduzierung von Verlusten konsistent , wenn Sie mehrere Aufrufe sammeln.
Mit einem Live session - und einem nicht entsempigenden SFT batchberechnen Sie Farbverläufe und prüfen Sie die Pro-Beispiel-Ausgaben:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referenz: FineTuningSession.forward_backward und LossFn.
Verwenden Sie LossFn.IMPORTANCE_SAMPLING für einen vorbereiteten RL-Batch oder einen anderen unterstützten Richtlinienverlust.
LossFn Enumerationselemente und deren Zeichenfolgenwerte wählen denselben Verlust aus.
Anwenden eines Optimiererschritts
session.optim_step(adam_params) wendet akkumulierte Farbverläufe an.
AdamParams Python erfordert alle fünf Felder:
| Feld | Dies bedeutet |
|---|---|
learning_rate |
Updategröße des Optimierrs. |
beta1 |
Abklingfaktor des ersten Moments. |
beta2 |
Second-Moment-Verfallsfaktor. |
eps |
Numerischer Stabilitätsausdruck. |
weight_decay |
Gewichtszerfalleinstellung. |
Wählen Sie Werte für Ihr Experiment aus, anstatt universelle Standardwerte zu übernehmen.
Dieses Hilfsprogramm liefert jedes erforderliche Feld und wartet auf das Update. Die Werte sind Beispieleinstellungen, nicht modellunabhängige Empfehlungen.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Referenz: FineTuningSession.optim_step und AdamParams.
Kompensieren learning_rate Sie erneut, wenn Ihr Treiber einen Zeitplan verwendet. Gehen Sie nicht davon aus, dass eine Optimiererkonfiguration während der ausführung gilt.
Beispieltext
session.save_weights_for_sampler(seq_id, ...) bereitet Gewichtungen vor und gibt einen Samplerprüfpunktbezeichner zurück. Aktualisieren Sie die Samplergewichte nach Updates, bevor Sie vom aktualisierten Adapter generiert werden.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) generiert Antworten aus den ausgewählten Samplergewichtungen.
| Parameter oder Ergebnis | Dies bedeutet |
|---|---|
prompt_tokens |
Tokenisierte Eingabeaufforderung oder unterstützt ModelInput. |
checkpoint_id |
Abgeschlossener Samplerprüfpunktbezeichner für diese Sitzung, kein Prüfpunktpfad oder Bereitstellungsname. |
num_samples |
Anzahl der Antworten für die Eingabeaufforderung. |
SamplingParams.max_tokens |
Vervollständigungstokenbudget. |
temperature, top_ptop_k |
Samplingverteilungseinstellungen. |
stop_criteria |
Eine Liste der Stoppzeichenfolgen oder eine Liste von Token-IDs, nicht beide. |
response_format |
Optionale Antwortformatanforderung; Die Unterstützung hängt vom Modell- und Samplinganbieter ab. |
result.sequences |
Generierte SampledSequence Werte. |
SamplingParams Python erfordert max_tokens, temperature, , top_pund top_k. Legen Sie das gleiche seq_id für die Sampleraktualisierung und das Sampling fest. Geben Sie entweder path oder sampling_session_seq_id beim Speichern von Samplergewichten an.
Aktualisieren Sie nach einer Optimiereraktualisierung den Sampler, und generieren Sie eine Antwort. Verwenden Sie den Tokenisierungs prompt_tokens - und Abgleich tokenizer des Modells von Ihrem Treiber.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Referenz: FineTuningSession.save_weights_for_sampler, FineTuningSession.sample und SamplingParams.
Das Ergebnis enthält eine stichprobenfähige Sequenz. Erhöhen Sie den Schrittbezeichner mit ihren Updates und aktualisieren Sie Samplergewichte, bevor Sie die aktualisierte Richtlinie samplingn.
Das Vorbereiten von Samplergewichten entspricht nicht dem Speichern des fortsetzbaren Trainingszustands.
Persist or refresh sampler weights
Die synchrone Methode verwendet sampling_session_seq_id , um eine In-Memory-Aktualisierung von einem dauerhaften Samplerprüfpunkt zu unterscheiden.
| Purpose | Synchroner Aufruf |
|---|---|
| Aktualisieren von Samplergewichtungen ohne Persistenz | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Speichern eines Samplerprüfpunkts |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), ohne sampling_session_seq_id. |
Beide Aufrufe geben einen Samplerprüfpunktbezeichner zurück. Behalten Sie sie mit ihrer eigenen Sitzungs-ID bei. Bei einem dauerhaften Samplerspeicher wird keine unbestimmte Aufbewahrung festgelegt oder der Prüfpunkt in einer anderen Sitzung verwendet.
Ausführen eines Vorwärtsdurchlaufs
session.forward(batch, loss_fn=...) gibt Verlustfunktionsausgaben zurück, ohne Farbverläufe zu akkumulieren. Verwenden Sie sie, um einen vorbereiteten Batch zu untersuchen oder Auswertungsmetriken zu berechnen.
Das Ergebnis füllt das training-only total_lossnicht auf. Prüfen loss_fn_outputs; behandeln Sie kein fehlendes Aggregat als Nullverlust.
Prüfen Sie mit einem Live und einem vorbereiteten batch, session die pro Beispiel ausgegebenen Ausgaben, ohne sich angesammelte Farbverläufe zu ändern:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referenz: FineTuningSession.forward.
Speichern und Fortsetzen der Schulung
session.save_weights(path) spart Adaptergewichte und Optimiererzustand. Notieren Sie den Prüfpunktverweis mit dem Quellsitzungs- und Treiberstatus.
Speichern Sie nach einer abgeschlossenen Aktualisierung den Schulungsstatus, und notieren Sie die Referenz zu Quellsitzung/Prüfpunkt:
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Referenz: FineTuningSession.save_weights.
Die Methode wird erst nach Abschluss des Speichervorgangs zurückgegeben. Speichern Sie checkpoint_path mit der Datasetposition und dem anderen Treiberstatus, bevor Sie die Sitzung schließen.
FineTuningSession.create_from_checkpoint Stellt den Schulungszustand in einer neuen Sitzung wieder her:
| Parameter | Dies bedeutet |
|---|---|
checkpoint_path |
Gespeicherte Referenz zu Schulungsprüfpunkten im <source-session-id>/<checkpoint-name> Formular. |
base_model |
Basismodell, das mit dem ursprünglichen Prüfpunkt kompatibel ist. |
lora_config |
Kompatible Adapterkonfiguration mit einer expliziten Rangfolge. |
Ein Samplerprüfpunkt ist kein Vollzustandsschulungsprüfpunkt. Stellen Sie die Position des Datasets und die Planung separat in Ihrem Treiber wieder her. Siehe Prüfpunkte.
Dieser Hilfsprogramm stellt den gespeicherten Schulungszustand über eine authentifizierte Wiederherstellung clientwieder her. Übergeben Sie die aufgezeichnete Schulung checkpoint_path, und halten Sie das Basismodell und den LoRA-Rang mit der Quellsitzung kompatibel.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Referenz: FineTuningSession.create_from_checkpoint.
Die zurückgegebene Sitzung verfügt über eine neue Sitzungs-ID und startet einen eigenen Takt. Schließen Sie die fortgesetzte Sitzung, wenn die Schleife beendet wird, genauso wie Sie eine neu erstellte Sitzung schließen.
Verwenden asynchroner Vorgänge
Die asynchronen Client- und Cookbookwrapper des SDK sind nicht austauschbar. Importieren Sie den asynchronen Client aus azure.ai.finetuningsessions.aio; Modelltypen stammen immer noch aus azure.ai.finetuningsessions.models.
| Interface | Abschlussmuster |
|---|---|
Synchron FineTuningSession |
Die Methode gibt ein abgeschlossenes Vorgangsergebnis zurück. |
Unformatierte asynchrone SDK-Komfortmethoden wie z. B. save_weights_for_sampler_async |
Warten Sie die Übermittlung, und warten Sie dann auf den Abschluss asyncio.Task . |
Cookbook Training-Wrapper-Methoden wie save_state_async |
Warten Sie die Übermittlung, und warten Sie dann die Zukunft.result_async() |
Bei einer Livesitzung, die einer asynchronen clientSitzung gehört, speichert dieser Hilfsprogramm gewichtet und gibt den vollständigen Prüfpunktbezeichner zurück:
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Referenz: Async FineTuningSessionClient.save_weights_for_sampler_async.
Verwenden Sie save_weights_and_get_sampling_client_async stattdessen eine kurzlebige Sampleraktualisierung. Auf dem unformatierten SDK-Client gibt diese Methode weiterhin eine Aufgabe mit einem Vorgangsergebnis zurück, nicht einen Cookbook-Samplingclient.
Warten Sie vor dem Entladen einer Sitzung auf erforderliche Ersparnissen. Das Kompatibilitätsargument ttl_seconds des Cookbook wird nicht an diese SDK-Speicher weitergeleitet. Behandeln Sie es nicht als erzwungene Aufbewahrungseinstellung.
Für benutzerdefinierte Ziele erstellt Cookbook forward_backward_custom_async die Dienstweiterleitungsausgaben mit clientseitiger differenzierbarer Verlustberechnung. Es handelt sich nicht um FineTuningSessioneine Methode, und der Parameter des loss_fn SDK akzeptiert keine beliebige Python aufrufbar.
Schließen von Ressourcen
session.close() beendet den Takt und sendet eine Unload-Anforderung. Rufen Sie sie auf, wenn die Schleife beendet wird, einschließlich eines Fehlers; schließen Sie dann den HTTP-Client und die Anmeldeinformationen.
Durch das Schließen wird der Abschluss der Remotebereinigung oder das Löschen von Prüfpunkten nicht bestätigt.
session.delete() kann an gespeicherte Ressourcen kaskadieren. Siehe "Überprüfen und Entladen von Sitzungen".
Verwenden Sie den open_session Kontext-Manager, um ein einzelnes SFT-Update auszuführen und den Schulungszustand zu speichern. Definieren open_session und apply_optimizer_step aus den früheren Beispielen und übergeben Sie einen nicht überflüssig gerenderten SFT batch.
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Referenz: FineTuningSession.close und FineTuningSession.save_weights.
Der Hilfsprogramm gibt einen Schulungsprüfpunktverweis zurück. Der Kontext sendet eine Unload-Anforderung, auch wenn ein Schulungsvorgang eine Ausnahme auslöst, und schließt dann den Client und die Anmeldeinformationen.
SDK-Referenz
Verwenden Sie die vollständige Referenz für ausführbare Beispiele, Methodensignaturen, asynchrone APIs, Ergebnistypen und Fehler: