Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
GQL (Graph Query Language) ist die ISO-standardisierte Abfragesprache für Graphdatenbanken. Verwenden Sie GQL zum Effizienten Abfragen, Analysieren und Arbeiten mit Graph-Daten mit Graph in Microsoft Fabric.
Dieselbe ISO-Arbeitsgruppe, die SQL standardisiert, entwickelt GQL. Daher teilt GQL viele Konzepte mit SQL, einschließlich Ausdrücken, Prädikaten und Datentypen. Wenn Sie über SQL-Erfahrung verfügen, können Sie viele dieser Kenntnisse auf GQL anwenden.
Dieser Artikel ist der End-to-End-Leitfaden für GQL in Graph. Sie erklärt, wie die Sprache zusammenpasst, und verlinkt mit gezielten Referenzen für vollständige Syntax- und Typdetails. Es umfasst:
- Kernkonzepte: Graph-Datenstrukturen, Muster und Abfragegrundlagen
-
Wesentliche Aussagen:
MATCH,FILTER, ,LET,ORDER BYWHEN, ,LIMITundRETURN - Datentypen und Ausdrücke: Werttypen, Operatoren und integrierte Funktionen
- Erweiterte Techniken: Kompositions-, Variablen-Bereichs- und Aggregationsstrategien mit mehreren Anweisungen
Hinweis
Der offizielle internationale Standard für GQL ist ISO/IEC 39075 Information Technology - Database Languages - GQL.
Wenn Sie aufgabenorientierte Anleitungen statt einer Sprachanleitung suchen, sehen Sie sich die Anleitungen an:
- Schreiben allgemeiner GQL-Abfragen – Nachbarn, Multi-Hop-Traversal, freigegebene Verbindungen und Entitätsexistenzprüfungen
- Filtern und Aggregieren von Diagrammdaten – FILTER-, WHERE-, GROUP BY- und Aggregatfunktionen
- Schreiben von Diagrammmusterabfragen – Multi-Hop-Muster, Pfadmodi, Wiederverwendung von Variablen und OPTIONAL MATCH
- Optimieren der GQL-Abfrageleistung – Filterstrategie, Traversalgrenzwerte und Empfehlungen für wichtige Einschränkungen
Verwenden Sie die fokussierten Referenzartikel, wenn Sie vollständige Informationen benötigen:
| Benötigte Informationen | Endgültiger Artikel |
|---|---|
| Syntax auf einen Blick | GQL-Kurzübersicht |
| Syntax von Knoten-, Kanten-, Pfad- und Musterkompositionssyntax | GQL-Diagrammmuster |
| Operatoren, Prädikate und Funktionen | GQL-Ausdrücke, Prädikate und Funktionen |
| Wörtliche Syntax, Wertverhalten und Typumwandlungen | GQL-Werte und Werttypen |
| Definitionen und Einschränkungen von Graphentypen | GQL-Diagrammtypen |
| Aktuelle ISO GQL-Funktionsabdeckung | GQL-Standardkonformität |
| Aktuelle Fabric-spezifische Einschränkungen und Einschränkungen | Aktuelle Einschränkungen |
Voraussetzungen
Bevor Sie beginnen, stellen Sie sicher, dass Sie mit diesen Konzepten vertraut sind:
- Basic Understanding of databases – Experience with any database system such as relational (SQL), NoSQL, or graph is helpful.
- Diagrammkonzepte – Grundlegendes zu Knoten, Kanten und Beziehungen in verbundenen Daten.
- Abfragegrundlagen – Kenntnisse grundlegender Abfragekonzepte wie Filtern, Sortieren und Aggregation.
Empfohlener Hintergrund:
- Die Erfahrung mit SQL- oder OpenCypher-Sprachen erleichtert das Erlernen der GQL-Syntax (sie sind die Wurzeln von GQL).
- Vertrautheit mit der Datenmodellierung hilft beim Diagrammschemaentwurf.
- Grundlegendes zu Ihrem spezifischen Anwendungsfall für Diagrammdaten.
Was Sie benötigen:
- Zugriff auf einen Diagrammarbeitsbereich mit Abfragefunktionen.
- Beispieldaten oder Bereitschaft, mit unseren Beispielen für soziale Netzwerke zu arbeiten.
- Einfacher Text-Editor zum Schreiben von Abfragen.
Tipp
Wenn Sie noch nicht mit Diagrammdatenbanken vertraut sind, beginnen Sie mit der Übersicht über Diagrammdatenmodelle , bevor Sie mit diesem Leitfaden fortfahren.
Was macht GQL besonders
GQL ist speziell für Graphdaten konzipiert, daher drückt seine Syntax direkt aus, wie Entitäten miteinander verbunden sind. Während SQL häufig Beziehungen durch Joins zwischen Tabellen ausdrückt, verwendet GQL Graphenmuster, die Diagrammen der Daten ähneln.
Zum Beispiel findet die folgende Abfrage Paare von Menschen, die sich kennen und beide vor 1999 geboren wurden:
MATCH (person:Person)-[:knows]-(friend:Person)
WHERE person.birthday < 19990101
  AND friend.birthday < 19990101
RETURN person.firstName || ' ' || person.lastName AS person_name,
       friend.firstName || ' ' || friend.lastName AS friend_name
Das Muster (person:Person)-[:knows]-(friend:Person) zeigt die entsprechende Beziehungsstruktur. Variablen binden die beiden Personen, sodass die Abfrage filtern und ihre Eigenschaften zurückgeben kann.
GQL-Grundlagen
Diese Konzepte bilden die Grundlage von GQL:
- Graphen enthalten Knoten und Kanten mit Labels und Eigenschaften.
- Graphtypen definieren formal die Knotentypen, Kantentypen und Nebenbedingungen, die in einem Graphen erlaubt sind.
-
Abfragen verwenden Anweisungen wie
MATCH,FILTER, undRETURNum Daten zu verarbeiten und Ergebnisse zu liefern. - Muster beschreiben die entsprechenden Graphenstrukturen.
- Ausdrücke berechnen, transformieren und vergleichen Werte.
- Prädikate sind boolesche Ausdrücke, die verwendet werden, um Bedingungen zu testen.
- Werttypen definieren die Arten von Werten, die Abfragen verarbeiten können und welche Grapheigenschaften speichern können.
Graphendaten verstehen
Um mit GQL zu arbeiten, musst du die Struktur der beschrifteten Eigenschaftsgraphen verstehen, die die Sprache abfragt.
Knoten und Kanten: die Bausteine
Ein beschrifteter Eigenschaftsgraph enthält zwei Arten von Graphelementen:
- Knoten repräsentieren typischerweise Entitäten wie Personen, Organisationen, Beiträge oder Produkte.
- Kanten stellen Verbindungen zwischen Knoten dar, wie etwa dass eine Person eine andere Person kennt oder in einem Unternehmen arbeitet.
Jedes Graphenelement besitzt eine interne Identität, ein oder mehrere Labels und eine Menge von Eigenschaften. Bezeichnungen klassifizieren Elemente wie Person oder knows. Eigenschaften sind Namen-Wert-Paare, wie firstName: 'Alice' oder birthday: 19730108u. In Graph hat eine Kante immer genau ein Label.
Jede Kante verbindet genau zwei Knoten: einen Ursprung und ein Ziel. Die Kantenrichtung ist Teil der Graphenstruktur. Zum Beispiel kann eine workAt Kante einen Person Ursprung mit einem Company Ziel verbinden.
Hinweis
Graph unterstützt derzeit nicht das Erstellen ungerichteter Kanten. Man kann eine bestehende gerichtete Kante in beide Richtungen abfragen, indem man ein beliebiges gerichtetes Kantenmuster wie -[:knows]-verwendet.
Graphen sind wohlgeformt: Jede Kante verbindet zwei Knoten, die im selben Graphen existieren.
Diagrammmodelle und Diagrammtypen
Ein Fabric-Graphenmodell definiert die Knotentypen, Kantentypen, Eigenschaften, Quellcode-Abbildungen und Schlüssel, die in einem Graphen verfügbar sind. Es gibt an, welche Quelltabellenzeilen zu Knoten und Kanten werden und wie diese Elemente miteinander verbunden sind. Für Modellierungshinweise siehe Entwurf eines Graphenschemas.
Der GQL-Standard verwendet einen Graphentyp , um erlaubte Knotentypen, Kantentypen, Eigenschaften und Einschränkungen formell zu beschreiben. Graphtypen sind das sprachliche Gegenstück zur Struktur, die durch ein Fabric-Graphenmodell dargestellt wird, aber Graph akzeptiert derzeit keine GQL-Graphtyp-Deklarationen direkt. Für die formale Syntax und Konzepte siehe GQL-Graphentypen.
Beispielgraph, das in diesem Leitfaden verwendet wird
Beispiele verwenden das Beispieldatenset für soziale Netzwerke, das Personen, Orte, Organisationen, Nachrichten, Tags und die Kanten enthält, die sie verbinden.
Das Beispieldiagramm verbindet diese Bereiche:
- Die Leute kennen andere Menschen, arbeiten in Unternehmen und studieren an Universitäten.
- Städte, Länder oder Regionen sowie Kontinente bilden eine geografische Hierarchie.
- Foren enthalten Beiträge, und Menschen erstellen Beiträge und Kommentare.
- Tags kategorisieren Inhalte und repräsentieren die Interessen der Menschen.
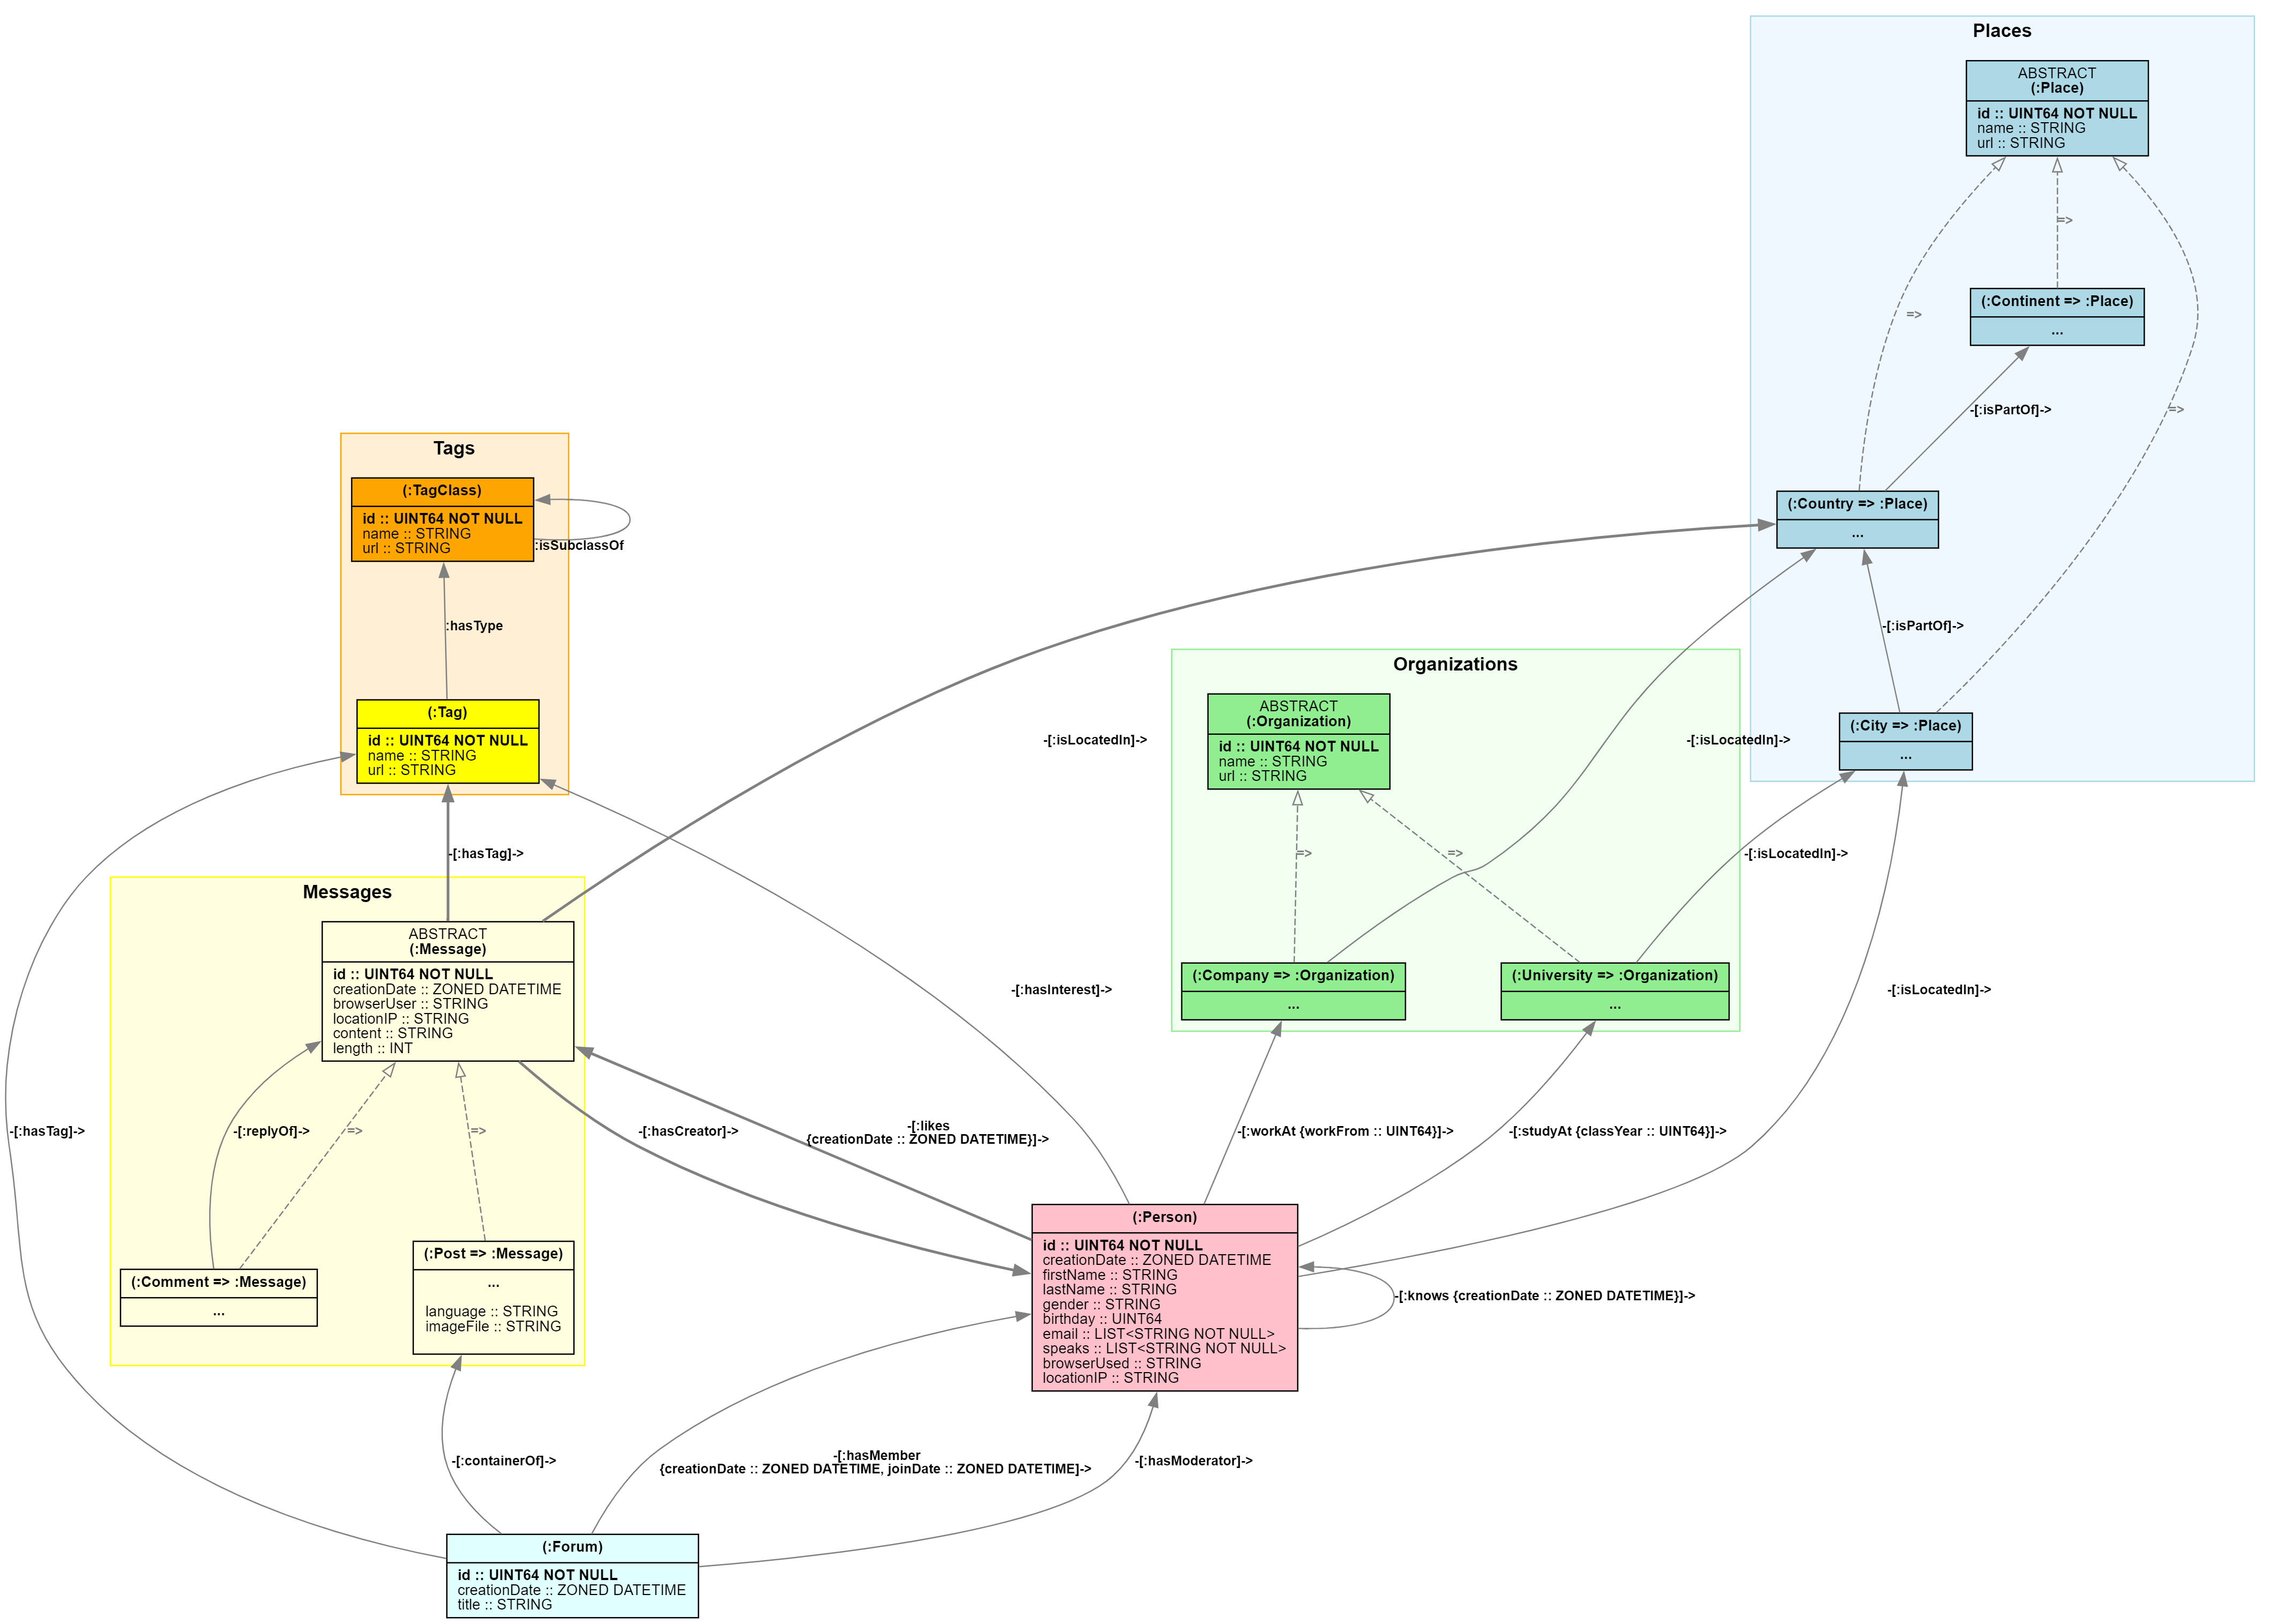
Für die vollständige Beispielstruktur siehe das Beispiel für das soziale Netzwerk-Schema. Für allgemeine Graphkonzepte siehe Beschriftete Eigenschaftsgraphen.
Ihre ersten GQL-Abfragen
Nachdem Sie nun die Grundlagen von Diagrammen verstanden haben, sehen wir uns an, wie Sie Diagrammdaten mit GQL abfragen. Diese Beispiele erstellen von einfach bis komplex und zeigen Ihnen, wie der Ansatz von GQL Graph-Abfragen intuitiv und leistungsfähig macht.
Einfaches Start: Suchen aller Personen
Beginnen Sie mit der einfachsten Abfrage, die möglich ist. Suchen Sie die Namen (Vorname, Nachname) aller Personen (:Personn) im Diagramm.
MATCH (p:Person)
RETURN p.firstName, p.lastName
Diese Abfrage wird wie folgt ausgeführt:
-
MATCHfindet alle Knoten mitPersonder Bezeichnung . -
RETURNzeigt ihre Vor- und Nachnamen an.
Filter hinzufügen: Bestimmte Personen suchen
Suchen Sie nun Personen mit bestimmten Merkmalen. In diesem Fall finden Sie alle namens Alice und zeigen ihre Namen und Geburtstage an.
MATCH (p:Person)
FILTER p.firstName = 'Alice'
RETURN p.firstName, p.lastName, p.birthday
Diese Abfrage wird wie folgt ausgeführt:
-
MATCHfindet alle Knoten (p) mit der Bezeichnung "Person". -
FILTERKnoten (p), deren Vorname Alice ist. -
RETURNzeigt ihren Vor-, Nachnamen und Geburtstag an.
Grundlegende Abfragestruktur
Grundlegende GQL-Abfragen folgen einem konsistenten Muster: eine Abfolge von Anweisungen, die zusammen arbeiten, um Daten zu suchen, zu filtern und zurückzugeben.
Die meisten Abfragen beginnen damit MATCH , Muster im Graphen zu finden, und enden damit RETURN , um das Ergebnis zu spezifizieren.
Hier ist eine einfache Abfrage, die Paare von Menschen findet, die sich kennen und denselben Geburtstag haben, und dann die Gesamtzahl dieser Freundespaare zurückgibt.
MATCH (n:Person)-[:knows]-(m:Person)
FILTER n.birthday = m.birthday
RETURN count(*) AS same_age_friends
Diese Abfrage wird wie folgt ausgeführt:
-
MATCHfindet alle KnotenpaarePerson, die einander kennen. -
FILTERhält nur die Paare, bei denen beide Personen denselben Geburtstag haben. -
RETURNzählt, wie viele solche Freundpaare vorhanden sind.
Tipp
Du kannst auch direkt in ein Muster filtern, indem du eine Klausel WHERE anhängst. Zum Beispiel MATCH (n:Person WHERE n.birthday < 19900101) wird nur Person Knoten mit einem birthday Wert vor 1990 übereinstimmt.
GQL unterstützt Linienkommentare im C-Stil // , ZEILENkommentare im SQL-Stil -- und Blockkommentare im C-Stil /* */ .
Häufige Aussagen
-
MATCH: Identifiziert das zu suchende Graphenmuster – hier definieren Sie die Struktur der Daten, die Sie interessieren. -
LET: Zuweist neue Variablen oder berechnete Werte basierend auf abgestimmten Daten zu – fügt abgeleitete Spalten zum Ergebnis hinzu. -
FOR: Erweitert eine Liste in Zeilen, mit einer optionalen nullbasierten Versetzung oder einer ein-basierten Ordinalposition. -
CALL: Führt für jede Eingabezeile eine Inline-Unterabfrage aus und addiert die von der Unterabfrage zurückgegebenen Spalten. -
FILTER: Begrenzt die Ergebnisse durch Anwendung von Bedingungen – entfernt Zeilen, die die Kriterien nicht erfüllen. -
ORDER BY: Sortiert die gefilterten Daten – hilft, die Ausgabe basierend auf einem oder mehreren Feldern zu organisieren. -
OFFSETundLIMIT: Begrenze die Anzahl der zurückgegebenen Zeilen – nützlich für Paginierung oder Top-K-Abfragen. -
RETURN: Spezifiziert die Endausgabe – definiert, welche Daten in den Ergebnissatz aufgenommen werden sollen, und führt die Aggregation durch. -
NEXT: Starte eine weitere Abfragephase, indem die von der vorherigen Stufe zurückgegebenen Spalten verwendet werden.
Zusammenarbeit von Anweisungen
GQL-Anweisungen bilden eine Pipeline, in der jede Anweisung die Ausgabe der vorherigen verarbeitet. Diese sequentielle Ausführung macht Abfragen leicht lesbar und fehlerfrei, da die Ausführungsreihenfolge mit der Lesereihenfolge übereinstimmt.
Wichtige Punkte:
- Anweisungen werden effektiv sequenziell ausgeführt.
- Jede Anweisung transformiert Daten und übergibt sie an die nächste.
- Dieser Prozess erstellt einen klaren, vorhersehbaren Datenfluss, der komplexe Abfragen vereinfacht.
-
NEXTstartet eine neue Abfragephase. In der nächsten Stufe sind nur die von der vorangegangenenRETURNAussage projizierten Spalten verfügbar. -
UNION,UNION DISTINCT, undUNION ALLdie Ergebnisse vollständiger Abfrageblöcke kombinieren.
Hinweis
Anweisungen haben eine definierte logische Reihenfolge. Schreiben Sie Abfragen nach diesem Datenfluss, anstatt sich auf eine bestimmte physische Ausführungsstrategie zu verlassen.
Beispiel für die Komposition von Anweisungen
Die folgende GQL-Abfrage findet die ersten 10 Personen, die bei Unternehmen mit "Air" im Namen arbeiten, sortiert sie nach vollständigem Namen und gibt ihren vollständigen Namen zusammen mit dem Namen ihrer Unternehmen zurück.
-- Data flows: Match → Let → Filter → Order → Limit → Return
MATCH (p:Person)-[:workAt]->(c:Company)           -- Input: unit table, Output: (p, c) table
LET fullName = p.firstName || ' ' || p.lastName   -- Input: (p, c) table, Output: (p, c, fullName) table
FILTER c.name CONTAINS 'Air'                      -- Input: (p, c, fullName) table, Output: filtered table
ORDER BY fullName                                 -- Input: filtered table, Output: sorted table
LIMIT 10                                          -- Input: sorted table, Output: top 10 rows table
RETURN fullName, c.name AS companyName            -- Input: top 10 rows table
                                                  -- Output: projected (fullName, companyName) result table
Diese Abfrage wird wie folgt ausgeführt:
-
MATCHFindet Leute, die in Unternehmen arbeiten. -
LETerstellt vollständige Namen durch Kombinieren von Vor- und Familiennamen. -
FILTERbehält nur Mitarbeiter von Unternehmen mit "Air" im Firmennamen. -
ORDER BYsortiert nach vollständigem Namen. -
LIMITdie ersten 10 Ergebnisse. -
RETURNSender vollständige Namen und Firmennamen zurück.
Variablen verbinden Ihre Daten
Variablen, z p. B. , cund fullName in den vorherigen Beispielen, tragen Daten zwischen Anweisungen. Wenn Sie einen Variablennamen wiederverwenden, stellt GQL automatisch sicher, dass er sich auf dieselben Daten bezieht und leistungsstarke Verknüpfungsbedingungen erstellt. Variablen werden manchmal auch als Bindungsvariablen bezeichnet.
Sie können Variablen auf unterschiedliche Weise kategorisieren:
Durch Bindungsquelle:
- Mustervariablen – gebunden durch übereinstimmende Diagrammmuster
- Reguläre Variablen – gebunden an andere Sprachkonstrukte
Mustervariablentypen:
-
Elementvariablen – Binden an Diagrammelementverweiswerte
- Knotenvariablen – Binden an einzelne Knoten
- Edgevariablen – Binden an einzelne Kanten
- Pfadvariablen – Binden an Pfadwerte, die übereinstimmende Pfade darstellen
Nach Referenzgrad:
- Singleton-Variablen – Binden an einzelne Elementverweiswerte aus Mustern
- Gruppenvariablen – binden Sie Listen von Elementreferenzwerten aus variablen Längenmustern. Details finden Sie unter Aggregierte Funktionen.
Ausführungsergebnisse und Ergebnisse
Wenn Sie eine Abfrage ausführen, erhalten Sie ein Ausführungsergebnis , das aus:
-
Ein Ergebnis, normalerweise eine Ergebnistabelle mit den Daten aus Ihrer
RETURNAussage. - Statusinformationen , die anzeigen, ob die Abfrage erfolgreich war oder nicht.
Ergebnistabellen
Die Ergebnistabelle (sofern vorhanden) ist das tatsächliche Ergebnis der Abfrageausführung.
Eine Ergebnistabelle enthält Informationen über den Namen und den Typ der Spalten, eine bevorzugte Spaltennamensequenz, die zum Anzeigen von Ergebnissen verwendet werden soll, ob die Tabelle sortiert ist, und die tatsächlichen Zeilen selbst.
Hinweis
Wenn die Ausführung fehlschlägt, ist keine Ergebnistabelle im Ausführungsergebnis enthalten.
Ausgelassene Ergebnisse
GQL definiert außerdem ein ausgelassenes Ergebnis für Aussagen, die niemals Zeilen erzeugen, unabhängig von den Daten oder dem Auswertungsergebnis. Ein ausgelassenes Ergebnis hat den Status " 00001erfolgreicher Abschluss" .
Ein ausgelassenes Ergebnis unterscheidet sich von einer leeren Ergebnistabelle. Eine leere Tabelle bedeutet, dass eine zeilenerzeugende Abfrage ausgewertet wurde, aber keine Zeilen erzeugte. Die Abfrage-API kann ein ausgelassenes Ergebnis mit Ergebnistyp NOTHINGdarstellen.
Graph Reserves ließ Ergebnisse für zukünftige Data Definition Language (DDL) und Data Manipulation Language (DML)-Anweisungen aus. Aktuelle Abfrageanweisungen liefern Tabellenergebnisse, einschließlich leerer Tabellen.
Statusinformationen
Während der Abfrageausführung erkennt der Prozess verschiedene notwürdige Bedingungen, z. B. Fehler oder Warnungen. Jede Bedingung wird von einem Statusobjekt in den Statusinformationen des Ausführungsergebnisses aufgezeichnet.
Die Statusinformationen bestehen aus einem primären Statusobjekt und einer (möglicherweise leeren) Liste anderer Statusobjekte. Das primäre Statusobjekt ist immer vorhanden und gibt an, ob die Abfrageausführung erfolgreich war oder fehlgeschlagen ist.
Jedes Statusobjekt enthält einen fünfstelligen alphanumerischen Code und eine Beschreibung des aufgezeichneten Zustands.
Die Abfrage-API verwendet die folgenden primären Statuscodes:
| API-Statuscode | Bedeutung |
|---|---|
00000 |
Erfolgreicher Abschluss mit mindestens einer Reihe. |
00001 |
Erfolgreicher Abschluss mit ausgeschlossenem Ergebnis. Reserviert für zukünftige DDL- und DML-Unterstützung. |
01000 |
Eine Warnung oder Informationsbedingung. |
02000 |
Derzeit sind keine Zeilen von einer zeilenerzeugenden Abfrage verfügbar. |
42000 |
Ein vom Benutzer korrigierbarer Abfragefehler. |
50000 |
Ein System- oder nicht klassifizierter Fehler. |
Die API bewahrt den kanonischen GQLSTATUS, der von der Abfrage-Engine im _graphaneGqlStatus Mitglied des Diagnosedatensatzes gemeldet wird. Zum Beispiel verwendet numerischer Überlauf den kanonischen GQLSTATUS 22003, während Division durch Null verwendet 22012wird ; beide werden im öffentlichen status.code Feld dargestellt42000.
Von Bedeutung
Im Anwendungscode wird Verwendung status.code für breiten Erfolg und Fehlerbehandlung verwendet. Verwenden Sie die kanonische GQLSTATUS-Diagnose, wenn Sie eine bestimmte Abfragebedingung unterscheiden müssen. Teste den Beschreibungstext nicht, da er variieren kann.
Darüber hinaus können Statusobjekte ein zugrunde liegendes Ursachenstatusobjekt und einen Diagnosedatensatz mit weiteren Informationen enthalten, die die aufgezeichnete Bedingung kennzeichnen.
Wesentliche Konzepte und Anweisungen
In diesem Abschnitt werden die wichtigsten Bausteine behandelt, die Sie zum Schreiben effektiver GQL-Abfragen benötigen. Jedes Konzept baut auf praktische Fähigkeiten zum Schreiben von Abfragen auf.
Diagrammmuster: Struktur finden
Ein Graphenmuster beschreibt die Knoten, Kanten und Pfade, die übereinstimmen sollen. Binden Sie Variablen, wenn spätere Anweisungen auf abgestimmte Elemente verweisen müssen:
MATCH (person:Person)-[employment:workAt]->(company:Company)
RETURN person.firstName, company.name, employment.workFrom
Platzieren Sie ein Prädikat in der Reihenfolge, wenn es definiert, welcher Knoten oder welche Kante am Muster teilnehmen darf:
MATCH (person:Person WHERE person.firstName = 'Alice')
      -[:knows]->(friend:Person)
RETURN friend.firstName, friend.lastName
Verwenden Sie eine Variable wieder, um zwei Musterpositionen zu benötigen, um dasselbe Element zu binden.
Trenne Muster mit Kommas, um größere Graphstrukturen zu erstellen. Verwenden Sie einen Quantor, um {1,4} ein Kantenmuster zu wiederholen und Pfade mit variabler Länge abzugleichen.
Pfadmodi steuern die Wiederverwendung von Elementen innerhalb eines Pfades:
| Pfadmodus | Behavior |
|---|---|
WALK |
Ermöglicht wiederholte Knoten und Kanten. Dieser Modus ist der Standardmodus. |
TRAIL |
Verhindert wiederholte Kanten. |
SIMPLE |
Verhindert wiederholte Knoten, außer bei einem gemeinsamen ersten und letzten Knoten. |
ACYCLIC |
Verhindert alle wiederholten Knoten. |
Ein Pfadsuchpräfix steuert, welche passenden Pfade zurückgegeben werden.
ALL ist der Standardwert.
ANY SHORTEST gibt für jedes Quell-Ziel-Paar einen kürzesten Pfad zurück:
MATCH path = ANY SHORTEST
  (source:Person WHERE source.id = 123u)-[:knows]->{1,4}(target:Person)
RETURN target.id, path_length(path) AS hopCount
Inline-Prädikate schränken die Pfadberechtigung vor der Wegauswahl ein.
Operationen auf Anweisungsebene MATCH ... WHERE und spätere FILTER Operationen sind Postfilter.
Diese Unterscheidung kann die Ergebnisse verändern ANY SHORTEST .
Für definitive Knoten-, Kanten-, Pfad-, Kompositions-, Quantor- und Prädikatplatzierungssemantiken siehe GQL-Graphenmuster. Für aktuelle Streckenbeschränkungen siehe Aktuelle Beschränkungen.
Kernanweisungen
GQL stellt bestimmte Anweisungstypen bereit, die schritt für Schritt zusammenarbeiten, um Ihre Diagrammdaten zu verarbeiten. Das Verständnis dieser Anweisungen ist für die Erstellung effektiver Abfragen unerlässlich.
MATCH-Anweisung
Syntax:
MATCH <graph pattern>, <graph pattern>, ... [ WHERE <predicate> ]
Die MATCH Anweisung verwendet Eingabedaten und findet Diagrammmuster. Es verknüpft Eingabevariablen mit Mustervariablen und gibt alle übereinstimmenen Kombinationen aus.
Eingabe- und Ausgabevariablen:
-- Input: unit table (no columns, one row)
-- Pattern variables: p, c
-- Output: table with (p, c) columns for each person-company match
MATCH (p:Person)-[:workAt]->(c:Company)
Filterung auf Anweisungsebene mithilfe von WHERE:
-- Filter pattern matches
MATCH (p:Person)-[:workAt]->(c:Company) WHERE p.lastName = c.name
Sie können alle Übereinstimmungen nach dem Filtern mithilfe von WHERE. Bei diesem Ansatz wird eine separate FILTER Anweisung vermieden. Bei einem Pfadsuch-Präfix wie ANY SHORTEST, gilt die Anweisungsebene WHERE nach der Pfadwahl. Inline-Prädikate schränken stattdessen ein, welche Pfade zur Auswahl zugelassen sind. Weitere Informationen finden Sie unter Platz-Prädikate vor oder nach der Pfadauswahl.
Verknüpfen mithilfe von Eingabevariablen:
Wenn MATCH es sich nicht um die erste Anweisung handelt, verknüpft sie Eingabedaten mit Mustervergleichen:
...
-- Input: table with 'targetCompany' column
-- Implicit join: targetCompany (equality join)
-- Output: table with (targetCompany, p, r) columns
MATCH (p:Person)-[r:workAt]->(targetCompany)
Von Bedeutung
Graph unterstützt grundlegende und vollständige lineare Aussage-Komposition, einschließlich NEXT. Man kann auch Abfrageblöcke mit UNION, UNION DISTINCT, und UNION ALLkombinieren. Die EXCEPT, INTERSECT, und Set-Operationen OTHERWISE werden noch nicht unterstützt. Weitere Informationen finden Sie im Artikel zu den aktuellen Einschränkungen.
Wichtige Verknüpfungsverhalten:
So MATCH wird's gehandhabt:
- Variable Gleichheit: Eingabevariablen werden mit Mustervariablen mithilfe des Gleichheitsabgleichs verknüpft
-
Innere Verknüpfung: Eingabezeilen ohne Mustervergleiche werden verworfen. Wird für das Verhalten der linken äußeren Verknüpfung verwendet
OPTIONAL MATCH. -
Filterreihenfolge: Anweisungen auf Filter
WHEREnach Mustererkennung und Pfadauswahl - Musterzusammensetzung: Gemeinsame Variablen beschränken Muster auf dasselbe Element. Nicht zusammenhängende Muster bilden ein kartesisches Produkt.
Von Bedeutung
Ein nicht zusammenhängendes Muster ist gültig, aber sein kartesisches Produkt kann viele Zeilen erzeugen. Verwenden Sie gemeinsame Variablen, wenn sich die Muster auf dieselben Graphelemente beziehen sollten.
Fügen Sie Muster mit gemeinsamen Variablen zusammen:
-- Shared variable 'p' joins the two patterns
-- Output: people with both workplace and residence data
MATCH (p:Person)-[:workAt]->(c:Company),
      (p)-[:isLocatedIn]->(city:City)
OPTIONAL MATCH-Anweisung
Syntax:
OPTIONAL MATCH <graph pattern> [ WHERE <predicate> ]
OPTIONAL MATCH funktioniert wie MATCH bei links-outer-join-Semantik. Wenn das Muster keine Übereinstimmung für eine Eingabezeile findet, behält die Abfrage die Zeile mit NULL Werten für nicht übereinstimmende Variablen bei, anstatt sie zu verwerfen.
Example:
-- Find all people and, if available, their workplace
MATCH (p:Person)
OPTIONAL MATCH (p)-[:workAt]->(c:Company)
RETURN p.firstName, p.lastName, c.name AS company_name
Personen, die in keinem Unternehmen arbeiten, werden weiterhin in den Ergebnissen angezeigt NULLfür company_name .
Tipp
Verwenden Sie diese Vorgehensweise OPTIONAL MATCH , wenn Sie Entitäten einschließen möchten, die möglicherweise nicht über eine bestimmte Beziehung verfügen, ähnlich wie eine SQL LEFT JOIN.
LET-Anweisung
Syntax:
LET <variable> = <expression>, <variable> = <expression>, ...
Die LET Anweisung erstellt berechnete Variablen und ermöglicht die Datentransformation in Ihrer Abfragepipeline.
Einfache Variablenerstellung:
MATCH (p:Person)
LET fullName = p.firstName || ' ' || p.lastName
RETURN *
LIMIT 1000
Komplexe Berechnungen:
MATCH (p:Person)
LET adjustedAge = 2000 - (p.birthday / 10000),
    fullProfile = p.firstName || ' ' || p.lastName || ' (' || p.gender || ')'
RETURN *
LIMIT 1000
Schlüsselverhalten:
- Das Abfragemodul wertet Ausdrücke für jede Eingabezeile aus.
- Die Ergebnisse werden zu neuen Spalten in der Ausgabetabelle.
- Variablen können nur auf vorhandene Variablen aus vorherigen Anweisungen verweisen.
- Mehrere Zuweisungen in einer
LETAnweisung verwenden denselben Eingabebereich, daher kann eine Zuweisung keine andere Zuweisung aus dieser Anweisung referenzieren.
FOR-Anweisung
Syntax:
FOR <variable> IN <list_expression>
  [ WITH OFFSET <offset_variable> | WITH ORDINALITY <ordinality_variable> ]
Die Aussage FOR erweitert eine Liste in Zeilen. Für jede Eingabezeile gibt es für jedes Listenelement eine Ausgabezeile aus und bindet dieses Element an die angegebene Variable. Weitere Variablen aus der Eingabezeile bleiben verfügbar.
Verwenden Sie WITH OFFSET , um einen nullbasierten Index zu binden, oder WITH ORDINALITY verwenden Sie, um eine ein-basierte Position zu binden.
LET cities = ['Seattle', 'London', 'Tokyo']
FOR city IN cities WITH ORDINALITY position
RETURN city, position
Diese Abfrage liefert für jede Stadt eine Zeile zurück. Die Werte position sind 1, 2, und 3. Wenn Sie durch ersetzenWITH ORDINALITY position, sind 0die Werte , 1, und 2.WITH OFFSET position
Der Quellausdruck muss zu einer Liste ausgewertet werden. Ein Nicht-Listenwert führt dazu, dass die Abfrage fehlschlägt.
CALL-Anweisung
Verwenden Sie CALL , um für jede Eingabezeile eine Inline-Unterabfrage auszuführen:
CALL {
  <query statements>
  RETURN <columns>
}
Variablen, die bereits im Anwendungsbereich liegen, sind implizit innerhalb der Unterabfrage verfügbar. Von den innerhalb der Unterabfrage erstellten Variablen sind außerhalb der Unteranweisung nur Spalten aus der Endanweisung RETURN verfügbar. Innerhalb der Unterabfrage erstellte, aber nicht zurückgegebene Variablen bleiben lokal.
Die folgende korrelierte Unteranfrage berechnet für jede Person eine Arbeitgeberanzahl:
MATCH (p:Person)
CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN count(*) AS employerCount
}
RETURN p.firstName, p.lastName, employerCount
ORDER BY employerCount DESC
Ein gewöhnliches CALL Element wirkt wie eine abhängige innere Verbindung. Es erzeugt eine Ausgabezeile für jede von der Unterabfrage zurückgegebene Zeile. Wenn die Unterabfrage keine Zeilen zurückgibt, wird die entsprechende äußere Zeile nicht zurückgegeben. Wenn mehrere Zeilen zurückgegeben werden, erscheint die äußere Zeile einmal für jede Unterabfragezeile.
Das vorherige count(*) Beispiel liefert immer eine Unterabfragezeile zurück, da es eine ungruppierte Aggregate verwendet. Eine Person ohne passenden Arbeitgeber hat daher ein employerCount von 0.
Verwenden OPTIONAL CALL Sie es als abhängigen linken Join. Wenn die Unterabfrage keine Zeilen zurückgibt, erhält sie eine äußere Zeile und setzt die zurückgegebenen Unterabfragspalten auf NULL. Wenn die Unterabfrage mehrere Zeilen zurückgibt, erzeugt sie für jede Unterabfragezeile eine Ausgabezeile.
MATCH (p:Person)
OPTIONAL CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN company.name AS companyName
}
RETURN p.firstName, p.lastName, companyName
Du kannst Inline-Subqueries CALL verschachteln. Eine verschachtelte Unterabfrage kann Variablen aus ihren umschließenden Abfragebereichen referenzieren.
Von Bedeutung
Beenden Sie jeden Inline-Body CALL mit RETURN. Graph unterstützt keine benannten Prozeduraufrufe oder explizite Variablenimportlisten wie CALL (p) { ... }.
FILTER-Anweisung
Syntax:
FILTER [ WHERE ] <predicate>
Die FILTER Anweisung bietet eine genaue Kontrolle darüber, welche Daten durch Ihre Abfragepipeline weitergeleitet werden.
Grundlegende Filterung:
MATCH (p:Person)
FILTER p.birthday < 19980101 AND p.gender = 'female'
RETURN *
Komplexe logische Bedingungen:
MATCH (p:Person)
FILTER (p.gender = 'male' AND p.birthday < 19940101)
  OR (p.gender = 'female' AND p.birthday < 19990101)
  OR p.browserUsed = 'Edge'
RETURN *
Filtermuster mit Null-Berücksichtigung:
Verwenden Sie diese Muster, um Nullwerte sicher zu behandeln:
-
Auf Werte überprüfen:
p.firstName IS NOT NULL- hat einen Vornamen -
Validieren von Daten:
p.id > 0- gültige ID -
Behandeln fehlender Daten:
NOT coalesce(p.locationIP, '10.x.x.x') STARTS WITH '10.x.x.x'- Keine Verbindung über das lokale Netzwerk hergestellt -
Kombinieren von Bedingungen: Verwenden mit
AND/ORexpliziten NULL-Prüfungen für komplexe Logik
Vorsicht
Denken Sie daran, dass Bedingungen mit Nullwerten zurückgegeben UNKNOWNwerden, die diese Zeilen herausfiltern. Verwenden Sie explizite IS NULL Prüfungen, wenn Sie null-inklusive Logik benötigen.
ORDER BY-Anweisung
Syntax:
ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ],
         <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ...
Sortierung auf mehreren Ebenen mit berechneten Ausdrücken:
MATCH (p:Person)
RETURN *
ORDER BY p.firstName DESC,               -- Primary: by first name (Z-A)
         p.birthday ASC,                 -- Secondary: by age (oldest first)
         p.id DESC                       -- Tertiary: by ID (highest first)
Nullbehandlung beim Sortieren:
MATCH (p:Person)
RETURN p.firstName, p.birthday
ORDER BY p.birthday DESC NULLS LAST, p.firstName ASC
Details zum Sortierverhalten:
Grundlegendes zur ORDER BY Funktionsweise:
- Das Abfragemodul wertet Ausdrücke für jede Zeile aus und ermittelt dann die Zeilenreihenfolge.
- Mehrere Sortierschlüssel erstellen hierarchische Sortierung (primär, sekundär, tertiär usw.).
-
NULLS FIRSTplatziert Nullwerte vor nicht-nullen Werten.NULLS LASTPlatziert sie nach nicht-null Werten. - Die Nullplatzierung ist unabhängig von der Sortierrichtung. Wenn du keine Nullordnung spezifizierst,
NULLS LASTist die Standardregelung für sowohl als auchASCDESC. -
ASC(aufsteigend) ist die Standardreihenfolge, und Sie müssen explizit (absteigend) angebenDESC. - Sie können nach berechneten Werten sortieren, nicht nur nach gespeicherten Eigenschaften.
| Sortierspezifikation | Resultierende Reihenfolge |
|---|---|
ASC oder ASC NULLS LAST |
Nicht-Nullwerte in aufsteigender Reihenfolge, gefolgt von Nullwerten. |
ASC NULLS FIRST |
Nullwerte, gefolgt von nicht-nullen Werten in aufsteigender Reihenfolge. |
DESC oder DESC NULLS LAST |
Nicht-Nullwerte in absteigender Reihenfolge, gefolgt von Nullwerten. |
DESC NULLS FIRST |
Nullwerte, gefolgt von nicht-nullen Werten in absteigender Reihenfolge. |
Vorsicht
Nur die unmittelbar folgende Anweisung kann die sortierreihenfolge sehen, die ORDER BY eingerichtet wird.
ORDER BY Daher erzeugt gefolgt von RETURN * kein sortiertes Ergebnis.
Vergleichen:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
ORDER BY r.creationDate DESC
/* intermediary result _IS_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
/* final result _IS_ _NOT_ guaranteed to be ordered here  */
Durch:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
/* intermediary result _IS_ _NOT_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
ORDER BY r.creationDate DESC
/* final result _IS_ guaranteed to be ordered here              */
Dieser Unterschied hat unmittelbare Folgen für "Top-k"-Abfragen: LIMIT Muss immer der ORDER BY Anweisung folgen, die die beabsichtigte Sortierreihenfolge festlegt.
OFFSET- und LIMIT-Anweisungen
Syntax:
  OFFSET <offset> [ LIMIT <limit> ]
| LIMIT <limit>
Häufige Muster:
-- Basic top-N query
MATCH (p:Person)
RETURN *
ORDER BY p.id DESC
LIMIT 10                                 -- Top 10 by ID
Von Bedeutung
Verwenden Sie ORDER BY für vorhersagbare Paginierungsergebnisse immer vorher OFFSET , und LIMIT stellen Sie eine konsistente Zeilenreihenfolge über Abfragen hinweg sicher.
RETURN: Grundlegende Ergebnisprojektion
Syntax:
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
[ ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
Die RETURN Anweisung erzeugt die endgültige Ausgabe Ihrer Abfrage, indem angegeben wird, welche Daten in der Ergebnistabelle angezeigt werden.
Grundlegende Ausgabe:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday,
       c.name
Verwenden von Aliasen zur Übersichtlichkeit:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS first_name,
       p.lastName AS last_name,
       c.name AS company_name
Kombinieren mit Sortierung und Top-k:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday AS birth_year,
       c.name AS company
ORDER BY birth_year ASC
LIMIT 10
Duplikatbehandlung mithilfe von DISTINCT:
-- Remove duplicate combinations
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN DISTINCT p.gender, p.browserUsed, p.birthday AS birth_year
ORDER BY p.gender, p.browserUsed, birth_year
Kombinieren mit Aggregation:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN count(DISTINCT p) AS employee_count
RETURN mit GROUP BY: gruppierte Ergebnisprojektion
Syntax:
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
GROUP BY <variable>, <variable>, ...
[ ORDER BY <expression> [ ASC | DESC ], <expression> [ ASC | DESC ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
Wird GROUP BY verwendet, um Zeilen nach freigegebenen Werten zu gruppieren und Aggregatfunktionen innerhalb jeder Gruppe zu berechnen.
Grundlegende Gruppierung mit Aggregation:
MATCH (p:Person)-[:workAt]->(c:Company)
LET companyId = c.id, companyName = c.name
RETURN companyId,
       companyName,
       count(*) AS employeeCount,
       avg(p.birthday) AS avg_birth_year
GROUP BY companyId, companyName
ORDER BY employeeCount DESC
Mehrspaltige Gruppierung:
MATCH (p:Person)
LET gender = p.gender
LET browser = p.browserUsed
RETURN gender,
       browser,
       count(*) AS person_count,
       avg(p.birthday) AS avg_birth_year,
       min(p.creationDate) AS first_joined,
       max(p.id) AS highest_id
GROUP BY gender, browser
ORDER BY avg_birth_year DESC
LIMIT 10
Hinweis
Für horizontale Aggregation über Muster variabler Länge siehe Aggregate Funktionen.
Werte und Werttypen
GQL-Werte umfassen Boolesche Werte, Zeichenketten, numerische, zeitliche Werte, Listen-, Knoten-, Kanten-, Pfad-, Null- und Nullwerte. Typen sind nullerbar, es sei denn, du spezifizierst NOT NULL.
Eigenschaften verwenden eine unterstützte Teilmenge des vollständigen Abfragewertsystems.
RETURN 42 AS integerValue,
       'Alice' AS stringValue,
       TRUE AS booleanValue,
       [1, 2, 3] AS listValue
Vergleiche mit Null evaluieren zu UNKNOWN; verwenden IS NULL und IS NOT NULL für Nulltests. Numerische Operationen können implizite Umrechnungen zwischen kompatiblen numerischen Typen anwenden.
Hinweis
Nicht jeder GQL-Werttyp wird in jedem Graph-Kontext unterstützt. Für aktuelle Eigenschafts- und Abfragebeschränkungen siehe Datentypen.
Für wörtliche Syntax, Vergleichsverhalten, Typkonvertierungen und die Typhierarchie siehe GQL-Werte und Werttypen.
Ausdrücke
Ausdrücke berechnen, vergleichen, aggregieren und transformieren Werte. Gängige Formen umfassen Eigenschaftsreferenzen, arithmetische und logische Operatoren, Prädikate, Funktionsaufrufe, einfache CASE Ausdrücke und Teilabfragen:
MATCH (person:Person)
FILTER person.birthday < 19900101
RETURN person.firstName,
       CASE person.gender
         WHEN 'female' THEN 'F'
         WHEN 'male' THEN 'M'
         ELSE 'Other'
       END AS genderCode
GQL verwendet die dreiwertige Logik: Boolesche Ausdrücke können zu TRUE, FALSE, oder UNKNOWNauswerten. A FILTER behält nur Zeilen, für die sein Prädikat ist TRUE.
Aggregiere Funktionen wie COUNT, SUM, AVG, , MINund MAX fasse Zeilen zusammen. Liste Prädikate wie ALL, ANY, , NONEund SINGLE bearbeite ein Prädikat für Listenelemente. Prozedurformular-Unterabfragen EXISTS testen, ob eine verschachtelte Abfrage eine Zeile zurückgibt.
Für vollständiges Operator-, Prädikat-, Aggregat- und Funktionsverhalten siehe GQL-Ausdrücke, Prädikate und Funktionen. Für aufgabenorientierte Filter- und Gruppierungsbeispiele siehe Filter- und aggregierte Graphendaten.
Erweiterte Abfragetechniken
In diesem Abschnitt werden komplexe Muster und Techniken zum Erstellen komplexer, effizienter Diagrammabfragen behandelt. Diese Muster gehen über die grundlegende Verwendung von Anweisungen hinaus, damit Sie leistungsstarke analytische Abfragen erstellen können.
Komplexe Multistatementkomposition
Von Bedeutung
Graph unterstützt die Komposition von einfachen und vollständigen linearen Anweisungen. Die EXCEPT, INTERSECT, und Set-Operationen OTHERWISE werden noch nicht unterstützt. Weitere Informationen finden Sie im Artikel zu den aktuellen Einschränkungen.
Das effiziente Erstellen komplexer Abfragen ist für die erweiterte Graph-Abfrage von entscheidender Bedeutung.
UNION und UNION ALL
Verwenden UNIONSie , UNION DISTINCT, oder UNION ALL kombinieren Sie Ergebnisse von zwei oder mehr linearen Abfrageblöcken:
<query block>
UNION [ DISTINCT | ALL ]
<query block>
-- Combine results from two separate pattern matches
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS name, c.name AS affiliation
UNION DISTINCT
MATCH (p:Person)-[:studyAt]->(u:University)
RETURN p.firstName AS name, u.name AS affiliation
Bare UNION entspricht UNION DISTINCT; beide entfernen doppelte Zeilen.
UNION ALL behält alle Zeilen bei, einschließlich Duplikaten.
Jeder Abfrageblock muss denselben Satz von Spaltennamen zurückgeben. Die Reihenfolge der Spalten kann zwischen den Blöcken variieren, und die Datentypen müssen kompatibel sein.
NEXT
Verwenden Sie NEXT , um eine weitere Abfragestufe gegen die von der vorhergehende Stufe zurückgegebene Tabelle auszuführen:
<query stage>
RETURN <columns>
NEXT
<query stage>
Die folgende Abfrage findet Mitarbeiter und ihre Unternehmen und verwendet dann die zurückgegebenen Mitarbeiterknoten in einem weiteren Mustermatch:
MATCH (person:Person)-[:workAt]->(company:Company)
RETURN person, company.name AS companyName
NEXT
MATCH (person)-[:isLocatedIn]->(city:City)
RETURN person.firstName AS employee, companyName, city.name AS city
Nur Spalten, die von der vorherigen Stufe zurückgegeben werden, liegen nach NEXT. im Geltungsbereich. Man kann mehrere NEXT Separatoren verwenden, um eine längere Abfolge von Abfragestufen zu erstellen.
Beide Stufen können eine Vereinigung von Abfrageblöcken enthalten. Eine Vereinigung wird innerhalb ihrer Stufe bewertet, bevor die Ausgabe der Stufe die Grenze NEXT überschreitet. Wenn A, B, und C Abfrageblöcke repräsentieren, gruppieren A UNION B NEXT C sie als (A UNION B) NEXT C, während A NEXT B UNION C Gruppen als A NEXT (B UNION C).
Bedingungsanweisungen
Verwenden Sie eine bedingte Anweisung, um jede eingehende Zeile auf den ersten Zweig zu routen, dessen Prädikat zu TRUEauswertet:
WHEN <predicate> THEN <linear query statement or { query statements }>
[ WHEN <predicate> THEN <linear query statement or { query statements }> ... ]
[ ELSE <linear query statement or { query statements }> ]
Um Zeilen aus einer vorhergehenden Abfragephase zu routen, geben Sie die erforderlichen Spalten zurück und verwenden NEXT Sie vor der bedingten Anweisung:
MATCH (p:Person)
RETURN p.firstName AS name, p.birthday AS birthday
NEXT
WHEN birthday < 19800101u THEN
  RETURN name, 'Before 1980' AS era
WHEN birthday < 20000101u THEN
  RETURN name, '1980-1999' AS era
ELSE
  RETURN name, '2000 or later' AS era
Jedes WHEN Prädikat muss boolesch sein. Die Abfrage-Engine bewertet die Prädikate für jede Eingabezeile der Reihe nach. Ein Prädikat, das seinen Zweig auswählt FALSE oder UNKNOWN nicht. Nachdem ein Prädikat auf ausgewertet hat TRUE, werden spätere Prädikate und nicht ausgewählte Zweigkörper nicht mehr bewertet. Wenn kein Prädikat zu TRUE auswertet und es keine ELSEgibt, wird die Eingabezeile nicht zurückgegeben.
Prädikate und Zweigkörper können auf Spalten aus der vorherigen Stufe verweisen. Eine Verzweigung kann eine lineare Aussage sein oder ein verschachteltes Verfahren, das von Stangen umgeben ist. Verwenden Sie ein verschachteltes Verfahren, wenn ein Sprung mehrere Stufen oder Anweisungen benötigt, wie zum Beispiel CALL:
MATCH (p:Person)
RETURN p, p.firstName AS name
NEXT
WHEN p.gender = 'female' THEN {
  CALL {
    MATCH (p)-[:knows]->(friend:Person)
    RETURN count(*) AS friendCount
  }
  RETURN name, friendCount
}
ELSE
  RETURN name, 0u AS friendCount
Jeder Zweig hat seinen eigenen lokalen Bereich. Schwester-Zweige sehen keine Variablen, die von einem anderen Zweig erstellt werden, sondern nur Spalten aus dem endgültigen RETURN Continue des ausgewählten Zweigs nach der bedingten Anweisung. Jeder Sprung muss dieselben Spaltennamen zurückgeben, und die entsprechenden Ergebnistypen müssen kompatibel sein. Die Abfrage-Engine zwingt kompatible Typen zu einem gemeinsamen Ausgabetyp. Eine zurückgegebene Verzweigungsspalte kann denselben Namen wie eine eingehende Spalte tragen; der Verzweigungswert ersetzt den eingehenden Wert in der bedingten Ausgabe.
Bedingte Anweisungen unterscheiden sich von CASE Ausdrücken. Graph unterstützt einfache CASE <expression> WHEN <value>, aber nicht gesuchte CASE WHEN <predicate> Ausdrücke. Für weitere Informationen siehe Bedingte Ausdrücke.
Variabler Bereich und erweiterte Flusssteuerung
Variablen verbinden Daten über Abfrageanweisungen hinweg und ermöglichen komplexe Graph-Traversale. Wenn Sie erweiterte Bereichsregeln verstehen, können Sie komplexe Abfragen mit mehreren Anweisungen schreiben.
Variable Bindungs- und Bereichsmuster
-- Variables flow forward through subsequent statements
MATCH (p:Person)                                    -- Bind p
LET fullName = p.firstName || ' ' || p.lastName     -- Bind concatenation of p.firstName and p.lastName as fullName
FILTER fullName CONTAINS 'Smith'                    -- Filter for fullNames with “Smith” substring (p is still bound)
RETURN p.id, fullName                               -- Only return p.id and fullName (p is dropped from scope)
Variable Wiederverwendung für Verknüpfungen über Anweisungen hinweg
-- Multi-statement joins using variable reuse
MATCH (p:Person)-[:workAt]->(:Company)          -- Find people with jobs
MATCH (p)-[:isLocatedIn]->(:City)               -- Same p: people with both job and residence
MATCH (p)-[:knows]->(friend:Person)             -- Same p: their social connections
RETURN *
Wichtige Bereichsregeln und Einschränkungen
-- ✅ Backward references work
MATCH (p:Person)
LET adult = p.birthday < 20061231  -- Can reference p from previous statement
RETURN *

-- ❌ Forward references don't work
LET adult = p.birthday < 20061231  -- Error: p not yet defined
MATCH (p:Person)
RETURN *

-- ❌ Variables in same LET statement can't reference each other
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName,
    greeting = 'Hello, ' || name     -- Error: name not visible yet
RETURN *

-- ✅ Use separate statements for dependent variables
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName
LET greeting = 'Hello, ' || name     -- Works: name now available
RETURN *
Variable Sichtbarkeit in komplexen Abfragen
-- Variables remain visible until overridden or query ends
MATCH (p:Person)                     -- p available from here
LET gender = p.gender                -- gender available from here
MATCH (p)-[:knows]->(e:Person)       -- p still refers to original person
                                     -- e is a new variable for the friend
RETURN p.firstName AS manager, e.firstName AS friend, gender
Vorsicht
Variablen in derselben Anweisung können nicht miteinander verweisen, außer in Diagrammmustern. Verwenden Sie separate Anweisungen für die abhängige Variablenerstellung.
Aggregierte Zeilen und Wegelemente
GQL unterstützt zwei Aggregationskontexte:
-
Vertikale Aggregation fasst Eingabezeilen zusammen, optional nach
GROUP BYVariablen aufgeteilt. - Die horizontale Aggregation fasst eine Gruppenliste zusammen, die durch ein variables Längen-Kantenmuster innerhalb eines passenden Pfades begrenzt ist.
MATCH (person:Person)-[:workAt]->(company:Company)
LET companyId = company.id, companyName = company.name
RETURN companyId, companyName, count(*) AS employeeCount
GROUP BY companyId, companyName
MATCH (:Person)-[connections:knows]->{1,4}(:Person)
RETURN count(connections) AS pathLength
Für gruppierte Abfragen, aggregatespezifische Filter, Sammlungsaggregate und bedingtes Routing siehe Filter- und Aggregategraph-Daten. Für vollständige Regeln für aggregierte Ergebnisse siehe Aggregierte Funktionen.
Umgang mit Nullen und Abfragefehlern
Verwenden Sie explizite Nulltests, wenn fehlende Werte unterschiedlich behandelt werden müssen:
MATCH (person:Person)
FILTER person.browserUsed IS NULL
RETURN person.firstName
Ein Vergleich mit null bewertet zu UNKNOWN, das a FILTER nicht behält.
Nutze coalesce() es, wenn du einen Rückfallwert brauchst.
Abfrageergebnisse umfassen Statusinformationen für den Erfolg, Warnungen, Datenlosigkeiten, benutzerkorrigierbare Fehler und Systemfehler. Verwenden Sie den öffentlichen Statuscode für einen breiten Kontrollfluss und die kanonische GQLSTATUS-Diagnose für eine bestimmte Bedingung. Siehe Ausführungsergebnisse und -ergebnisse sowie die Referenz zu GQL-Statuscodes.
Reservierte Wörter
GQL reserviert bestimmte Schlüsselwörter, die Sie nicht als Bezeichner wie Variablen, Eigenschaftennamen oder Bezeichnungsnamen verwenden können. Die vollständige Liste finden Sie in der Referenz zu reservierten GQL-Wörtern .
Wenn Sie reservierte Wörter als Bezeichner verwenden müssen, escapeen Sie sie mit Backticks: `match`, `return`.
Verwenden Sie diese Benennungskonvention, um zu vermeiden, reservierte Wörter zu entfernen:
- Fügen Sie bei Bezeichnern mit einem Wort einen Unterstrich an:
:Product_ - Verwenden Sie bei Mehrwort-IDs camelCase oder PascalCase:
:MyEntity,:hasAttributetextColor
Nächste Schritte
- Folgen Sie dem Quickstart- oder GQL-Tutorial für eine praktische Einführung.
- Verwenden Sie Write common GQL-Abfragen für anpassungsfähige Graphaufgaben.
- Verwenden Sie GQL-Graphenmuster, GQL-Ausdrücke, Prädikate und Funktionen sowie GQL-Werte und Wertetypen für detaillierte Referenz.
- Verwenden Sie Design a Graph Schema für den unterstützten Fabric-Modellierungs-Workflow.