Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Gilt für: SQL ServerAzure SQL-DatenbankAzure SQL Managed InstanceAzure Synapse AnalyticsSQL-Datenbank in Microsoft Fabric
SQL Server verwendet Verknüpfungen, um Daten aus mehreren Tabellen basierend auf logischen Beziehungen zwischen ihnen abzurufen. Verknüpfungen sind grundlegend für relationale Datenbankvorgänge und ermöglichen es Ihnen, Daten aus zwei oder mehr Tabellen in einem einzigen Resultset zu kombinieren.
SQL Server implementiert sowohl logische Verknüpfungsvorgänge (definiert durch Transact-SQL-Syntax) als auch physische Verknüpfungsvorgänge (die tatsächlichen Algorithmen, die zum Ausführen der Verknüpfungen verwendet werden). Wenn Sie beide Aspekte verstehen, können Sie effiziente Abfragen schreiben und die Datenbankleistung optimieren.
Logische Verknüpfungsvorgänge umfassen:
- Innere Verknüpfungen
- Linke, rechte und vollständige äußere Verknüpfungen
- Kreuzverknnungen
Physische Verknüpfungsvorgänge umfassen:
- Nested-Loops-Joins
- Zusammenführen von Verknüpfungen
- Hash-Verknüpfungen
- Adaptive Verknüpfungen (Gilt für: SQL Server 2017 (14.x) und höhere Versionen)
In diesem Artikel wird erläutert, wie Verknüpfungen funktionieren, wann verschiedene Verknüpfungstypen verwendet werden sollen, und wie der Abfrageoptimierer den effizientesten Verknüpfungsalgorithmus basierend auf Faktoren wie Tabellengröße, verfügbaren Indizes und Datenverteilung auswählt.
Note
Weitere Informationen zur Verknüpfungssyntax finden Sie unter FROM-Klausel plus JOIN, APPLY, PIVOT.
Sich den Grundlagen anschließen
Mithilfe von Joins können Sie Daten aus zwei oder mehr Tabellen basierend auf logischen Beziehungen zwischen den Tabellen abrufen. Joins zeigen an, wie SQL Server Daten aus einer Tabelle zum Auswählen der Zeilen in einer anderen Tabelle verwenden soll.
Eine Joinbedingung definiert die Beziehung zweier Tabellen in einer Abfrage auf folgende Art:
- Angeben der Spalte aus jeder Tabelle, die für den Join verwendet werden soll. Eine typische Joinbedingung gibt einen Fremdschlüssel aus einer Tabelle und den zugehörigen Schlüssel in der anderen Tabelle an.
- Sie gibt auch einen logischen Operator (z. B. = oder <>) an, der zum Vergleichen der Werte aus den Spalten verwendet werden soll.
Joins werden mithilfe der folgenden Transact-SQL-Syntax logisch ausgedrückt:
[ INNER ] JOINLEFT [ OUTER ] JOINRIGHT [ OUTER ] JOINFULL [ OUTER ] JOINCROSS JOIN
Inner Joins können entweder in der FROM- oder der WHERE-Klausel angegeben werden.
Outer Joins und Cross Joins können nur in der FROM-Klausel verwendet werden. Die Joinbedingungen in Verbindung mit WHERE- und HAVING-Suchbedingungen steuern, welche Zeilen aus den Basistabellen ausgewählt werden, auf die in der FROM-Klausel verwiesen wird.
Das Angeben der Joinbedingungen in der FROM-Klausel trägt dazu bei, dass diese von anderen, möglicherweise in einer WHERE-Klausel angegebenen Suchbedingungen getrennt werden. Dies ist die empfohlene Methode zur Angabe von Joins. Eine vereinfachte ISO-Joinsyntax für eine FROM-Klausel lautet:
FROM first_table < join_type > second_table [ ON ( join_condition ) ]
- join_type gibt an, welche Art von Join ausgeführt wird: innerer Join, äußerer Join oder Cross Join. Erläuterungen zu den verschiedenen Jointypen finden Sie unter FROM-Klausel.
- Die join_condition definiert das Prädikat, das für jedes verknüpfte Zeilenpaar ausgewertet werden soll.
Der folgende Code ist ein Beispiel für die Joinspezifizierung einer FROM-Klausel:
FROM Purchasing.ProductVendor INNER JOIN Purchasing.Vendor
     ON ( ProductVendor.BusinessEntityID = Vendor.BusinessEntityID )
Der folgende Code ist ein Beispiel für eine einfache SELECT-Anweisung mithilfe dieses Joins:
SELECT ProductID, Purchasing.Vendor.BusinessEntityID, Name
FROM Purchasing.ProductVendor INNER JOIN Purchasing.Vendor
    ON (Purchasing.ProductVendor.BusinessEntityID = Purchasing.Vendor.BusinessEntityID)
WHERE StandardPrice > $10
  AND Name LIKE N'F%';
GO
Die SELECT-Anweisung gibt die Produkt- und Lieferanteninformationen für alle Kombinationen der Teile zurück, die von einer Firma geliefert werden, deren Firmenname mit dem Buchstaben F beginnt, und bei denen der Produktpreis über 10 USD liegt.
Wenn in einer einzigen Abfrage auf mehrere Tabellen verwiesen wird, müssen alle Spaltenverweise eindeutig sein. Im vorherigen Beispiel verfügt sowohl die ProductVendor- als auch die Vendor-Tabelle über eine Spalte mit der Bezeichnung BusinessEntityID. Alle Spaltennamen, die in zwei oder mehr Tabellen vorkommen, auf die in der Abfrage verwiesen wird, müssen mit dem Tabellennamen gekennzeichnet werden. Alle Verweise auf die Vendor-Spalten im Beispiel sind gekennzeichnet.
Wenn ein Spaltenname nicht in zwei oder mehr Tabellen dupliziert wird, die in der Abfrage verwendet werden, müssen Verweise darauf nicht mit dem Tabellennamen qualifiziert werden. Dies ist im vorherigen Beispiel dargestellt.
SELECT Eine solche Klausel ist manchmal schwer zu verstehen, da es nichts gibt, um die Tabelle anzugeben, die jede Spalte bereitgestellt hat. Die Lesbarkeit der Abfrage wird verbessert, indem alle Spalten mit dem entsprechenden Tabellennamen gekennzeichnet werden. Die Übersichtlichkeit kann weiterhin durch Verwenden von Tabellenaliasnamen verbessert werden, besonders, wenn die Tabellennamen mit dem Datenbank- und Besitzernamen gekennzeichnet werden müssen. Der folgende Code unterscheidet sich vom vorherigen nur dadurch, dass Tabellenaliasnamen zugewiesen und die Spalten der Übersichtlichkeit halber mit Tabellenaliasnamen gekennzeichnet wurden:
SELECT pv.ProductID, v.BusinessEntityID, v.Name
FROM Purchasing.ProductVendor AS pv
INNER JOIN Purchasing.Vendor AS v
    ON (pv.BusinessEntityID = v.BusinessEntityID)
WHERE StandardPrice > $10
    AND Name LIKE N'F%';
In den vorhergehenden Beispielen wurden die Joinbedingungen in der FROM-Klausel angegeben. Dies ist die bevorzugte Methode. Die folgende Abfrage enthält dieselbe Joinbedingung, die in der WHERE-Klausel angegeben wird:
SELECT pv.ProductID, v.BusinessEntityID, v.Name
FROM Purchasing.ProductVendor AS pv, Purchasing.Vendor AS v
WHERE pv.BusinessEntityID=v.BusinessEntityID
    AND StandardPrice > $10
    AND Name LIKE N'F%';
Die SELECT-Liste für einen Join kann auf alle Spalten in den verknüpften Tabellen oder auf eine beliebige Teilmenge der Spalten verweisen. Die SELECT Liste ist nicht erforderlich, um Spalten aus jeder Tabelle in der Verknüpfung zu enthalten. So kann beispielsweise bei der Verknüpfung von drei Tabellen nur eine Tabelle verwendet werden, um als Brücke zwischen einer der anderen Tabellen und der dritten Tabelle zu dienen, und in der SELECT-Liste muss auf keine der Spalten aus der mittleren Tabelle Bezug genommen werden. Dies wird auch als Antisemijoin bezeichnet.
Obwohl Joinbedingungen normalerweise Übereinstimmungsvergleiche (=) enthalten, können andere Vergleichsoperatoren oder relationale Operatoren ebenso wie andere Prädikate angegeben werden. Weitere Informationen finden Sie unter Vergleichsoperatoren und WHERE.
Beim Verarbeiten von Joins durch SQL Server wählt der Abfrageoptimierer (aus verschiedenen Möglichkeiten) die effizienteste Methode aus. Dies umfasst die Auswahl des effizientesten Typs der physischen Verknüpfung, die Reihenfolge, in der die Tabellen verknüpft werden, und sogar mithilfe von Typen logischer Verknüpfungen, die nicht direkt mit Transact-SQL Syntax ausgedrückt werden können, z. B. Semi-Verknüpfungen und Anti-Semi-Verknüpfungen. Die physische Ausführung verschiedener Verknüpfungen kann viele verschiedene Optimierungen verwenden und daher nicht zuverlässig vorhergesagt werden. Weitere Informationen zu Semiverknüpfungen und Anti-Semi-Verknüpfungen finden Sie unter Referenz für logische und physische Showplan-Operatoren.
Spalten, die in einer Verknüpfungsbedingung verwendet werden, müssen nicht denselben Namen haben oder denselben Datentyp aufweisen. Wenn die Datentypen jedoch nicht identisch sind, müssen sie kompatibel sein oder Typen sein, die SQL Server implizit konvertieren kann. Wenn die Datentypen nicht implizit konvertiert werden können, muss die Verknüpfungsbedingung den Datentyp explizit mithilfe der CAST Funktion konvertieren. Weitere Informationen zu impliziten und expliziten Konvertierungen finden Sie unter Datentypkonvertierung (Datenbankmodul).
Die meisten Abfragen, die einen Join verwenden, können in eine Unterabfrage (eine in eine andere Abfrage geschachtelte Abfrage) umgeschrieben werden, und die meisten Unterabfragen können in Joins umgeschrieben werden. Weitere Informationen zu Unterabfragen finden Sie unter Unterabfragen (SQL Server).For more information about subqueries, see Subqueries (SQL Server).
Note
Tabellen können nicht direkt in ntext-, Text- oder Bildspalten verknüpft werden. Tabellen können jedoch mithilfe von SUBSTRING indirekt über ntext-, text- oder image-Spalten verknüpft werden.
SELECT * FROM t1 JOIN t2 ON SUBSTRING(t1.textcolumn, 1, 20) = SUBSTRING(t2.textcolumn, 1, 20) führt z. B. einen inneren Join zwischen zwei Tabellen auf den ersten 20 Zeichen jeder Textspalte in den Tabellen t1 und t2 aus.
Außerdem können ntext- oder text-Spalten aus zwei Tabellen verglichen werden, indem die Längen der Spalten mithilfe einer WHERE-Klausel wie im folgenden Beispiel verglichen werden: WHERE DATALENGTH(p1.pr_info) = DATALENGTH(p2.pr_info).
Grundlegendes zu Nested Loops-Joins
Wenn eine Joineingabe klein (weniger als 10 Zeilen) und die andere Joineingabe relativ umfangreich ist und indizierte Joinspalten aufweist, ist ein indizierter Nested Loops-Join der schnellste Joinvorgang, da sie mit dem geringsten E/A-Aufkommen und den wenigsten Vergleichen auskommen.
Der Nested-Loops-Join, auch als geschachtelte Iteration bezeichnet, verwendet eine Joineingabe als äußere Eingabetabelle (im grafischen Ausführungsplan als obere Eingabe dargestellt) und eine als innere (untere) Eingabetabelle. Die äußere Schleife verarbeitet die äußere Eingabetabelle zeilenweise. Die innere Schleife wird für jede äußere Zeile ausgeführt und sucht übereinstimmende Zeilen in der inneren Eingabetabelle.
Im einfachsten Fall durchsucht die Suche eine ganze Tabelle oder einen ganzen Index; dies wird als naive nested loops join bezeichnet. Wenn die Suche einen Index ausnutzt, wird er als Index geschachtelte Schleifenverbindung bezeichnet. Wenn der Index als Teil des Abfrageplans erstellt wird (und nach Abschluss der Abfrage zerstört wird), wird er als temporärer Index-Nested-Loops-Join bezeichnet. Alle beschriebenen Varianten werden vom Abfrageoptimierer berücksichtigt.
Ein Nested Loops-Join ist besonders wirksam, wenn die äußere Eingabe klein und die innere Eingabe vorindiziert und umfangreich ist. Bei vielen kleinen Vorgängen, etwa solchen, die nur wenige Zeilen betreffen, sind Index-Nested-Loop-Joins sowohl Merge-Joins als auch Hash-Joins überlegen. In umfangreichen Abfragen dagegen sind Nested Loops-Joins häufig nicht die optimale Wahl.
Wenn das Attribut „OPTIMIZED“ eines Nested-Loops-Joinoperators auf True festgelegt ist, bedeutet dies, dass ein optimierter Nested-Loops-Join (oder eine Batchsortierung) verwendet wird, um E/A-Vorgänge zu minimieren, wenn die Tabelle auf der inneren Seite groß ist, unabhängig davon, ob er parallelisiert wird oder nicht. Das Vorhandensein dieser Optimierung in einem bestimmten Plan ist beim Analysieren eines Ausführungsplans möglicherweise nicht offensichtlich, da die Sortierung selbst ein verborgener Vorgang ist. Ein Blick in die Plan-XML auf das Attribut „OPTIMIZED“ weist jedoch darauf hin, dass der Nested-Loops-Join möglicherweise versucht, die Eingabezeilen neu anzuordnen, um die E/A-Leistung zu verbessern.
Zusammenführen von Verknüpfungen
Wenn die beiden Join-Eingaben nicht klein sind, aber in ihrer Join-Spalte sortiert sind (z. B. wenn sie durch Scannen von sortierten Indizes abgerufen wurden), ist ein Merge-Join der schnellste Join-Vorgang. Sind beide Joineingaben umfangreich und etwa gleich groß, so bietet ein Zusammenführungsjoin mit vorherigem Sortiervorgang und ein Hashjoin vergleichbares Leistungsverhalten. Hashjoinvorgänge sind jedoch häufig erheblich schneller, wenn sich beide Eingaben im Umfang deutlich unterscheiden.
Für den Merge-Join müssen beide Eingaben in den Zusammenführungsspalten sortiert werden, die durch die Gleichheitsklauseln (ON) des Join-Prädikats definiert werden. Der Abfrageoptimierer durchsucht in der Regel einen Index, sofern ein solcher für den entsprechenden Satz von Spalten vorhanden ist, oder platziert unter dem Merge Join einen Sortieroperator. In seltenen Fällen kann es mehrere Gleichheitsklauseln geben, aber die Zusammenführungsspalten werden nur aus einigen der verfügbaren Gleichheitsklauseln ausgewählt.
Da die Eingaben sortiert vorliegen, ruft der Merge Join-Operator von jeder Eingabe jeweils eine Zeile ab und vergleicht diese. Beispielsweise werden bei inneren Joins die Zeilen zurückgegeben, wenn sie gleich sind. Wenn sie nicht gleich sind, wird die Zeile mit niedrigeren Werten verworfen, und eine andere Zeile wird aus dieser Eingabe abgerufen. Dieser Vorgang wird wiederholt, bis alle Zeilen verarbeitet wurden.
Der Mergejoinvorgang ist entweder ein normaler Vorgang oder eine Viele-zu-viele-Operation. Ein Viele-zu-Viele-Merge-Join verwendet eine temporäre Tabelle, um Zeilen zu speichern. Treten bei den Eingaben doppelte Werte auf, so muss eine Eingabe bis zum ersten Duplikat zurückgespult werden, damit alle Duplikate der anderen Eingabe verarbeitet werden können.
Ist ein Residualprädikat vorhanden, so werten alle Zeilen, die dem Zusammenführungsprädikat genügen, das Residualprädikat aus. Nur die Zeilen werden zurückgegeben, die auch dem Residualprädikat genügen.
Der Merge-Join selbst ist sehr schnell, kann aber eine kostspielige Wahl sein, wenn Sortieroperationen erforderlich sind. Wenn jedoch die Datenmenge groß ist und die gewünschten Daten vorsortiert aus vorhandenen B-Baum-Indizes bezogen werden können, ist der Merge Join häufig der schnellste verfügbare Join-Algorithmus.
Hash-Verknüpfungen
Hashjoins können umfangreiche, unsortierte, nicht indizierte Eingaben effizient verarbeiten. Sie sind für Zwischenergebnisse in komplexen Abfragen aus folgenden Gründen nützlich:
- Zwischenergebnisse werden nicht indiziert (es sei denn, sie werden explizit auf dem Datenträger gespeichert und dann indiziert) und werden häufig nicht entsprechend für den nächsten Vorgang im Abfrageplan sortiert.
- Abfrageoptimierer schätzen nur die Größe von Zwischenergebnissen ab. Weil Schätzungen bei komplexen Abfragen sehr ungenau sein können, müssen Algorithmen zur Verarbeitung von Zwischenergebnissen nicht nur effizient sein, sondern auch robust reagieren, wenn sich ein Zwischenergebnis als deutlich größer als erwartet herausstellt.
Der Hash-Join ermöglicht eine Verringerung des Einsatzes der Denormalisierung. Die Denormalisierung wird in der Regel verwendet, um bessere Leistung durch Reduzierung der Joinvorgänge zu erreichen, und zwar trotz der Redundanzgefahr wie beispielsweise durch inkonsistente Updates. Hashjoins vermindern den Bedarf, die Denormalisierung durchzuführen. Hashjoins ermöglichen die vertikale Partitionierung (die Darstellung von Spaltengruppen aus einer einzelnen Tabelle in separate Dateien oder Indizes), wodurch sie zu einer beachtenswerten Option für den physischen Datenbankentwurf wird.
Der Hashjoin verfügt über zwei Eingaben: die Erstellungseingabe und die Untersuchungseingabe. Der Abfrageoptimierer weist diese Rollen so zu, dass die kleinere Eingabe als Erstellungseingabe verwendet wird.
Hash-Joins werden für viele Arten von Mengenabgleichsoperationen verwendet: INNER JOIN (innerer Join), LEFT OUTER JOIN, RIGHT OUTER JOIN und FULL OUTER JOIN (linker, rechter und voller äußerer Join), LEFT SEMI-JOIN und RIGHT SEMI-JOIN (linker und rechter Semijoin), INTERSECTION (Schnittmenge), UNION (Vereinigungsmenge) und DIFFERENCE (Differenzmenge). Darüber hinaus können mit einer Variante des Hashjoins Duplikate entfernt und Gruppierungen vorgenommen werden, z.B. SUM(salary) GROUP BY department. Diese Änderungen verwenden nur eine Eingabe sowohl für die Build- als auch für die Probe-Rolle.
In den folgenden Abschnitten werden verschiedene Arten von Hash-Joins beschrieben: Hash-Join im Arbeitsspeicher, Grace-Hash-Join und rekursiver Hash-Join.
Arbeitsspeicherinterne Hashjoins
Der Hashjoin scannt oder berechnet zuerst die gesamte Erstellungseingabe und erstellt dann eine Hashtabelle im Arbeitsspeicher. Jede Zeile wird in ein Hashbucket eingefügt, abhängig von dem für den Hashschlüssel berechneten Hashwert. Wenn die gesamte Erstellungseingabe kleiner als der verfügbare Arbeitsspeicher ist, können alle Zeilen in die Hashtabelle eingefügt werden. Auf diese Erstellungsphase folgt die Untersuchungsphase. Die gesamte Untersuchungseingabe wird zeilenweise gescannt oder berechnet, und für jede Untersuchungszeile wird der Wert des Hashschlüssels berechnet, das entsprechende Hashbucket wird gescannt, und die Übereinstimmungen werden erzeugt.
Grace-Hash-Join
Wenn die Buildeingabe nicht in den Arbeitsspeicher passt, wird eine Hash-Verknüpfung in mehreren Schritten durchgeführt. Dies wird als Grace-Hash-Join bezeichnet. Jeder Schritt besteht aus einer Erstellungsphase und einer Untersuchungsphase. Zuerst wird die gesamte Erstellungseingabe und Untersuchungseingabe verarbeitet und (durch Anwenden einer Hashfunktion auf die Hashschlüssel) in mehrere Dateien aufgeteilt. Durch Anwenden der Hashfunktion auf die Hashschlüssel wird sichergestellt, dass die zwei zu verknüpfenden Datensätze sich stets in demselben Dateipaar befinden. So wird die Aufgabe, zwei umfangreiche Eingaben zu verknüpfen, auf mehrere kleinere gleichartige Teilaufgaben reduziert. Der Hashjoin wird dann auf jedes Paar partitionierter Dateien angewendet.
Rekursive Hashjoins
Wenn die Erstellungseingabe so umfangreich ist, dass Eingaben für einen standardmäßigen externen Mergeprozess mehrere Mergeebenen erfordern würden, sind mehrere Partitionierungsschritte und mehrere Partitionierungsebenen erforderlich. Sind nur einige Partitionen umfangreich, so sind zusätzliche Partitionierungsschritte nur für diese Partitionen erforderlich. Um alle Partitionierungsschritte möglichst schnell zu machen, werden umfangreiche, asynchrone E/A-Operationen verwendet, sodass bereits ein Thread mehrere Datenträger auslastet.
Note
Wenn die Build-Eingabe nur geringfügig größer als der verfügbare Arbeitsspeicher ist, werden Elemente des In-Memory-Hash-Joins und des Grace-Hash-Joins in einem einzigen Schritt kombiniert, wodurch ein hybrider Hash-Join entsteht.
Während der Optimierung ist es nicht immer möglich, zu bestimmen, welche Hash-Verknüpfung verwendet wird. Daher verwendet SQL Server zunächst einen speicherinternen Hashjoin und wechselt dann abhängig von der Größe der Build-Eingabe schrittweise zu einem Grace-Hashjoin und einem rekursiven Hashjoin.
Wenn der Abfrageoptimierer falsch einschätzt, welche Eingabe kleiner ist und daher als Erstellungseingabe verwendet werden müsste, werden die Rollen der Erstellungs- und der Untersuchungseingabe dynamisch vertauscht. Der Hashjoin stellt sicher, dass die kleinere Überlaufdatei als Erstellungseingabe verwendet wird. Diese Technik wird als Rollentausch bezeichnet. Ein Rollentausch tritt innerhalb des Hashjoins nach mindestens einem Überlauf auf den Datenträger auf.
Note
Der Rollentausch tritt unabhängig von Abfragehinweisen oder von der Struktur auf. Die Rollenumkehr wird in Ihrem Abfrageplan nicht angezeigt. wenn sie auftritt, ist sie für den Benutzer transparent.
Hash-Rettung
Der Begriff „hash bailout“ wird manchmal zur Bezeichnung von Grace-Hash-Joins oder rekursiven Hash-Joins verwendet.
Note
Rekursive Hashjoins oder Hashabbrüche verursachen eine reduzierte Leistung auf dem Server. Wenn in einem Trace viele Hash Warning-Ereignisse angezeigt werden, sollten Sie die Statistiken der Spalten aktualisieren, die verknüpft werden.
Weitere Informationen zum Hash-Abbruch finden Sie unter Ereignisklasse „Hash Warning“.
Adaptive Verknüpfungen
Adaptive Joins im Batchmodus ermöglichen es, die Wahl einer Joinmethode – eines Hash Join oder eines Joins mit geschachtelten Schleifen – bis nach dem Scannen der ersten Eingabe zurückzustellen. Der Adaptive-Join-Operator definiert einen Schwellenwert, der verwendet wird, um zu entscheiden, wann zu einem Nested-Loops-Plan gewechselt wird. Daher kann ein Abfrageplan während der Ausführung dynamisch zu einer passenderen Joinstrategie wechseln, ohne dass er erneut kompiliert werden muss.
Tip
Workloads mit häufigen Schwankungen zwischen kleinen und großen Scans der Join-Eingaben profitieren am meisten von dieser Funktion.
Die Laufzeitentscheidung basiert auf den folgenden Schritten:
- Wenn die Anzahl der Zeilen der Buildjoineingabe so klein ist, dass ein Join geschachtelter Schleifen passender wäre als ein Hashjoin, wechselt der Plan zu einem Algorithmus geschachtelter Schleifen.
- Wenn die Buildjoineingabe eine bestimmte Anzahl an Zeilen übersteigt, wird nicht gewechselt, und der Plan wird mit einem Hashjoin fortgesetzt.
Die folgende Abfrage wird verwendet, um ein Beispiel für einen Adaptive Join zu veranschaulichen:
SELECT [fo].[Order Key], [si].[Lead Time Days], [fo].[Quantity]
FROM [Fact].[Order] AS [fo]
INNER JOIN [Dimension].[Stock Item] AS [si]
       ON [fo].[Stock Item Key] = [si].[Stock Item Key]
WHERE [fo].[Quantity] = 360;
Die Abfrage gibt 336 Zeilen zurück. Bei Aktivierung der Liveabfragestatistik wird der folgende Plan angezeigt:

Beachten Sie im Plan Folgendes:
- Ein Columnstore-Indexscan diente dazu, Zeilen für die Buildphase eines Hashjoins bereitzustellen.
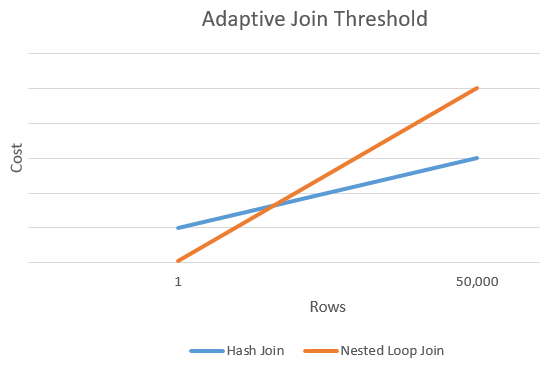
- Der neue Adaptive Join-Operator. Dieser Operator definiert einen Schwellenwert, der verwendet wird, um zu entscheiden, wann zu einem Nested-Loops-Plan gewechselt werden soll. In diesem Beispiel entspricht der Schwellenwert 78 Zeilen. Alles mit >= 78 Zeilen verwendet einen Hashjoin. Wenn der Wert unter dem Schwellenwert liegt, wird ein Nested-Loops-Join verwendet.
- Da von der Abfrage 336 Zeilen zurückgegeben werden, wird der Schwellenwert überschritten. Deshalb stellt der zweite Branch die Überprüfungsphase eines standardmäßigen Hashjoinvorgangs dar. Die Live-Abfragestatistik zeigt die Zeilen an, die durch die Operatoren fließen – in diesem Fall „672 von 672“.
- Und der letzte Zweig ist ein Clustered-Index-Seek zur Verwendung durch den Nested-Loops-Join, falls der Schwellenwert nicht überschritten worden wäre. Es werden „0 von 336“ Zeilen angezeigt (der Zweig ist ungenutzt).
Vergleichen Sie den Plan nun mit derselben Abfrage, dieses Mal aber mit einem Quantity-Wert, der nur eine Zeile in der Tabelle hat:
SELECT [fo].[Order Key], [si].[Lead Time Days], [fo].[Quantity]
FROM [Fact].[Order] AS [fo]
INNER JOIN [Dimension].[Stock Item] AS [si]
       ON [fo].[Stock Item Key] = [si].[Stock Item Key]
WHERE [fo].[Quantity] = 361;
Die Abfrage gibt eine Zeile zurück. Bei Aktivierung der „Liveabfragestatistik“ wird der folgende Plan angezeigt:

Beachten Sie im Plan Folgendes:
- Da nun eine Zeile zurückgegeben wird, fließen jetzt Zeilen durch den Clustered Index Seek.
- Und da die Hash-Join-Buildphase nicht fortgesetzt wurde, gibt es keine Zeilen, die durch die zweite Verzweigung fließen.
Hinweise zu Adaptive Join
Adaptive Joins erfordern einen höheren Speicherbedarf als ein äquivalenter Plan mit einem indizierten Nested-Loops-Join. Der zusätzliche Speicher wird so angefordert, als wäre Nested Loops eine Hash-Verknüpfung. Außerdem besteht ein Aufwand für die Buildphase, die als Stop-and-Go-Vorgang im Vergleich zu einer geschachtelten Schleifen-Streaming-Äquivalent-Verknüpfung erfolgt. Dieser zusätzliche Aufwand geht mit Flexibilität für Szenarios einher, in denen die Zeilenzahl in der Buildeingabe schwankt.
Adaptive Joins im Batchmodus funktionieren bei der ersten Ausführung einer Anweisung. Nach der ersten Kompilierung bleiben aufeinanderfolgende Ausführungen adaptiv, basierend auf dem Schwellenwert des kompilierten adaptiven Joins und den Laufzeitzeilen, die die Buildphase der äußeren Eingabe durchlaufen.
Wenn ein Adaptive Join zu einem Nested-Loops-Vorgang wechselt, verwendet er die Zeilen, die bereits in der Buildphase des Hash Join gelesen wurden. Der Operator liest die Zeilen der äußeren Referenz nicht erneut.
Nachverfolgen der Aktivität adaptiver Joins
Der Adaptive Join-Operator weist die folgenden Attribute des Planoperators auf:
| Plan-Attribut | Description |
|---|---|
| AdaptiveThresholdRows | Gibt den beim Wechsel von einem Hashjoin zu einem Nested Loop-Join zu verwendenden Schwellenwert an |
| EstimatedJoinType | Gibt den erwarteten Jointyp an |
| ActualJoinType | In einem tatsächlichen Plan wird angezeigt, welcher Join-Algorithmus auf Grundlage des Schwellenwerts letztendlich ausgewählt wurde. |
Der geschätzte Plan zeigt die Planform von Adaptive Join sowie den definierten Adaptive-Join-Schwellenwert und den geschätzten Jointyp an.
Tip
Der Abfragespeicher erfasst einen adaptiven Joinplan im Batchmodus und kann diesen erzwingen.
Für adaptive Verknüpfungen geeignete Anweisungen
Einige Bedingungen müssen erfüllt sein, damit ein logischer Join für einen Adaptive Join im Batchmodus geeignet ist:
- Der Datenbank-Kompatibilitätsgrad ist 140 oder höher.
- Die Abfrage ist eine
SELECT-Anweisung (Anweisungen zur Datenänderung sind aktuell nicht verfügbar). - Der Join kann sowohl vom physischen Algorithmus eines indizierten Joins geschachtelter Schleifen als auch eines Hashjoins ausgeführt werden.
- Der Hash Join arbeitet im Batchmodus, der durch das Vorhandensein eines Columnstore-Index in der Abfrage insgesamt, durch eine mit einem Columnstore-Index versehene Tabelle, auf die der Join direkt verweist, oder durch die Verwendung von Batch mode on rowstore aktiviert wird.
- Die generierten alternativen Ausführungspläne für den Nested-Loops-Join und den Hash-Join sollten dasselbe erste Kind haben (äußere Referenz).
Adaptive Schwellenwertzeilen
Das folgende Diagramm zeigt einen beispielhaften Schnittpunkt zwischen den Kosten eines Hash-Joins und den Kosten einer alternativen Nested-Loops-Join-Strategie. Am Überschneidungspunkt wird der Schwellenwert bestimmt, der wiederum den für den Joinvorgang verwendeten Algorithmus bestimmt.
Deaktivieren von adaptiven Joins ohne Änderung des Kompatibilitätsgrads
Adaptive Joins können auf Datenbank- oder Anweisungsebene deaktiviert werden, während die Datenbankkompatibilitätsebene 140 oder höher beibehalten wird.
Führen Sie die folgende Anweisung im Kontext der betreffenden Datenbank aus, um adaptive Joins für alle Abfrageausführungen zu deaktivieren, die aus der Datenbank stammen:
-- SQL Server 2017
ALTER DATABASE SCOPED CONFIGURATION SET DISABLE_BATCH_MODE_ADAPTIVE_JOINS = ON;

-- Azure SQL Database, SQL Server 2019 and later versions
ALTER DATABASE SCOPED CONFIGURATION SET BATCH_MODE_ADAPTIVE_JOINS = OFF;
Ist diese Einstellung aktiviert, wird sie in sys.database_scoped_configurations als aktiviert aufgeführt.
Um adaptive Joins für alle Abfrageausführungen wieder zu aktivieren, die aus der Datenbank stammen, führen Sie die folgende Anweisung im Kontext der betroffenen Datenbank aus:
-- SQL Server 2017
ALTER DATABASE SCOPED CONFIGURATION SET DISABLE_BATCH_MODE_ADAPTIVE_JOINS = OFF;

-- Azure SQL Database, SQL Server 2019 and later versions
ALTER DATABASE SCOPED CONFIGURATION SET BATCH_MODE_ADAPTIVE_JOINS = ON;
Durch Festlegen von DISABLE_BATCH_MODE_ADAPTIVE_JOINS als USE HINT-Abfragehinweis können adaptive Joins für eine bestimmte Abfrage auch deaktiviert werden. Beispiel:
SELECT s.CustomerID,
       s.CustomerName,
       sc.CustomerCategoryName
FROM Sales.Customers AS s
LEFT OUTER JOIN Sales.CustomerCategories AS sc
       ON s.CustomerCategoryID = sc.CustomerCategoryID
OPTION (USE HINT('DISABLE_BATCH_MODE_ADAPTIVE_JOINS'));
Note
Ein USE HINT Abfragehinweis hat Vorrang vor einer Konfigurations- oder Ablaufverfolgungskennzeichnungseinstellung für die Datenbank.
NULL-Werte und Joins
Wenn in den Spalten der verknüpften Tabellen Nullwerte vorhanden sind, stimmen die Nullwerte nicht miteinander überein. Das Vorhandensein von NULL-Werten in einer Spalte aus einer der verknüpften Tabellen kann nur mithilfe eines äußeren Joins zurückgegeben werden (wenn die WHERE-Klausel keine NULL-Werte ausschließt).
Es folgen zwei Tabellen, bei denen NULL in der Spalte enthalten ist, die Bestandteil des Joins ist.
table1                          table2
a           b                   c            d
-------     ------              -------      ------
      1        one                 NULL         two
   NULL      three                    4        four
      4      join4
Eine Verknüpfung, die die Werte in Spalte a mit Spalte c vergleicht, erhält keine Übereinstimmung für die Spalten mit Werten von NULL:
SELECT *
FROM table1 t1 JOIN table2 t2
   ON t1.a = t2.c
ORDER BY t1.a;
GO
Nur eine Zeile mit dem Wert 4 in der Spalte a und c wird zurückgegeben:
a           b      c           d
----------- ------ ----------- ------
4           join4  4           four

(1 row(s) affected)
Außerdem sind aus einer Basistabelle zurückgegebene NULL-Werte schwer von den von einem äußeren Join zurückgegebenen NULL-Werten zu unterscheiden. Beispielsweise führt die folgende SELECT-Anweisung einen linken äußeren Join zwischen diesen beiden Tabellen aus:
SELECT *
FROM table1 t1 LEFT OUTER JOIN table2 t2
   ON t1.a = t2.c
ORDER BY t1.a;
GO
Hier sehen Sie das Ergebnis.
a           b      c           d
----------- ------ ----------- ------
NULL        three  NULL        NULL
1           one    NULL        NULL
4           join4  4           four

(3 row(s) affected)
Die Ergebnisse machen es nicht einfach, zwischen einer NULL in den Daten und einer NULL zu unterscheiden, die einen Fehler beim Verknüpfen darstellt. Wenn NULL Werte in Daten vorhanden sind, die verknüpft werden, ist es in der Regel vorzuziehen, sie aus den Ergebnissen auszulassen, indem man eine reguläre Verknüpfung verwendet.