Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Gilt für: SQL Server
Hinweis
Diese Funktion wird in einer zukünftigen Version von SQL Serverentfernt. Nutzen Sie diese Funktionen bei Neuentwicklungen nicht mehr, und planen Sie die Änderung von Anwendungen, die diese Funktion zurzeit verwenden.
Standardmäßig verarbeitet Merge Replication Datenänderungen Zeile für Zeile. In vielen Fällen ist dieser Ansatz angemessen, aber für manche Anwendungen ist es unerlässlich, dass verwandte Zeilen als Einheit verarbeitet werden. Die Funktion logische Datensätze von Merge Replication ermöglicht es Ihnen, eine Beziehung zwischen verwandten Zeilen in verschiedenen Tabellen zu definieren, sodass die Zeilen als Einheit verarbeitet werden.
Hinweis
Du kannst die Funktion für logische Datensätze eigenständig oder in Kombination mit Join-Filtern verwenden. Weitere Informationen zu Joinfiltern finden Sie unter Join Filters. Zum Verwenden logischer Datensätze muss die Veröffentlichung mindestens einen Kompatibilitätsgrad von 90RTM aufweisen.
Nehmen Sie die folgenden drei verknüpften Tabellen als Beispiel:
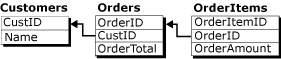
Die Customers -Tabelle ist die übergeordnete Tabelle in dieser Beziehung und enthält eine CustID-Primärschlüsselspalte. Die Orders -Tabelle enthält eine OrderID-Primärschlüsselspalte sowie eine FOREIGN KEY-Einschränkung für die CustID -Spalte, die auf die CustID -Spalte in der Customers -Tabelle verweist. Dementsprechend enthält die OrderItems -Tabelle eine OrderItemID-Primärschlüsselspalte sowie eine FOREIGN KEY-Einschränkung für die OrderID -Spalte, die auf die OrderID -Spalte in der Orders -Tabelle verweist.
In diesem Beispiel besteht ein logischer Datensatz aus allen Zeilen in der Orders -Tabelle, die sich auf einen einzelnen CustID -Wert beziehen, und allen Zeilen der OrderItems -Tabelle, die sich auf jene Zeilen in der Orders -Tabelle beziehen. Das Diagramm zeigt alle Zeilen in den drei Tabellen, die im logischen Datensatz für Customer 2 enthalten sind:
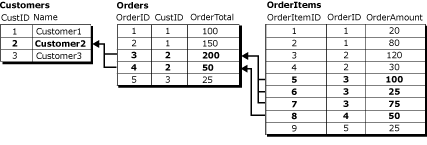
Informationen zum Definieren einer logischen Datensatzbeziehung zwischen Artikeln finden Sie unter Definieren einer logische Datensatzbeziehung zwischen Mergetabellenartikeln.
Vorteile logischer Aufzeichnungen
Logische Datensätze bieten zwei entscheidende Vorteile:
Anwendung von Datenänderungen als Einheit.
Gleichzeitige Erkennung und Lösung von Konflikten in mehreren Zeilen aus mehreren Tabellen.
Die Anwendung von Änderungen als Einheit
Wenn die Mergeverarbeitung unterbrochen wird, beispielsweise bei einem Verbindungsabbruch, macht der Prozess den teilweise abgeschlossenen Satz zusammengehöriger replizierter Änderungen rückgängig, wenn logische Datensätze verwendet werden. Beispiel: Ein Abonnent fügt einen neuen Auftrag mit OrderID = 6 und zwei neue Zeilen in der OrderItems -Tabelle mit OrderItemID = 10 und OrderItemID = 11 für OrderID = 6 hinzu.
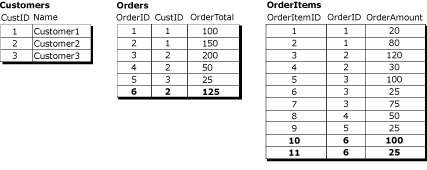
Wenn der Replikationsprozess unterbrochen wird, nachdem die Zeile in Orders für OrderID = 6 abgeschlossen ist, aber bevor die Datensätze 10 und 11 in OrderItems abgeschlossen sind, und wenn keine logischen Datensätze verwendet werden, stimmt der Wert OrderTotal für OrderID = 6 nicht mit der Summe der OrderAmount-Werte für die Zeilen in OrderItems überein. Wenn logische Datensätze verwendet werden, wird die Zeile in Orders für OrderID = 6 erst übernommen, wenn die zugehörigen OrderItems-Änderungen repliziert wurden.
In einem anderen Szenario, wenn logische Datensätze verwendet werden und jemand Tabellen abfragt, während der Merge-Prozess Änderungen anwendet, sieht der Benutzer die teilweise replizierten Änderungen erst, wenn sie vollständig abgeschlossen sind. Zum Beispiel lädt der Replikationsprozess die Orders-Reihe für OrderID = 6 hoch, aber ein Benutzer fragt die Tabellen ab, bevor der Replikationsprozess die OrderItems-Zeilen repliziert; der OrderTotal-Wert ist nicht derselbe wie die Summe der OrderAmount-Werte . Wenn logische Datensätze verwendet werden, ist die Order-Reihe erst sichtbar, wenn die OrderItems-Zeilen abgeschlossen sind und die Transaktion als Einheit ausgeführt wird.
Die Anwendung der Konfliktbehandlung auf mehr als eine Tabelle
Betrachten wir den Fall, in dem zwei Abonnenten den vorherigen Datensatz besitzen:
Ein Benutzer beim ersten Abonnenten ändert den OrderAmount von OrderItemID 5 von 100 auf 150 und den OrderTotal von OrderID 3 von 200 auf 250.
Ein Benutzer beim zweiten Abonnenten ändert OrderAmount von OrderItemID 6 von 25 auf 125 und OrderTotal von OrderID 3 von 200 auf 300.
Wenn diese Änderungen ohne Verwendung logischer Datensätze repliziert werden, führen die unterschiedlichen OrderTotal-Werte zu einem Konflikt und nur einer davon wird repliziert. Die nicht widersprüchlichen Änderungen in der OrderItems-Tabelle werden jedoch ohne Konflikt repliziert, sodass die endgültigen OrderTotal-Werte in Bezug auf die OrderItems-Zeilen inkonsistent sind. Wenn in diesem Szenario logische Datensätze verwendet werden, wird auch die OrderItems-Änderung zurückgesetzt, die der verworfenen Änderung an der Tabelle Orders zugeordnet ist, und der endgültige OrderTotal-Wert ist eine korrekte Summe der OrderItems-Zeilen.
Weitere Informationen zur Konflikterkennung und -lösung bei logischen Datensätzen finden Sie unter Ermitteln und Lösen von Konflikten in logischen Datensätzen.
Überlegungen zur Verwendung logischer Datensätze
Beachten Sie bei der Verwendung von logischen Datensätzen Folgendes:
Allgemeine Überlegungen
Halte die Anzahl der Tabellen in einem logischen Datensatz so gering wie möglich. Verwende fünf oder weniger Tische.
Logische Datensätze können keine Spalten mit den folgenden Datentypen referenzieren:
varchar(max) und nvarchar(max)
varbinary(max)
text und ntext
Abbildung
XML
UDT
Du kannst keine Fremdschlüssel-Beziehungen in veröffentlichten Tabellen mit der CASCADE-Option definieren. Weitere Informationen finden Sie unter CREATE TABLE (Transact-SQL) und ALTER TABLE (Transact-SQL).
Du kannst keine Spalten aktualisieren, die in der logischen Relationsklausel verwendet werden.
Benutzerdefinierte Konfliktlösung mittels Geschäftslogik-Handlern oder benutzerdefinierten Resolvern wird für Artikel, die in einem logischen Datensatz enthalten sind, nicht unterstützt.
Wenn Sie logische Datensätze in einer Publikation verwenden, die parametrisierte Filter enthält, müssen Sie jeden Abonnenten mit einem Snapshot für seine Partition initialisieren. Wenn du einen Subscriber mit einer anderen Methode initialisierst, schlägt der Merge-Agent fehl. Weitere Informationen finden Sie unter Snapshots for Merge Publications with Parameterized Filters.
Konflikte, die logische Aufzeichnungen betreffen, erscheinen nicht im Conflict Viewer. Mit den gespeicherten Replikationsprozeduren können Informationen zu diesen Konflikten angezeigt werden. Weitere Informationen finden Sie unter Konfliktinformationen für Mergeveröffentlichungen anzeigen (Replikationsprogrammierung mit Transact-SQL).
Veröffentlichungseinstellungen
Die Veröffentlichung muss mindestens einen Kompatibilitätsgrad von 90RTM aufweisen. Weitere Informationen finden Sie im Abschnitt „Kompatibilitätsgrad von Veröffentlichungen“ Abwärtskompatibilität von Replikationen.
Die Veröffentlichung muss den nativen Momentaufnahmemodus verwenden. Dieser Modus ist der Standard, es sei denn, du replizierst auf SQL Server Compact, das keine logischen Datensätze unterstützt.
Die Publikation erlaubt keine Web-Synchronisation. Weitere Informationen zur Websynchronisierung finden Sie unter Web Synchronization for Merge Replication.
Um logische Datensätze auf einer gefilterten Veröffentlichung zu verwenden:
Du musst außerdem vorberechnete Partitionen verwenden. Die Anforderungen für vorausberechnete Partitionen treffen auch auf logische Datensätze zu. Weitere Informationen finden Sie unter Optimieren Parametrisierter Filter-Leistung mit Vorausberechneten Partitionen .
Man kann keine nicht überlappenden parametrisierten Filter verwenden. Weitere Informationen finden Sie im Abschnitt zum Festlegen von Partitionsoptionen unter Parameterized Row Filters.
Wenn die Publikation Joinfilter verwendet, müssen Sie bei allen Joinfiltern, die an logischen Datensatzbeziehungen beteiligt sind, die Eigenschaft join unique key auf true festlegen. Weitere Informationen finden Sie unter Join Filters.
Beziehungen zwischen Tabellen
Tabellen, die über logische Datensätze verknüpft sind, müssen Primärschlüssel/Fremdschlüssel-Beziehungen aufweisen.
Du kannst die Option NICHT FÜR REPLIKATION für Fremdschlüssel-Constraints nicht festlegen.
Untergeordnete Tabellen können nur eine übergeordnete Tabelle aufweisen.
Eine Datenbank, in der z. B. Kurse und Studenten nachverfolgt werden, könnte folgendermaßen aufgebaut sein:
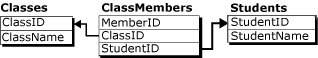
Man kann keinen logischen Datensatz verwenden, um die drei Tabellen in dieser Beziehung darzustellen, da die Zeilen in ClassMembers nicht mit einer einzigen primären Schlüsselzeile verknüpft sind. Die Tabellen Classes und ClassMembers könnten jedoch einen logischen Datensatz bilden, ebenso die Tabellen ClassMembers und Students, aber nicht alle drei zusammen.
Die Veröffentlichung kann keine zirkulären Join-Filter-Beziehungen enthalten.
Anhand des Beispiels mit den Tabellen Kunden,Bestellungen und OrderItems können Sie keine logischen Datensätze verwenden, wenn die Order-Tabelle auch eine Fremdschlüssel-Constraint enthält, die auf die OrderItems-Tabelle verweist.
Leistungseinschränkungen logischer Datensätze
Die logische Aufzeichnungsfunktion ist mit einem Leistungsaufwand verbunden. Wenn Sie keine logischen Datensätze verwenden, kann der Replikationsagent alle Änderungen eines bestimmten Artikels gleichzeitig verarbeiten. Da die Änderungen Reihe für Reihe angewendet werden, sind die Anforderungen an Sperren und Transaktionsprotokolle, die für die Umsetzung der Änderungen erforderlich sind, minimal.
Wenn Sie logische Datensätze verwenden, muss der Merge-Agent die Änderungen für jeden gesamten logischen Datensatz gemeinsam verarbeiten. Dieser Prozess beeinflusst die Zeit, die der Merge-Agent benötigt, um die Zeilen zu replizieren. Darüber hinaus können sich die Sperranforderungen erhöhen, da der Agent eine separate Transaktion für jeden logischen Datensatz öffnet.