Auswählen eines Datenaufnahmetools
Wenn Sie Datenpipelines in Azure Databricks entwerfen, wirkt sich die Auswahl des richtigen Aufnahmetools direkt auf die Zuverlässigkeit der Pipeline, den Wartungsaufwand und langfristige Kosten aus. Jedes Tool behandelt unterschiedliche Szenarien, Datenquellen und betriebliche Anforderungen. Wenn Sie diese Unterschiede verstehen, können Sie fundierte Entscheidungen treffen, die den Anforderungen Ihrer Organisation entsprechen.
Verstehen Sie die Landschaft der Ingestion-Tools
Azure Databricks bietet mehrere Aufnahmeoptionen, die ein Spektrum von vollständig verwalteten Diensten bis hin zu hochgradig anpassbaren Frameworks umfassen. Die von Ihnen ausgewählten Tools hängen von Faktoren wie dem Datenquellentyp, den Latenzanforderungen und der Kontrolle über den Aufnahmeprozess ab.

Lakeflow Connect bietet hochgradig verwaltete Schnittstellen für Unternehmensanwendungen und Datenbanken. Diese Connectors behandeln die Authentifizierung, Änderungsnachverfolgung, Fehlerwiederherstellung und Schemaentwicklung automatisch. Am anpassbaren Ende bietet Spark Structured Streaming Ihnen vollständige Kontrolle darüber, wie Daten durch Ihre Pipeline fließen, obwohl sie mehr Entwicklungs- und Wartungsaufwand erfordert.
Zwischen diesen Extremen finden Sie Tools wie Auto Loader für Cloudspeicherdateien, COPY INTO für SQL-basierte Batch-Ladevorgänge und notizbuchbasierte Ansätze mithilfe von JDBC/ODBC-Verbindungen. Darüber hinaus dient Azure Data Factory als Orchestrierungsebene, die die Datenverschiebung in Azure Databricks aus dem umfassenderen Azure-Ökosystem koordinieren kann.
Lakeflow Connect
Lakeflow Connect stellt den modernen Ansatz für die Datenaufnahme in Azure Databricks dar. Es bietet sowohl vollständig verwaltete Connectors als auch Standardconnectors, die in Lakeflow-Pipelines integriert sind, um eine optimierte Erfahrung zu erzielen.
Verwaltete Connectors sind in drei Typen unterteilt:
SaaS connectors bieten eine sofort einsatzbereite Integration in Unternehmensanwendungen wie Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk und viele andere. Diese Connectors behandeln quellspezifische Authentifizierung, inkrementelle Lesevorgänge, API-Ratelimitierung, Schemaentwicklung und automatisierte Wiederholungen. Sie werden auf serverlosem Compute ausgeführt und in von Unity Catalog verwaltete Streaming-Tabellen geschrieben.
Datenbank-Connectors erfassen Daten aus relationalen Datenbanken, einschließlich MySQL, PostgreSQL und SQL Server, mithilfe der Änderungsdatenerfassung (Change Data Capture, CDC). Da CDC-basierte Connectors aus Protokollen zu Datenbanktransaktionen gelesen werden, anstatt Tabellen direkt abzufragen, benötigen sie ein in Ihrem Netzwerk bereitgestelltes Einspeisegateway und einen Zwischenspeicher, um erfasste Änderungen zu puffern.
Community-Connectors sind Open-Source-Connectors, die von der Community erstellt und verwaltet werden. Sie erweitern Lakeflow Connect auf Quellen, die noch keinen verwalteten Connector haben. Sie können einen vorhandenen Community-Connector verwenden oder einen eigenen Beitrag leisten.
Hinweis
Das Konnektorökosystem wächst schnell. In der Dokumentation zu den verwalteten Connectors finden Sie die aktuelle vollständige Liste der unterstützten Quellen.
Standard-Connectors erweitern Lakeflow Connect auf Cloud-Objektspeicher und Nachrichtenbusse. Sie können Daten aus Amazon S3, Azure Data Lake Storage oder Google Cloud Storage mithilfe des automatischen Ladens aufnehmen. Für Echtzeitdaten unterstützen Standard-Connectors Apache Kafka, Google Pub/Sub und Apache Pulsar.

Erwägen Sie Lakeflow Connect, wenn Sie eine zuverlässige, wartungsarme Aufnahme aus unterstützten Quellen benötigen. Die verwalteten Connectors reduzieren die Entwicklungszeit und die fortlaufende Wartung im Vergleich zu benutzerdefinierten Lösungen erheblich. Wenn Ihre Datenquelle jedoch nicht unterstützt wird oder Sie hochspezialisierte Aufnahmelogik benötigen, müssen Sie möglicherweise weitere Optionen erkunden.
Lakeflow Connect unterstützt sowohl geplante Aufnahme (stündlich, täglich, wöchentlich) als auch On-Demand-Trigger , sodass sie für regelmäßige Datenaktualisierungszyklen und Ad-hoc-Ladeszenarien geeignet sind.
Abfragebasierte Konnektoren
Abfragebasierte Connectors sind eine leichtgewichtige Alternative zu CDC-Datenbankconnectors zur geplanten Einspeisung aus relationalen Datenbanken. Anstatt Transaktionsprotokolle zu lesen, fragen sie die Quelltabelle direkt mithilfe einer Cursorspalte ab – ein monoton steigender Zeitstempel oder ganzzahliger Wert, der verfolgt, welche Zeilen seit der letzten Pipelineausführung neu sind oder aktualisiert werden.
Da sie die Quelle direkt abfragen, benötigen abfragebasierte Connectors kein Eingabegateway oder Stagingspeicher. Bei jeder geplanten Ausführung ruft der Connector alle Zeilen mit einem Cursorspaltenwert ab, der größer ist als die Hochwassermarke aus der vorherigen Ausführung, und schreibt dann die Ergebnisse in Streamingtabellen im Unity Catalog.
Zu den unterstützten Quellen gehören Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL und alle Lakehouse Federation-Datenquellen.
Abfragebasierte Connectors unterstützen drei Verlaufsverfolgungsmodi für Zieltabellen:
- SCD-Typ 1: Überschreibt die vorhandene Zeile mit der neuesten Quellzeile. Es wird kein Verlauf gespeichert.
- SCD-Typ 2: Behält den vollständigen Verlauf bei, indem neue Zeilen mit Versionsmetadaten hinzugefügt werden.
- Nur anfügen: Fügt jede aufgenommene Zeile ohne Zusammenführen oder Überschreiben an.
Verwenden Sie abfragebasierte Connectors statt CDC-Datenbankconnectors, wenn die CDC- oder Binlog-Infrastruktur nicht verfügbar ist, aber eine zuverlässige Cursorspalte in den Quellen vorhanden ist. Wählen Sie CDC-Connectors, wenn Sie jeden Zwischenstatus von Zeilen zwischen den Ausführungen von Pipelines benötigen oder wenn die Nachverfolgung von vorläufigen Löschungen kritisch ist. Im Vergleich zu CDC-Connectors, die aus dem Binlog lesen, legen abfragebasierte Connectors mehr Last auf die Quelltabellen.
Automatischer Lader
Auto Loader stellt eine inkrementelle Dateiverarbeitung für Daten bereit, die im Cloudspeicher ankommen. Anstatt ganze Verzeichnisse zu scannen, um neue Dateien zu finden, verfolgt auto Loader effizient, welche Dateien verarbeitet wurden und erfasst nur neue Ankünfte.
Auto Loader funktioniert, indem der Status an einem Kontrollpunkt gespeichert wird, der die verarbeiteten Dateien verfolgt. Wenn neue Dateien in Ihrem Cloudspeicher landen, entdeckt Auto Loader sie entweder über die Verzeichniseinstellung oder den Dateibenachrichtigungsmodus. Die Verzeichnisauflistung sucht regelmäßig nach neuen Dateien, während der Dateibenachrichtigungsmodus cloudeigene Ereignisse zur sofortigen Erkennung verwendet.
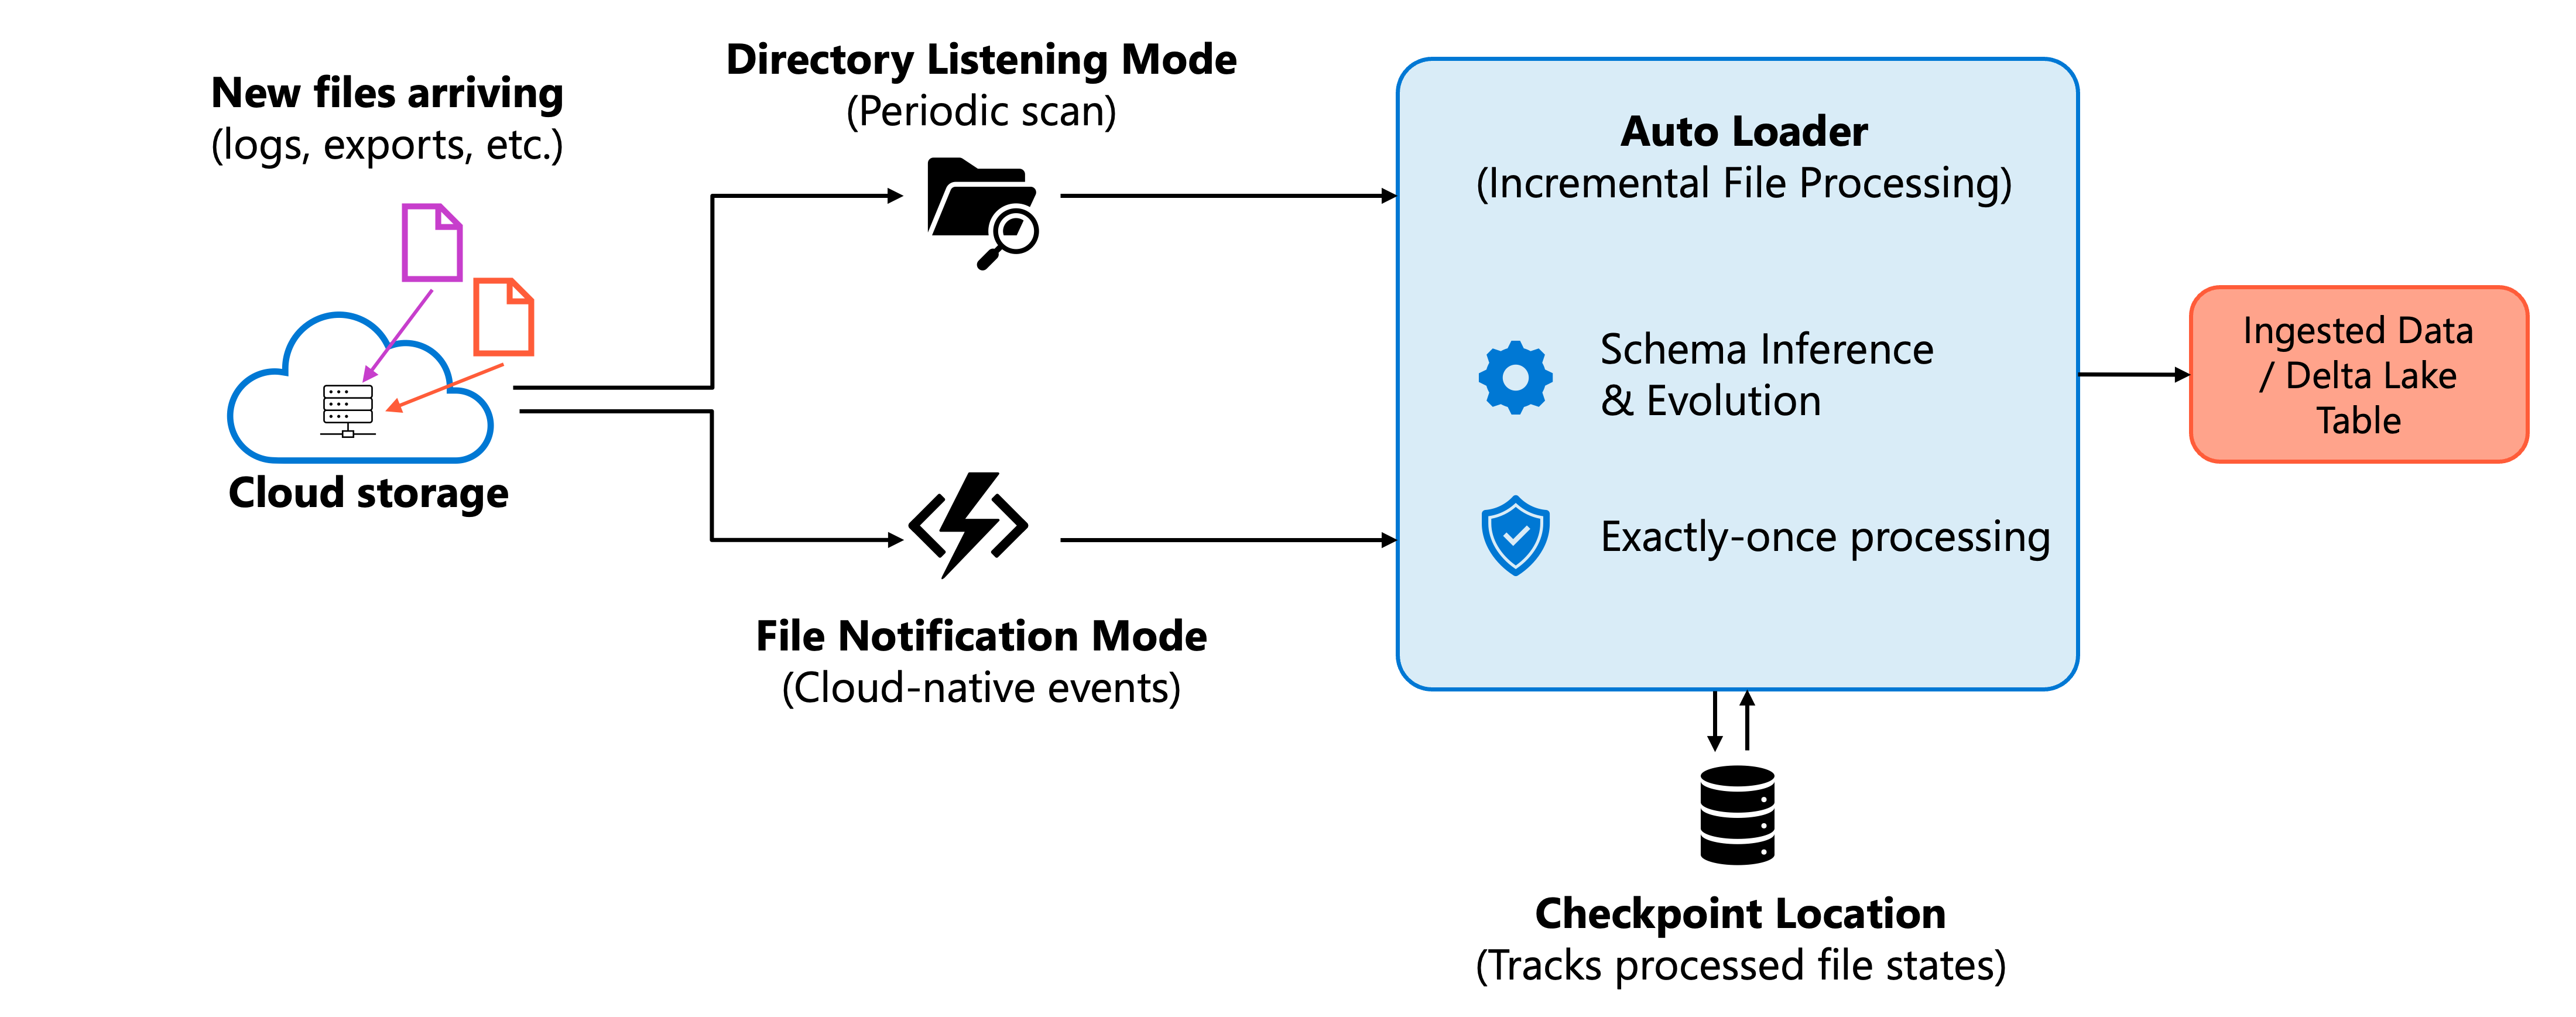
Zu den wichtigsten Funktionen von Auto Loader gehört:
- Schemainference und Evolution: Erkennt automatisch das Schema eingehender Dateien und behandelt Schemaänderungen ordnungsgemäß.
- Genau einmal verarbeitet: Garantiert, dass jede Datei einmal verarbeitet wird, auch bei Fehlern und Neustarts.
- Skalierbarkeit: Verarbeitet Milliarden von Dateien für Backfills oder Migrationen effizient.
- Formatunterstützung: Verarbeitet JSON-, CSV-, Parkett-, Avro-, ORC-, XML-, Text- und Binärdateien.
Auto Loader passt zu Szenarien, in denen Daten als Dateien im Cloudspeicher eintreffen – allgemeine Muster umfassen Protokolldateien, Exporte aus upstream-Systemen und Datenlandungszonen. Sie können Auto Loader mit Lakeflow-Pipelines für eine verwaltete Erfahrung oder mit strukturiertem Streaming für mehr Kontrolle verwenden.
KOPIEREN IN
Der COPY INTO SQL-Befehl lädt Daten aus dem Cloudspeicher in Delta-Tabellen. Im Gegensatz zu Auto Loader, der kontinuierlich als Datenstrom ausgeführt wird, wird COPY INTO als Batchvorgang ausgeführt, den Sie manuell planen oder auslösen.
COPY INTO verfolgt, welche Dateien es bereits verarbeitet hat, wodurch der Vorgang idempotent wird. Wenn Sie denselben Befehl mehrmals ausführen, werden keine Daten dupliziert, da zuvor geladene Dateien übersprungen werden. Diese Eigenschaft eignet sich COPY INTO für geplante Batchaufträge, bei denen sie ein vorhersehbares, wiederholbares Verhalten wünschen.
Hinweis
Die Nachverfolgungsmetadaten werden als Teil des Transaktionsprotokolls der Delta-Tabelle (verzeichnis _delta_log ) gespeichert.

Häufige Szenarien für COPY INTO sind einmalige Datenmigrationen, geplante Batch-Ladevorgänge aus Landungszonen und SQL-first-Workflows, bei denen Sie eine deklarative Syntax Streaming-APIs vorziehen.
Wählen Sie COPY INTO statt Auto Loader, wenn Sie eine einmalige Batchladung eines großen Datasets durchführen.
COPY INTO bietet ein einfacheres Konfigurationsmodell ohne Streaming-Infrastruktur, sodass es ideal zum Laden von Hunderten von Gigabyte oder sogar Terabytes an Daten in einem einzigen Vorgang ist. Das fortlaufende Verarbeitungsmodell und die Prüfpunktverwaltung von Auto Loader fügen unnötige Komplexität hinzu, wenn Sie nur einmal Daten laden müssen.
Für die fortlaufende inkrementelle Einspeisung in großem Maßstab bietet Auto Loader jedoch eine bessere Leistung und eine robustere Dateiermittlung.
Spark Structured Streaming (strukturiertes Streaming)
Spark Structured Streaming bietet die Grundlage für die Echtzeitdatenverarbeitung in Azure Databricks. Es ermöglicht eine kontinuierliche Erfassung von verschiedenen Streaming-Quellen mit der Garantie einer einmaligen Verarbeitung.
Zu den unterstützten Streamingquellen gehören:
- Apache Kafka und Azure Event Hubs: Für ereignisgesteuerte Architekturen und Nachrichtenwarteschlangenverarbeitung.
- Delta Lake-Änderungsfeeds: Zum Weitergeben von Änderungen zwischen Delta-Tabellen.
- Cloudspeicher über automatisches Laden: Für dateibasierte Streaming-Aufnahme.
- Socket und benutzerdefinierte Quellen: Für spezielle Erfassungsszenarien.
Wählen Sie "Strukturiertes Streaming" aus, wenn Sie eine differenzierte Kontrolle über das Streamingverhalten, die benutzerdefinierte Wasserzeichen- oder Fensterlogik oder das Arbeiten mit Quellen benötigen, die von Abstraktionen höherer Ebene nicht unterstützt werden.
JDBC- und ODBC-Verbindungen
Die notizbuchbasierte Datenerfassung mithilfe von JDBC oder ODBC bleibt ein praktischer Ansatz zum Extrahieren von Daten aus relationalen Datenbanken. Sie schreiben Code, der eine direkte Verbindung mit Quelldatenbanken herstellt, Abfragen ausführt und Ergebnisse in Delta-Tabellen lädt.
Dieser Ansatz unterstützt praktisch jede Datenbank mit einem ODBC-Treiber: SQL Server, Oracle, PostgreSQL, MySQL und viele andere. Sie implementieren vollständige oder inkrementelle Ladungen, indem Sie entsprechende Abfragen schreiben und oft Wasserzeichen-Spalten verwenden, um den Fortschritt der Extraktion zu verfolgen.
Während Lakeflow Connect verwaltete Konnektoren JDBC/ODBC in vielen Szenarien ersetzen, sind Notebook-basierte Verbindungen nach wie vor nützlich, wenn:
- Ihre Datenbank wird von verwalteten Lakeflow Connect-Connectors nicht unterstützt.
- Sie benötigen benutzerdefinierte Extraktionslogik, die ein verwalteter Connector nicht bereitstellen kann.
- Sie verwalten vorhandene Pipelines, die dieses Muster verwenden.
- Sie benötigen spezielle Abfrage-Pushdown-Optimierungen für große Tabellen.
Speichern Sie anmeldeinformationen bei Verwendung von ODBC sicher mithilfe von Databricks-Geheimschlüsseln, anstatt sie in Notizbüchern zu codieren. Berücksichtigen Sie die Leistungsauswirkungen auf Quellsysteme und implementieren Sie eine geeignete Drosselung oder Terminierung, um eine Überlastung von Transaktionsdatenbanken zu vermeiden.
Für lokale Datenbanken ist eine zusätzliche Netzwerkinfrastruktur erforderlich – entweder Azure ExpressRoute/VPN für direkte JDBC-Konnektivität von Databricks oder Azure Data Factory mit einer Self-Hosted Integration Runtime, um Daten zunächst in den Cloudspeicher zu überführen.
Azure Data Factory
Azure Data Factory (ADF) dient als Orchestrierungs- und Datenbewegungsplattform innerhalb des Azure-Ökosystems. Es zeichnet sich durch die Koordination von Workflows aus, die mehrere Dienste umfassen und Daten aus verschiedenen Quellen in den Cloudspeicher übertragen, wo Azure Databricks sie verarbeiten kann.
ADF integriert sich umfassend in Microsoft-Dienste wie Dynamics 365, Azure SQL-Datenbank und Microsoft Fabric. Wenn Ihre Daten aus diesen Quellen stammen, bietet ADF eine einfache Konnektivität und kann Daten in Azure Data Lake Storage für nachfolgende Databricks-Verarbeitung landen.
Das Verständnis der geeigneten Rolle von ADF ist wichtig. Verwenden Sie ADF für:
- Orchestrierung: Koordinieren von Workflows, die mehrere Azure-Dienste umfassen.
- Erstes Data Landing: Verschieben von Daten aus Azure-Quellen in den Cloud-Speicher.
- Unternehmensintegration: Wenn die Unternehmensrichtlinie ADF für die Datenbewegung anordnet.

Vermeiden Sie die Verwendung von ADF für kerne ETL-Transformationen in Databricks. Das Ausführen von Transformationen durch ADF-Aktivitäten führt zu unnötiger Komplexität und arbeitet weniger effizient als die Databricks-native Verarbeitung. Lassen Sie ADF Daten in Ihr Lakehouse verschieben und verwenden Sie dann Azure Databricks-Tools für Transformationslogik.
Anwenden eines Entscheidungsrahmens
Die Auswahl eines Erfassungstools wird klarer, wenn Sie Ihr Szenario anhand wichtiger Entscheidungskriterien bewerten.
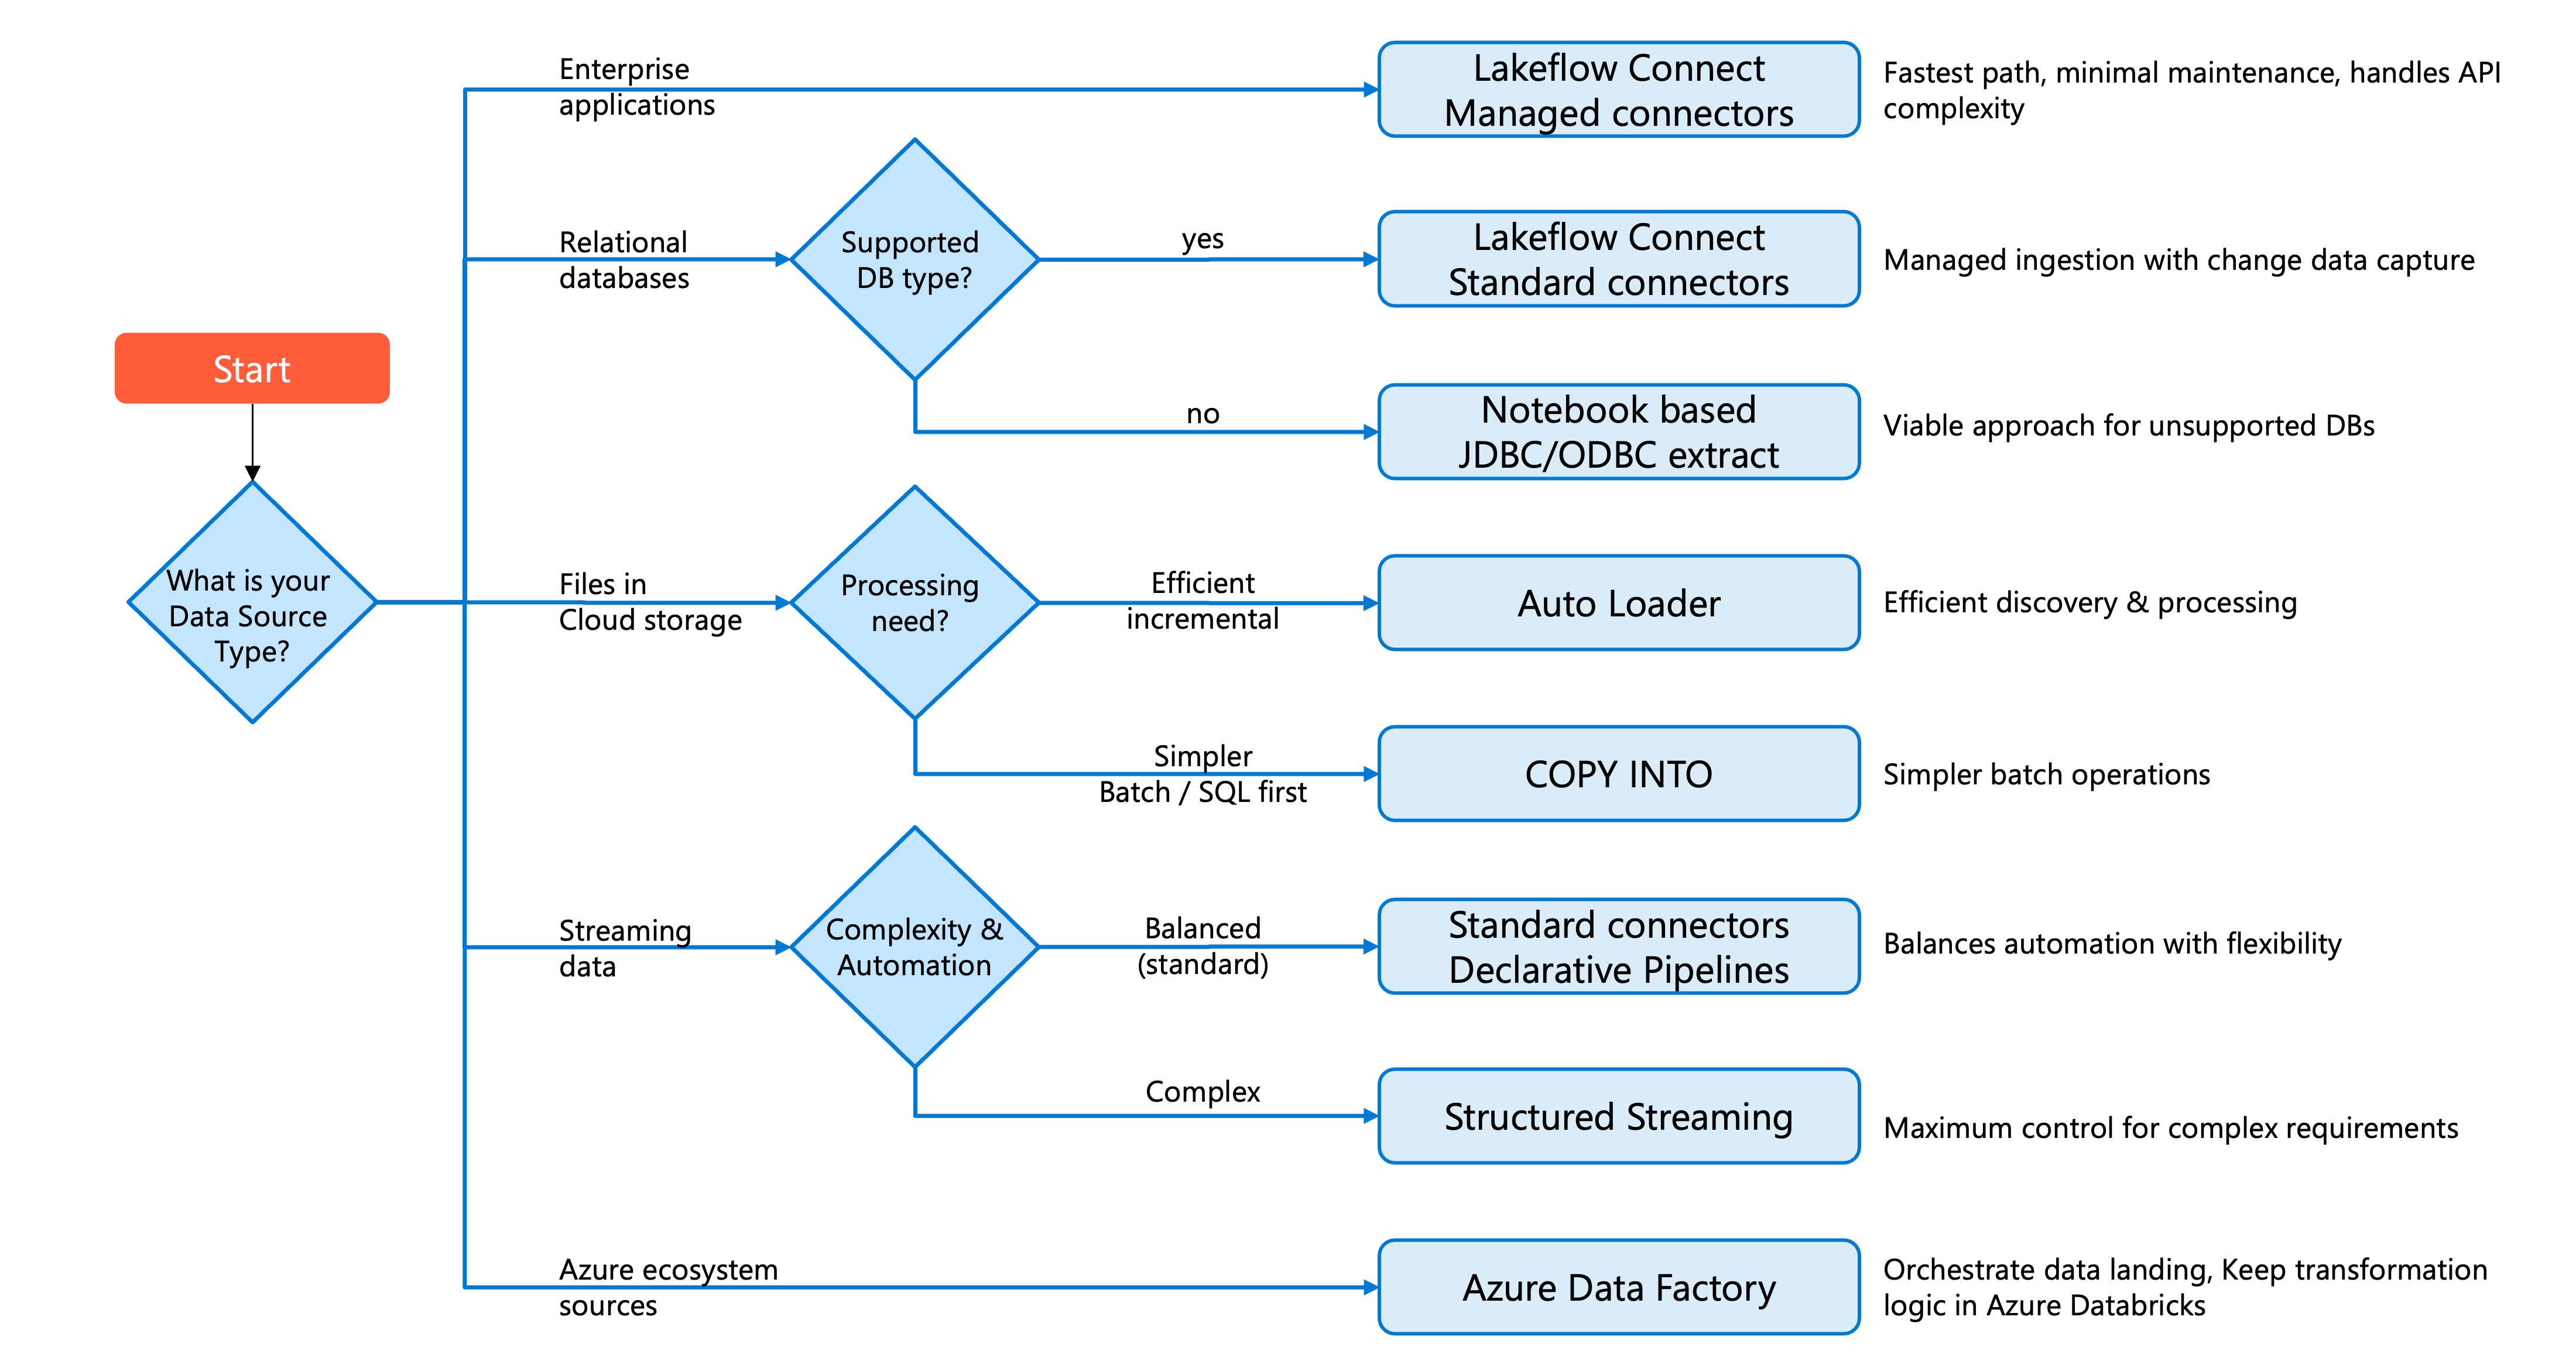
Beginnen Sie, indem Sie Ihren Datenquellentyp identifizieren und dann die betrieblichen Anforderungen und den Organisationskontext berücksichtigen.
Für Unternehmensanwendungen (Salesforce, ServiceNow, SharePoint) bieten Lakeflow Connect verwaltete Connectors den schnellsten Weg zur Produktion mit minimaler Wartung. Diese Connectors behandeln die Komplexität der API-Integration, der Ratelimitierung und der Änderungsnachverfolgung.
Für relationale Datenbanken mit unterstützten Typen bietet Lakeflow Connect zwei verwaltete Pfade: Datenbankconnectors (CDC-basiert, erfordert Gateway) für die kontinuierliche Änderungserfassung und abfragebasierte Connectors für eine einfachere geplante Erfassung mithilfe einer Cursorspalte. Bei nicht unterstützten Datenbanken bleibt die notizbuchbasierte JDBC/ODBC-Extraktion ein sinnvoller Ansatz.
Für Dateien im Cloudspeicher bietet auto Loader eine effiziente inkrementelle Erkennung und Verarbeitung. Verwenden Sie COPY INTO für einfachere Batchszenarien oder wenn Sie SQL-first-Workflows bevorzugen.
Für das Streamen von Daten aus Nachrichtenbussen (Kafka, Event Hubs, Pub/Sub) gleichen Standardconnectors mit Lakeflow-Pipelines die Automatisierung mit Flexibilität aus. Für komplexe Streaminganforderungen bietet Structured Streaming maximale Kontrolle.
Für Azure-Ökosystemquellen , die eine Koordination mit anderen Diensten erfordern, kann Azure Data Factory Daten koordinieren, die in Ihr Lakehouse landen. Behalten Sie transformationslogik in Azure Databricks und nicht in ADF-Datenflüssen bei.
Tipp
Beginnen Sie mit der am häufigsten verwalteten Option, die Ihren Anforderungen entspricht. Verwaltete Connectors reduzieren entwicklungszeit und Wartungsaufwand. Wechseln Sie nur zu anpassbareren Ansätzen, wenn bestimmte Anforderungen nicht durch Abstraktionen höherer Ebene erfüllt werden können.
Ihre Wahl hängt auch von Teamfähigkeiten und organisatorischen Standards ab. Dokumentieren Sie Ihre Entscheidungen und die Gründe dafür, dass zukünftige Teammitglieder die Pipelinearchitektur verstehen.