Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Importante
El entrenamiento interactivo requiere aprobación de acceso explícita. Solicite acceso a través del formulario de registro en versión preliminar y espere a la aprobación antes de crear una sesión de entrenamiento.
Use esta hoja de referencia rápida para asignar el bucle de entrenamiento a las funciones y parámetros del SDK de Python en Microsoft Foundry. Los ejemplos se centran en la API de FineTuningSession conveniencia sincrónica. Los clientes asincrónicos y los contenedores de libros de cocina usan diferentes interfaces y patrones de finalización.
Prerequisites
- Complete la instalación, la autenticación y la configuración de acceso.
- Use
azure-ai-finetuningsessions==1.0.0b1, la versión preliminar pública instalada por el libro de recetas. - El rol Usuario de Foundry para el entrenamiento o el rol Propietario de Foundry si también implementa el modelo optimizado. Consulte Control de acceso basado en rol para Microsoft Foundry.
- Seleccione un modelo apto y una configuración de adaptador compatible. Prepare tokens con su tokenizador coincidente y la plantilla de chat.
- Establezca
AZURE_AI_PROJECT_ENDPOINTy confirme un presupuesto de entrenamiento aprobado. La creación de una sesión y la ejecución de operaciones de entrenamiento o muestreo pueden incurrir en cargos.
Los métodos de comodidad de entrenamiento, muestreo y punto de comprobación esperan los resultados de la operación. Las operaciones sin procesar y los asistentes asincrónicos tienen diferentes tipos de valor devuelto y comportamiento de finalización; use la referencia completa del SDK para esas interfaces.
En los ejemplos se usa el SDK sincrónico a menos que se etiquete lo contrario. Prepare las funciones auxiliares una vez y, a continuación, ejecute operaciones dentro de with open_session() as session:. Usar datos tokenizados reales; Los fragmentos de código no proporcionan un conjunto de datos ni implementan un algoritmo de entrenamiento completo.
Ajuste fino supervisado
El ajuste supervisado (SFT) se entrena en solicitudes y respuestas deseadas.
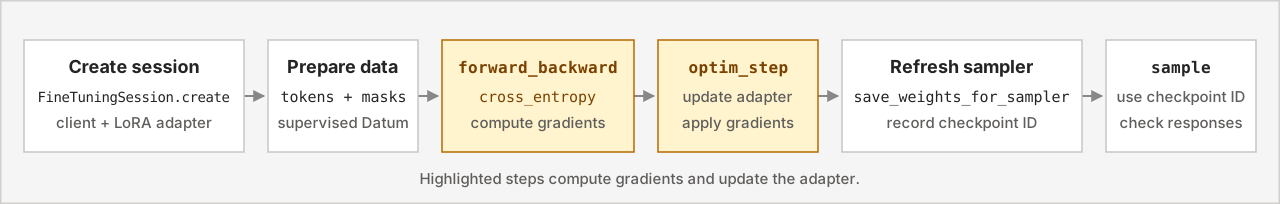
La secuencia se crea un > paso de evaluación > del punto > de control de evaluación de los datos > supervisados hacia delante o hacia atrás>. El muestreo no es necesario para cada lote supervisado.
Aprendizaje de refuerzo
El aprendizaje de refuerzo (RL) entrena a partir de respuestas de modelos puntuadas.

La secuencia es crear > un sampler > de actualización que recopila recompensas de proceso y ventajas >> del optimizador hacia delante o hacia atrás>. Repita la actualización del sampler para recopilar respuestas de la directiva actualizada.
La agrupación, la calificación y el cálculo de ventajas pertenecen al controlador, no a un algoritmo de entrenamiento automático del SDK. Para obtener ejemplos de entrenamiento completos, explore el repositorio de ejemplos de ajuste preciso.
Creación de una sesión
FineTuningSessionClient se conecta al proyecto mediante endpoint y credential.
FineTuningSession.create inicializa un modelo y un adaptador e inicia el latido de la sesión.
Este asistente se autentica con DefaultAzureCredential, crea una sesión y la descarga cuando se cierra su contexto. Use el modelo aprobado y la clasificación de LoRA. El ámbito de credenciales explícito es para Microsoft Entra autenticación.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Referencia: FineTuningSession.create, FineTuningSessionClient y DefaultAzureCredential.
Espere un identificador de sesión después de que se complete la carga del modelo. Mantenga abierta la sesión para las operaciones siguientes; al cerrar su contexto, se detiene el latido y se envía una solicitud de descarga.
| Parameter | Meaning |
|---|---|
base_model |
Identificador exacto del modelo de entrenamiento admitido. |
lora_config |
Explícito LoRAConfig con un objeto compatible rank. |
type |
Tipo de sesión; use training. El muestreo se realiza a través de la sesión de entrenamiento, no un tipo de sesión de inferencia independiente. |
timeout_sec |
Tiempo máximo para esperar la carga del modelo. Un tiempo de espera no confirma la limpieza remota. |
from_checkpoint |
Opcional FromCheckpoint con el origen source_session_id y checkpoint_id. Use el estado de entrenamiento guardado compatible. |
user_metadata |
Diccionario opcional de metadatos de ejecución que se van a asociar a la sesión. |
training_type |
Selector de niveles opcional; Los valores conocidos son GlobalStandard, DatazoneStandardy DeveloperTier. La idoneidad sigue dependiendo del modelo y del proyecto. |
Registre session.session_id cuando use el SDK directamente. Para ejecutar una receta de entrenamiento de un extremo a otro, consulte Introducción.
Preparación de datos supervisados
Datum grupos model_input y loss_fn_inputs para un ejemplo.
| Tipo o campo | Meaning |
|---|---|
ModelInput |
Fragmentos ordenados de entrada de modelo. |
ModelInputChunk.tokens |
Identificadores de token de texto del tokenizador del modelo. |
LossFnInputs.target_tokens |
Destinos del siguiente token alineados con las posiciones de entrada. |
LossFnInputs.weights |
Ponderaciones explícitas por token; cero excluye un destino del entrenamiento entre entropía. |
TensorData.data |
Destinos enteros o señales de aprendizaje de punto flotante. |
Cambie las entradas y los destinos por un token y alinee los pesos con los destinos. Entrene en los tokens de asistente previstos, no solicite ni observaciones. Consulte Funciones de pérdida y pesos de token.
Pase tokens de solicitud y finalización del mismo representador de chat específico del modelo a este asistente. Crea un ejemplo de SFT de un solo turno y enmascara los destinos de aviso.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Referencia: Datum, LossFnInputs y ModelInput.
Compile batch como una lista de estos Datum valores. Las matrices de entrada, destino y peso tienen la misma longitud. En el caso de los datos de varios turnos, conserve las máscaras del representador en lugar de tratar cada token después del primer símbolo del sistema como token de asistente.
Preparación de los datos de RL
Para RL, use respuestas muestreadas y señales de aprendizaje derivadas de recompensas:
| Field | Meaning |
|---|---|
SampledSequence.tokens |
Identificadores de token generados. |
SampledSequence.logprobs |
Probabilidades de registro de tokens de la directiva que generó la respuesta, cuando se proporciona. |
LossFnInputs.logprobs |
Probabilidades de registro de lanzamiento alineadas con los destinos de entrenamiento. |
LossFnInputs.advantages |
Ventajas por token; cero excluye las posiciones de aviso y observación de la señal RL. |
Conserve la alineación entre los destinos, las probabilidades de registro y las ventajas. No reemplace las probabilidades de lanzamiento por las de un modelo recién actualizado. El constructor de LossFnInputs Python también requiere explícitamente weights; El enmascaramiento de RL usa las ventajas.
Para un lanzamiento de un solo turno, pase un muestreado sequence y un advantage calculado por el controlador. Este asistente coloca cero ventajas y probabilidades de registro en posiciones de destino de aviso.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Referencia: SampledSequence y LossFnInputs.
En el caso de las llamadas a herramientas o lanzamientos de varios turnos, use el representador de la receta para distinguir los tokens de acción muestreados de las observaciones del entorno.
Degradados de proceso
session.forward_backward(batch, loss_fn=...) calcula el objetivo y acumula degradados. No actualiza los pesos del adaptador.
batch contiene Datum valores.
loss_fn
cross_entropyselecciona , importance_sampling, ppo, cispoo sapo. Opcional loss_fn_config usa el modelo del LossFnConfig SDK; no infiere las claves de configuración aceptadas de un documento de algoritmo.
Complete el cálculo del degradado antes de la actualización del optimizador. Mantenga la reducción de pérdida coherente al acumular varias llamadas.
Con una SFT activa session y una SFT batchno vacía, calcula los degradados e inspecciona las salidas por ejemplo:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referencia: FineTuningSession.forward_backward y PérdidaFn.
Para un lote de RL preparado, use LossFn.IMPORTANCE_SAMPLING u otra pérdida de directiva admitida.
LossFn los miembros de enumeración y sus valores de cadena seleccionan la misma pérdida.
Aplicación de un paso del optimizador
session.optim_step(adam_params) aplica degradados acumulados.
AdamParams Python requiere los cinco campos:
| Field | Meaning |
|---|---|
learning_rate |
Tamaño de actualización del optimizador. |
beta1 |
Factor de descomposición del primer momento. |
beta2 |
Factor de descomposición de segundo momento. |
eps |
Término de estabilidad numérica. |
weight_decay |
Configuración de descomposición de peso. |
Elija valores para el experimento en lugar de asumir los valores predeterminados universales.
Este asistente proporciona todos los campos necesarios y espera la actualización. Los valores son valores de ejemplo, no recomendaciones independientes del modelo.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Referencia: FineTuningSession.optim_step y AdamParams.
Vuelva a calcular learning_rate cuando el controlador use una programación; no suponga que se aplica una configuración del optimizador durante toda la ejecución.
Texto de ejemplo
session.save_weights_for_sampler(seq_id, ...) prepara pesos y devuelve un identificador de punto de control del muestreador. Actualice los pesos del sampler después de las actualizaciones antes de generar desde el adaptador actualizado.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) genera respuestas de los pesos del muestreador seleccionado.
| Parámetro o resultado | Meaning |
|---|---|
prompt_tokens |
Solicitud con token o compatible.ModelInput |
checkpoint_id |
Identificador de punto de control del sampler completado para esta sesión, no una ruta de acceso de punto de control ni un nombre de implementación. |
num_samples |
Número de respuestas para el mensaje. |
SamplingParams.max_tokens |
Presupuesto del token de finalización. |
temperature, , top_p, top_k |
Configuración de distribución de muestreo. |
stop_criteria |
Una lista de cadenas de detención o una lista de identificadores de token, no ambos. |
response_format |
Solicitud opcional de formato de respuesta; La compatibilidad depende del modelo y del proveedor de muestreo. |
result.sequences |
Valores generados SampledSequence . |
SamplingParams Python requiere max_tokens, temperature, top_py top_k. Establezca lo mismo seq_id para la actualización y el muestreo del sampler. Proporcione o pathsampling_session_seq_id al guardar pesos del muestreador.
Después de una actualización del optimizador, actualice el sampler y genere una respuesta. Use el modelo con tokenizado prompt_tokens y la coincidencia tokenizer del controlador.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Referencia: FineTuningSession.save_weights_for_sampler, FineTuningSession.sample y SamplingParams.
El resultado contiene una secuencia muestreada. Incremente el identificador de paso con las actualizaciones y actualice los pesos del muestreador antes de realizar el muestreo de la directiva actualizada.
La preparación de pesos de muestreo no es la misma que guardar el estado de entrenamiento reanudable.
Ponderaciones de muestreo persistentes o de actualización
El método sincrónico usa sampling_session_seq_id para distinguir una actualización en memoria de un punto de control de muestreo persistente.
| Purpose | Llamada sincrónica |
|---|---|
| Actualizar pesos del muestreador sin persistencia | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Conservar un punto de control del sampler |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), sin sampling_session_seq_id. |
Ambas llamadas devuelven un identificador de punto de comprobación del sampler. Manténgalo con su identificador de sesión propietario. Un protector de muestra duradero no establece la retención indefinida ni hace que el punto de control se pueda usar en otra sesión.
Ejecución de un pase de solo avance
session.forward(batch, loss_fn=...) devuelve salidas de función de pérdida sin acumular degradados. Úselo para inspeccionar un lote preparado o calcular las métricas de evaluación.
Su resultado no rellena el solo total_lossentrenamiento. Inspeccione loss_fn_outputs; no trate un agregado que falta como pérdida cero.
Con un activo session y un preparado batch, inspeccione las salidas por ejemplo sin cambiar los degradados acumulados:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referencia: FineTuningSession.forward.
Guardar y reanudar el entrenamiento
session.save_weights(path) ahorra pesos del adaptador y el estado del optimizador. Registre la referencia de punto de control con su sesión de origen y el estado del controlador.
Después de una actualización completada, guarde el estado de entrenamiento y registre su referencia de punto de comprobación o sesión de origen:
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Referencia: FineTuningSession.save_weights.
El método solo devuelve después de que se complete el guardado. Almacene checkpoint_path con la posición del conjunto de datos y otro estado del controlador antes de cerrar la sesión.
FineTuningSession.create_from_checkpoint restaura el estado de entrenamiento en una nueva sesión:
| Parameter | Meaning |
|---|---|
checkpoint_path |
Se guardó la referencia de punto de control de entrenamiento en <source-session-id>/<checkpoint-name> forma. |
base_model |
Modelo base compatible con el punto de control original. |
lora_config |
Configuración del adaptador compatible con una clasificación explícita. |
Un punto de comprobación del sampler no es un punto de control de entrenamiento de estado completo. Restaure la posición del conjunto de datos y la programación por separado en el controlador. Consulte Puntos de control.
Este asistente restaura el estado de entrenamiento guardado a través de un autenticado client. Pase el entrenamiento checkpoint_pathgrabado y mantenga el modelo base y la clasificación de LoRA compatibles con la sesión de origen.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Referencia: FineTuningSession.create_from_checkpoint.
La sesión devuelta tiene un nuevo identificador de sesión e inicia su propio latido. Cierre la sesión reanudada cuando se cierre su bucle, al cerrar una sesión recién creada.
Uso de operaciones asincrónicas
Los contenedores de libros y cliente asincrónicos del SDK no son intercambiables. Importe el cliente asincrónico desde azure.ai.finetuningsessions.aio; los tipos de modelo proceden de azure.ai.finetuningsessions.models.
| Interface | Patrón de finalización |
|---|---|
Síncrono FineTuningSession |
El método devuelve un resultado de operación completado. |
Métodos de comodidad del SDK asincrónico sin procesar, como save_weights_for_sampler_async |
Espere al envío y, a continuación, espere a que se complete el devuelto asyncio.Task . |
Métodos de contenedor de entrenamiento del libro de cocina, como save_state_async |
Espere el envío y, a continuación, espere a que el futuro sea result_async(). |
Para una sesión en directo que pertenece a un asincrónico client, este asistente conserva los pesos del muestreador y devuelve el identificador de punto de control completado:
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Referencia: FineTuningSessionClient.save_weights_for_sampler_async asincrónico.
Use save_weights_and_get_sampling_client_async en su lugar para una actualización del sampler efímero. En el cliente del SDK sin procesar, ese método sigue devuelve una tarea con un resultado de operación, no un cliente de muestreo de libros de cocina.
Await requiere guardar antes de descargar una sesión. El argumento de compatibilidad ttl_seconds del libro de cocina no se reenvía a estos guardados del SDK; no lo trate como una configuración de retención aplicada.
En el caso de los objetivos personalizados, el libro forward_backward_custom_async de cocina compone las salidas de reenvío del servicio con el cálculo de pérdida diferente del lado cliente. No es un método en FineTuningSessiony el parámetro del loss_fn SDK no acepta un Python arbitrario al que se puede llamar.
Cerrar recursos
session.close() detiene su latido y envía una solicitud de descarga. Llámalo cuando se cierre el bucle, incluido el error; después, cierre el cliente HTTP y las credenciales.
El cierre no confirma la finalización de la limpieza remota ni elimina los puntos de control.
session.delete() se puede aplicar en cascada a los recursos guardados. Consulte Inspección y descarga de sesiones.
Use el administrador de open_session contextos para ejecutar una única actualización de SFT y guardar el estado de entrenamiento. Defina open_session y apply_optimizer_step de los ejemplos anteriores y pase una SFT batchno representada.
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Referencia: FineTuningSession.close y FineTuningSession.save_weights.
El asistente devuelve una referencia de punto de control de entrenamiento. Su contexto envía una solicitud de descarga incluso si una operación de entrenamiento genera una excepción, cierra el cliente y la credencial.
Referencia del SDK
Use la referencia completa para ejemplos ejecutables, firmas de método, API asincrónicas, tipos de resultados y errores: