Generación de perfiles de datos
Antes de limpiar o transformar los datos, debe comprender lo que hay en las tablas. Datos de perfil se refiere a examinar los conjuntos de datos para generar estadísticas de resumen—recuentos, promedios, distribuciones de valor y porcentajes de nulos—que revelan la calidad y la estructura de los datos. Este fundamento le ayuda a identificar problemas como valores que faltan, valores atípicos y patrones inesperados antes de que causen problemas posteriormente.
En esta unidad, aprenderá a generar estadísticas de resumen mediante comandos SQL y la característica de generación de perfiles de datos en Azure Databricks.
Generación de estadísticas de resumen mediante SQL
Azure Databricks proporciona comandos SQL que recopilan y muestran estadísticas sobre las tablas. Estas estadísticas ayudan al optimizador de consultas a elegir planes de ejecución eficaces y le proporcionan información sobre las características de los datos.
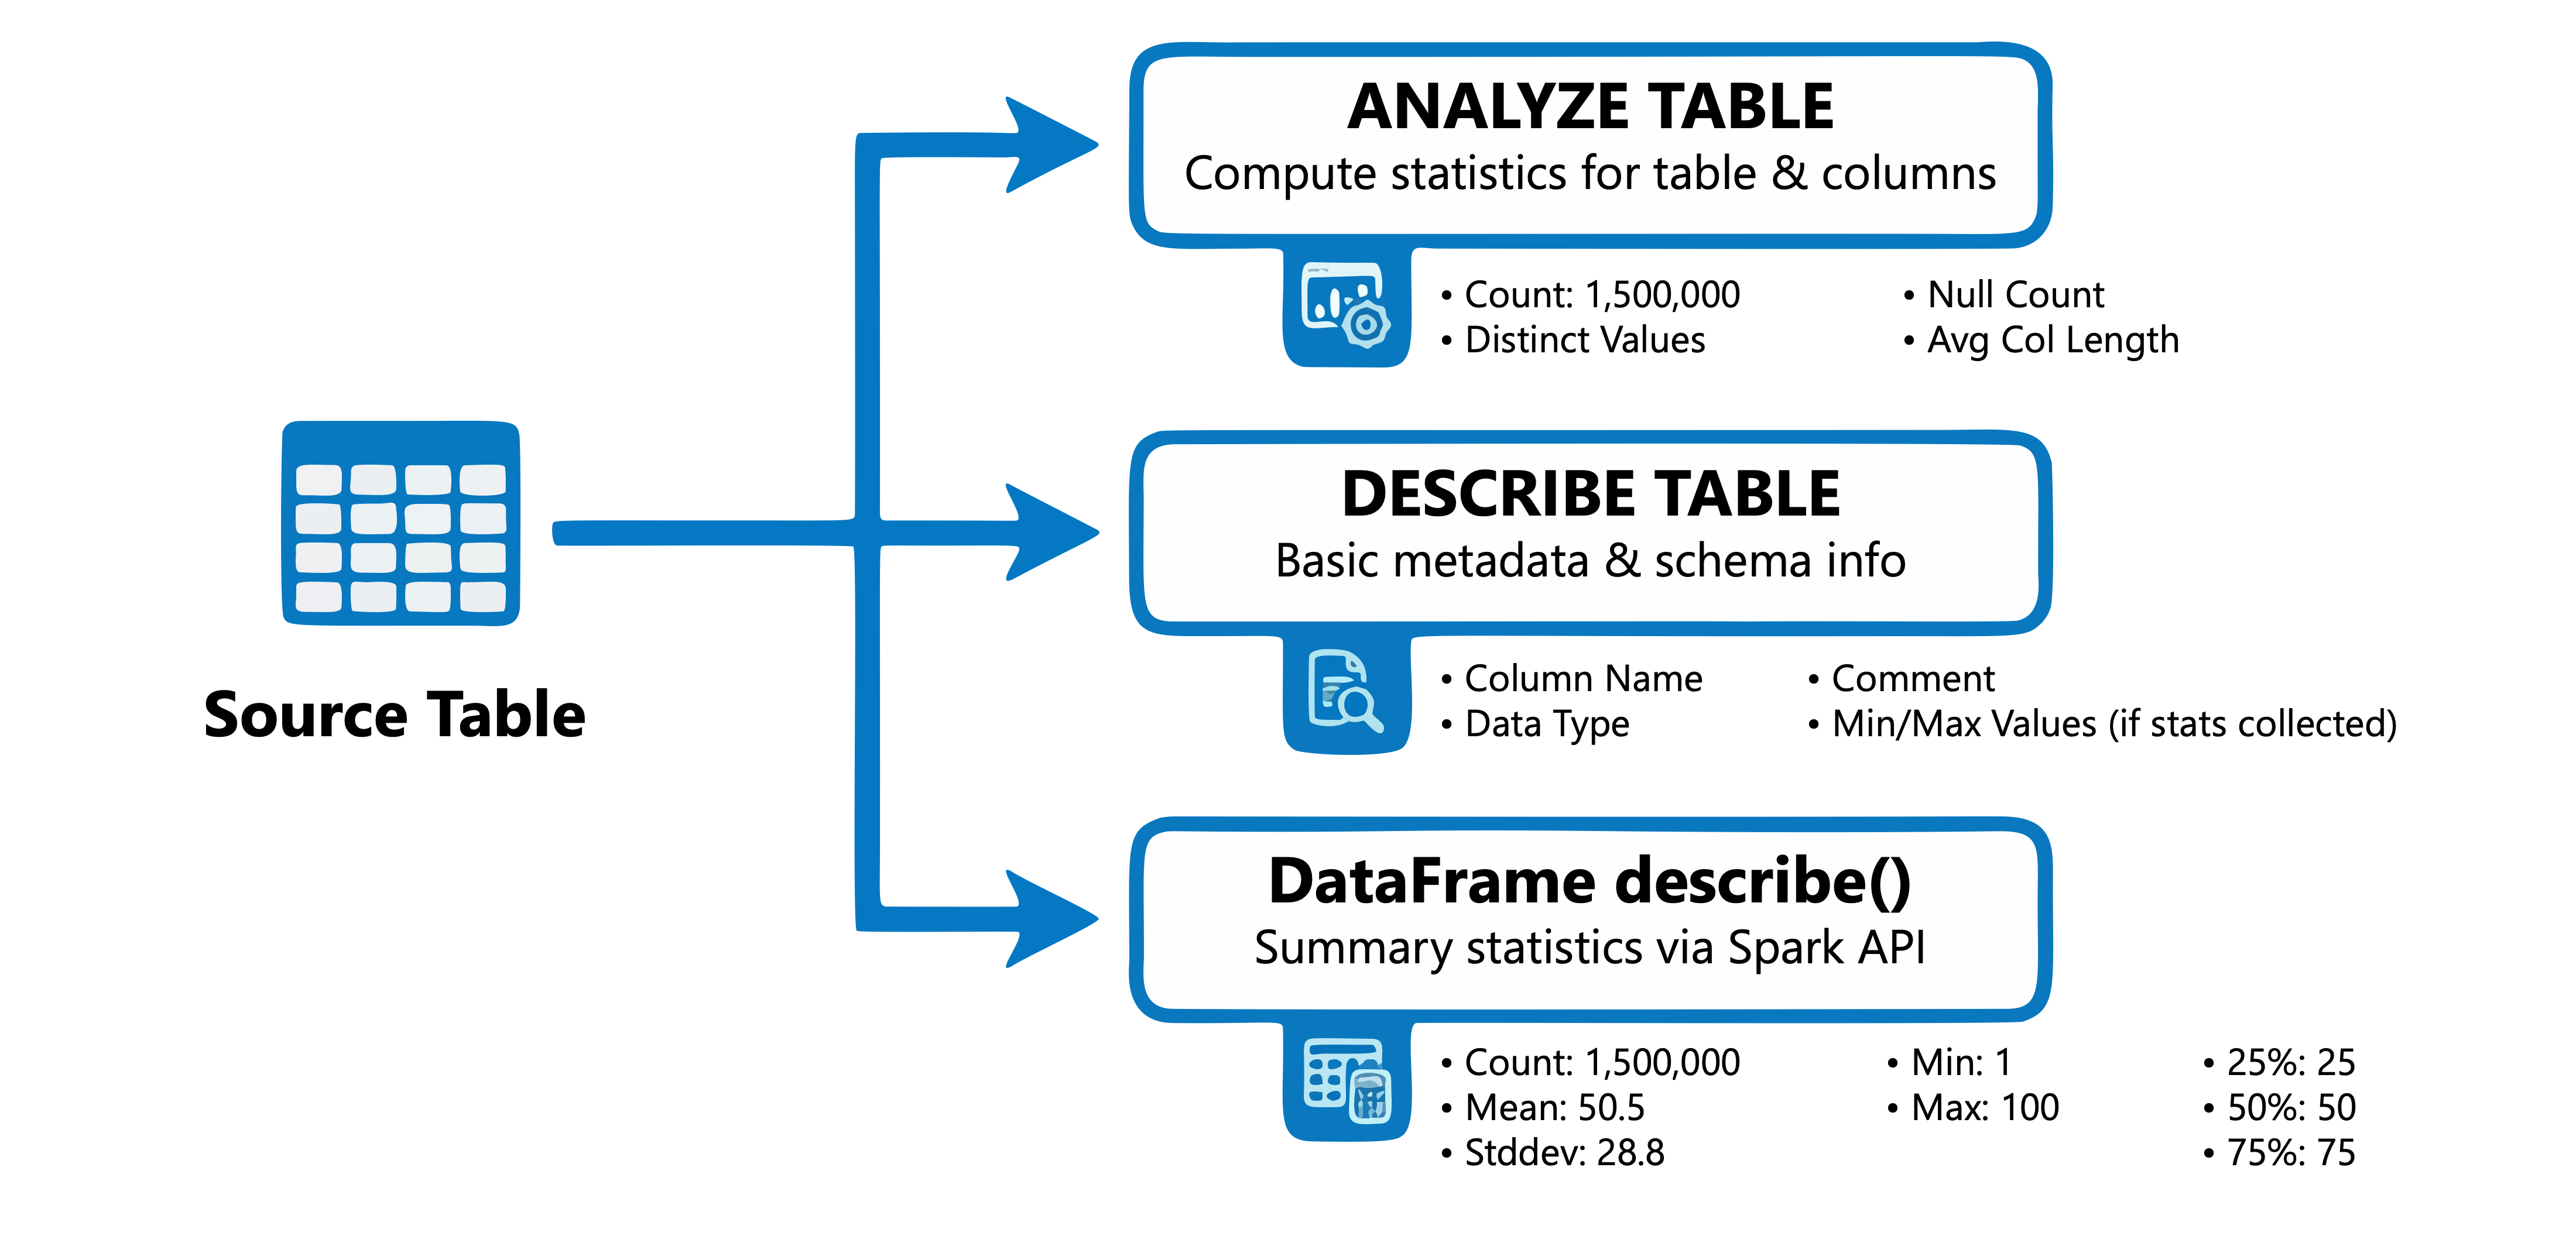
Recopilación de estadísticas con ANALYZE TABLE
El ANALYZE TABLE comando calcula las estadísticas de una tabla o columnas específicas. Estas estadísticas incluyen recuentos de filas, métricas de nivel de columna, como valores mínimos y máximos, recuentos null y recuentos de valores distintos.
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
Al analizar una columna específica, obtendrá métricas detalladas:
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
Esto devuelve métricas que incluyen el valor mínimo, el valor máximo, el número de valores NULL, el recuento distinto, la longitud media de la columna y la longitud máxima de la columna.
Visualización de estadísticas con DESCRIBE TABLE
El DESCRIBE TABLE EXTENDED comando muestra las estadísticas recopiladas junto con los metadatos de la tabla:
DESCRIBE TABLE EXTENDED sales.transactions;
También puede usar PySpark para recuperar metadatos de tabla y generar estadísticas de resumen:
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
El describe() método devuelve count, mean, standard deviation, min y max para las columnas numéricas y de cadena.
La DESCRIBE TABLE EXTENDED salida incluye una Statistics fila que muestra el tamaño de la tabla en bytes y, después de ejecutar ANALYZE TABLE ... COMPUTE STATISTICS, el recuento de filas. En el caso de las tablas administradas por el catálogo de Unity, la optimización predictiva se ejecuta ANALYZE automáticamente para mantener las estadísticas actualizadas.
Sugerencia
Ejecute ANALYZE TABLE después de cargas masivas de datos o cambios significativos para asegurarse de que el optimizador de consultas tiene estadísticas precisas para planear consultas eficaces.
Uso de la generación de perfiles de datos en el catálogo de Unity
Además de los comandos SQL, Azure Databricks proporciona supervisión de la calidad de los datos en el catálogo de Unity, un paraguas que cubre dos funcionalidades distintas:
- La detección de anomalías (versión preliminar pública) supervisa automáticamente todas las tablas de un esquema. Analiza los patrones históricos para evaluar la frescura de cada tabla (cuán reciente fue su actualización) y su completitud (si llegó el número esperado de filas). Se habilita una vez en el nivel de esquema en el Explorador de catálogos y Azure Databricks determina la frecuencia con la que se examina cada tabla. Utilice la detección de anomalías para lograr una cobertura amplia y automatizada en todas sus tablas sin necesidad de configuración por tabla.
- La generación de perfiles de datos proporciona un análisis estadístico profundo por tabla: las distribuciones de seguimiento, los porcentajes nulos, las métricas de desfase y el rendimiento del modelo a lo largo del tiempo. Se configura individualmente para cada tabla. Use la generación de perfiles de datos para las tablas más críticas en las que necesite tendencias históricas detalladas.
Para el trabajo de ingeniería de datos centrado en la limpieza y la calidad, use la detección de anomalías como un sistema de advertencia temprana en todas las tablas y la generación de perfiles de datos para la supervisión en profundidad de las tablas clave.

Descripción de los tipos de perfil
La generación de perfiles de datos admite tres tipos de análisis, cada uno adecuado para diferentes escenarios:
| Tipo de perfil | Caso de uso | Características clave |
|---|---|---|
| Snapshot | Tablas de uso general | Calcula las métricas en toda la tabla con cada actualización. |
| Serie temporal | Tablas con columnas de marca de tiempo | Realiza un seguimiento de las métricas en las ventanas de tiempo para detectar tendencias |
| Inferencia | Tablas de inferencia del modelo de ML | Supervisa las entradas, las predicciones y la precisión del modelo a lo largo del tiempo. |
Para las tareas de ingeniería de datos centradas en la calidad de los datos, los perfiles de instantáneas y series temporales son más relevantes.
Creación de un perfil mediante la interfaz de usuario
Para crear un perfil en el Explorador de catálogos:
- Navegue hasta su tabla en el Explorador de catálogo.
- Seleccione la pestaña Calidad .
- Si la detección de anomalías para el esquema no está habilitada, seleccione Habilitar. Si la detección de anomalías ya está habilitada, seleccione Configurar.
- En el cuadro de diálogo Supervisión de la calidad de los datos, en el campo Generación de perfiles de datos , seleccione Configurar.
- Elija el tipo de perfil y configure opciones como granularidad y programación.
El perfil genera una tabla de métricas de perfil con estadísticas de resumen y una tabla de métricas de deriva que realiza un seguimiento de los cambios de distribución a lo largo del tiempo. Azure Databricks rellena la tabla de métricas de deriva cuando hay disponible una tabla de referencia o una ventana de tiempo consecutiva.
Creación de un perfil mediante la API
Para el acceso mediante programación, use el SDK de Databricks. Instale o actualice el SDK para obtener la API actual:
%pip install "databricks-sdk>=0.68.0"
A continuación, cree un perfil de imagen instantánea para una tabla.
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
Para actualizar el perfil y actualizar las métricas:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
Interpretación de los resultados de generación de perfiles
La generación de perfiles genera métricas que le ayudan a evaluar la calidad de los datos e identificar problemas que requieren atención.
Métricas clave que se van a examinar
La tabla de métricas de perfil contiene estadísticas para cada columna:
| Métrica | Lo que revela |
|---|---|
count y num_nulls |
Integridad de los datos: los altos porcentajes nulos pueden indicar problemas de ingesta |
distinct_count |
Cardinalidad: los valores inesperados pueden sugerir problemas de calidad de datos |
min, max, , avg, stddev |
Características de distribución: valores atípicos o distribuciones sesgadas |
frequent_items |
Valores más comunes: ayuda a identificar categorías dominantes o duplicados |
quantiles |
Distribución de valores: útil para detectar asimetría |
Detección de problemas de calidad de datos
Al examinar los resultados de generación de perfiles, busque estos indicadores comunes:
- Altos porcentajes de valores nulos en columnas que deberían tener valores
- Recuentos distintos inesperados, como identificadores únicos que no son únicos
- Intervalos de valores fuera de los límites esperados, como cantidades negativas en las que solo los positivos son válidos.
- Cambios de distribución a lo largo del tiempo, que pueden indicar el desfase de datos
La tabla de métricas de deriva calcula pruebas estadísticas como la prueba de Kolmogorov-Smirnov (KS) para columnas numéricas y la prueba de chi-cuadrado para columnas categóricas. Estas pruebas cuantifican la cantidad de distribuciones que han cambiado.
Comprender estos patrones le ayuda a diseñar reglas de limpieza y validación adecuadas para las canalizaciones de datos.