Elección de una herramienta de ingesta de datos
Al diseñar canalizaciones de datos en Azure Databricks, seleccionar la herramienta de ingesta adecuada afecta directamente a la confiabilidad de la canalización, el esfuerzo de mantenimiento y los costos a largo plazo. Cada herramienta aborda diferentes escenarios, orígenes de datos y requisitos operativos. Comprender estas diferencias le ayuda a tomar decisiones fundamentadas que se adapten a las necesidades de su organización.
Comprender el panorama de las herramientas de ingesta
Azure Databricks proporciona varias opciones de ingesta que abarcan un espectro de servicios totalmente administrados a marcos altamente personalizables. Las herramientas que elija dependen de factores como el tipo de origen de datos, los requisitos de latencia y la cantidad de control que necesita sobre el proceso de ingesta.

En el extremo más gestionado, Lakeflow Connect ofrece conectores llave en mano para aplicaciones y bases de datos empresariales. Estos conectores controlan automáticamente la autenticación, el seguimiento de cambios, la recuperación de errores y la evolución del esquema. En el ámbito de personalización, Spark Structured Streaming le ofrece un control completo de cómo fluyen los datos a través de la canalización, aunque requiere más esfuerzo de desarrollo y mantenimiento.
Entre estos extremos, encontrará herramientas como Auto Loader para archivos de almacenamiento en la nube, COPY INTO para la carga por lotes basada en SQL y enfoques basados en cuadernos mediante conexiones JDBC/ODBC . Además, Azure Data Factory actúa como una capa de orquestación que puede coordinar el movimiento de datos en Azure Databricks desde el ecosistema de Azure más amplio.
Lakeflow Connect
Lakeflow Connect representa el enfoque moderno para la ingesta de datos en Azure Databricks. Ofrece conectores totalmente administrados y conectores estándar que se integran con las canalizaciones de Lakeflow para una experiencia simplificada.
Los conectores administrados se organizan en tres tipos:
conectores SaaS proporcionan integración integrada con aplicaciones empresariales como Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk y muchas otras. Estos conectores controlan la autenticación específica del origen, las lecturas incrementales, la limitación de velocidad de API, la evolución del esquema y los reintentos automatizados. Se ejecutan en computación sin servidor y escriben en tablas de streaming controladas por el catálogo de Unity.
Conectores de Base de Datos ingieren datos de bases de datos relacionales, como MySQL, PostgreSQL y SQL Server mediante la captura de datos de cambios (CDC). Dado que los conectores basados en CDC leen desde registros de transacciones de base de datos en lugar de consultar tablas directamente, requieren una puerta de enlace de ingesta implementada en la red y un volumen de almacenamiento provisional para almacenar en búfer los cambios capturados.
Los conectores de la comunidad son conectores de código abierto creados y mantenidos por la comunidad. Extienden Lakeflow Connect a orígenes que aún no tienen un conector administrado. Puede usar un conector de comunidad existente o contribuir por su cuenta.
Nota:
El ecosistema del conector está creciendo rápidamente. Consulte la documentación de conectores administrados para obtener la lista completa actual de orígenes admitidos.
Los conectores estándar amplían Lakeflow Connect al almacenamiento de objetos en la nube y a los buses de mensajes. Puede ingerir datos de Amazon S3, Azure Data Lake Storage o Google Cloud Storage mediante Auto Loader. Para los datos en tiempo real, los conectores estándar admiten Apache Kafka, Google Pub/Sub y Apache Pulsar.

Considere Lakeflow Connect cuando necesite una ingestión confiable y de bajo mantenimiento de fuentes compatibles. Los conectores administrados reducen significativamente el tiempo de desarrollo y el mantenimiento continuo en comparación con las soluciones personalizadas. Sin embargo, si su fuente de datos no es compatible o necesita una lógica de ingestión altamente especializada, es posible que deba explorar otras opciones.
Lakeflow Connect admite la ingesta programada (horaria, diaria, semanal) y desencadenadores a petición, lo que hace que sea adecuado para ciclos de actualización de datos regulares y escenarios de carga ad hoc.
Conectores basados en consultas
Los conectores basados en consultas son una alternativa ligera a los conectores de base de datos CDC para la ingesta programada de bases de datos relacionales. En lugar de leer los registros de transacciones, consultan la tabla de origen directamente mediante una columna de cursor, que es un entero o una marca de tiempo creciente de manera monótona que hace un seguimiento de las filas nuevas o actualizadas desde la última ejecución de la canalización.
Dado que consultan directamente el origen, los conectores basados en consultas no requieren una puerta de enlace de ingesta ni un almacenamiento provisional. En cada ejecución programada, el conector recupera todas las filas cuyo valor en la columna del cursor sea superior al punto máximo alcanzado en la ejecución anterior y, a continuación, escribe los resultados en las tablas de streaming de Unity Catalog.
Entre los orígenes admitidos se incluyen Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL y todos los orígenes de datos de federación de Lakehouse.
Los conectores basados en consultas admiten tres modos de seguimiento del historial para las tablas de destino:
- SCD Tipo 1: sobrescribe la fila existente con la fila de origen más reciente. No se conserva ningún historial.
- SCD Tipo 2: conserva el historial completo agregando nuevas filas con metadatos de versión.
- Solo anexar: se anexa cada fila ingerida sin combinar ni sobrescribir.
Elija conectores basados en consultas en lugar de conectores de base de datos basados en CDC cuando no esté disponible la infraestructura CDC o binlog, pero exista una columna de cursor confiable en el origen. Opte por los conectores CDC cuando necesite conocer el estado de cada fila entre ejecuciones de la canalización o cuando el seguimiento de las eliminaciones temporales sea fundamental. La contrapartida es que los conectores basados en consultas imponen más carga directamente en las tablas de origen en comparación con los conectores CDC, que leen desde el binlog.
Cargador automático
Auto Loader proporciona procesamiento incremental de archivos para los datos que llegan al almacenamiento en la nube. En lugar de examinar directorios completos para buscar nuevos archivos, Auto Loader realiza un seguimiento eficaz de los archivos que se han procesado e ingiere solo las nuevas llegadas.
El cargador automático funciona manteniendo el estado en una ubicación de punto de control que rastrea los archivos procesados. Cuando los nuevos archivos llegan al almacenamiento en la nube, Auto Loader los detecta a través de la lista de directorios o el modo de notificación de archivos. La lista de directorios examina periódicamente los archivos nuevos, mientras que el modo de notificación de archivos usa eventos nativos en la nube para la detección inmediata.
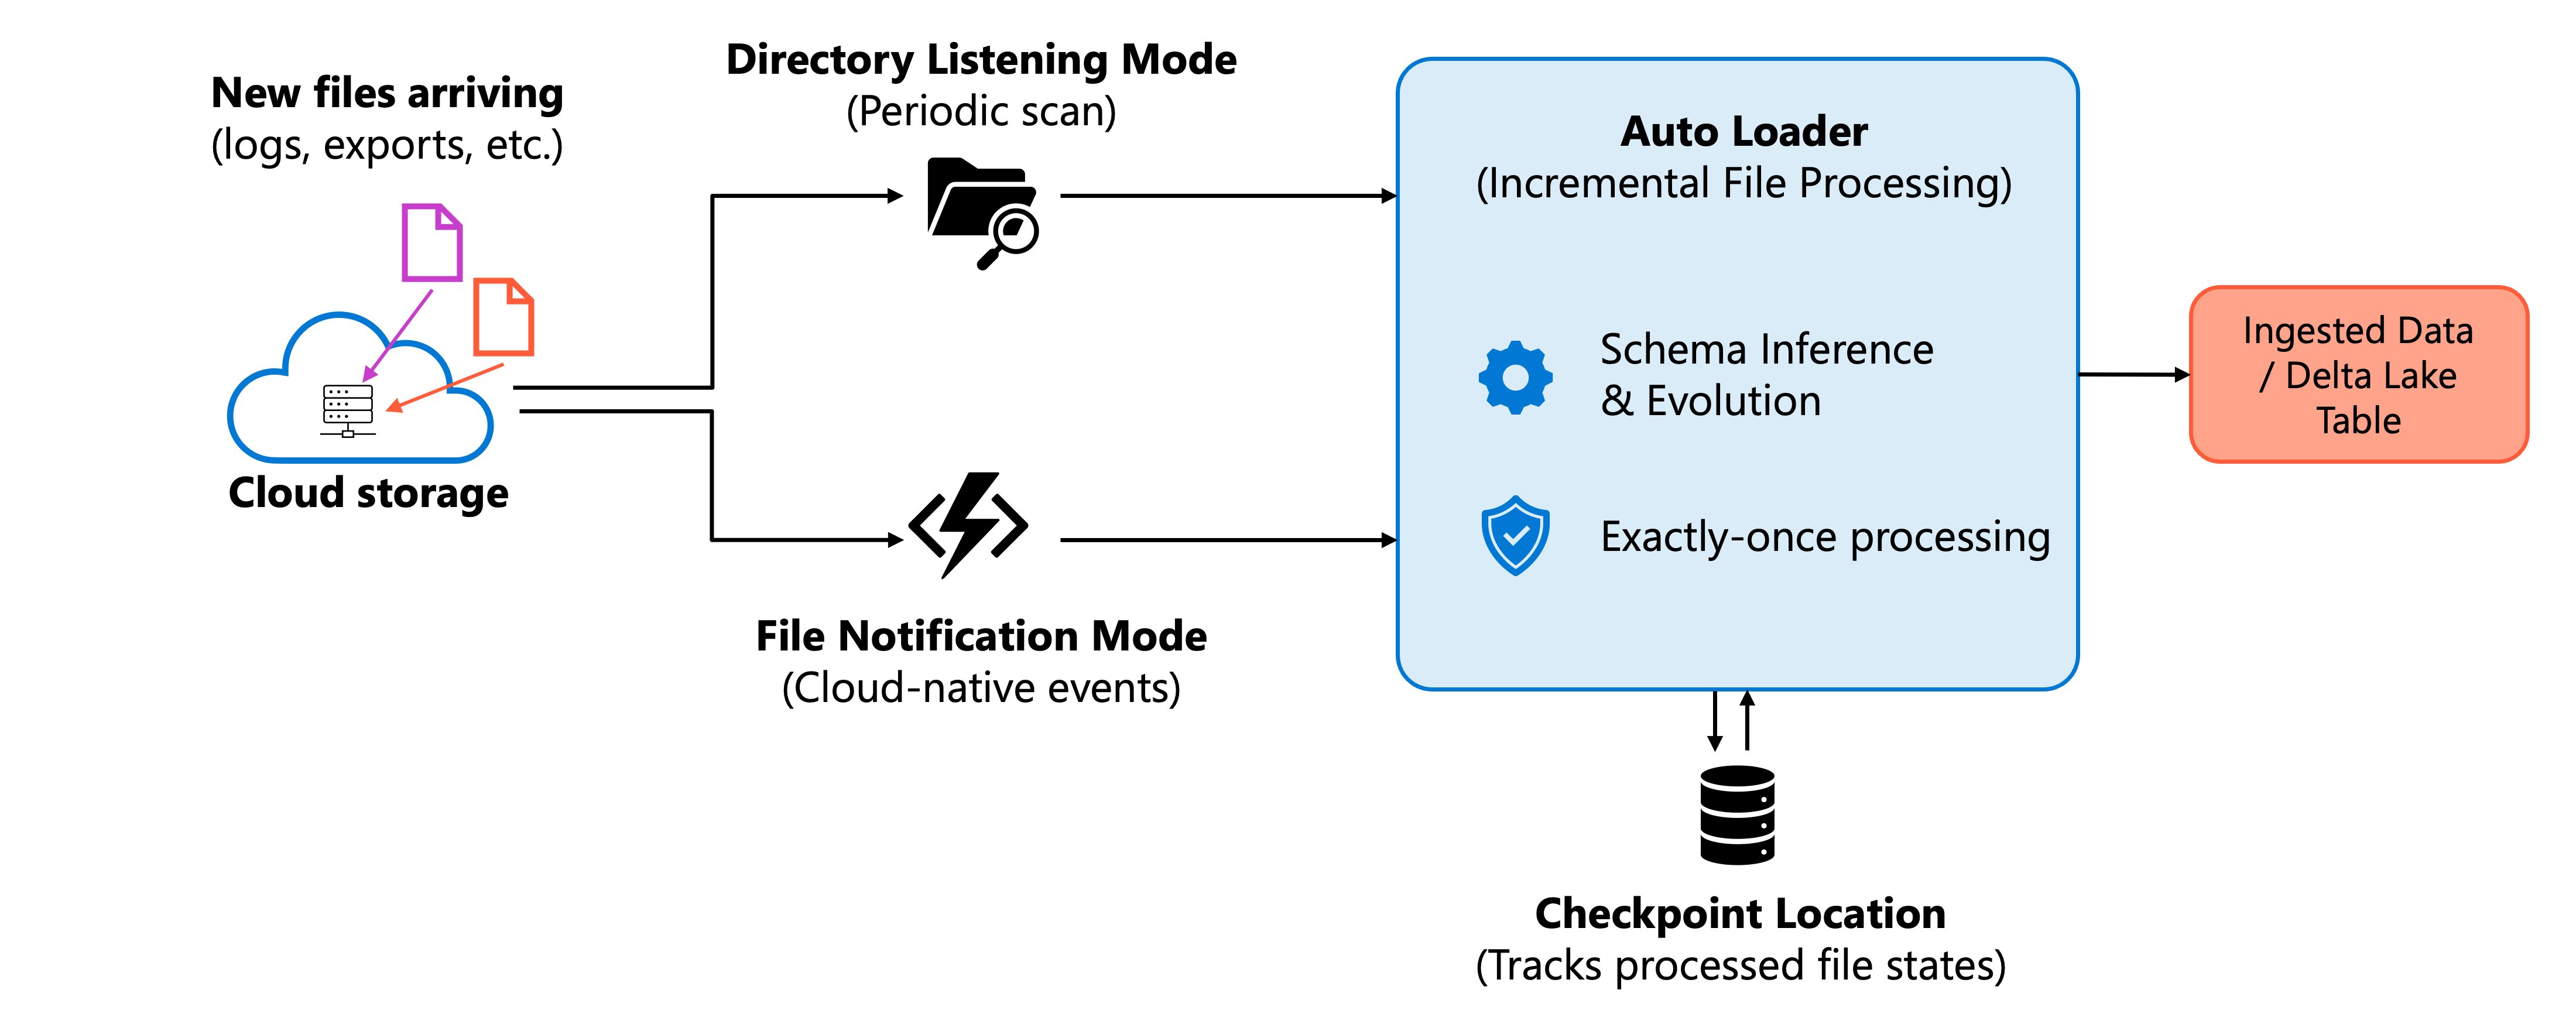
Entre las principales funcionalidades del cargador automático se incluyen las siguientes:
- Inferencia y evolución del esquema: detecta automáticamente el esquema de los archivos entrantes y controla los cambios de esquema correctamente.
- Procesamiento exactamente una vez: garantiza que cada archivo se procesa una vez, incluso entre errores y reinicios.
- Escalabilidad: controla de forma eficaz miles de millones de archivos para reposición o migraciones.
- Compatibilidad con formato: procesa archivos JSON, CSV, Parquet, Avro, ORC, XML, texto y binarios.
Auto Loader se adapta a escenarios en los que llegan datos como archivos en el almacenamiento en la nube: los patrones comunes incluyen archivos de registro, exportaciones desde sistemas ascendentes y zonas de aterrizaje de datos. Puede usar Auto Loader con canalizaciones de Lakeflow para una experiencia administrada o con Structured Streaming para obtener más control.
COPIAR EN
El COPY INTO comando SQL carga datos del almacenamiento en la nube en tablas Delta. A diferencia de Auto Loader, que se ejecuta continuamente como una secuencia, COPY INTO se ejecuta como una operación por lotes que programa o desencadena manualmente.
COPY INTO realiza un seguimiento de los archivos que ya ha procesado, lo que hace que la operación sea idempotente. Ejecutar el mismo comando varias veces no duplica los datos porque se omiten los archivos cargados previamente. Esta característica resulta COPY INTO útil para los trabajos por lotes programados donde se busca un comportamiento predecible y repetible.
Nota:
Los metadatos de seguimiento se almacenan como parte del registro de transacciones de la tabla Delta (el _delta_log directorio)

Los escenarios comunes para COPY INTO incluyen migraciones de datos únicas, cargas por lotes programadas desde zonas de destino y flujos de trabajo SQL-first donde se prefiere la sintaxis declarativa en lugar de las API de transmisión.
Elija COPY INTO en lugar de Auto Loader cuando realice una carga por lotes única de un gran conjunto de datos.
COPY INTO proporciona un modelo de configuración más sencillo sin necesidad de infraestructura de streaming, por lo que resulta ideal para cargar cientos de gigabytes o incluso terabytes de datos en una sola operación. El modelo de procesamiento continuo del cargador automático y la administración de puntos de control agregan complejidad innecesaria cuando solo es necesario cargar datos una vez.
Sin embargo, para la ingesta incremental en curso a escala, Auto Loader proporciona un mejor rendimiento y una detección de archivos más sólida.
Streaming estructurado de Spark
Spark Structured Streaming proporciona la base para el procesamiento de datos en tiempo real en Azure Databricks. Permite la ingesta continua desde varias fuentes de streaming con garantías de procesamiento exactamente una vez.
Entre los orígenes de streaming admitidos se incluyen:
- Apache Kafka y Azure Event Hubs: para arquitecturas controladas por eventos y procesamiento de colas de mensajes.
- Fuentes de cambios de Delta Lake: Para propagar cambios entre tablas Delta.
- Almacenamiento en la nube mediante el cargador automático: Para la ingesta de streaming basada en archivos.
- Socket y orígenes personalizados: Para escenarios de ingesta especializados.
Elija Structured Streaming cuando necesite un control específico sobre el comportamiento de streaming, la marca de agua personalizada o la lógica de ventanas, o cuando trabaje con orígenes no compatibles con abstracciones de nivel superior.
Conexiones JDBC y ODBC
La ingesta basada en cuadernos mediante JDBC o ODBC sigue siendo un enfoque práctico para extraer datos de bases de datos relacionales. Tú escribes código que se conecta directamente a las bases de datos de origen, ejecuta consultas y carga resultados en tablas Delta.
Este enfoque admite prácticamente cualquier base de datos con un controlador JDBC o ODBC: SQL Server, Oracle, PostgreSQL, MySQL y muchos otros. Implementa cargas completas o incrementales escribiendo consultas apropiadas, a menudo usando columnas de marca de agua para rastrear el progreso de la extracción.
Aunque los conectores administrados de Lakeflow Connect reemplazan JDBC/ODBC para muchos escenarios, las conexiones basadas en cuadernos siguen siendo valiosas cuando:
- Los conectores administrados de Lakeflow Connect no son compatibles con tu base de datos.
- Necesita lógica de extracción personalizada que los conectores administrados no puedan acomodar.
- Estás manteniendo las tuberías existentes que utilizan este patrón.
- Necesita optimizaciones de inserción de consultas específicas para tablas grandes.
Al usar JDBC/ODBC, almacene credenciales de forma segura mediante secretos de Databricks en lugar de codificarlos de forma segura en cuadernos. Tenga en cuenta el impacto en el rendimiento en los sistemas de origen e implemente la limitación o programación adecuadas para evitar sobrecargar las bases de datos transaccionales.
En el caso de las bases de datos locales, se requiere una infraestructura de red adicional, ya sea Azure ExpressRoute/VPN para la conectividad directa de JDBC desde Databricks o Azure Data Factory con un entorno de ejecución de integración de Self-Hosted para almacenar primero datos en el almacenamiento en la nube.
Azure Data Factory
Azure Data Factory (ADF) actúa como una plataforma de orquestación y movimiento de datos dentro del ecosistema de Azure. Se destaca en la coordinación de flujos de trabajo que abarcan varios servicios y en la integración de datos de diversos orígenes en el almacenamiento en la nube, donde Azure Databricks puede procesarlos.
ADF se integra ampliamente con servicios de Microsoft como Dynamics 365, Azure SQL Database y Microsoft Fabric. Cuando los datos se originan en estos orígenes, ADF proporciona conectividad sencilla y puede aterrizar datos en Azure Data Lake Storage para su posterior procesamiento de Databricks.
Comprender el rol adecuado de ADF es importante. Use ADF para:
- Orquestación: coordinación de flujos de trabajo que implican varios servicios de Azure.
- Aterrizaje inicial de datos: traslado de datos de orígenes de Azure al almacenamiento en la nube.
- Integración empresarial: cuando la directiva de empresa exige ADF para el movimiento de datos.

Evite usar ADF para las transformaciones ETL principales dentro de Databricks. La ejecución de transformaciones a través de actividades de ADF presenta una complejidad innecesaria y funciona de forma menos eficaz que el procesamiento nativo de Databricks. Deje que ADF gestione la transferencia de datos a su lakehouse y luego utilice las herramientas de Azure Databricks para la lógica de transformación.
Aplicación de un marco de decisión
La selección de una herramienta de ingesta se vuelve más clara al evaluar el escenario con respecto a los criterios de decisión clave.
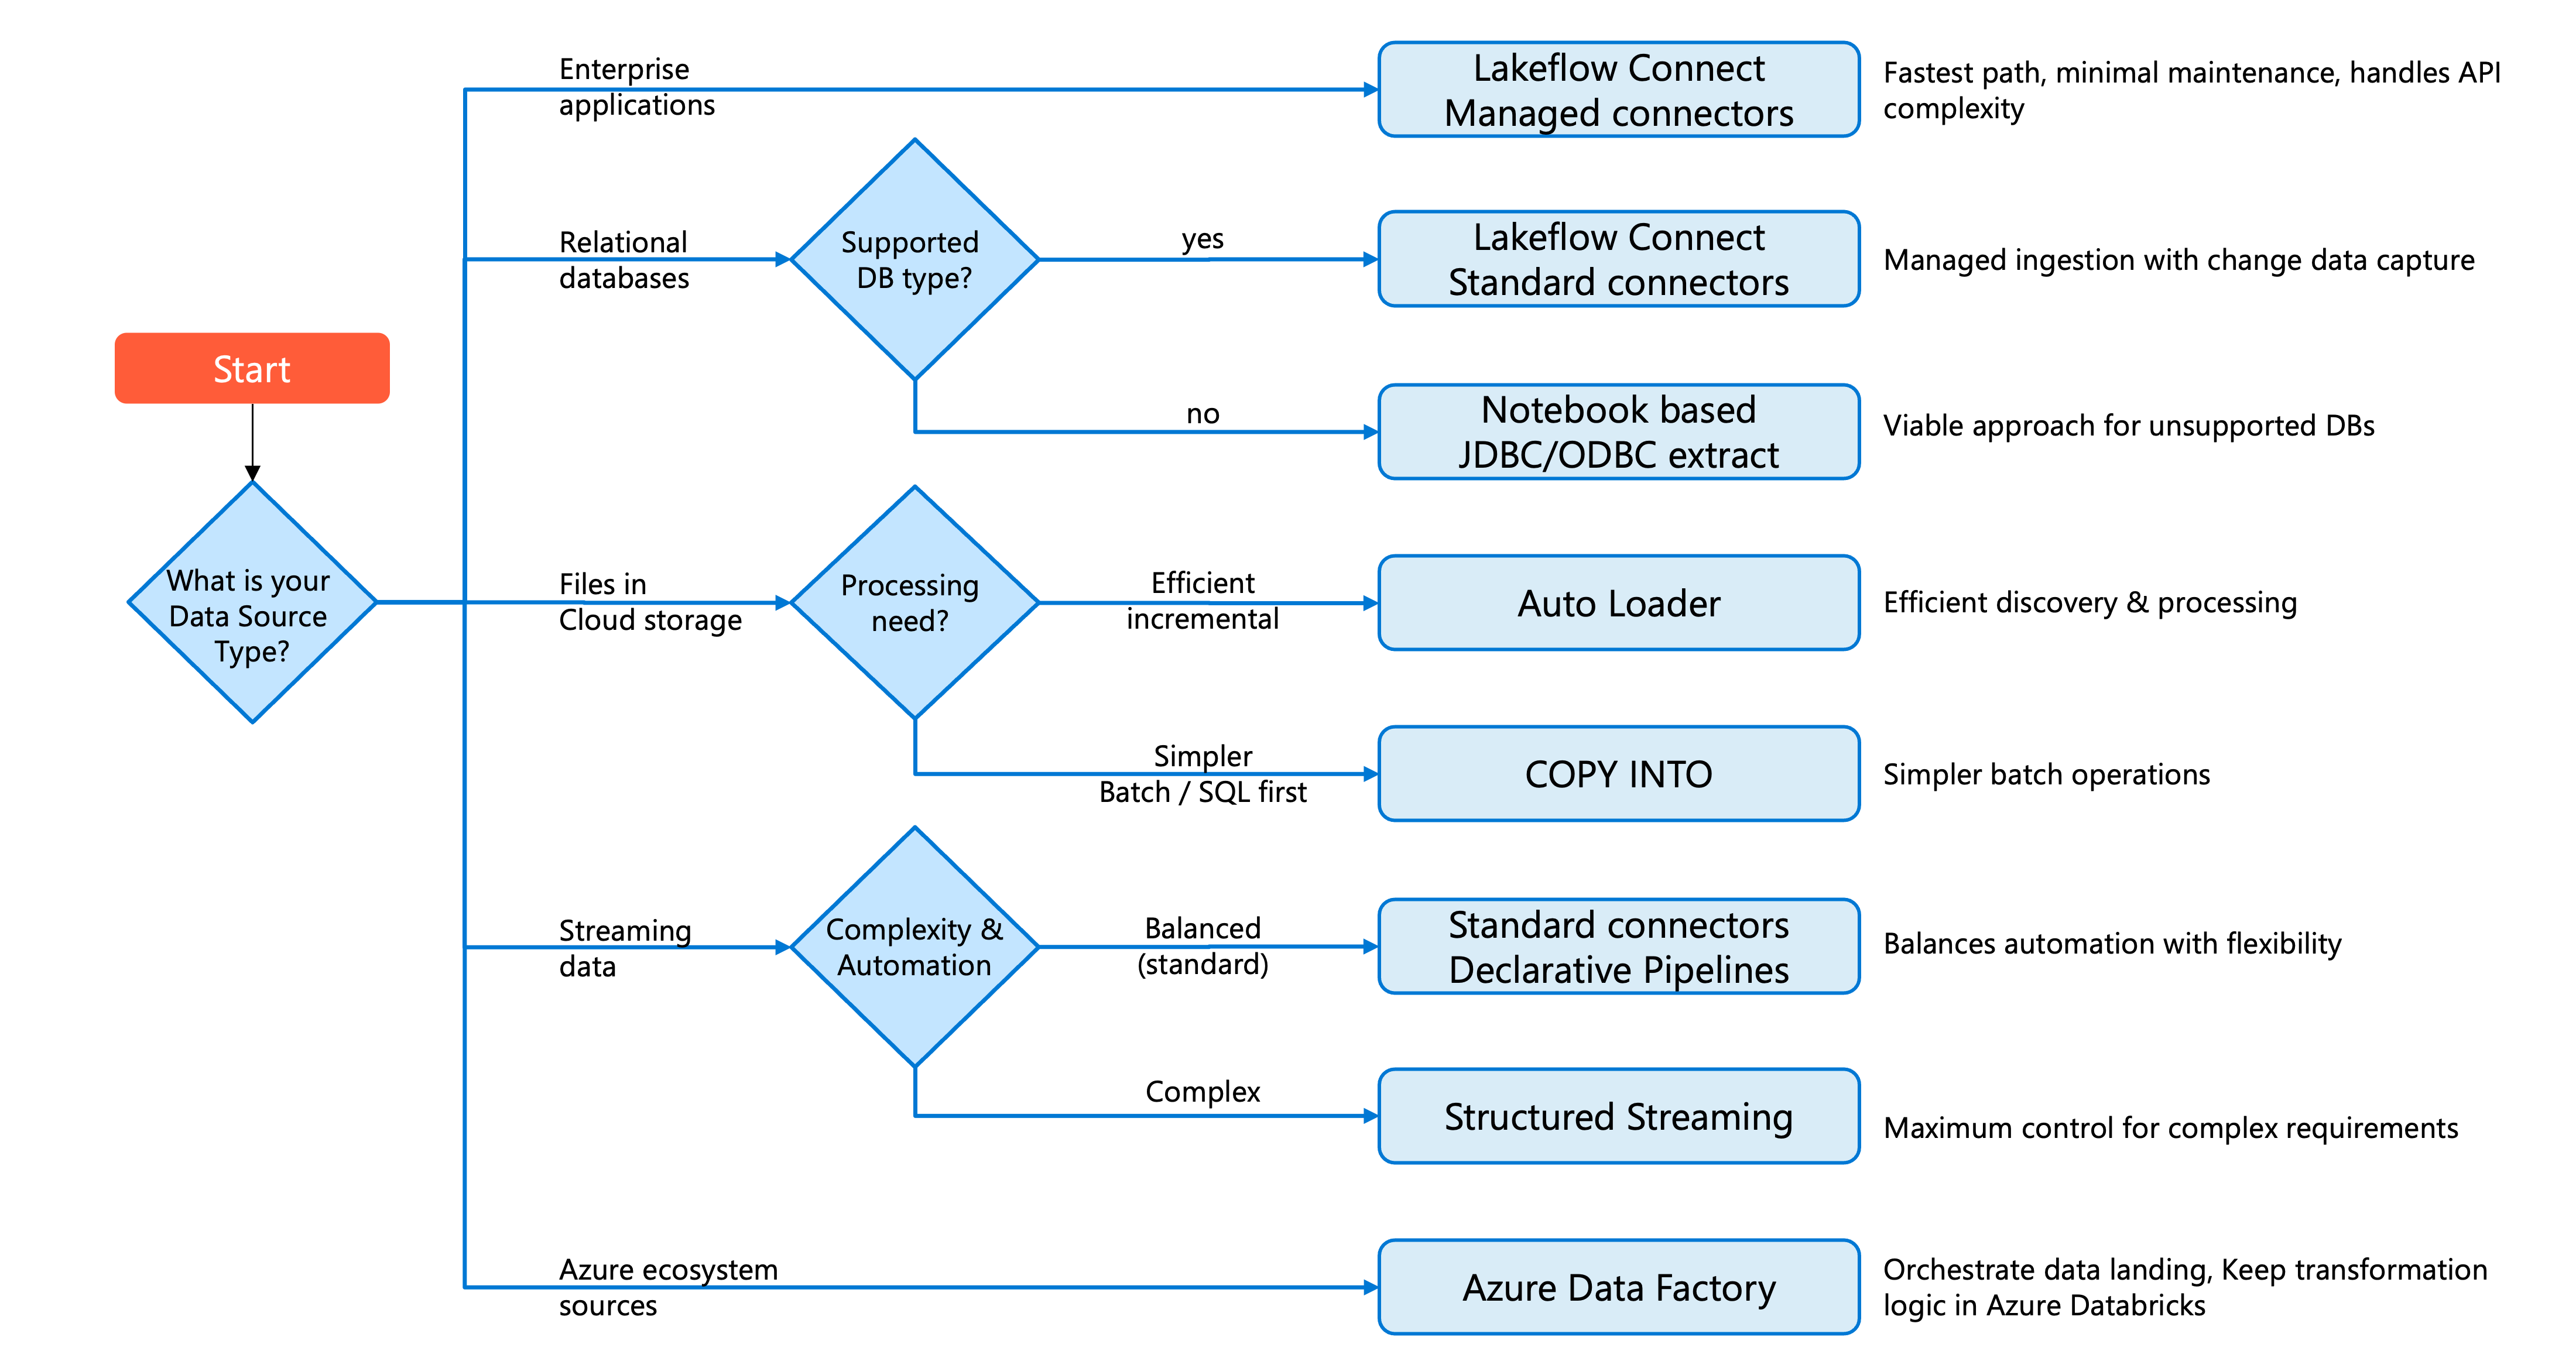
Empiece por identificar el tipo de origen de datos y, a continuación, tenga en cuenta los requisitos operativos y el contexto organizativo.
En el caso de las aplicaciones empresariales (Salesforce, ServiceNow, SharePoint), los conectores administrados de Lakeflow Connect ofrecen la ruta de acceso más rápida a la producción con un mantenimiento mínimo. Estos conectores controlan la complejidad de la integración de API, la limitación de velocidad y el seguimiento de cambios.
En el caso de las bases de datos relacionales con tipos admitidos, Lakeflow Connect ofrece dos rutas de acceso administradas: conectores de base de datos (basados en CDC, requiere puerta de enlace) para la captura continua de cambios y conectores basados en consultas para la ingesta programada más sencilla mediante una columna de cursor. En el caso de las bases de datos no admitidas, la extracción JDBC/ODBC basada en cuadernos sigue siendo un enfoque viable.
En el caso de los archivos en el almacenamiento en la nube, Auto Loader proporciona una detección y un procesamiento incremental eficaces. Utilice COPY INTO para escenarios de lotes más sencillos o cuando prefiera flujos de trabajo SQL-first.
Para datos en streaming desde buses de mensajes (Kafka, Event Hubs, Pub/Sub), los conectores estándar con canalizaciones de Lakeflow equilibran la automatización con flexibilidad. Para requisitos complejos de streaming, Structured Streaming ofrece el máximo control.
Para orígenes del ecosistema de Azure que requieren coordinación con otros servicios, Azure Data Factory puede orquestar la llegada de los datos a su lakehouse. Mantenga la lógica de transformación en Azure Databricks en lugar de en flujos de datos de ADF.
Sugerencia
Comience con la opción más administrada que cumpla sus requisitos. Los conectores administrados reducen el tiempo de desarrollo y la carga de mantenimiento. Solo pase a enfoques más personalizables cuando no se puedan cumplir requisitos específicos mediante abstracciones de nivel superior.
Su elección también depende de las aptitudes del equipo y los estándares de la organización. Documente sus decisiones y el razonamiento subyacente para ayudar a los futuros miembros del equipo a comprender la arquitectura de la canalización.