Muistiinpano
Tämän sivun käyttö edellyttää valtuutusta. Voit yrittää kirjautua sisään tai vaihtaa hakemistoa.
Tämän sivun käyttö edellyttää valtuutusta. Voit yrittää vaihtaa hakemistoa.
Fabric Runtime tarjoaa saumattoman integraation Fabric-ekosysteemissä, tarjoten vahvan ympäristön data-insinööri- ja data-analytiikkaprojekteille, joita tukee Apache Spark.
Tässä artikkelissa esitellään Fabric Runtime 2.0, uusin yleisesti saatavilla oleva (GA) ja oletusajonaikainen versio Microsoft Fabric. Runtime 2.0 on oletusvalinta uusille työtiloille ja ympäristökohteille. Se tarjoaa ominaisuuksia ja komponentteja skaalautuvaan analytiikkaan ja edistyneisiin työkuormiin.
Fabric Runtime 2.0 sisältää seuraavat komponentit ja päivitykset, jotka on suunniteltu parantamaan datankäsittelykykyäsi:
- Apache Spark 4.1
- Käyttöjärjestelmä: Azure Linux 3.0 (Mariner 3.0)
- Java: 21
- Scala: 2.13
- Python: 3.13
- Delta-järvi: 4,2
- R: 4.5.2
Tärkeää
Fabric-ajonaikaiset julkaisukanavat antavat sinun testata tulevia ajonaikaisia muutoksia ja varmistaa työkuormien yhteensopivuuden ennen kuin päivitykset muuttuvat oletuksiksi. Tämä lähestymistapa auttaa vähentämään odottamattomia tuotantohäiriöitä ja tarjoaa paremman hallinnan ajonaikaisiin päivityksiin. Lue lisää julkaisukanavista.
Vinkki
Fabric Runtime 2.0 sisältää tuen Native Execution Enginelle, joka voi merkittävästi parantaa suorituskykyä ilman lisäkustannuksia. Voit ottaa natiivisuoritusmoottorin käyttöön ympäristötasolla, jolloin kaikki työt ja muistikirjat perivät automaattisesti parannetut suorituskykyominaisuudet.
Ota käyttöön Runtime 2.0
Uudet työtilat ja ympäristöelementit käyttävät oletuksena Runtime 2.0:aa. Jos työtilasi tai ympäristösi käyttää aiempaa ajonaikaista, seuraa näitä ohjeita valitaksesi Runtime 2.0 työkuormien yhteensopivuuden varmistamisen jälkeen. Ympäristön kohteen ajonaikainen valinta ohittaa työtilan oletusarvon muistikirjoille ja Spark-työtehtävien määrittelyille, jotka on liitetty kyseiseen ympäristöön.
Ota Runtime 2.0 käyttöön Workspace-asetuksissa
Asetetaan Runtime 2.0 oletuseksi koko työtilallesi:
Siirry Workspace-asetuksiin Fabric-työtilassasi.
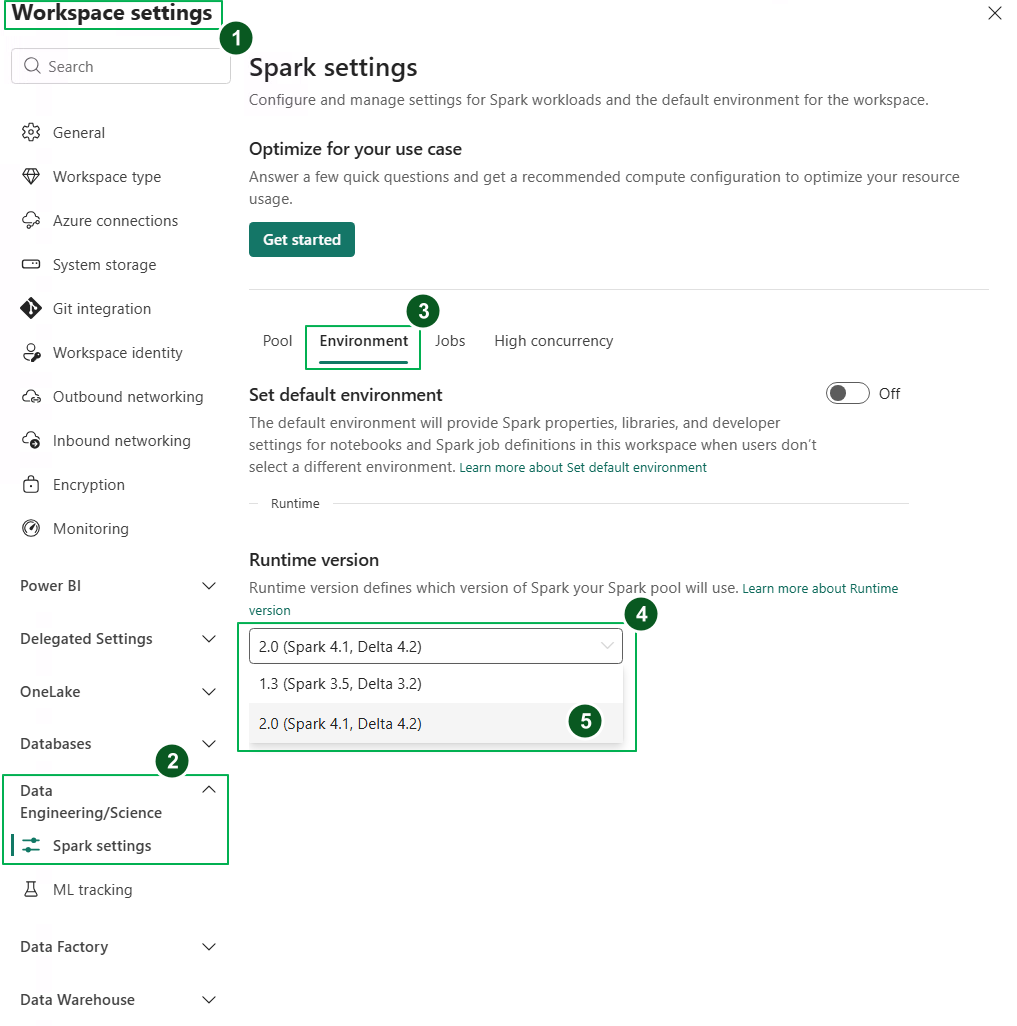
Valitse Data Engineering/Science -välilehti ja valitse sitten Spark settings.
Valitse Ympäristö-välilehti .
Runtime-version pudotusvalikosta valitse 2.0 (Spark 4.1, Delta 4.2) ja tallenna muutokset.
Runtime 2.0 on asetettu oletusajonaikaksi työtilallesi.
Ota käyttöön Runtime 2.0 Ympäristö-kohteessa
Käyttääksesi Runtime 2.0:aa tiettyjen muistikirjojen tai Spark-tehtävämääritelmien kanssa:
Luo uusi Ympäristö-kohde tai avaa olemassa oleva.
Runtime-pudotusvalikosta valitse 2.0 (Spark 4.1, Delta 4.2),tallenna ja julkaise muutoksesi.

Seuraavaksi käytä tätä Ympäristö-elementtiä muistikirjan tai Sparkin työmäärittelyn kanssa.

Voit nyt aloittaa työskentelyn Fabric Runtime 2.0:n uusimpien parannusten ja toimintojen (Spark 4.1 ja Delta Lake 4.2) kanssa.
Note
Ennen kuin vaihdat olemassa olevan työtilan tai ympäristön Runtime 2.0:aan, varmista kirjastosi, Spark-asetuksesi ja työkuormasi. Yhteensopivuusnäkökohdista ja vaiheittaisesta migraatioprosessista katso Migrate from Runtime 1.3 to Runtime 2.0.
Vinkki
Saat ajan tasalla olevat tiedot, yksityiskohtaisen luettelon muutoksista ja Fabric-suorituspalvelun erityisistä julkaisutiedoista tarkistamalla Spark Runtimes -julkaisut ja -päivitykset ja tilaamalla ne.
Tärkeimmät tiedot
Suorituskyvyn ja suoritusmoottorin parannukset
Fabric Runtime 2.0 sisältää Native Execution Enginen, joka tarjoaa merkittäviä suorituskyvyn parannuksia avoimen lähdekoodin Spark-ohjelmistoon verrattuna. Moottori käyttää vektoroitua käsittelyä nopeuttaakseen Spark-kyselyitä järvenrakennusinfrastruktuurissa ilman, että koodimuutoksia tarvitaan.
Keskeiset suorituskykyominaisuudet Runtime 2.0:ssa:
- Jopa kuusi kertaa nopeampia: Testit näyttävät jopa kuusi kertaa nopeampaa suorituskykyä verrattuna avoimen lähdekoodin Sparkiin TPC-DS työkuormissa.
- Vektoroitu CSV-jäsennys: Natiivisuoritusmoottori sisältää vektoroidun CSV-jäsentimen, joka nopeuttaa CSV:n vastaanottoa ja kyselykuormia. Vektoroitu JSON-jäsennys ja Spark Structured Streaming -tuki ovat suunnitteilla tulevia päivityksiä varten.
Natiivin suoritusmoottorin ottamiseksi käyttöön katso Fabric Data Engineeringin natiivisuoritusmoottori.
Apache Spark 4.1
Apache Spark 4.0 merkitsi merkittävää virstanpylvästä 4.x-sarjan ensimmäisenä julkaisuna, ilmentäen elävän avoimen lähdekoodin yhteisön yhteistä ponnistusta. Fabric Runtime 2.0 toimii nyt Apache Spark 4.1 -pohjalla, joka rakentaa tätä pohjaa lisäparannuksilla.
Tässä versiossa Spark SQL on merkittävästi rikastettu tehokkailla uusilla ominaisuuksilla, jotka on suunniteltu lisäämään SQL-työkuormien ilmaisukykyä ja monipuolisuutta, kuten VARIANT-tietotyyppien tuki, SQL-käyttäjän määrittelemät funktiot, istuntomuuttujat, putkisyntaksi ja merkkijonojen kokoaminen. PySpark sitoutuu jatkuvasti sekä toiminnalliseen laajuuteen että kehittäjäkokemukseen, tuoden mukanaan natiivin piirto-API:n, uuden Python Data Source API:n, tuen Python UDTF:ille ja yhtenäisen profiloinnin PySpark UDF:ille sekä lukuisia muita parannuksia. Strukturoitu suoratoisto kehittyy tärkeiden lisäysten myötä, jotka tarjoavat paremman hallinnan ja helpomman virheenkorjauksen, erityisesti Arbitrary State API v2:n käyttöönoton myötä joustavampaan tilanhallintaan sekä State Data Sourcen myötä helpompaan virheenkorjaukseen.
Voit tarkistaa koko listan ja yksityiskohtaiset muutokset täältä:
Note
Spark 4.x:ssä SparkR on vanhentunut ja se voidaan poistaa tulevassa versiossa.
Delta Lake 4.2
Delta Lake 4.2 rakentuu aiempien Delta Lake -julkaisujen pohjalle jatkaen sitoutumista tehdä Delta Lakesta yhteensopiva eri formaateissa, helpommin käsiteltävä ja suorituskykyisempi. Se sisältää tehokkaita uusia ominaisuuksia, suorituskyvyn optimointeja ja perustavanlaatuisia parannuksia avoimen datan järvenrakennusten tulevaisuudelle.
Koko lista ja yksityiskohtaiset muutokset, jotka on tehty Delta Lake 3.3:n, 4.0:n, 4.1:n ja 4.2:n myötä, katso:
Datan asettelu ja optimointi
Runtime 2.0 tukee datan asettelun ja optimointiominaisuuksia Delta-tauluille:
- Z-järjestys: Järjestä Delta-taulutiedostojen tiedot määriteltyjen sarakkeiden mukaan parantaaksesi suodatettujen kyselyiden suorituskykyä.
- Liquid Clustering: Joustava klusterointimenetelmä, joka optimoi datan asettelun automaattisesti ilman manuaalista ylläpitoa.
- Rinnakkainen Delta-snapshotin lataus: Natiivisuoritusmoottori lataa Delta-taulukon snapshotit rinnakkain, mikä lyhentää kyselyjen käynnistysaikaa suurille tauluille.
Tärkeää
Delta Lake 4.2:n erityisominaisuudet ovat kokeellisia ja toimivat vain Spark-kokemuksissa, kuten muistikirjoissa ja Spark-tehtävien määrittelyissä. Jos sinun täytyy käyttää samoja Delta Lake -taulukoita useissa Microsoft Fabricin työkuormissa, älä ota näitä ominaisuuksia käyttöön. Lisätietoja siitä, mitkä protokollaversiot ja ominaisuudet ovat yhteensopivia kaikissa Microsoft Fabric -kokemuksissa, löydät Delta Lake Table Format Interoperability.
Laskennan hallinta Runtime 2.0:ssa
Runtime 2.0 tukee seuraavia laskentahallinnan ominaisuuksia:
- Resurssiprofiilit: Määritä ennalta määritellyt resurssiallokaatiot Spark-istunnoille vastaamaan työkuormavaatimuksia ja hallitsemaan kustannuksia.
- Mukautetut live-poolit (esikatselu): Luo omistetut, esilämmitetyt Spark-poolit, jotka lyhentävät istuntojen käynnistysaikaa. Mukautetut live-poolit ovat saatavilla esikatselussa Runtime 2.0 -työkuormille.
Rajoitukset ja huomautukset
- Delta Lake 4.x -ominaispiirteet ovat kokeellisia ja toimivat vain Spark-kokemuksissa, kuten muistikirjoissa ja Spark-tehtävämääritteyksissä. Jos sinun täytyy käyttää samoja Delta Lake -tauluja useissa Fabric-työkuormissa, älä ota näitä ominaisuuksia käyttöön. Lisätietoja löytyy Delta Lake -taulukkomuotojen yhteentoimivuudesta.
- Fabric Sparkin VS Code -laajennus tukee Runtime 2.0:aa kannettavan ja Sparkin työnmäärittelyn kehitykseen.
Liittyvä sisältö
- Siirry Runtime 1.3:sta Runtime 2.0:aan
- Apache Spark Runtimet Fabricissa – yleiskatsaus, versiointi ja useiden ajonaikaisten tuki
- Spark Core -siirto-opas
- SQL:n, tietojoukkojen ja DataFrame-siirto-oppaan
- Jäsennetty virtauttamisopas
- MLlib (koneoppimisen) siirto-opas
- PySpark (Python on Spark) -siirto-opas
- SparkR (R on Spark) -siirto-opas