Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Les types d’informations sensibles (SIT) sont utilisés pour identifier les données sensibles afin que vous puissiez empêcher qu’elles soient partagées par inadvertance ou de manière inappropriée. Ils sont également utilisés pour vous aider à localiser les données pertinentes dans eDiscovery et pour appliquer des actions de gouvernance à certains types d’informations. Vous définissez un SIT personnalisé en fonction des éléments suivants :
- modèles
- preuve de mot clé tel qu’employé, numéro de sécurité sociale ou ID
- caractère à proximité de la preuve dans un modèle particulier
- niveaux de confiance
Mais qu’en est-il si vous souhaitez un SIT personnalisé qui utilise des valeurs de données exactes ou presque exactes, au lieu d’un SIT qui trouve des correspondances basées sur des modèles génériques ? Avec la classification basée sur la correspondance exacte des données (EDM), vous pouvez créer un type d’informations sensibles personnalisé conçu pour :
- être dynamique et actualisé facilement ;
- entraînent moins de faux positifs
- utiliser des données sensibles structurées ;
- gérer les informations sensibles en toute sécurité, sans les partager avec qui que ce soit, y compris Microsoft
- être utilisé avec différents services de cloud computing Microsoft.
La classification basée sur la GED vous permet de créer des SIT personnalisés qui font référence à des valeurs exactes dans une base de données d’informations sensibles. La base de données peut être actualisée quotidiennement et peut contenir jusqu’à 100 millions de lignes de données. Ainsi, à mesure que les employés, les patients et les clients vont et viennent, et que les enregistrements changent, vos types d’informations sensibles personnalisées restent à jour et applicables. Vous pouvez également utiliser la classification basée sur la GED avec des stratégies, telles que les stratégies Protection contre la perte de données Microsoft Purview ou les stratégies de fichiers Sécurité des applications infonuagiques Microsoft.
Le schéma suivant montre le fonctionnement fondamental de la classification EDM :
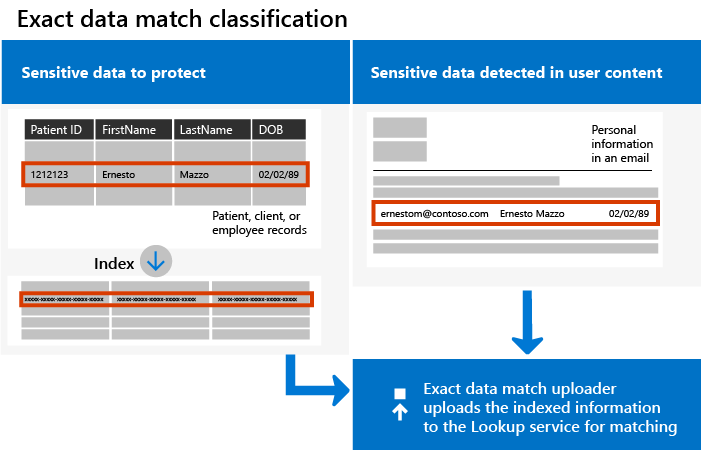
Remarque
La Protection des données Microsoft Purview prend en charge les langues suivantes qui utilisent des jeux de caractères codés sur deux octets :
- Chinois (simplifié)
- Chinois (traditionnel)
- Korean
- Japanese
Cette prise en charge est disponible pour les types d’informations sensibles. Pour plus d’informations, consultez Support pour la protection des informations relatif aux jeux de caractères codés sur deux octets : Notes de publication (préversion).
Ce qui est différent dans un SIT EDM
Lorsque vous travaillez avec des SIT EDM, il est utile de comprendre quelques concepts qui leur sont propres.
Schéma
Un schéma est un fichier XML. Microsoft Purview utilise le schéma pour déterminer si vos données contiennent ou non des chaînes qui correspondent à celles que vos types d’informations sensibles sont conçus pour détecter.
Le fichier XML de schéma définit :
- Nom du schéma, appelé plus tard le magasin de données.
- Noms des champs que contient votre table source d’informations sensibles. Il existe un mappage 1:1 des noms des champs de schéma avec les noms des colonnes dans la table source d’informations sensibles.
- Les champs de preuves corroborantes qui nécessitent un mode de correspondance multi-jetons.
- Les champs de données pouvant faire l’objet d’une recherche.
- Indique si les correspondances configurables sont prises en charge pour chaque champ. Une correspondance configurable est une correspondance dont les paramètres modifient une recherche, tels que l’ignorance des délimiteurs et de la casse dans les valeurs recherchées.
Table source d’informations sensibles
La table source d’informations sensibles contient les valeurs que le SIT EDM recherche. Le tableau est composé de colonnes et de lignes. Les en-têtes de colonne sont les noms de champs, les lignes sont des instances d’éléments et chaque cellule d’une ligne contient les valeurs de cette instance d’élément pour ce champ.
Voici un exemple simple de table source d’informations sensibles.
| Prénom | Nom | Date of Birth |
|---|---|---|
| Ésaïe | Langer | 05-05-1960 |
| Ana | Bowman | 11-24-1971 |
| Oscar | Ward | 02-12-1998 |
Package de règles
Chaque type d’informations sensibles possède un ensemble de règles. Vous utilisez le package de règles d’un SIT EDM pour définir les différents composants de votre SIT EDM. Le tableau suivant fournit une description de chaque composant.
| Composant | Description |
|---|---|
| Match | Spécifie l’élément principal (champ de données) à utiliser dans la recherche exacte. Il peut s’agir d’une expression régulière avec ou sans validation de somme de contrôle, d’une liste de mots clés, d’un dictionnaire de mots clés ou d’une fonction. |
| Classification | Spécifie la correspondance de type d’informations sensibles qui déclenche une recherche EDM. |
| Éléments de prise en charge | Éléments qui, lorsqu’ils sont trouvés, fournissent des preuves qui aident à augmenter la confiance de la correspondance. Par exemple, l’occurrence d’un nom de famille à proximité d’un numéro de sécurité sociale réel. Un élément de prise en charge peut être une expression régulière avec ou sans validation de somme de contrôle, une liste de mots clés, un dictionnaire de mots clés ou une correspondance de chaîne à jeton unique ou multiple. |
| Niveau de confiance (Élevé, Moyen, Faible) |
Indication de la quantité de preuves à l’appui détectées en plus de l’élément principal. Plus un élément contient de preuves à l’appui, plus le degré de confiance dans le fait qu’un élément correspondant contient les informations sensibles que vous recherchez est fiable. Pour plus d’informations sur les niveaux de confiance, voir Parties fondamentales d’un type d’informations sensibles. |
| Proximité | Nombre de caractères entre l’élément principal et l’élément de support. |
Vous fournissez votre propre schéma et vos propres données
Microsoft Purview est fourni avec de nombreuses SIT prédéfinies . Ces SIT sont fournis avec des schémas, des modèles REGEX, des mots clés et des niveaux de confiance. Toutefois, avec les SIT EDM, vous êtes responsable de la définition du schéma, ainsi que des champs principal et secondaire qui identifient les éléments sensibles. Étant donné que le schéma et les valeurs de données primaires et secondaires sont tous très sensibles, vous les chiffrez via une fonction de hachage qui inclut une valeur de sel générée de manière aléatoire ou auto-fournie. Seules les valeurs hachées sont téléchargées dans le service, de sorte que vos données sensibles ne sont jamais ouvertes.
Éléments de soutien primaires et secondaires
Lorsque vous créez un SIT EDM, vous définissez un champ d’élément primaire dans le package de règles. L’EDM recherche ensuite tout votre contenu pour l’élément principal. Pour que l’EDM puisse les détecter, les éléments primaires doivent pouvoir être découverts via un SIT existant.
Remarque
Pour obtenir la liste complète des SIT disponibles, consultez Définitions d’entité de type d’informations sensibles
Vous devez trouver un SIT intégré qui détecte les informations sensibles que vous souhaitez que votre SIT EDM détecte. Par exemple, si votre schéma EDM SIT a le numéro de sécurité sociale américain comme élément principal, lorsque vous créez votre schéma EDM, vous l’associez au SIT de numéro de sécurité sociale américain (SSN). Les éléments primaires doivent suivre un modèle défini pour être détectés.
Lorsque l’élément principal est trouvé dans un élément scanné, EDM recherche ensuite des éléments secondaires (également appelés éléments de support ). Contrairement aux éléments primaires, les éléments secondaires ont la possibilité de suivre un modèle. Si les éléments secondaires contiennent plusieurs jetons, ces éléments doivent être associés à un SIT qui peut détecter ce contenu ou qui peut être configuré pour la correspondance multi-jetons. Dans tous les cas, les éléments secondaires doivent se trouver à une certaine proximité de l’élément primaire pour qu’une correspondance puisse être détectée.
Comment fonctionne la correspondance
La GED fonctionne en comparant les chaînes de vos documents et courriels avec les valeurs de la table source d’informations sensibles. Il utilise cette comparaison pour déterminer si les valeurs du contenu analysé sont présentes dans la table. La détermination s’effectue en comparant les hachages cryptographiques unidirectionnels.
Conseil
Vous pouvez utiliser les SIT GED et les SIT prédéfinis sur lesquels ils sont basés dans les règles DLP pour améliorer la détection des données sensibles. Utilisez le SIT EDM avec des niveaux de confiance plus élevés et le SIT prédéfini avec des niveaux de confiance plus faibles. Par exemple, utilisez un SIT GED qui recherche le numéro de sécurité sociale et d’autres données justificatives avec des exigences strictes avec un niveau de confiance élevé. S’il est configuré pour des correspondances à haut niveau de fiabilité, EDM génère une correspondance DLP lorsque seules quelques instances sont détectées. Pour déclencher une correspondance DLP lorsque un plus grand nombre d’occurrences est détecté, utilisez un SIT intégré, tel que le numéro de sécurité sociale américain.
Fonctionnement des éléments de support avec la GED
Comme nous l’avons vu dans Qu’est-ce qui est différent dans un SIT EDM, les éléments de soutien sont des éléments qui, lorsqu’ils sont trouvés, fournissent des preuves qui aident à augmenter la confiance de la correspondance.
Avec la prise en charge des SIT EDM, vous pouvez rechercher et détecter des éléments de prise en charge composés de plusieurs champs. Les correspondances d’éléments de prise en charge peuvent consister en des listes de mots clés, des dictionnaires de mots clés, des chaînes alphanumériques uniques ou des chaînes multi-jetons.
Prenons un exemple. Supposons que vous souhaitez détecter des numéros de sécurité sociale américains. Pour augmenter la confiance de correspondance, vos éléments de soutien incluent first name, last nameet date of birth (DoB). Votre table source ressemble donc à ceci :
| Numéro de sécurité sociale (SSN) | FirstName | LastName | Date de naissance |
|---|---|---|---|
| 987-65-4320 | Ésaïe | Langer | 05-05-1960 |
| 078-05-1120 | Ana | Bowman | 11-24-1971 |
| 219-09-9999 | Oscar | Ward | 02-12-1998 |
Lors de la recherche d’éléments de support correspondants dans un fichier protégé, votre SIT EDM vérifie chaque élément de support (individuellement et en combinaison) une fois l’élément principal détecté.
Par exemple, disons que le premier numéro de sécurité sociale est détecté. La fonctionnalité de correspondance de données exactes recherche ensuite des combinaisons d’éléments de prise en charge dans toutes les colonnes de votre table source :
- Ésaïe
- Langer
- 05-05-1960
- Isaiah Langer
- Ésaïe 05-05-1960
- Langer 05-05-1960
- Isaiah Langer 05-05-1960
Correspondance de plusieurs jetons
La correspondance multi-tokens est conçue pour être utilisée lorsque votre champ de preuves corroboratives contient des valeurs multi-tokens, mais qu’il n’est pas facile de faire correspondre ces valeurs à un SIT. Par exemple, lorsque vous avez un champ contenant des Address valeurs telles que 1 Microsoft Way, Redmond, WA ou 123 Main Street, New York, NY.
Cette fonctionnalité permet à EDM de comparer les hachages de mots consécutifs dans le contenu avec les hachages des champs à plusieurs jetons de votre source de données. S’ils sont identiques, l’EDM produit une correspondance. De cette façon, EDM peut détecter les champs multi-tokens tels que les noms, les adresses, les conditions médicales ou tout autre champ de preuves corroborantes pouvant contenir plusieurs mots, tant qu’ils sont marqués comme multi-tokens dans votre schéma EDM.
Par exemple, si vous sélectionnez la correspondance multi-jetons comme option de correspondance, vous obtenez deux avantages supplémentaires :
- Vos stratégies détecteront le contenu qui correspond à plusieurs champs dans les colonnes de votre table source.
- Votre table source peut inclure des champs avec des valeurs de chaîne qui se composent d’un nombre préconfiguré de mots. Le tableau suivant présente un exemple de table source :
| Numéro de sécurité sociale (SSN) | Nom | Rue |
|---|---|---|
| 987-65-4320 | Isaiah Langer | 1432 Lincoln Road |
| 078-05-1120 | Ana Bowman | 8250 First Street |
| 219-09-9999 | Oscar Ward | 424 205th Avenue |
Avec la correspondance multi-jetons, les champs Nom et Adresse postale sont mis en correspondance à la fois en tant que chaînes d’éléments de prise en charge indépendantes et en tant que champs individuels. Ainsi, lorsqu’elles sont mises en correspondance en tant que chaînes multi-jetons en tant qu’éléments de prise en charge pour le numéro de sécurité sociale 987-65-4320, les correspondances sont les suivantes :
- Isaiah Langer
- 1432 Lincoln Road
Lorsqu’il est mis en correspondance, le résultat est le suivant :
- Isaiah Langer + 1432 Lincoln Road
La correspondance de plusieurs jetons est également prise en charge pour les jeux de caractères codés sur deux octets, qui n’utilisent généralement pas d’espaces pour séparer les mots.
Services pris en charge par GED
| Service | Emplacements |
|---|---|
| Protection contre la perte de données Microsoft Purview | - SharePoint - OneDrive - Conversation Teams - Exchange Online - Appareils |
| Microsoft Defender for Cloud Apps | - SharePoint - OneDrive |
| Étiquetage automatique (côté service) | - SharePoint - OneDrive - Exchange Online |
| Étiquetage automatique (côté client) | - Word - Excel - PowerPoint - Clients de bureau Exchange |
| Clé gérée par le client | - SharePoint - OneDrive - Teams Chat - Exchange Online - Word - Excel - PowerPoint - Clients de bureau Exchange - Appareils |
| eDiscovery | - SharePoint - OneDrive - Teams Chat - Exchange Online - Word - Excel - PowerPoint - Clients de bureau Exchange |
| Gestion des risques internes | - SharePoint - OneDrive - Teams Chat - Exchange Online - Word - Excel - PowerPoint - Clients de bureau Exchange |