Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur d’espace de travail doit activer Project-Scoped Shared Compute depuis la page des Aperçus. Consultez Gérer les préversions d’Azure Databricks.
Avec Shared Serverless, les notebooks et fichiers dans le même dossier Git ou bundle partagent le calcul serverless et un environnement Python dans l’éditeur. Pour personnaliser l’environnement, ajoutez un fichier pyproject.toml à la racine du dossier. Pour joindre un notebook ou un fichier, suivez les étapes des dossiers Git ou des Declarative Automation Bundles.
Requirements
- Votre espace de travail doit répondre aux exigences de calcul sans serveur.
- Ouvrez votre dossier Git ou votre bundle dans l’éditeur de dossiers Git ou l’éditeur de bundles. Consultez Créer et gérer des dossiers Git et Créer des bundles dans l’espace de travail.
- Shared Serverless nécessite un environnement serverless version 5 ou supérieure.
Calcul partagé et environnement
- Les notebooks et fichiers dans le même dossier Git ou bundle partagent le calcul et un environnement Python dans l’éditeur. Un fichier optionnel
pyproject.tomlà la racine du dossier définit l’environnement partagé. - Seuls les notebooks et les fichiers situés dans le dossier Git ou le bundle associé peuvent se connecter à sa ressource de calcul partagée.
- Les ressources de calcul partagées sont isolées par utilisateur. Seul l’utilisateur qui est le premier à associer un notebook ou un fichier à une ressource de calcul partagée peut exécuter des charges de travail dessus.
- L’exécution sur le notebook reste isolée. Les variables Python définies dans un carnet ne sont pas disponibles dans un autre carnet.
- Un terminal web ouvert depuis un carnet ou un fichier attaché s’exécute sur la même ressource de calcul.
Utilisez Shared Serverless dans les dossiers Git
Utilisez Shared Serverless pour travailler avec des notebooks et des fichiers dans un dossier Git.
Connecter des notebooks et des fichiers dans l’éditeur de dossiers Git
Dans la barre latérale de l’espace de travail, cliquez sur Espace de travail et allez dans le dossier Git.
Cliquez sur Ouvrir dans l’éditeur.
Ouvrez un carnet ou un fichier dans le dossier Git.
Cliquez sur le menu déroulant Compute.
Sélectionnez Shared Serverless.
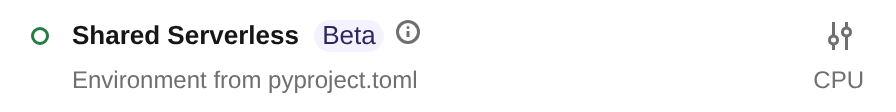
Exécutez le carnet ou le fichier pour lancer la ressource de calcul.
Pour utiliser le même calcul depuis un autre notebook ou fichier, ouvrez-le dans le même dossier Git et sélectionnez Shared Serverless.
Collaborer avec Git
Databricks recommande que chaque collaborateur clone le dépôt dans un dossier Git dans son dossier personnel de travail. Chaque collaborateur obtient alors une ressource de calcul et un environnement distincts pour son clone.
Utilisez des branches, des commits, des pushes et des pulls pour échanger des modifications via le dépôt Git distant. Voir Collaborer dans les dossiers Git.
Utilisez Shared Serverless en bundles
Utilisez Shared Serverless pour travailler avec des notebooks et des fichiers dans un bundle dans l’espace de travail. La racine du package contient databricks.yml et peut contenir un fichier pyproject.toml qui définit l’environnement partagé.
Attachez les notebooks et fichiers dans l’éditeur de bundles
- Dans la barre latérale de l’espace de travail, cliquez sur Espace de travail, puis accédez au bundle.
- À droite du nom du bundle, cliquez sur Ouvrir dans l’éditeur.
- Ouvrez un notebook ou un fichier dans le bundle.
- Cliquez sur le menu déroulant Compute.
- Sélectionnez Shared Serverless.
- Exécutez le carnet ou le fichier pour lancer la ressource de calcul.
Pour utiliser le même calcul depuis un autre notebook ou fichier, ouvrez-le dans le même bundle et sélectionnez Shared Serverless.
Pour collaborer via Git, faites en sorte que chaque collaborateur clone le dépôt dans un dossier Git dans son dossier d’espace de travail personnel. Consultez Collaborer via Git.
Gérer l’environnement avec pyproject.toml
Le calcul serverless partagé utilise le fichier pyproject.toml situé à la racine du dossier Git ou du bundle pour gérer les dépendances Python du projet. Les notebooks serverless standard utilisent des dépendances configurées pour chaque notebook dans le volet latéral « Environnement ».
Créez le fichier racine pyproject.toml et définissez la version de son environnement serverless avant de gérer ses dépendances. Consultez Créer et modifier pyproject.toml. Vous pouvez alors ajouter des dépendances avec des commandes notebook ou modifier directement le fichier.
Utiliser les commandes du carnet
Ouvrez un notebook associé à Shared Serverless.
Exécutez
%uv add <package>pour ajouter une dépendance au fichier racinepyproject.toml. Par exemple:%uv add cowsay
La commande met à jour pyproject.toml, uv.lock, et l’environnement partagé. Vous n’avez pas besoin d’exécuter %uv sync après %uv add. Utilisez %uv sync pour appliquer les modifications apportées directement à pyproject.toml.
Créer et modifier pyproject.toml
Ouvrez un carnet associé à Shared Serverless.
Ouvre le volet latéral Environnement.
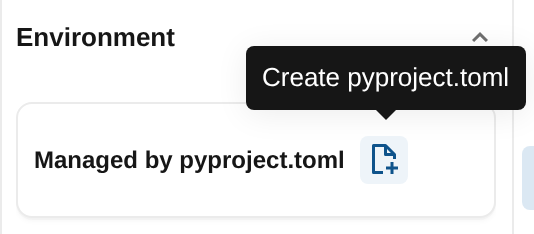
Dans la carte Géré par pyproject.toml, cliquez sur
 Créer pyproject.toml pour créer le fichier racine. Si le fichier existe déjà, cliquez sur
 Voir pyproject.toml. Le fichier s’ouvre dans l’éditeur.
Modifiez la liste
dependencies. Gardez la section générée[tool.databricks.environment], ou ajoutez-la si elle manque. Réglezenvironment_versionsur une version prise en charge (5 et plus). Par exemple:[project] name = "my-project" version = "0.1.0" dependencies = [ "simplejson==3.18.1", ] [tool.databricks.environment] environment_version = "5"Cliquez sur Appliquer en haut de l’éditeur
pyproject.tomlde fichiers.
L’environnement mis à jour est disponible pour les carnets et fichiers attachés à la même ressource de calcul partagée. Pour inspecter l’environnement, ouvrez la vitre latérale de l’Environnement . Voir Configurer l’environnement serverless pour des informations sur les versions et dépendances installées de l’environnement serverless.
Planifier l’exécution d’un notebook
Lorsque vous planifiez l’exécution d’un notebook connecté à Shared Serverless depuis l’éditeur de dossiers Git ou de bundles, Azure Databricks utilise le fichier pyproject.toml racine comme environnement de projet de la tâche, s’il existe. Déploie le paquet comme décrit dans les étapes suivantes.
- Dans le dossier Git ou l’éditeur de bundles, ouvrez un notebook attaché à Shared Serverless.
- Si le dossier Git ou le bundle possède un fichier racine
pyproject.toml, vérifiez qu’il déclare les dépendances nécessaires à la tâche. - Cliquez sur Planifier.
- Dans la liste déroulante Calcul, sélectionnez le calcul serverless.
- Configurez la planification, puis cliquez sur Créer.
Après avoir cliqué sur Créer, vérifiez la configuration de la tâche :
Dossier Git : si le dossier Git contient un fichier
pyproject.tomlracine, vérifiez que Environnement du projet dans la configuration de la tâche pointe vers ce fichier. Pour modifier la sélection, voir Configurer l’environnement pour les tâches de travail.Bundle : L’éditeur de bundle ouvre un fichier YAML de travail généré dans le dossier
resources/.- Si le bundle contient un fichier
pyproject.tomlracine, vérifiez queproject_environmentsousspecde l’environnement pointe vers ce fichier, en utilisant un chemin relatif au fichier YAML généré. Voir Configurer un environnement de projet dans un bundle. - Déployez le bundle pour créer la tâche.
Les plannings sont mis en pause par défaut en mode développement. ** Consultez les modes de déploiement des ensembles d'automatisation déclarative.
- Si le bundle contient un fichier
Pour les options de planification des notebooks, voir Créer et gérer les tâches de notebooks planifiées.
Limitations
- Le partage des ressources de calcul est limité à une politique d’utilisation sans serveur. Les notebooks et fichiers dans le même dossier Git ou bundle qui utilisent des politiques d’utilisation différentes se voient attribuer des ressources de calcul distinctes au lieu d’en partager une.