Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
La formation programmée nécessite une approbation d’accès explicite. Demandez l’accès via le formulaire d’inscription en préversion et attendez l’approbation avant de créer une session d’entraînement.
Utilisez cette aide-mémoire pour mapper votre boucle d'entraînement aux fonctions et paramètres du KIT de développement logiciel (SDK) Python dans Microsoft Foundry. Les exemples se concentrent sur l’API pratique synchrone FineTuningSession . Les clients asynchrones et les wrappers de livre de recette utilisent différentes interfaces et modèles d’achèvement.
Prerequisites
- Terminer l’installation, l’authentification et la configuration de l’accès.
- Utilisez
azure-ai-finetuningsessions==1.0.0b1la préversion publique installée par le livre de recettes. - Rôle Utilisateur Foundry pour la formation, ou le rôle Propriétaire de Foundry si vous déployez également le modèle affiné. Consultez le contrôle d’accès en fonction du rôle pour Microsoft Foundry.
- Sélectionnez un modèle éligible et une configuration d’adaptateur prise en charge. Préparez des jetons avec son modèle de jetons et de conversation correspondants.
- Définissez et confirmez
AZURE_AI_PROJECT_ENDPOINTun budget de formation approuvé. La création d’une session et l’exécution d’opérations d’entraînement ou d’échantillonnage peuvent entraîner des frais.
Les méthodes pratiques d’entraînement, d’échantillonnage et de point de contrôle attendent les résultats de l’opération. Les opérations brutes et les helpers asynchrones ont différents types de retour et comportement d’achèvement ; utilisez la référence complète du Kit de développement logiciel (SDK) pour ces interfaces.
Les exemples utilisent le Kit de développement logiciel (SDK) synchrone, sauf indication contraire. Préparez les fonctions d’assistance une seule fois, puis exécutez des opérations à l’intérieur with open_session() as session:. Utiliser des données tokenisées réelles ; les extraits de code ne fournissent pas de jeu de données ni implémentent un algorithme d’apprentissage complet.
Mise au point supervisée
Le réglage précis supervisé (SFT) s’entraîne sur les invites et les réponses souhaitées.
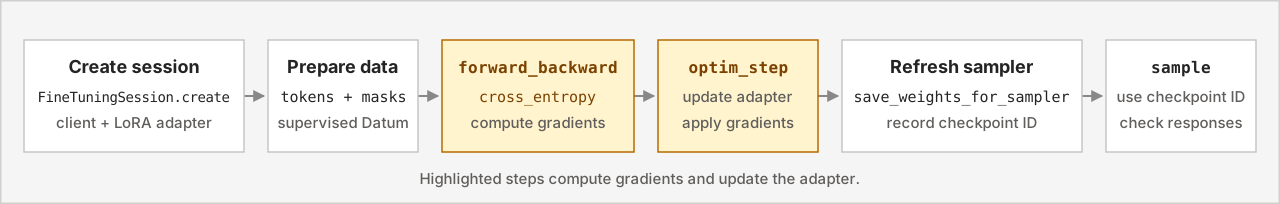
La séquence est la création > d’une étape de préparation des données > supervisées vers l’avant/vers l’arrière-plan >> d’évaluation > du point de contrôle. L’échantillonnage n’est pas nécessaire pour chaque lot supervisé.
Apprentissage par renforcement
L’apprentissage par renforcement (RL) s’entraîne à partir des réponses de modèle notées.

La séquence est la création > d’un échantillonneur > d’actualisation qui collecte les récompenses > de calcul et les > avantages de l’étape de l’optimiseur avant/arrière>. Répétez l’actualisation de l’échantillonneur pour collecter des réponses à partir de la stratégie mise à jour.
Les calculs de regroupement, de notation et d’avantage appartiennent à votre pilote, et non à un algorithme d’apprentissage automatique du SDK. Pour obtenir des exemples d’apprentissage complets, explorez le référentiel d’exemples de réglage précis.
Créer une session
FineTuningSessionClient se connecte à votre projet à l’aide d’un endpoint et credential.
FineTuningSession.create initialise un modèle et un adaptateur et démarre la pulsation de session.
Cet assistance s’authentifie avec DefaultAzureCredential, crée une session et la décharge quand son contexte se termine. Utilisez votre modèle approuvé et le classement LoRA. L’étendue des informations d’identification explicites concerne l’authentification Microsoft Entra.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Référence : FineTuningSession.create, FineTuningSessionClient et DefaultAzureCredential.
Attendez-vous à un identificateur de session une fois le chargement du modèle terminé. Laissez la session ouverte pour les opérations ci-dessous ; la fermeture de son contexte arrête la pulsation et envoie une demande de déchargement.
| Parameter | Meaning |
|---|---|
base_model |
Identificateur de modèle d’entraînement pris en charge exactement. |
lora_config |
Explicite LoRAConfig avec un objet pris en charge rank. |
type |
Type de session ; utiliser training. L’échantillonnage se produit par le biais de la session d’entraînement, et non d’un type de session d’inférence distinct. |
timeout_sec |
Durée maximale d’attente du chargement du modèle. Un délai d’expiration ne confirme pas le nettoyage à distance. |
from_checkpoint |
Facultatif FromCheckpoint avec la source source_session_id et checkpoint_id. Utilisez l’état d’entraînement enregistré compatible. |
user_metadata |
Dictionnaire facultatif des métadonnées d’exécution à associer à la session. |
training_type |
Sélecteur de niveau facultatif ; les valeurs connues sont GlobalStandard, DatazoneStandardet DeveloperTier. L’éligibilité dépend toujours du modèle et du projet. |
Enregistrez session.session_id lorsque vous utilisez directement le Kit de développement logiciel (SDK). Pour exécuter une recette de formation de bout en bout, consultez Prise en main.
Préparer les données supervisées
Datum groupes model_input et loss_fn_inputs pour un exemple.
| Type ou champ | Meaning |
|---|---|
ModelInput |
Segments d’entrée de modèle ordonnés. |
ModelInputChunk.tokens |
ID de jeton de texte du générateur de jetons du modèle. |
LossFnInputs.target_tokens |
Les cibles de jeton suivant sont alignées avec les positions d’entrée. |
LossFnInputs.weights |
Pondérations explicites par jeton ; zéro exclut une cible de l’entraînement inter-entropie. |
TensorData.data |
Cibles entières ou signaux d’apprentissage à virgule flottante. |
Déplacez les entrées et les cibles d’un jeton et alignez les pondérations avec les cibles. Effectuez l’apprentissage sur les jetons d’assistant prévus, et non sur les invites ou les observations. Consultez les fonctions de perte et les pondérations de jeton.
Passez des jetons d’invite et de saisie semi-automatique à partir du même renderer de conversation spécifique au modèle à cet assistance. Il crée un exemple SFT à tour unique et des cibles d’invite de masques.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Référence : Datum, LossFnInputs et ModelInput.
Générez batch en tant que liste de ces Datum valeurs. Les tableaux d’entrée, de cible et de poids ont la même longueur. Pour les données à plusieurs tour, conservez les masques du renderer plutôt que de traiter chaque jeton après la première invite comme jeton d’assistant.
Préparer les données de liste de révocation de certificats
Pour la liste de révocation de certificats, utilisez des réponses échantillonnées et des signaux d’apprentissage dérivés de récompense :
| Champ | Meaning |
|---|---|
SampledSequence.tokens |
ID de jeton généré. |
SampledSequence.logprobs |
Probabilités du journal des jetons de la stratégie qui a généré la réponse, lorsqu’elle est fournie. |
LossFnInputs.logprobs |
Probabilités du journal de déploiement alignées sur les cibles d’entraînement. |
LossFnInputs.advantages |
Avantages par jeton ; zéro exclut les positions d’invite et d’observation du signal RL. |
Conservez l’alignement entre les cibles, les probabilités de journal et les avantages. Ne remplacez pas les probabilités de déploiement par celles d’un modèle nouvellement mis à jour. le constructeur de LossFnInputs Python nécessite également une spécification explicite weights; Le masquage de la liste de révocation de certificats utilise les avantages.
Pour un déploiement à un seul tour, transmettez un échantillon et sequence un advantage modèle calculé par votre pilote. Cet assistance met zéro avantage et journalise les probabilités à des positions cibles à l’invite.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Référence : SampledSequence et LossFnInputs.
Pour les appels d’outils ou les déploiements à plusieurs tour, utilisez le convertisseur de la recette pour distinguer les jetons d’action échantillonné des observations d’environnement.
Dégradés de calcul
session.forward_backward(batch, loss_fn=...) calcule l’objectif et accumule les dégradés. Il ne met pas à jour les pondérations de l’adaptateur.
batch contient des Datum valeurs.
loss_fn
cross_entropysélectionne , , importance_samplingppo, cispoou sapo. Facultatif loss_fn_config utilise le modèle du LossFnConfig Kit de développement logiciel (SDK) ; n’déduitz pas les clés de configuration acceptées à partir d’un document d’algorithme.
Effectuer le calcul de dégradé avant sa mise à jour de l’optimiseur. Conservez la cohérence de la réduction des pertes lors de l’accumulation de plusieurs appels.
Avec un SFT batchactif session et sansmpty, calculez des dégradés et inspectez les sorties par exemple :
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Référence : FineTuningSession.forward_backward et LossFn.
Pour un lot de listes de révocation de certificats préparé, utilisez LossFn.IMPORTANCE_SAMPLING ou une autre perte de stratégie prise en charge.
LossFn les membres enum et leurs valeurs de chaîne sélectionnent la même perte.
Appliquer une étape d’optimiseur
session.optim_step(adam_params) applique des dégradés cumulés.
AdamParams Python nécessite les cinq champs suivants :
| Champ | Meaning |
|---|---|
learning_rate |
Taille de mise à jour de l’optimiseur. |
beta1 |
Facteur de désintégration du premier moment. |
beta2 |
Deuxième moment, facteur de décroissance. |
eps |
Terme de stabilité numérique. |
weight_decay |
Paramètre de dégradation du poids. |
Choisissez des valeurs pour votre expérience plutôt que d’assumer les valeurs par défaut universelles.
Cet assistance fournit chaque champ requis et attend la mise à jour. Les valeurs sont des exemples de paramètres, et non des recommandations indépendantes du modèle.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Référence : FineTuningSession.optim_step et AdamParams.
Recompilez learning_rate lorsque votre pilote utilise une planification ; ne supposez pas qu’une configuration d’optimiseur s’applique tout au long de l’exécution.
Exemple de texte
session.save_weights_for_sampler(seq_id, ...) prépare les pondérations et retourne un identificateur de point de contrôle sampler. Actualisez les pondérations de l’échantillonneur après les mises à jour avant de générer à partir de l’adaptateur mis à jour.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) génère des réponses à partir des pondérations de l’échantillonneur sélectionné.
| Paramètre ou résultat | Meaning |
|---|---|
prompt_tokens |
Invite par jetons ou prise en charge ModelInput. |
checkpoint_id |
Identificateur de point de contrôle sampler terminé pour cette session, et non pas un chemin de point de contrôle ou un nom de déploiement. |
num_samples |
Nombre de réponses pour l’invite. |
SamplingParams.max_tokens |
Budget de jeton d’achèvement. |
temperature, top_p, top_k |
Paramètres de distribution d’échantillonnage. |
stop_criteria |
Liste de chaînes d’arrêt ou liste d’ID de jeton, pas les deux. |
response_format |
Demande de format réponse facultative ; la prise en charge dépend du modèle et du fournisseur d’échantillonnage. |
result.sequences |
Valeurs générées SampledSequence . |
SamplingParams Python nécessite max_tokens, temperaturetop_p, et top_k. Définissez la même seq_id valeur pour l’actualisation et l’échantillonnage de l’échantillonneur. Fournissez l’un ou sampling_session_seq_id l’autre path des poids échantillonneurs.
Après une mise à jour de l’optimiseur, actualisez l’échantillonneur et générez une réponse. Utilisez les jetons prompt_tokens et la correspondance tokenizer du modèle à partir de votre pilote.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Référence : FineTuningSession.save_weights_for_sampler, FineTuningSession.sample et SamplingParams.
Le résultat contient une séquence échantillonné. Incrémentez l’identificateur d’étape avec vos mises à jour et actualisez les pondérations de l’échantillonneur avant d’échantillonner la stratégie mise à jour.
La préparation des pondérations de l’échantillonneur n’est pas la même que l’enregistrement de l’état d’entraînement pouvant être repris.
Conserver ou actualiser les pondérations de l’échantillonneur
La méthode synchrone utilise sampling_session_seq_id pour distinguer une actualisation en mémoire d’un point de contrôle d’échantillonneur persistant.
| Purpose | Appel synchrone |
|---|---|
| Actualiser les pondérations de l’échantillonneur sans persistance | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Conserver un point de contrôle sampler |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), sans sampling_session_seq_id. |
Les deux appels retournent un identificateur de point de contrôle sampler. Conservez-la avec son ID de session propriétaire. Un enregistrement d’échantillonneur durable n’établit pas de rétention indéfinie ni ne rend le point de contrôle utilisable dans une autre session.
Exécuter un transfert uniquement
session.forward(batch, loss_fn=...) retourne des sorties de fonction de perte sans accumuler de dégradés. Utilisez-le pour inspecter un lot préparé ou calculer les métriques d’évaluation.
Son résultat ne remplit pas l’entraînement uniquement total_loss. Inspecter loss_fn_outputs; ne traitez pas un agrégat manquant comme une perte nulle.
Avec une sortie active session et préparée batch, inspectez les sorties par exemple sans modifier les dégradés cumulés :
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Référence : FineTuningSession.forward.
Enregistrer et reprendre l’entraînement
session.save_weights(path) enregistre les poids de l’adaptateur et l’état d’optimiseur. Enregistrez la référence de point de contrôle avec son état de session source et de pilote.
Après une mise à jour terminée, enregistrez l’état d’entraînement et enregistrez sa référence source-session/point de contrôle :
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Référence : FineTuningSession.save_weights.
La méthode ne retourne qu’une fois l’enregistrement terminé. Stockez checkpoint_path avec la position du jeu de données et d’autres états du pilote avant de fermer la session.
FineTuningSession.create_from_checkpoint restaure l’état d’entraînement dans une nouvelle session :
| Parameter | Meaning |
|---|---|
checkpoint_path |
Référence de point de contrôle d’entraînement enregistrée sous <source-session-id>/<checkpoint-name> forme. |
base_model |
Modèle de base compatible avec le point de contrôle d’origine. |
lora_config |
Configuration d’adaptateur compatible avec un rang explicite. |
Un point de contrôle sampler n’est pas un point de contrôle d’entraînement à état complet. Restaurez la position du jeu de données et la planification séparément dans votre pilote. Consultez points de contrôle.
Cet assistance restaure l’état d’entraînement enregistré par le biais d’une instance authentifiée client. Passez l’entraînement checkpoint_pathenregistré et conservez le modèle de base et le classement LoRA compatibles avec la session source.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Référence : FineTuningSession.create_from_checkpoint.
La session retournée a un nouvel ID de session et démarre sa propre pulsation. Fermez la session reprise lorsque sa boucle s’arrête, tout comme vous fermez une session nouvellement créée.
Utiliser des opérations asynchrones
Le client asynchrone et les wrappers de livre de recettes du Kit de développement logiciel (SDK) ne sont pas interchangeables. Importez le client asynchrone à partir azure.ai.finetuningsessions.modelsduquel les types de azure.ai.finetuningsessions.aiomodèles proviennent toujours .
| Interface | Modèle d’achèvement |
|---|---|
Synchrone FineTuningSession |
La méthode retourne un résultat d’opération terminé. |
Méthodes pratiques du Kit de développement logiciel (SDK) asynchrone brutes, telles que save_weights_for_sampler_async |
Attendez la soumission, puis attendez l’achèvement retourné asyncio.Task . |
Méthodes de wrapper de formation de livre de recettes telles que save_state_async |
Attendez la soumission, puis attendez le futur result_async(). |
Pour une session en direct appartenant à un asynchrone client, cet assistance conserve les pondérations de l’échantillonneur et retourne l’identificateur de point de contrôle terminé :
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Référence : FineTuningSessionClient.save_weights_for_sampler_async asynchrone.
Utilisez save_weights_and_get_sampling_client_async plutôt une actualisation éphémère de l’échantillonneur. Sur le client du Kit de développement logiciel (SDK) brut, cette méthode retourne toujours une tâche avec un résultat d’opération, et non un client d’échantillonnage de livre de recettes.
Attendez les sauvegardes requises avant de décharger une session. L’argument de compatibilité ttl_seconds du livre de recettes n’est pas transféré à ces sauvegardes du Kit de développement logiciel (SDK) ; ne le traitez pas comme un paramètre de rétention appliqué.
Pour des objectifs personnalisés, le livre forward_backward_custom_async de recettes compose les sorties de transfert de service avec le calcul de perte différentiable côté client. Ce n'est pas une méthode surFineTuningSession, et le paramètre du loss_fn Kit de développement logiciel (SDK) n'accepte pas de Python arbitraire pouvant être appelé.
Fermer les ressources
session.close() arrête sa pulsation et envoie une demande de déchargement. Appelez-le lorsque la boucle se termine, y compris en cas d’échec ; fermez ensuite le client HTTP et les informations d’identification.
La fermeture ne confirme pas l’achèvement du nettoyage à distance ni la suppression de points de contrôle.
session.delete() peut être en cascade vers des ressources enregistrées. Consultez Inspecter et décharger des sessions.
Utilisez le open_session gestionnaire de contexte pour exécuter une mise à jour SFT unique et enregistrer l’état d’entraînement. Définissez open_session et apply_optimizer_step à partir des exemples précédents et transmettez une SFT batchrendue sansmpty.
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Référence : FineTuningSession.close et FineTuningSession.save_weights.
L’assistance retourne une référence de point de contrôle d’entraînement. Son contexte envoie une demande de déchargement même si une opération d’entraînement déclenche une exception, puis ferme le client et les informations d’identification.
Informations de référence sur le SDK
Utilisez la référence complète pour les exemples exécutables, les signatures de méthode, les API asynchrones, les types de résultats et les erreurs :