Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
S’applique à : Analytics Platform System (PDW)
Crée une table externe.
Utilisez une table externe pour :
- Interroger des données Hadoop ou Stockage Blob Azure avec des instructions Transact-SQL.
- Importer des données Hadoop ou Stockage Blob Azure et les stocker dans Analytics Platform System.
Voir aussi CREATE EXTERNAL DATA SOURCE et DROP EXTERNAL TABLE.
Syntaxe
CREATE EXTERNAL TABLE { database_name.schema_name.table_name | schema_name.table_name | table_name }
    ( <column_definition> [ , ...n ] )
    WITH (
        LOCATION = 'hdfs_folder_or_filepath' ,
        DATA_SOURCE = external_data_source_name ,
        FILE_FORMAT = external_file_format_name
        [ , <reject_options> [ , ...n ] ]
    )
[ ; ]

<column_definition> ::=
column_name <data_type>
    [ COLLATE collation_name ]
    [ NULL | NOT NULL ]

<reject_options> ::=
{
    | REJECT_TYPE = { value | percentage },
    | REJECT_VALUE = reject_value ,
    | REJECT_SAMPLE_VALUE = reject_sample_value ,

}
Arguments
{ database_name.nom_schéma.nom_de_table_| schema_name.nom_de_tableau | table_name }
Nom (composé d’une à trois parties) de la table à créer.
Pour une table externe, Analytics Platform System stocke uniquement les métadonnées de la table avec des statistiques de base sur le fichier ou le dossier qui est référencé dans Hadoop ou Stockage Blob Azure. Aucune donnée réelle est déplacée ou stockée dans le système de la plateforme d’analyse.
Important
Pour des performances optimales, si le pilote de source de données externe prend en charge un nom en trois parties, vous devez fournir le nom en trois parties.
< > column_definition [ ,... n ]
CREATE EXTERNAL TABLE prend en charge la possibilité de configurer le nom de colonne, le type de données, la valeur Nullability et le classement. Vous ne pouvez pas utiliser les DEFAULT CONSTRAINT tables externes.
Les définitions de colonne, notamment les types de données et le nombre de colonnes, doivent correspondre aux données des fichiers externes. En cas de non correspondance, les lignes du fichier sont rejetées lors de l’interrogation des données.
EMPLACEMENT = 'folder_or_filepath'
Spécifie le dossier ou le chemin et le nom du fichier où se trouvent les données dans Hadoop ou Stockage Blob Azure. L’emplacement commence au dossier racine. Le dossier racine est l’emplacement de données qui est spécifié dans la source de données externe.
Dans Analytics Platform System, l’instruction CREATE EXTERNAL TABLE AS SELECT (CETAS) crée le chemin et le dossier s’ils n’existent pas.
CREATE EXTERNAL TABLE ne crée pas le chemin et le dossier.
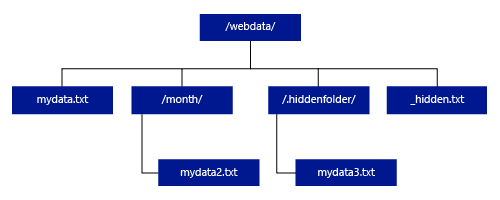
Si vous spécifiez LOCATION qu’il s’agit d’un dossier, une requête PolyBase qui sélectionne dans la table externe récupère les fichiers du dossier et tous ses sous-dossiers. Tout comme Hadoop, PolyBase ne retourne pas les dossiers masqués. Il ne retourne pas non plus de fichiers pour lesquels le nom de fichier commence par un soulignement (_) ou un point (.).
Dans l’exemple d’image suivant, si LOCATION='/webdata/'une requête PolyBase retourne des lignes depuis mydata.txt et mydata2.txt. Elle ne retourne mydata3.txt pas parce qu’elle se trouve dans un sous-dossier d’un dossier masqué et ne retourne _hidden.txt pas parce qu’il s’agit d’un fichier masqué.
Pour modifier la valeur par défaut et uniquement lire les données du dossier racine, définissez l’attribut <polybase.recursive.traversal>sur 'false' dans le fichier de configuration core-site.xml. Ce fichier se trouve sous <SqlBinRoot>\PolyBase\Hadoop\Conf\ sous la racine bin de SQL Server. Par exemple : C:\Program Files\Microsoft SQL Server\MSSQL13.XD14\MSSQL\Binn\.
DATA_SOURCE = external_data_source_name
Spécifie le nom de la source de données externe contenant l’emplacement des données externes. Cet emplacement est soit Hadoop, soit Stockage Blob Azure. Pour créer une source de données externe, utilisez CREATE EXTERNAL DATA SOURCE.
FILE_FORMAT = external_file_format_name
Spécifie le nom de l’objet de format de fichier externe qui stocke le type de fichier et la méthode de compression pour les données externes. Pour créer un format de fichier externe, utilisez CREATE EXTERNAL FILE FORMAT.
Options REJECT
Cette option peut être utilisée uniquement avec des sources de données externes où TYPE = HADOOP.
Vous pouvez spécifier les paramètres de rejet qui déterminent la façon dont PolyBase gère les enregistrements sales qu’il récupère à partir de la source de données externe. Un enregistrement de données est considéré comme « incorrect » si les types de données ou le nombre de colonnes ne correspondent pas aux définitions de colonnes de la table externe.
Si vous ne spécifiez pas ou ne changez pas les valeurs REJECT, PolyBase utilise les valeurs par défaut. Ces informations sur les paramètres de rejet sont stockées sous forme de métadonnées supplémentaires lorsque vous créez une table externe avec CREATE EXTERNAL TABLE une instruction. Lorsqu’une instruction ou SELECT une instruction future SELECT INTO SELECT sélectionne des données dans la table externe, PolyBase utilise les options de rejet pour déterminer le nombre ou le pourcentage de lignes qui peuvent être rejetées avant l’échec de la requête réelle. La requête retourne des résultats (partiels) jusqu’à ce que le seuil de rejet soit dépassé. Ensuite, elle échoue avec le message d’erreur correspondant.
REJECT_TYPE = { valeur | pourcentage }
Précise si l’option REJECT_VALUE est spécifiée en tant que valeur littérale ou pourcentage.
value
REJECT_VALUEest une valeur littérale, et non un pourcentage. La requête PolyBase échoue lorsque le nombre de lignes rejetées dépasse reject_value.Par exemple, si
REJECT_VALUE = 5etREJECT_TYPE = value, la requête PolyBaseSELECTéchoue après cinq lignes rejetées.pourcentage
REJECT_VALUEest un pourcentage, et non une valeur littérale. Une requête PolyBase échoue lorsque le pourcentage de lignes ayant échoué dépasse reject_value. Le pourcentage de lignes ayant échoué est calculé à intervalles.
REJECT_VALUE = reject_value
Spécifie la valeur ou le pourcentage de lignes pouvant être rejetées avant de provoquer l’échec de la requête.
Pour REJECT_TYPE = value, reject_value doit être un entier compris entre 0 et 2 147 483 647.
Pour REJECT_TYPE = percentage, reject_value doit être un flotteur compris entre 0 et 100.
REJECT_SAMPLE_VALUE = reject_sample_value
Cet attribut est requis lorsque vous spécifiez REJECT_TYPE = percentage. Il détermine le nombre de lignes à tenter de récupérer avant que PolyBase ne recalcule le pourcentage de lignes rejetées.
Le paramètre reject_sample_value doit être un entier compris entre 0 et 2 147 483 647.
Par exemple, si REJECT_SAMPLE_VALUE = 1000PolyBase calcule le pourcentage de lignes ayant échoué après avoir tenté d’importer 1 000 lignes à partir du fichier de données externe. Si le pourcentage de lignes ayant échoué est inférieur à reject_value, PolyBase tente de récupérer 1 000 lignes. Il continue de recalculer le pourcentage de lignes ayant échoué après avoir tenté d’importer chaque ligne supplémentaire de 1 000 lignes.
Note
Étant donné que PolyBase calcule le pourcentage de lignes ayant échoué à intervalles, le pourcentage de lignes ayant échoué peut dépasser la valeur de reject_value.
Exemple
Cet exemple montre comment les trois REJECT options interagissent entre elles. Par exemple, si REJECT_TYPE = percentage, REJECT_VALUE = 30et REJECT_SAMPLE_VALUE = 100, le scénario suivant peut se produire :
- PolyBase tente de récupérer les 100 premières lignes : la récupération échoue pour 25 d’entre elles, et réussit pour les 75 autres.
- Le pourcentage de lignes ayant échoué qui est obtenu est de 25 %, ce qui est inférieur à la valeur de rejet de 30 %. Par conséquent, PolyBase continue à récupérer des données à partir de la source de données externe.
- PolyBase tente de charger les 100 lignes suivantes. Cette fois-ci, le chargement réussit pour 25 lignes et échoue pour les 75 autres.
- Le pourcentage de lignes ayant échoué est recalculé et on obtient 50 %. Le pourcentage de lignes ayant échoué a donc dépassé la valeur de rejet de 30 %.
- La requête PolyBase échoue après le rejet de 50 % des 200 premières lignes qu’elle a tenté de retourner. Les lignes correspondantes sont retournées avant que la requête PolyBase détecte que le seuil de rejet a été dépassé.
Permissions
Nécessite les autorisations utilisateur suivantes :
CREATE TABLEALTER ANY SCHEMAALTER ANY EXTERNAL DATA SOURCEALTER ANY EXTERNAL FILE FORMATCONTROL DATABASE
La connexion qui crée la source de données externe doit avoir l’autorisation de lire et d’écrire dans la source de données externe, située dans Hadoop ou Stockage Blob Azure.
Important
L’autorisation ALTER ANY EXTERNAL DATA SOURCE accorde à tout principal la possibilité de créer et de modifier n’importe quel objet source de données externe, et par conséquent, elle accorde également la possibilité d’accéder à toutes les informations d’identification délimitées à la base de données sur la base de données. Cette autorisation doit être considérée comme fournissant des privilèges très élevés, et doit donc être accordée uniquement aux principaux de confiance du système.
Gestion des erreurs
Lors de l’exécution de l’instruction CREATE EXTERNAL TABLE, PolyBase tente de se connecter à la source de données externe. Si la tentative de connexion échoue, l’instruction échoue et la table externe n’est pas créée. L’échec de la commande peut prendre plusieurs minutes, car PolyBase tente plusieurs connexions avant que la requête n’échoue.
Remarques
Dans les scénarios de requête ad hoc, tels que SELECT FROM EXTERNAL TABLE, PolyBase stocke les lignes récupérées à partir de la source de données externe dans une table temporaire. Une fois la requête terminée, PolyBase supprime la table temporaire. Aucune donnée permanente n’est stockée dans les tables SQL.
En revanche, dans le scénario d’importation, par SELECT INTO FROM EXTERNAL TABLEexemple, PolyBase stocke les lignes récupérées à partir de la source de données externe en tant que données permanentes dans la table SQL. La nouvelle table est créée lors de l’exécution de la requête, au moment où PolyBase récupère les données externes.
PolyBase peut envoyer (push) une partie du calcul des requêtes vers Hadoop pour améliorer les performances des requêtes. Cette action est appelée pushdown de prédicat. Pour l’activer, spécifiez l’option de localisation du gestionnaire de ressources Hadoop dans CREATE EXTERNAL DATA SOURCE.
Vous pouvez créer plusieurs tables externes qui référencent les mêmes sources de données externes ou des sources différentes.
Limitations
Étant donné que les données d’une table externe ne sont pas sous le contrôle de gestion direct de l’appliance, elles peuvent être modifiées ou supprimées à tout moment par un processus externe. Par conséquent, il n’est pas garanti que les résultats d’une requête exécutée sur une table externe soient déterministes. La même requête peut retourner des résultats différents chaque fois qu’elle est exécutée sur une table externe. De même, une requête peut échouer si les données externes sont déplacées ou supprimées.
Vous pouvez créer plusieurs tables externes qui référencent chacune des sources de données externes différentes. Si vous exécutez simultanément plusieurs requêtes sur des sources de données Hadoop différentes, chaque source Hadoop doit utiliser le même paramètre de configuration de serveur « hadoop connectivity » (connectivité Hadoop). Par exemple, vous ne pouvez pas exécuter simultanément une requête sur un cluster Hadoop Cloudera et sur un cluster Hadoop Hortonworks, puisqu’ils utilisent des paramètres de configuration différents. Pour connaître les paramètres de configuration et les combinaisons prises en charge, consultez la configuration de la connectivité PolyBase.
Seules les instructions DDL suivantes sont autorisées avec les tables externes :
-
CREATE TABLEetDROP TABLE -
CREATE STATISTICSetDROP STATISTICS -
CREATE VIEWetDROP VIEW
Les constructions et les opérations suivantes ne sont pas prises en charge :
- Contrainte
DEFAULTsur les colonnes de table externe - Les opérations DML delete, insert et update
- Masquage dynamique des données sur les colonnes de table externe
Limitations des requêtes
PolyBase peut consommer un maximum de 33 000 fichiers par dossier lors de l’exécution simultanée de 32 requêtes PolyBase. Ce nombre maximal inclut les fichiers et les sous-dossiers de chaque dossier HDFS. Si le degré de concurrence est inférieur à 32, un utilisateur peut exécuter des requêtes PolyBase sur des dossiers dans des systèmes HDFS contenant plus de 33 000 fichiers. Il est recommandé de raccourcir au maximum les chemins de fichiers externes et de ne pas utiliser plus de 30 000 fichiers par dossier HDFS. Lorsque trop de fichiers sont référencés, une exception d’insuffisance de mémoire Java Virtual Machine (JVM) peut être levée.
Limitations concernant la largeur des tables
Dans SQL Server 2016 (13.x), PolyBase a une limite de largeur de ligne de 32 Ko en fonction de la taille maximale d’une seule ligne valide par définition de table. Si la somme du schéma de colonne est supérieure à 32 Ko, PolyBase ne peut pas interroger les données.
Dans Azure Synapse Analytics, cette limitation a été augmentée à 1 Mo.
Limitations des types de données
Les types de données suivants ne peuvent pas être utilisés dans les tables externes PolyBase :
- géographie
- géométrie
- hierarchyid
- image
- text
- ntext
- xml
- Tout type défini par l’utilisateur
Verrouillage
Verrou partagé sur l’objet SCHEMARESOLUTION .
Security
Les fichiers de données d’une table externe sont stockés dans Hadoop ou Stockage Blob Azure. Ces fichiers de données sont créés et gérés par vos propres processus. Il vous incombe de gérer la sécurité des données externes.
Exemples
A. Joindre des données HDFS avec des données du système de la plateforme d’analyse
SELECT cs.user_ip
FROM ClickStream AS cs
     INNER JOIN [User] AS u
         ON cs.user_ip = u.user_ip
WHERE cs.url = 'www.microsoft.com';
B. Importer des données de ligne à partir de HDFS dans une table du système de la plateforme d’analyse distribuée
CREATE TABLE ClickStream_PDW
WITH (DISTRIBUTION = HASH(url)) AS
SELECT url,
       event_date,
       user_ip
FROM ClickStream;
C. Importer des données de ligne à partir de HDFS dans une table du système de la plateforme d’analyse répliquée
CREATE TABLE ClickStream_PDW
WITH (DISTRIBUTION = REPLICATE) AS
SELECT url,
       event_date,
       user_ip
FROM ClickStream;