Choisir un outil d’ingestion de données
Conseil / Astuce
Pour plus d’informations, consultez l’onglet Texte et images !
Lorsque vous concevez des pipelines de données dans Azure Databricks, la sélection de l’outil d’ingestion approprié a un impact direct sur la fiabilité du pipeline, l’effort de maintenance et les coûts à long terme. Chaque outil répond à différents scénarios, sources de données et exigences opérationnelles. La compréhension de ces différences vous aide à prendre des décisions éclairées qui s’alignent sur les besoins de votre organisation.
Comprendre le paysage des outils d’ingestion
Azure Databricks fournit plusieurs options d’ingestion qui s’étendent d’un spectre de services entièrement managés à des infrastructures hautement personnalisables. Les outils que vous choisissez dépendent de facteurs tels que votre type de source de données, les exigences de latence et le contrôle dont vous avez besoin sur le processus d’ingestion.

À l'extrémité la plus gérée, Lakeflow Connect offre des connecteurs clés en main pour les applications et bases de données d’entreprise. Ces connecteurs gèrent automatiquement l’authentification, le suivi des modifications, la récupération des erreurs et l’évolution du schéma. Sur l’aspect personnalisable, Spark Structured Streaming vous donne un contrôle total sur la façon dont les données circulent via votre pipeline, mais cela nécessite davantage d’efforts de développement et de maintenance.
Entre ces extrêmes, vous trouvez des outils tels que Auto Loader pour les fichiers de stockage cloud, COPY INTO pour des chargements par lots basés sur SQL, et des approches basées sur des notebooks à l'aide de connexions JDBC/ODBC. En outre, Azure Data Factory sert de couche d’orchestration qui peut coordonner le déplacement des données dans Azure Databricks à partir de l’écosystème Azure plus large.
Lakeflow Connect
Lakeflow Connect représente l’approche moderne de l’ingestion de données dans Azure Databricks. Il offre des connecteurs entièrement managés et des connecteurs standard qui s’intègrent aux pipelines Lakeflow pour une expérience simplifiée.
Les connecteurs managés sont organisés en trois types :
SaaS connectors fournissent une intégration prête à l’emploi avec des applications d’entreprise telles que Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk, etc. Ces connecteurs gèrent l’authentification spécifique à la source, les lectures incrémentielles, la limitation du débit d’API, l’évolution du schéma et les nouvelles tentatives automatisées. Ils s’exécutent sur une infrastructure sans serveur et écrivent dans des tables de flux régies par Unity Catalog.
Les connecteurs de bases de données ingèrent des données à partir de bases de données relationnelles, notamment MySQL, PostgreSQL et SQL Server, en utilisant la capture de données de modification (CDC). Étant donné que les connecteurs basés sur CDC lisent les journaux des transactions de bases de données plutôt que d’interroger directement des tables, ils nécessitent une passerelle d’ingestion déployée dans votre réseau et un volume de stockage intermédiaire pour stocker temporairement les modifications capturées.
Les connecteurs de communauté sont des connecteurs open source créés et gérés par la communauté. Ils étendent Lakeflow Connect aux sources qui n’ont pas encore de connecteur managé. Vous pouvez utiliser un connecteur de communauté existant ou contribuer à votre propre connecteur.
Note
L’écosystème de connecteurs augmente rapidement. Consultez la documentation sur les connecteurs managés pour obtenir la liste complète actuelle des sources prises en charge.
Les connecteurs standard étendent Lakeflow Connect au stockage d’objets cloud et aux bus de messages. Vous pouvez ingérer des données à partir d’Amazon S3, d’Azure Data Lake Storage ou de Google Cloud Storage à l’aide du chargeur automatique. Pour les données en temps réel, les connecteurs standard prennent en charge Apache Kafka, Google Pub/Sub et Apache Pulsar.

Envisagez Lakeflow Connect lorsque vous avez besoin d’une ingestion fiable et à faible maintenance à partir de sources prises en charge. Les connecteurs managés réduisent considérablement le temps de développement et la maintenance continue par rapport aux solutions personnalisées. Toutefois, si votre source de données n’est pas prise en charge ou si vous avez besoin d’une logique d’ingestion hautement spécialisée, vous devrez peut-être explorer d’autres options.
Lakeflow Connect prend en charge l’ingestion planifiée (toutes les heures, quotidiennes, hebdomadaires) et les déclencheurs à la demande , ce qui le rend adapté aux cycles d’actualisation des données réguliers et aux scénarios de chargement ad hoc.
Connecteurs basés sur des requêtes
Les connecteurs basés sur des requêtes sont une alternative légère aux connecteurs de base de données CDC pour l’ingestion planifiée à partir de bases de données relationnelles. Au lieu de lire les journaux des transactions, ils interrogent directement la table source à l’aide d’une colonne de curseur , un horodatage ou un entier monotoniquement croissant qui suit les lignes qui sont nouvelles ou mises à jour depuis la dernière exécution du pipeline.
Étant donné qu’ils interrogent directement la source, les connecteurs basés sur des requêtes ne nécessitent pas de passerelle d’ingestion ou de stockage intermédiaire. À chaque exécution planifiée, le connecteur récupère toutes les lignes dont la valeur de la colonne de curseur est supérieure au point d'eau haute de l'exécution précédente, puis enregistre les résultats dans les tables de diffusion continue dans Unity Catalog.
Les sources prises en charge incluent Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL et toutes les sources de données de fédération Lakehouse.
Les connecteurs basés sur des requêtes prennent en charge trois modes de suivi d’historique pour les tables de destination :
- SCD Type 1 : remplace la ligne existante avec la dernière ligne source. Aucun historique n’est conservé.
- SCD Type 2 : conserve l’historique complet en ajoutant de nouvelles lignes avec des métadonnées de version.
- Append-only : ajoute chaque ligne importée sans fusionner ni remplacer.
Choisissez les connecteurs basés sur des requêtes plutôt que les connecteurs de base de données CDC lorsque l'infrastructure CDC ou binlog n'est pas disponible, mais qu'une colonne de curseur fiable existe dans la source. Choisissez des connecteurs CDC lorsque vous avez besoin de chaque état de ligne intermédiaire entre les exécutions du pipeline ou lorsque le suivi de la suppression logique est critique. Le compromis est que les connecteurs basés sur des requêtes placent plus de charge directement sur les tables sources par rapport aux connecteurs CDC, qui lisent à partir du binlog.
Chargeur automatique
Le chargeur automatique fournit un traitement incrémentiel des fichiers pour les données arrivant dans le stockage cloud. Au lieu d’analyser des répertoires entiers pour rechercher de nouveaux fichiers, le chargeur automatique effectue efficacement le suivi des fichiers qui ont été traités et ingère uniquement les nouveaux arrivées.
Auto Loader fonctionne en maintenant un état dans un emplacement de checkpoint qui suit les fichiers traités. Lorsque de nouveaux fichiers atterrissent dans votre stockage cloud, le chargeur automatique les découvre par le biais d’une liste de répertoires ou d’un mode de notification de fichier. La liste de répertoires analyse régulièrement les nouveaux fichiers, tandis que le mode de notification de fichier utilise des événements natifs cloud pour la détection immédiate.
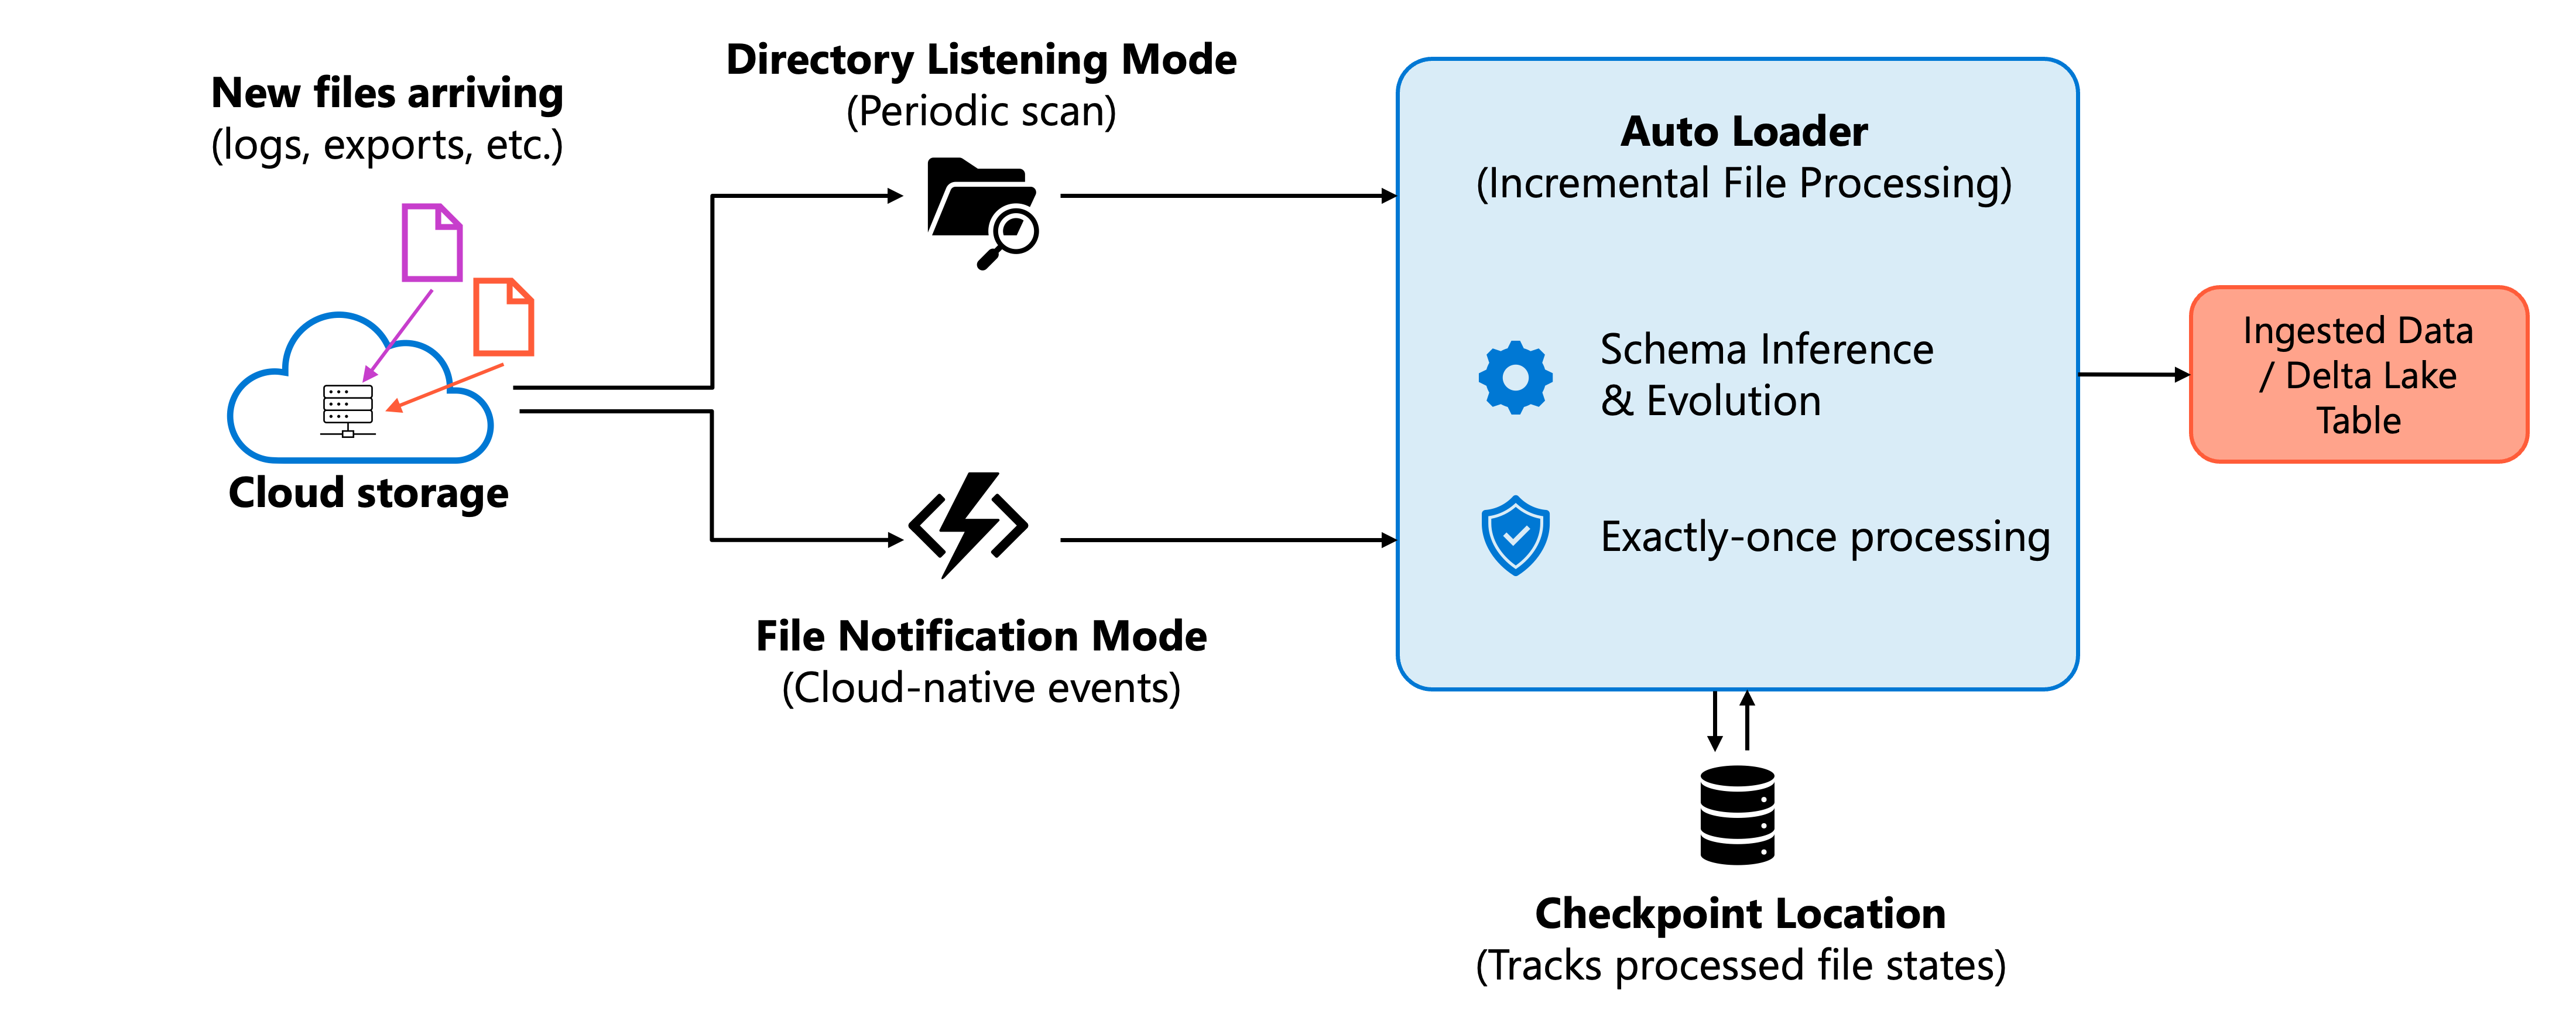
Les principales fonctionnalités du chargeur automatique sont les suivantes :
- Inférence et évolution du schéma : détecte automatiquement le schéma des fichiers entrants et gère les modifications de schéma correctement.
- Traitement exactement une fois : garantit que chaque fichier est traité une seule fois, même en cas d’échecs et de redémarrages.
- Scalabilité : gère efficacement des milliards de fichiers pour les remplissages et les migrations.
- Prise en charge du format : traite json, CSV, Parquet, Avro, ORC, XML, texte et fichiers binaires.
Le chargeur automatique s’adapte aux scénarios où les données arrivent en tant que fichiers dans le stockage cloud : les modèles courants incluent les fichiers journaux, les exportations à partir de systèmes en amont et les zones d’atterrissage des données. Vous pouvez utiliser Auto Loader avec des pipelines Lakeflow pour une expérience managée ou avec Structured Streaming pour plus de contrôle.
INSÉRER DANS
La COPY INTO commande SQL charge les données du stockage cloud dans des tables Delta. Contrairement au chargeur automatique, qui s’exécute en continu en tant que flux, COPY INTO s’exécute en tant qu’opération de traitement par lots que vous planifiez ou déclenchez manuellement.
COPY INTO suit les fichiers qu’il a déjà traités, ce qui rend l’opération idempotente. L’exécution de la même commande plusieurs fois ne duplique pas les données, car les fichiers précédemment chargés sont ignorés. Cette caractéristique est COPY INTO utile pour les travaux de traitement par lots planifiés dans lesquels vous souhaitez un comportement prévisible et reproductible.
Note
Les métadonnées de suivi sont stockées dans le journal des transactions de la table Delta (le _delta_log répertoire)

Scénarios courants pour COPY INTO incluent des migrations de données ponctuelles, des chargements batch planifiés à partir de zones de transfert et des workflows centrés sur SQL où vous préférez la syntaxe déclarative par rapport aux API de streaming.
Choisissez COPY INTO au lieu du chargeur automatique lorsque vous effectuez une charge par lot unique d'un jeu de données volumineux.
COPY INTO fournit un modèle de configuration plus simple sans nécessiter d’infrastructure de diffusion en continu, ce qui le rend idéal pour charger des centaines de gigaoctets ou même des téraoctets de données en une seule opération. Le modèle de traitement continu du chargeur automatique et la gestion des points de contrôle ajoutent une complexité inutile lorsque vous n’avez besoin de charger des données qu’une seule fois.
Toutefois, pour l’ingestion incrémentielle en cours à grande échelle, le chargeur automatique offre de meilleures performances et une découverte de fichiers plus robuste.
Streaming Structuré de Spark
Spark Structured Streaming fournit la base du traitement des données en temps réel dans Azure Databricks. Il permet l’ingestion continue à partir de différentes sources de streaming avec la garantie d'un traitement une seule fois.
Les sources de diffusion en continu prises en charge sont les suivantes :
- Apache Kafka et Azure Event Hubs : pour les architectures pilotées par les événements et le traitement de la file d’attente des messages.
- Flux de données de modification Delta Lake : pour propager les modifications entre des tables Delta.
- Stockage cloud via Auto Loader : pour l'ingestion de streaming basée sur des fichiers.
- Sources socket et personnalisées : pour des scénarios d'ingestion spécialisés.
Choisissez Structured Streaming lorsque vous avez besoin d’un contrôle précis sur le comportement de diffusion en continu, la logique personnalisée de filigrane ou de fenêtrage, ou lorsque vous utilisez des sources non prises en charge par des abstractions de niveau supérieur.
Connexions JDBC et ODBC
L'ingestion basée sur des notebooks à l'aide de JDBC ou ODBC reste une approche pratique pour extraire des données à partir de bases de données relationnelles. Vous écrivez du code qui se connecte directement aux bases de données sources, exécute des requêtes et charge les résultats dans des tables Delta.
Cette approche prend en charge pratiquement n’importe quelle base de données avec un pilote JDBC ou ODBC : SQL Server, Oracle, PostgreSQL, MySQL et bien d’autres. Vous implémentez des charges complètes ou incrémentielles en écrivant des requêtes appropriées, souvent en utilisant des colonnes de filigrane pour suivre la progression de l’extraction.
Alors que les connecteurs managés Lakeflow Connect remplacent JDBC/ODBC pour de nombreux scénarios, les connexions basées sur un notebook restent précieuses quand :
- Votre base de données n’est pas prise en charge par les connecteurs managés Lakeflow Connect.
- Vous avez besoin d’une logique d’extraction personnalisée que les connecteurs managés ne peuvent pas prendre en charge.
- Vous maintenez des pipelines existants qui utilisent ce modèle.
- Vous avez besoin d'optimisations spécifiques de filtrage de requêtes pour les tables volumineuses.
Lors de l’utilisation de JDBC/ODBC, stockez les informations d’identification en toute sécurité à l’aide de secrets Databricks plutôt que de les coder en dur dans les notebooks. Tenez compte de l’impact sur les performances sur les systèmes sources et implémentez la limitation ou la planification appropriées pour éviter les bases de données transactionnelles écrasantes.
Pour les bases de données locales, une infrastructure réseau supplémentaire est requise : Azure ExpressRoute/VPN pour la connectivité JDBC directe à partir de Databricks ou Azure Data Factory avec un runtime d’intégration Self-Hosted pour atterrir les données dans le stockage cloud en premier.
Azure Data Factory.
Azure Data Factory (ADF) sert de plateforme d’orchestration et de déplacement de données au sein de l’écosystème Azure. Il excelle dans la coordination des flux de travail qui s’étendent sur plusieurs services et l’intégration de données provenant de diverses sources dans le stockage cloud où Azure Databricks peut les traiter.
ADF s’intègre largement aux services Microsoft tels que Dynamics 365, Azure SQL Database et Microsoft Fabric. Lorsque vos données proviennent de ces sources, ADF fournit une connectivité simple et peut atterrir des données dans Azure Data Lake Storage pour un traitement Databricks ultérieur.
Comprendre le rôle approprié d’ADF est important. Utilisez ADF pour :
- Orchestration : coordination des flux de travail qui impliquent plusieurs services Azure.
- Atterrissage initial des données : déplacement de données de sources Azure vers le stockage cloud.
- Intégration de l’entreprise : lorsque la stratégie d’entreprise impose à ADF de déplacer des données.

Évitez d’utiliser ADF pour les transformations ETL principales à l’intérieur de Databricks. L’exécution de transformations par le biais d’activités ADF introduit une complexité inutile et est moins efficace que le traitement natif Databricks. Laissez ADF gérer le déplacement des données dans votre lakehouse, puis utilisez les outils Azure Databricks pour la logique de transformation.
Appliquer un cadre de décision
La sélection d’un outil d’ingestion devient plus claire lorsque vous évaluez votre scénario par rapport aux critères de décision clés.
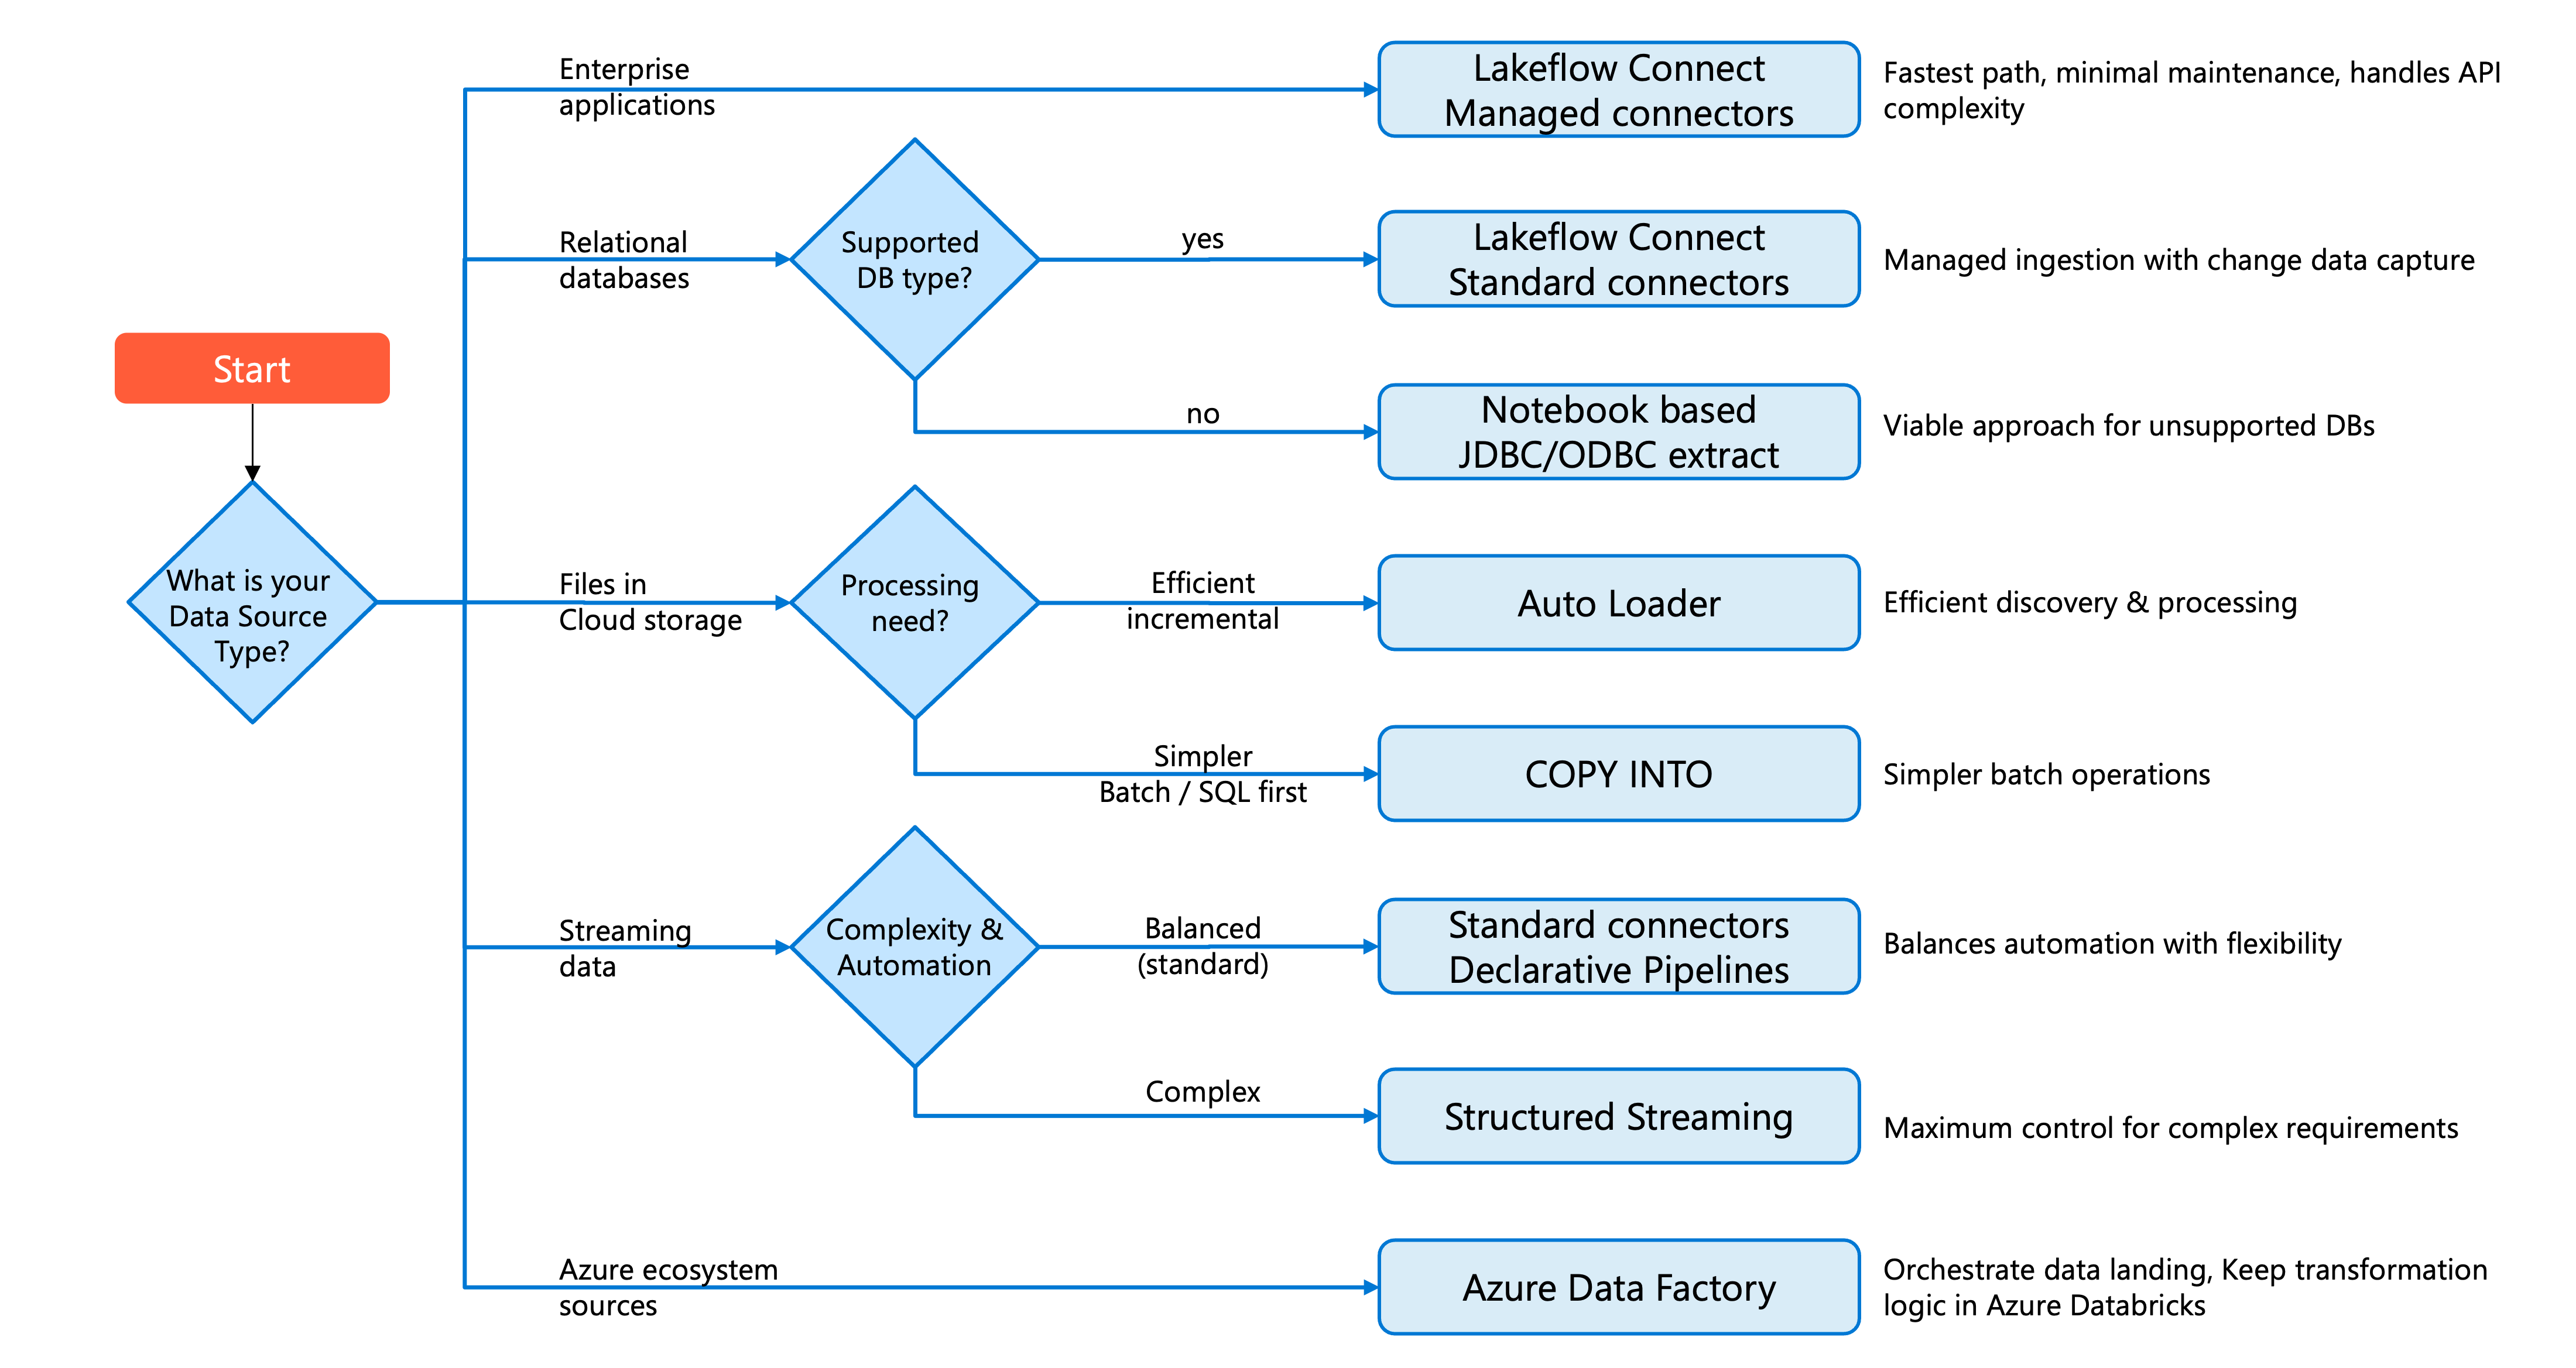
Commencez par identifier votre type de source de données, puis prenez en compte les exigences opérationnelles et le contexte organisationnel.
Pour les applications d’entreprise (Salesforce, ServiceNow, SharePoint), les connecteurs managés Lakeflow Connect offrent le chemin le plus rapide vers la production avec une maintenance minimale. Ces connecteurs gèrent la complexité de l’intégration des API, de la limitation de débit et du suivi des modifications.
Pour les bases de données relationnelles avec des types pris en charge, Lakeflow Connect offre deux chemins d’accès managés : les connecteurs de base de données (basés sur cdc, nécessite une passerelle) pour la capture de modifications continue et les connecteurs basés sur des requêtes pour simplifier l’ingestion planifiée à l’aide d’une colonne de curseur. Pour les bases de données non prises en charge, l’extraction JDBC/ODBC basée sur un notebook reste une approche viable.
Pour les fichiers dans le stockage cloud, le chargeur automatique fournit une détection et un traitement incrémentiels efficaces. Utilisez COPY INTO pour des scénarios de traitement par lots plus simples ou lorsque vous préférez les flux de travail SQL-first.
Pour la diffusion en continu de données à partir de bus de messages (Kafka, Event Hubs, Pub/Sub), les connecteurs standard avec les pipelines Lakeflow équilibrent l’automatisation avec flexibilité. Pour les exigences de diffusion en continu complexes, Structured Streaming offre un contrôle maximal.
Pour les sources d’écosystème Azure nécessitant une coordination avec d’autres services, Azure Data Factory peut orchestrer l’atterrissage des données dans votre lakehouse. Conservez la logique de transformation dans Azure Databricks plutôt que dans les flux de données ADF.
Conseil / Astuce
Commencez par l’option la plus gérée qui répond à vos besoins. Les connecteurs managés réduisent le temps de développement et la charge de maintenance. Passez uniquement à des approches plus personnalisables lorsque des exigences spécifiques ne peuvent pas être satisfaites par des abstractions de niveau supérieur.
Votre choix dépend également des compétences d’équipe et des normes organisationnelles. Documentez vos décisions et le raisonnement derrière eux pour aider les futurs membres de l’équipe à comprendre l’architecture du pipeline.