Comprendre les concepts clés
Tip
Pour plus d’informations, consultez l’onglet Texte et images !
Azure Databricks est une plateforme de service unique avec plusieurs technologies qui permettent de travailler avec des données à grande échelle. Pour utiliser Azure Databricks, il faut en comprendre quelques concepts clés.
Espaces de travail
Un espace de travail dans Azure Databricks est un environnement sécurisé et collaboratif dans lequel vous pouvez accéder à toutes les ressources Databricks, telles que des notebooks, des clusters, des jobs, des bibliothèques, des tableaux de bord et des expériences.
Vous pouvez ouvrir un espace de travail Azure Databricks à partir du portail Azure, en sélectionnant Lancer l’espace de travail.

Il fournit une interface utilisateur web ainsi que des API REST pour la gestion des ressources et des flux de travail. Les espaces de travail peuvent être structurés en dossiers pour organiser des projets, des pipelines de données ou des ressources d’équipe, et les autorisations peuvent être appliquées à différents niveaux pour contrôler l’accès. Ils prennent en charge la collaboration en permettant à plusieurs utilisateurs, comme les ingénieurs de données, les analystes et les scientifiques des données, de travailler ensemble sur des notebooks partagés, de suivre les expériences et de gérer les dépendances.
En outre, les espaces de travail sont liés au catalogue Unity (lorsqu’ils sont activés) pour la gouvernance centralisée des données, ce qui garantit un accès sécurisé aux données au sein de l’organisation. Les espaces de travail classiques sont également liés à un groupe de ressources managé qui contient les ressources de calcul, de mise en réseau et de stockage que Databricks utilise en arrière-plan.
Ordinateurs portables
Les notebooks Databricks sont des documents interactifs basés sur le web qui combinent du code exécutable, des visualisations et du texte narratif dans un environnement unique. Ils prennent en charge plusieurs langages, tels que Python, R, Scala et SQL, et permettent aux utilisateurs de basculer entre les langages au sein du même notebook à l’aide de commandes magiques. Cette flexibilité rend les notebooks bien adaptés à l’analyse exploratoire des données, à la visualisation des données, aux expériences de Machine Learning et à la création de pipelines de données complexes.
Les notebooks sont également conçus pour la collaboration : plusieurs utilisateurs peuvent modifier et exécuter des cellules simultanément, ajouter des commentaires et partager des insights en temps réel. Ils s’intègrent étroitement aux clusters Databricks, ce qui permet aux utilisateurs de traiter efficacement des jeux de données volumineux et peuvent se connecter à des sources de données externes via Unity Catalog pour l’accès aux données régis. En outre, les notebooks peuvent être contrôlés par version, planifiés en tant que tâches ou exportés pour le partage en dehors de la plateforme, ce qui les rend centrales à la fois pour l’exploration ad hoc et les flux de travail de niveau production.
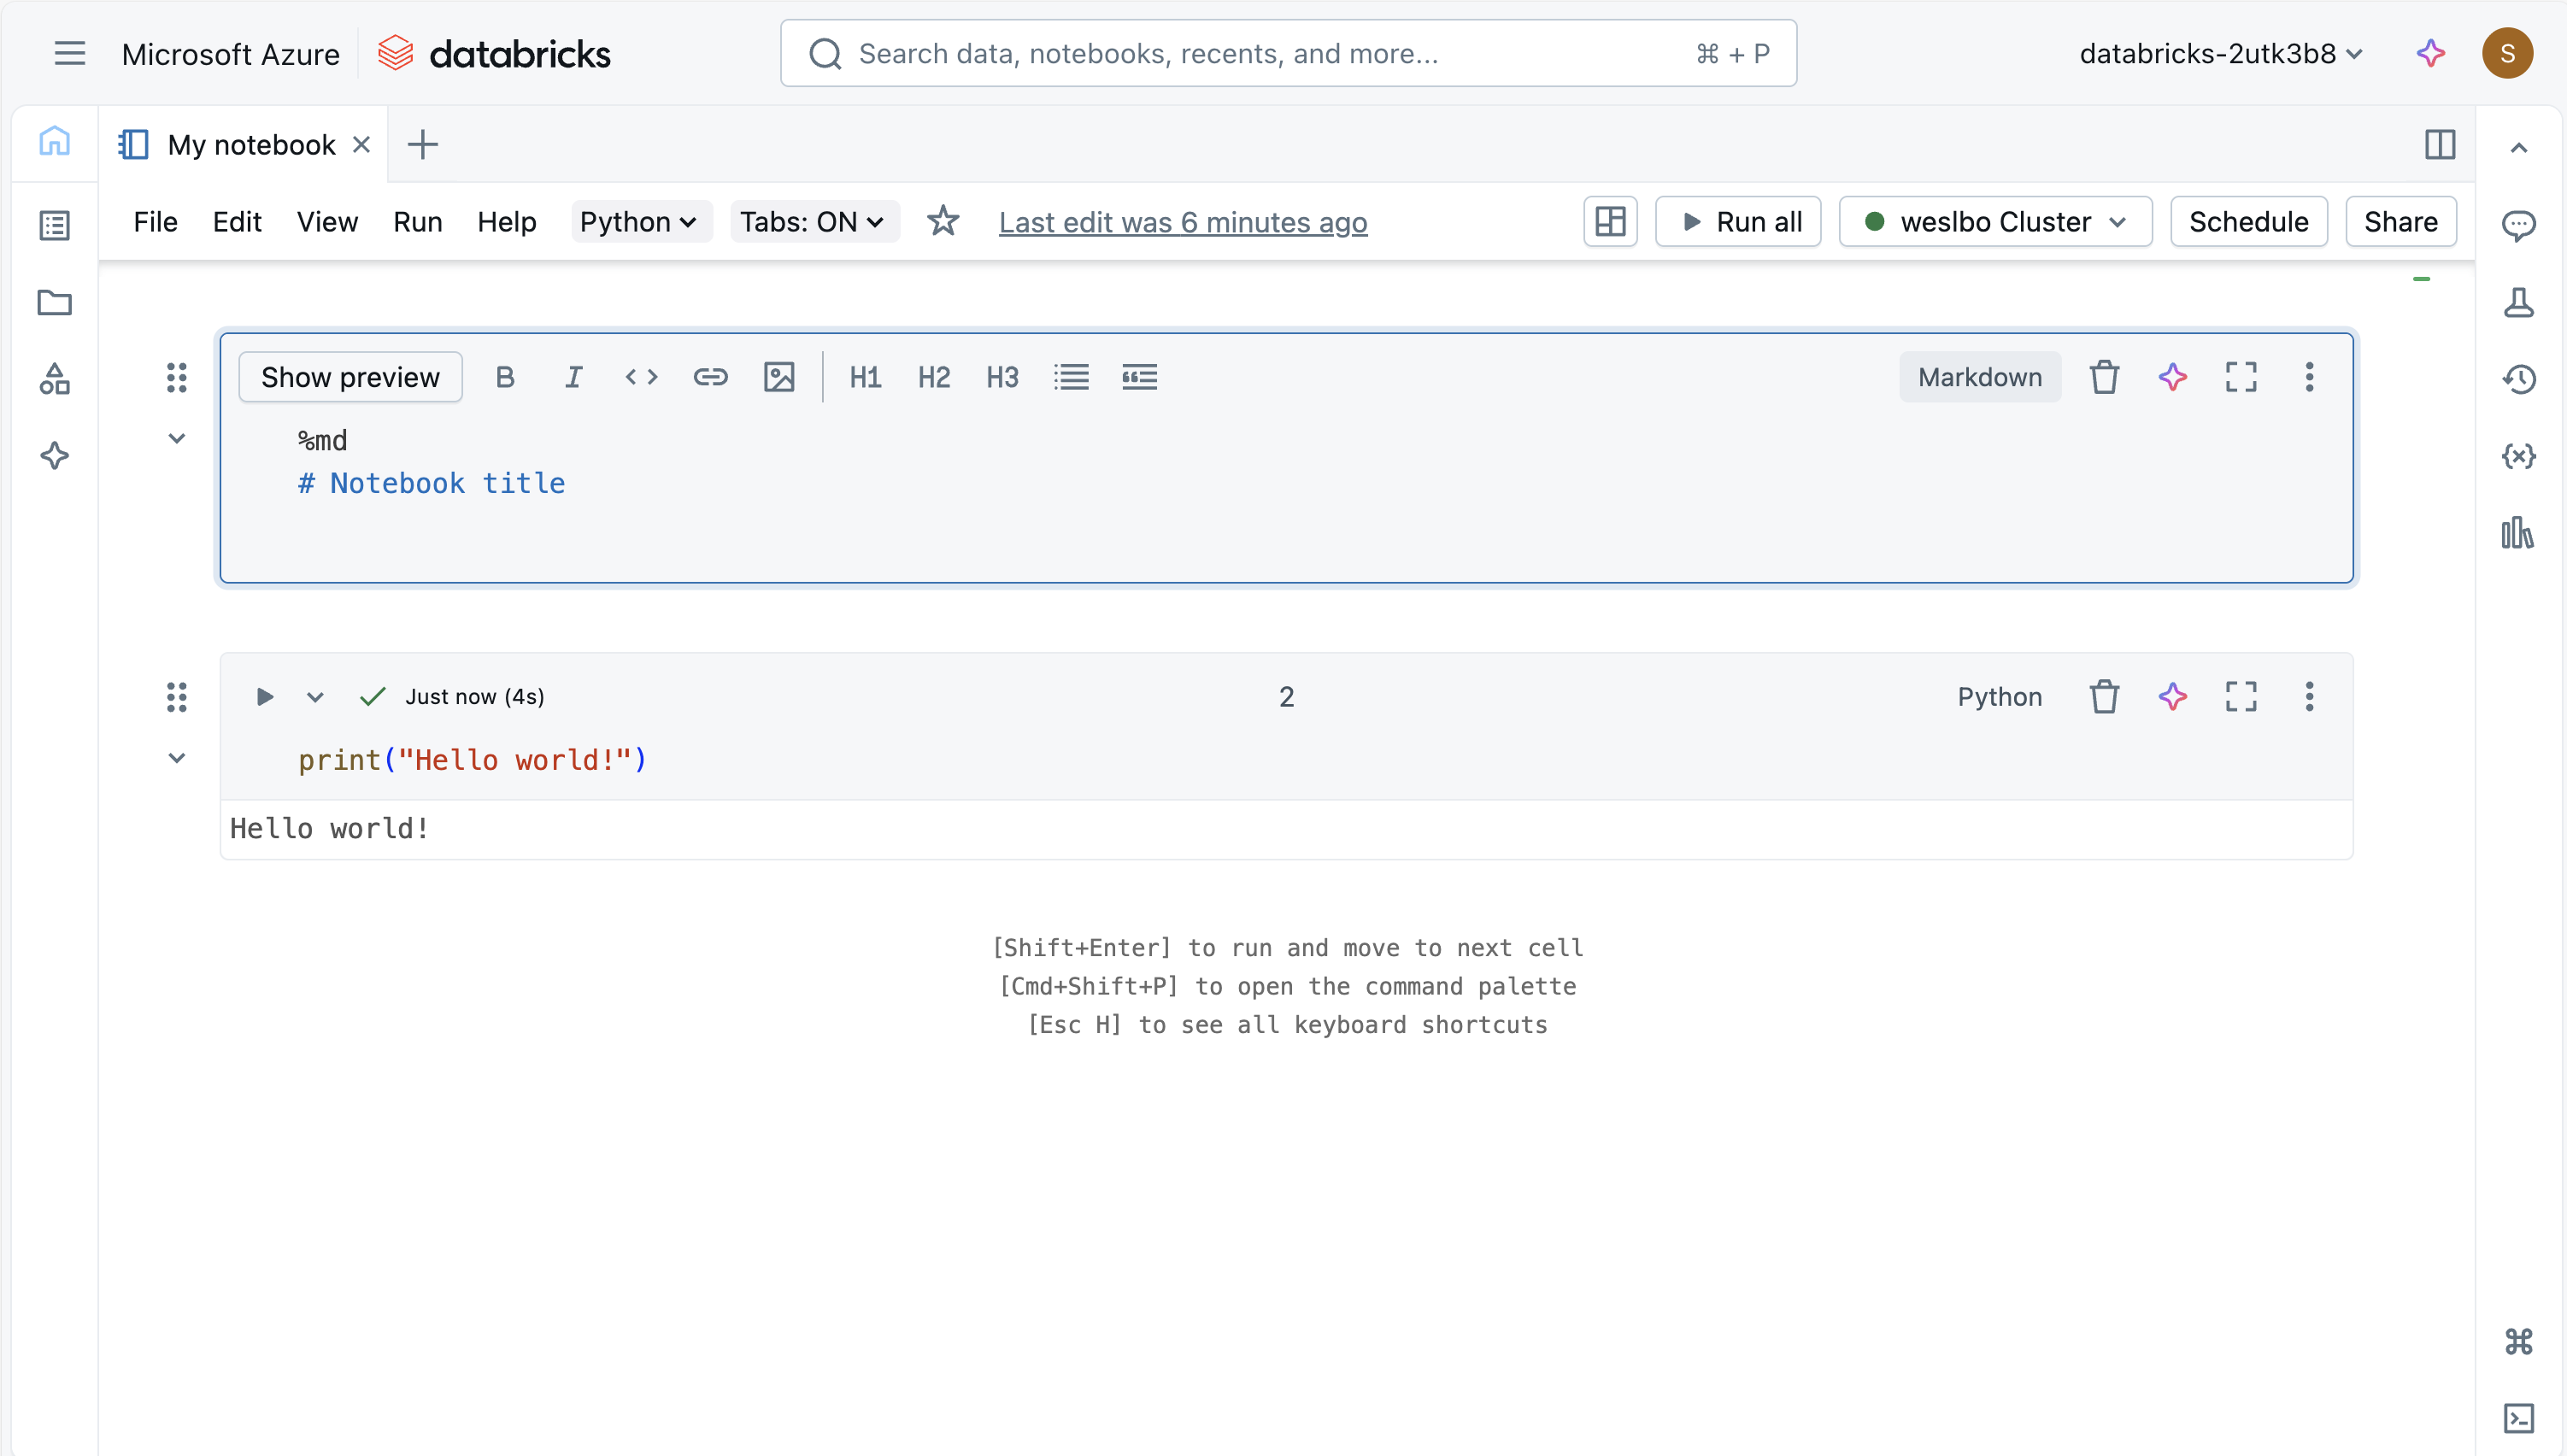
Les blocs-notes contiennent une collection de deux types de cellules : les cellules de code et les cellules Markdown. Les cellules de code contiennent du code exécutable. Les cellules Markdown contiennent du code Markdown qui s’affiche sous forme de texte et de graphique. Vous pouvez exécuter une seule cellule, un groupe de cellules ou l’ensemble du bloc-notes.
Clusters
Azure Databricks utilise une architecture à deux couches :
- Plan de contrôle : cette couche comprend les services principaux qu’Azure Databricks gère dans votre compte Azure Databricks, tels que l’application web.
- Plan de calcul : cette couche traite les données. Pour le calcul classique, le plan de calcul se trouve dans votre abonnement Azure. Pour le calcul serverless, il s’exécute dans votre compte Azure Databricks.

Les clusters sont les principaux moteurs de calcul dans Azure Databricks. Ils fournissent la puissance de traitement nécessaire pour exécuter des tâches d’ingénierie des données, de science des données et d’analytique. Chaque cluster se compose d’un nœud de pilote, qui coordonne l’exécution et un ou plusieurs nœuds Worker, qui gèrent les calculs distribués. Les clusters peuvent être créés manuellement avec des ressources fixes ou configurés pour l'auto-échelle, permettant à Databricks d'ajouter ou de supprimer des nœuds de travail selon la demande de charge de travail. Cette flexibilité garantit une utilisation efficace des ressources et un contrôle des coûts.
Azure Databricks Compute offre un large éventail d’options de calcul disponibles pour différents types de charge de travail :
- Calcul serverless : calcul entièrement géré à la demande qui effectue automatiquement un scale-up ou un scale-down pour répondre aux besoins de la charge de travail. Idéal pour les équipes qui veulent des temps de démarrage rapides, une surcharge de gestion minimale et une mise à l’échelle élastique.
- Calcul classique : clusters configurés et approvisionnés par l’utilisateur qui offrent un contrôle total sur les paramètres de calcul, tels que les tailles de machine virtuelle, les bibliothèques et les versions du runtime. Idéal pour les charges de travail spécialisées qui nécessitent une personnalisation ou des performances cohérentes.
- Entrepôts SQL : ressources de calcul optimisées pour les requêtes d’analytique et de bi basées sur SQL. Les entrepôts SQL peuvent être provisionnés en tant que serveurless (élastique, managé) ou classique (configuré par l’utilisateur) en fonction des exigences de gouvernance et de performances.
Cela vous permet d’adapter le calcul à des besoins spécifiques, de l’analyse exploratoire dans les notebooks, aux pipelines ETL à grande échelle, aux tableaux de bord hautes performances et aux rapports.
Environnement d'exécution de Databricks
Databricks Runtime est un ensemble de builds personnalisées d’Apache Spark qui incluent des améliorations des performances et des bibliothèques supplémentaires. Ces runtimes facilitent la gestion des tâches telles que le Machine Learning, tout en prenant en charge le traitement et l’analytique généraux des données.
Databricks fournit plusieurs versions d’exécution, notamment les versions de support à long terme (LTS). Chaque version spécifie la version d’Apache Spark sous-jacente, sa date de publication et la date de fin de prise en charge. Au fil du temps, chaque version du runtime suit un cycle de vie :
- Bêta : disponible pour une évaluation anticipée et non recommandée pour une utilisation en production.
- GA (développement de fonctionnalités) – généralement disponible, avec de nouvelles fonctionnalités et correctifs publiés sous le même numéro de version pendant environ six mois.
- Prise en charge à long terme (LTS) : des correctifs majeurs de stabilité et de sécurité sont rétroportés pendant trois ans.
- Fin du support (EoS) : aucun support ni correctif n’est fourni, et la version ne peut plus être sélectionnée lors de la création ou de la mise à jour d’une ressource de calcul.
- Fin de vie (EoL) – retiré et n’est plus utilisable.
Si une mise à jour de maintenance est publiée pour une version d’exécution que vous utilisez, vous pouvez l’appliquer en redémarrant votre cluster.
Travaux Lakeflow
Lakeflow Jobs offrent l’automatisation et l’orchestration des workflows dans Azure Databricks, permettant de planifier, coordonner et exécuter de manière fiable des tâches de traitement des données. Au lieu d’exécuter du code manuellement, vous pouvez utiliser des travaux pour automatiser des charges de travail répétitives ou de niveau production telles que des pipelines ETL, une formation machine learning ou des actualisations de tableau de bord.

Un job dans Databricks est essentiellement un conteneur pour une ou plusieurs tâches. Les tâches définissent le travail à effectuer , par exemple, l’exécution d’un bloc-notes, l’exécution d’un travail Spark, l’appel de code externe, ...
Les travaux peuvent être déclenchés de différentes manières :
- Selon une planification (par exemple, toutes les nuits à minuit).
- En réponse à un événement.
- Manuellement, si nécessaire.
Étant donné qu’elles sont reproductibles et gérées, les tâches sont essentielles pour les charges de production. Ils garantissent que les pipelines de données s’exécutent de manière cohérente, les modèles ML sont formés et déployés de manière contrôlée, et les systèmes en aval reçoivent des données mises à jour et précises.
Lac Delta
Delta Lake est une infrastructure de stockage open source qui améliore la fiabilité et l’extensibilité des lacs de données en ajoutant des fonctionnalités transactionnelles sur le stockage d’objets cloud, comme Azure Data Lake Storage. Les lacs de données traditionnels peuvent souffrir de problèmes tels que des données incohérentes, des écritures partielles ou des difficultés de gestion de l’accès simultané. Delta Lake résout ces problèmes en prenant en charge :
- Transactions ACID (atomicité, cohérence, isolation, durabilité) pour les lectures et écritures fiables.
- Gestion évolutive des métadonnées afin que les tables puissent être mises à l’échelle vers un très grand nombre de fichiers.
- Contrôle de version et restauration des données, activation des requêtes de voyage dans le temps et récupération des états précédents.
- Traitement unifié des lots et du streaming, de sorte que la même table puisse gérer les charges d’ingestion en temps réel et les chargements en lot historique.
En plus de cette base, les tables Delta fournissent une abstraction de table familière qui facilite l’utilisation de données structurées à l’aide de requêtes SQL ou de l’API DataFrame. Les tables delta sont le format de table par défaut dans Azure Databricks, ce qui garantit que les nouvelles données sont stockées avec des garanties transactionnelles par défaut.
Databricks SQL - Outil de requête de base de données
Databricks SQL offre des fonctionnalités d’entreposage de données à Databricks Lakehouse, ce qui permet aux analystes et aux utilisateurs professionnels d’interroger et de visualiser les données stockées dans des formats ouverts directement dans le lac de données. Il prend en charge ANSI SQL. Toute personne familiarisée avec SQL peut exécuter des requêtes, générer des rapports et créer des tableaux de bord sans avoir à apprendre de nouveaux langages ou outils.
Databricks SQL est disponible uniquement dans le niveau Premium d’Azure Databricks. Il inclut :
- Éditeur SQL pour l’écriture et l’exécution de requêtes.
- Tableaux de bord et outils de visualisation pour partager des insights.
- Intégration avec des outils de BI et d'analytique externes.
Entrepôts de données SQL
Toutes les requêtes Databricks SQL s’exécutent sur des entrepôts SQL (anciennement appelés points de terminaison SQL), qui sont des ressources de calcul évolutives découplées du stockage. Différents types d’entrepôts sont disponibles en fonction des performances, des coûts et des besoins de gestion :
Entrepôts SQL sans serveur
- Calcul instantané et élastique avec démarrage rapide et mise à l’échelle automatique.
- Une charge de gestion faible étant donné que Databricks gère la capacité, la mise à jour corrective et l’optimisation.
- Efficacité des coûts en effectuant une mise à l’échelle automatique et en évitant les coûts des ressources inactives.
Entrepôts SQL Pro
- Prend en charge les E/S photon et prédictives, mais pas la gestion intelligente des charges de travail.
- Utiliser quand serverless n’est pas disponible ou lorsque la mise en réseau personnalisée est requise (par exemple, la fédération ou les connexions hybrides/locales).
Entrepôts SQL classiques
- Les ressources de calcul s’exécutent dans votre propre abonnement Azure, et non dans Databricks.
- Prend environ 4 minutes pour démarrer et s'adapte avec moins de réactivité opérationnelle que les solutions sans serveur.
- Prend uniquement en charge Photon ; aucune gestion prédictive des E/S ou des charges de travail intelligentes.
- Utilisez uniquement pour l’exploration interactive de base lorsque serverless ou pro ne sont pas des options.
MLflow
MLflow est une plateforme open source conçue pour gérer le cycle de vie machine learning de bout en bout. Il aide les scientifiques des données et les ingénieurs ML à suivre les expériences, à gérer les modèles et à simplifier le processus de déplacement des modèles du développement à la production. MLflow prend également en charge les flux de travail d’IA génératifs et inclut des outils permettant d’évaluer et d’améliorer les agents IA.