Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
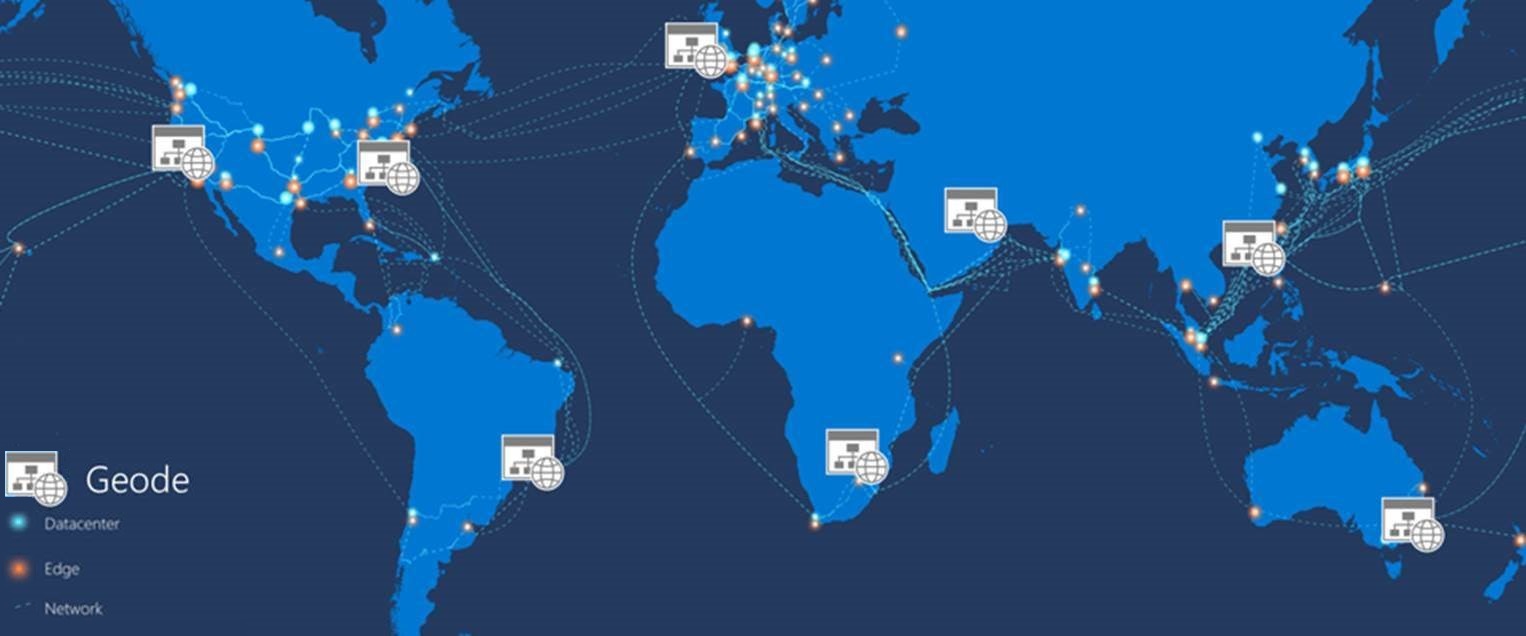
Distribuire una raccolta di servizi back-end in un set di nodigeografici, ognuno dei quali può gestire qualsiasi richiesta da qualsiasi client in qualsiasi area. Questo approccio attivo-attivo distribuisce l'elaborazione delle richieste in tutto il mondo per migliorare la latenza e aumentare la disponibilità.
Contesto e problema
Molti servizi su larga scala affrontano problemi con la disponibilità geografica e la scalabilità. Le architetture classiche spesso portano i dati all'elaborazione archiviando i dati in un server SQL remoto che elabora anche i dati. Si basano sull’aumento della capacità per gestire la crescita.
L'approccio classico potrebbe causare i problemi seguenti:
- Gli utenti in aree distanti possono sperimentare la latenza di rete quando si connettono all'endpoint di hosting.
- I picchi di domanda possono sovraccaricare i servizi in una singola regione.
- La distribuzione di copie dell'infrastruttura dell'applicazione in più regioni per un servizio attivo 24 ore su 24 può aggiungere complessità e costi.
L'infrastruttura cloud supporta il routing globale e la replicazione geografica dei dati. Per ridurre la latenza per una base di utenti distribuita geograficamente, è necessario collocare il calcolo con le repliche regionali dei dati che elabora. Il modello geode porta il calcolo ai dati.
Solution
Distribuire il servizio in più aree geografiche. Ogni deployment è denominato geode. Usare un servizio di routing globale per distribuire le richieste in base ai criteri di routing e ai controlli di integrità. Ogni geode accede a un archivio dati con replica geografica.
Configurare il tier dati in modo che ogni geode possa gestire le stesse operazioni dell'applicazione entro i requisiti di coerenza eventuale del carico di lavoro. I Geodes possono osservare versioni diverse di un elemento mentre è in corso la replica. L'applicazione deve tenere conto del ritardo di replica e delle scritture simultanee, soprattutto quando le richieste si spostano tra i geodes.
Ad esempio, un account Azure Cosmos DB per NoSQL configurato con più aree di scrittura può gestire letture e scritture nella regione di ogni geode. Le scritture multi-area di Azure Cosmos DB replicano i dati in modo asincrono.
In un'architettura delle unità di distribuzione, ogni unità serve un sottoinsieme assegnato di utenti o tenant. In un'architettura geode ogni geode può gestire le stesse operazioni dell'applicazione per qualsiasi utente e può accedere ai dati necessari per tali operazioni. Entrambi i modelli usano più distribuzioni; scegliere tra di essi in base all'idoneità della richiesta e al posizionamento dei dati.
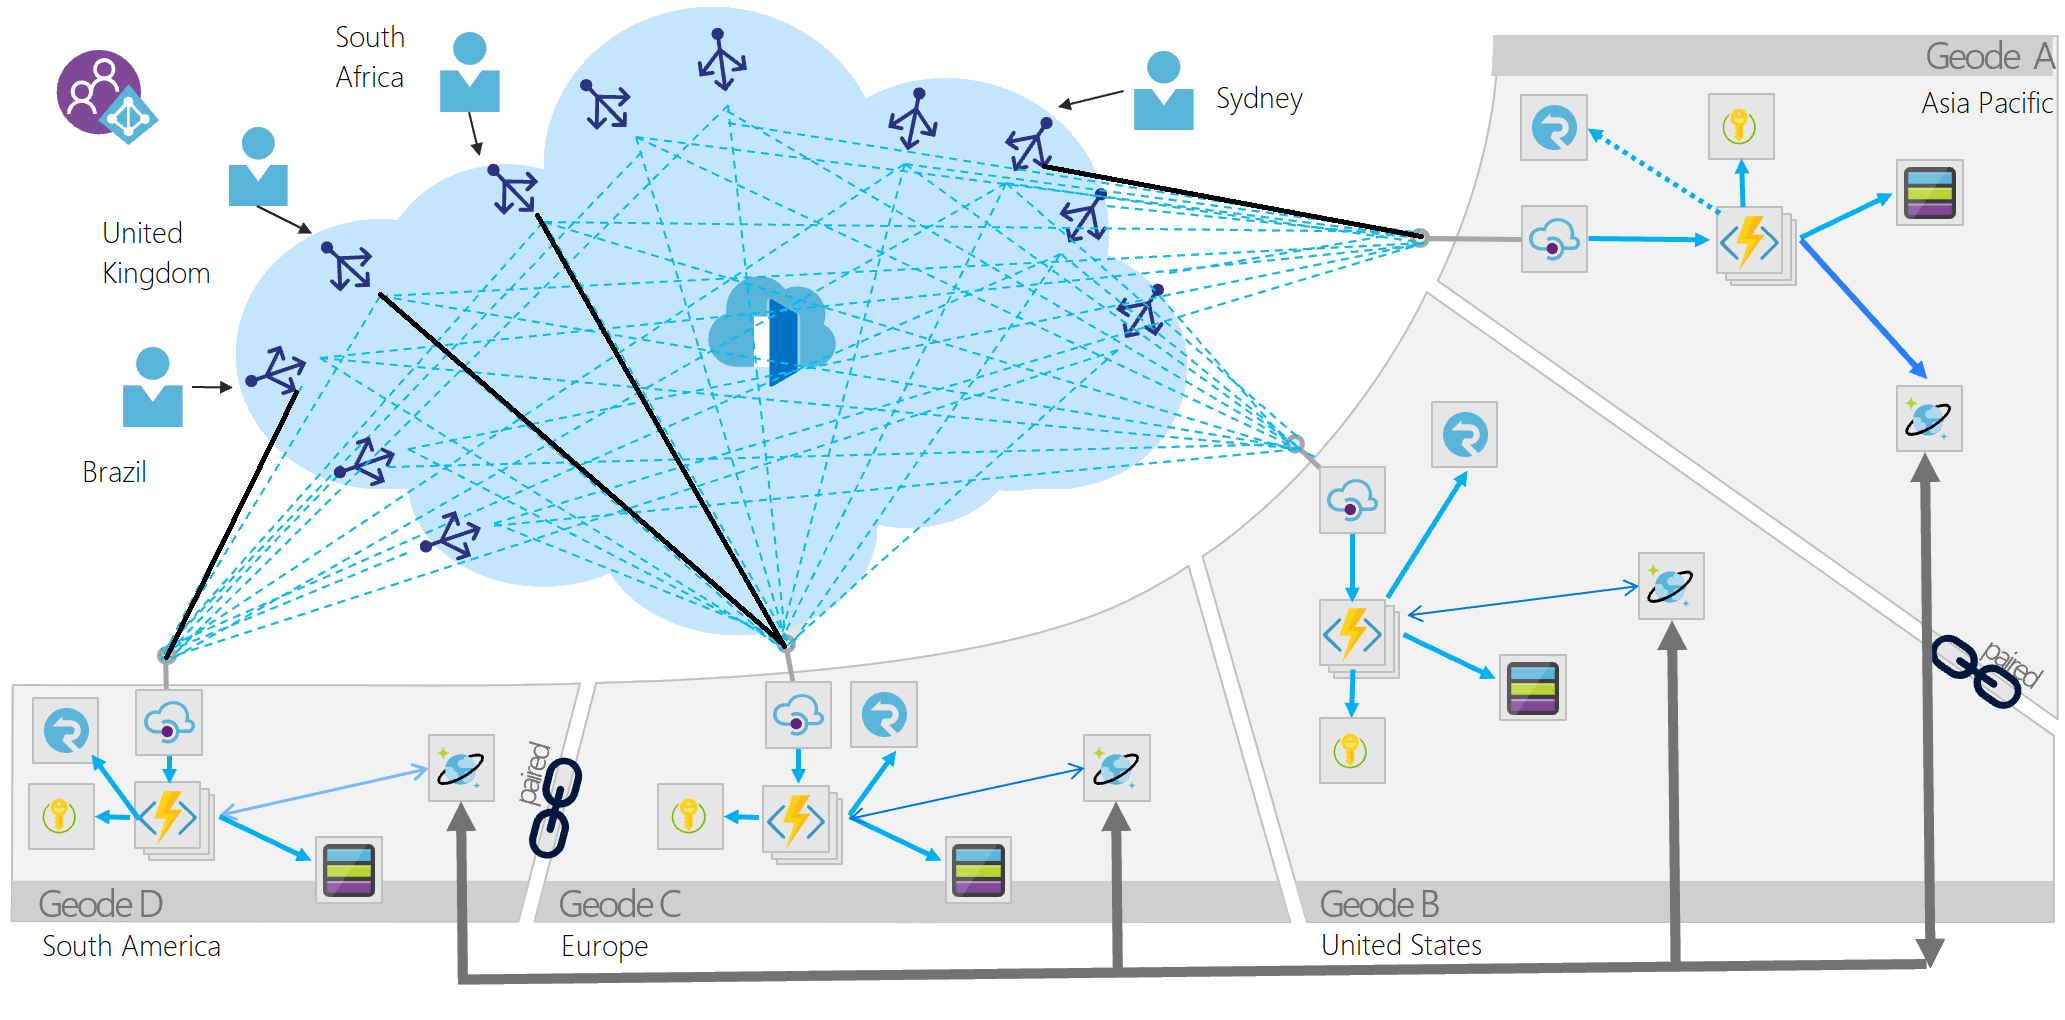
I geodes hanno le caratteristiche seguenti:
- Ogni geode è costituito da una raccolta di tipi di risorse, spesso definiti in un deployment template.
- Ogni geode contiene le risorse dell'area necessarie per gestire le richieste senza dipendere dal livello di applicazione di un altro geode. Il routing condiviso e i servizi dati possono ancora esistere nell'architettura.
- Geodes sono debolmente accoppiati tramite il routing globale e un backplane di replica. Il livello di routing indirizza le richieste ai geodes disponibili e il livello dati replica gli aggiornamenti tra di essi. L'applicazione necessita ancora di un modello di coerenza appropriato e di una strategia di gestione dei conflitti.
Il modello geode si verifica nelle architetture di Big Data che usano hardware standard per elaborare i dati collocati sulla stessa macchina e MapReduce per consolidare i risultati tra i computer. Un altro uso è il near-edge computing, che avvicina il calcolo al margine della rete per ridurre il tempo di risposta.
Scegliere il numero e la posizione dei geodi in base ai guasti regionali che il carico di lavoro deve tollerare. La disponibilità dipende dalle dipendenze condivise integre e dalla capacità di calcolo e database sufficienti nei geodes sopravvissuti per gestire il traffico reindirizzato.
Problemi e considerazioni
Usare le tecniche e le tecnologie seguenti per implementare questo modello:
- Usa pratiche e strumenti DevOps per creare e distribuire geodes identici tra aree o istanze.
- Usare la scalabilità automatica per aumentare le prestazioni di calcolo e il throughput del database all'interno di ogni geode, nel rispetto dei vincoli del backplane condiviso.
- Per un'implementazione dell'API HTTP, Frontdoor di Azure fornisce l'accelerazione del traffico attraverso la rete perimetrale e connessioni TCP suddivise.
- Usare un archivio dati con replica geografica per garantire la coerenza dei dati. Per l'esempio di scrittura in più aree di Cosmos DB, configurare il routing a livello di area dell'SDK in modo che ogni geode legga e scriva nell'area del database locale e possa usare le aree di fallback configurate.
- Prendere in considerazione il compute basato sul consumo per ridurre i costi di capacità inattiva quando il carico si sposta tra geode. Questa strategia potrebbe consentire la distribuzione di molti geodi con un investimento aggiuntivo minimo. I risparmi dipendono dal carico di lavoro e dal piano di hosting.
- Gestione API di Azure è facoltativo. Posizionarlo davanti alla Function App di ogni geode quando sono necessarie funzionalità di gestione API, ad esempio la limitazione della frequenza.
Quando si decide come implementare questo modello, tenere presente quanto segue:
Scegliere un livello di coerenza che soddisfi i requisiti di lettura quando le richieste si spostano tra i geodes.
Con la coerenza di sessione di Azure Cosmos DB, restituire il token di sessione al client e includerlo con le successive richieste di lettura in modo che le garanzie di read-your-writes rimangano valide anche se le richieste vengono instradate a un geode diverso. Negli account di scrittura in più aree usare questi token condivisi solo per le richieste di lettura.
Selezionare un criterio di risoluzione dei conflitti per le scritture simultanee.
Definire le modalità di guasto che il workload deve tollerare, incluse le interruzioni a livello regionale e gli errori delle dipendenze condivise. Dimensiona i geodi rimanenti per il carico di picco reindirizzato.
Testare il failover e il ripristino regionali con carico rappresentativo in un ambiente controllato. Includi i guasti delle dipendenze condivise e il failback.
Scegliere se elaborare i dati in locale in ogni regione o calcolare le aggregazioni in un unico geode e replicare i risultati a livello globale. Il processore del feed di modifiche Azure Cosmos DB offre questo controllo granulare usando il concetto di contenitore di lease e
LeaseContainerPrefixnell'associazione Funzioni di Azure corrispondente. Ogni approccio presenta vantaggi e svantaggi distinti.I geodes possono interagire usando il feed di modifiche Azure Cosmos DB e una piattaforma di comunicazione in tempo reale come SignalR. Possono comunicare con utenti remoti tramite altri geodes in un modello mesh senza conoscere o preoccuparsi delle posizioni di tali utenti.
Tieni traccia dei componenti della stessa richiesta, eseguiti in modo asincrono in istanze o geodes diverse. Monitorare le dipendenze condivise e le risorse regionali in modo da poter identificare i guasti correlati. Sia Frontdoor di Azure che Azure Cosmos DB possono essere integrati con Log Analytics e Funzioni di Azure possono usare Application Insights per il monitoraggio delle applicazioni.
Proteggere i punti di ingresso a ogni livello dell'implementazione distribuita.
- Limitare l'accesso ad Azure Cosmos DB alle app per le funzioni.
- Per le origini dell'app per le funzioni pubbliche dietro Frontdoor di Azure, configurare le restrizioni di accesso che combinano il tag del
AzureFrontDoor.Backendservizio e unX-Azure-FDIDfiltro di intestazione corrispondente all'ID del profilo di Frontdoor di Azure nella stessa regola di autorizzazione. Nega le richieste non corrispondenti.
Mantenere separata l'autenticazione del chiamante API da questi controlli di accesso all'origine.
Assicurarsi che ogni geode possa accedere ai segreti necessari in Key Vault e coordinare il provisioning e la rotazione per i segreti condivisi.
Le prestazioni dipendono dal numero di geodes e dal modello di hosting di calcolo usato per l'API di ogni geode. È necessario valutare la differenza di costo tra l'aggiunta di geodi e l'aumento della capacità di ogni geode.
Usare le risorse con ridondanza della zona ove supportate per ridurre l'effetto dei guasti delle Availability Zone all'interno della regione di ogni geode. Scegliere le aree in base a latenza, residenza dei dati, disponibilità del servizio e requisiti di ripristino.
Usare l'albero delle decisioni di bilanciamento del carico per selezionare un front-end per l'API.
Per Frontdoor configurare la selezione dell'origine in modo che corrisponda alla progettazione attiva-attiva. Assegnare ai geodi attivi contemporaneamente la stessa priorità, quindi configurare la sensibilità alla latenza e i pesi.
Quando usare questo modello
Usare questo modello negli scenari seguenti:
- È necessaria una piattaforma su larga scala per gli utenti distribuiti in un'ampia area geografica.
- Il carico di lavoro deve continuare a gestire le richieste critiche durante le interruzioni a livello di area incluse nel modello di guasto.
Questo modello potrebbe non essere adatto negli scenari seguenti:
- L'architettura limita i dati o gli utenti a deployment specifici, ad esempio per soddisfare i requisiti regionali di residenza dei dati. Prendere in considerazione deployment stamp con routing basato sui dati quando solo alcuni deployment possono servire un determinato utente.
- Il carico di lavoro può soddisfare i requisiti in una singola regione. Prendere in considerazione le distribuzioni con ridondanza della zona, laddove supportate, e valutare separatamente il ripristino di emergenza a livello di area geografica.
- Lo stato della sessione o le dipendenze dei dati dell'applicazione associano le richieste a una regione. Le applicazioni esistenti potrebbero richiedere modifiche alla gestione dello stato, alla replica dei dati e all'automazione del deployment prima che i deployment regionali possano gestire le stesse operazioni.
- I requisiti di disponibilità e latenza non giustificano la distribuzione geografica, ad esempio quando la maggior parte degli utenti e dei dati si trovano in un'area.
Progettazione del carico di lavoro
Un architetto deve valutare come usare il modello Geode nella progettazione del carico di lavoro per soddisfare gli obiettivi e i principi trattati nei pilastri di Azure Well-Architected Framework. Ad esempio:
| Pilastro | Come questo modello supporta gli obiettivi di pilastro |
|---|---|
| Le decisioni di progettazione dell'affidabilità consentono al carico di lavoro di diventare resilienti a malfunzionamenti e di assicurarsi che venga ripristinato in uno stato completamente funzionante dopo che si verifica un errore. | Le distribuzioni regionali e la replica dei dati consentono al carico di lavoro di tollerare una o più interruzioni regionali. - Ridondanza RE:05 - Aree geografiche e zone di disponibilità |
| l'efficienza delle prestazioni consente al carico di lavoro soddisfare in modo efficiente le richieste tramite ottimizzazioni di ridimensionamento, dati e codice. | L'elaborazione locale e l'accesso ai dati possono ridurre la latenza delle richieste per una base utente distribuita. In questo modo si riduce la latenza eliminando il traffico a lunga distanza e perché si condivide l'infrastruttura solo tra gli utenti che attualmente usano lo stesso geode. - PE:03 Selezione dei servizi |
Come per qualsiasi decisione di progettazione, prendere in considerazione eventuali compromessi rispetto agli obiettivi degli altri pilastri che potrebbero essere introdotti con questo modello.
Esempi
Active Directory Domain Services (AD DS) in Windows Server illustra una variante parziale di questo modello. I controller di dominio scrivibili usano la replica multimaster per le partizioni di directory che ospitano. Alcune operazioni richiedono un titolare di ruolo FSMO (Flexible Single Master Operations) designato, pertanto i controller di dominio non sono intercambiabili per ogni operazione.
I servizi di Azure seguenti illustrano l'intercambiabilità geografica delle richieste:
- Azure Cosmos DB for NoSQL: con scritture in più aree abilitate, ogni area configurata contiene tutte le partizioni di dati di un contenitore e può gestire letture e scritture. Queste distribuzioni regionali per l'erogazione dei dati illustrano i geodes per tale account.
- Azure Managed Redis: con la replica geografica attiva, ogni istanza di area collegata può accettare letture e scritture nella stessa cache logica.
- Frontdoor di Azure: ogni punto di presenza di Front Door può soddisfare qualsiasi richiesta. Queste località edge illustrano handler di richieste HTTP intercambiabili a livello geografico.
Passaggio successivo
Esaminare la baseline di AKS per cluster multiregione per indicazioni correlate sul calcolo regionale attivo-attivo e sul routing globale.