Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Database SQL di Microsoft Azure
Istanza gestita di SQL di Azure
Microsoft Fabric
Azure Databricks
Hub eventi di Azure
Questo articolo descrive come usare Precisely Connect per eseguire la migrazione di sistemi mainframe e midrange su Azure. Connect fornisce la replica dei dati in tempo reale da sistemi legacy a Azure usando Change Data Capture (CDC).
Questa soluzione offre la coerenza dei dati tra gli ambienti mainframe locali e Azure riducendo al minimo l'effetto sulle prestazioni del sistema di origine. L'architettura supporta varie origini dati mainframe e midrange e replica i dati verso destinazioni di Azure come il database SQL di Azure, Event Hubs di Azure e Microsoft Fabric.
Apache®, Spark e il logo con la fiamma sono marchi o marchi registrati di Apache Software Foundation negli Stati Uniti e/o in altri Paesi. L'uso di questi marchi non implica alcuna approvazione da parte di Apache Software Foundation.
Architettura
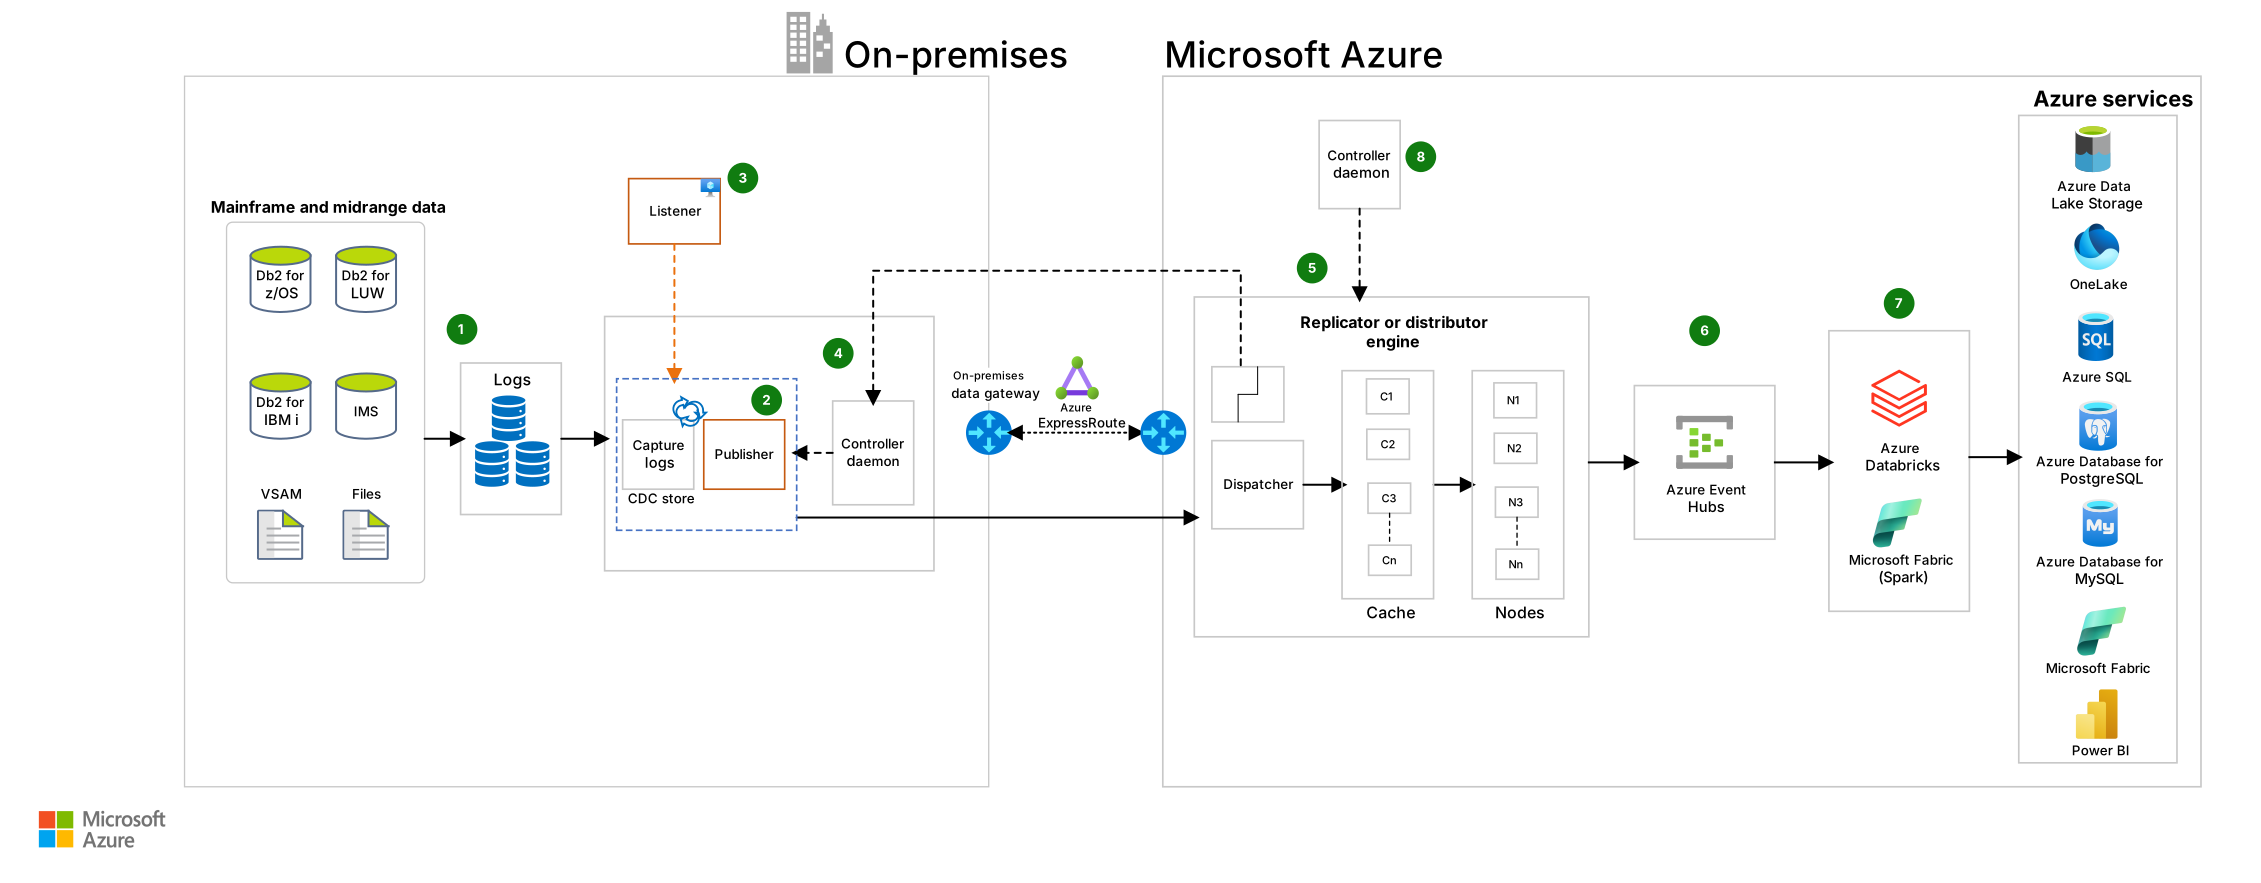
Scaricare un file di Visio di questa architettura.
Flusso di lavoro
Il flusso di lavoro seguente corrisponde al diagramma precedente:
- Un componente agente di Connect acquisisce i log delle modifiche utilizzando le utilità native del mainframe o del midrange e memorizza questi log nella cache dell'archiviazione temporanea.
- Per i sistemi mainframe, un componente di pubblicazione nel mainframe gestisce la migrazione dei dati.
- Per i sistemi midrange, un componente listener gestisce la migrazione dei dati anziché un server di pubblicazione. Il listener si trova in un computer Windows o Linux.
- Il server di pubblicazione o il listener sposta i dati dall'ambiente locale a Azure tramite Azure ExpressRoute. Il publisher o il listener gestisce il commit e il rollback delle transazioni per ciascuna unità di lavoro, mantenendo l'integrità dei dati.
- Il motore connect Replicator acquisisce i dati dal server di pubblicazione o dal listener e lo applica alla destinazione. Distribuisce i dati per l'elaborazione parallela.
- Event Hubs acquisisce le modifiche ai dati in tempo reale da Connect Replicator Engine per l'elaborazione quasi in tempo reale.
- Azure Databricks o Fabric elabora i dati inseriti. I dati elaborati vengono archiviati in destinazioni di Azure come SQL Database, Database di Azure per PostgreSQL - Server flessibile, Azure Data Lake Storage oppure lakehouse e warehouse di Fabric per analisi successive e business intelligence (BI).
- Il daemon del controller Connect autentica la richiesta e stabilisce la connessione socket tra il server di pubblicazione o il listener e il motore di Replicator.
Componenti
Questa architettura usa i componenti seguenti.
Rete e identità
Azure ExpressRoute è un servizio di connettività che estende le reti locali alla piattaforma cloud di Azure tramite una connessione privata da un provider di connettività. In questa architettura ExpressRoute offre una connessione sicura e a larghezza di banda elevata per la replica dei dati mainframe in Azure.
Gateway VPN di Azure è un servizio gateway di rete virtuale che consente di creare gateway di rete virtuale che inviano traffico crittografato tra una rete virtuale di Azure e una posizione locale tramite Internet pubblico. In questa architettura è possibile usare il gateway VPN come alternativa a ExpressRoute per connettere i sistemi mainframe ad Azure quando non è disponibile una connessione privata.
Microsoft Entra ID è un servizio di gestione delle identità e degli accessi che può essere sincronizzato con Active Directory locale. In questa architettura Microsoft Entra ID gestisce l'autenticazione e il controllo di accesso per i componenti connect che accedono alle risorse Azure.
Immagazzinamento
Database di Azure per MySQL è un servizio di database relazionale gestito basato sull'edizione community del motore di database MySQL open source. In questa architettura, il database di Azure per MySQL offre un'opzione di destinazione per i dati mainframe replicati.
Database di Azure per PostgreSQL Flexible Server è un servizio di database relazionale completamente gestito basato sull'edizione della community del motore di database PostgreSQL. In questa architettura, Database di Azure per PostgreSQL - Server flessibile funge da database di destinazione per la replica dei dati mainframe.
Il database SQL di Azure è un motore di database PaaS (Platform as a Service) che fa parte della famiglia SQL di Azure. È progettato per il cloud e offre tutti i vantaggi di un PaaS gestito e sempreverdi. Database SQL offre anche funzionalità automatizzate basate sull'intelligenza artificiale che ottimizzano le prestazioni e la durabilità. Le opzioni di calcolo serverless e di archiviazione Hyperscale ridimensionano automaticamente le risorse su richiesta. In questa architettura il database SQL funge da database di destinazione per la ricezione di dati mainframe replicati tramite connessioni ODBC (Open Database Connectivity) o native database.
Istanza gestita di SQL di Azure è un servizio di database cloud che offre tutti i vantaggi di un PaaS gestito e continuamente aggiornato. Istanza gestita SQL ha una compatibilità quasi completa con il motore di database dell'ultima versione di SQL Server Enterprise Edition. Fornisce anche un'implementazione di rete virtuale nativa che risolve i problemi di sicurezza più comuni. In questa architettura, Istanza gestita di SQL può fungere da destinazione per i dati mainframe che richiedono la compatibilità di SQL Server.
Archiviazione di Azure è una soluzione di archiviazione cloud che include oggetti, file, dischi, code e archiviazione di tabelle. I servizi includono soluzioni di archiviazione ibride e strumenti per il trasferimento, la condivisione e il backup dei dati. In questa architettura, il servizio di archiviazione offre uno spazio di archiviazione scalabile per i dati mainframe replicati e il caching temporaneo.
OneLake è il data lake unificato per Fabric. In questa architettura OneLake funge da risorsa di archiviazione per i dati inseriti da Hub eventi. Usa i collegamenti OneLake per consentire l'accesso zero-copy ai dati archiviati in Data Lake Storage o in un altro archivio cloud senza duplicare i dati.
Fabric è una piattaforma di analisi che unifica lo spostamento dei dati, l'elaborazione dei dati, l'inserimento, la trasformazione, il routing degli eventi in tempo reale e la compilazione di report. In questa architettura, Fabric (lakehouse, warehouse o database SQL all'interno di Fabric) funge da destinazione di archiviazione relazionale per l'analisi e il livello BI.
Analisi e creazione di report
- Power BI è un gruppo di strumenti di analisi aziendale che possono fornire informazioni dettagliate in tutta l'organizzazione. Power BI può connettersi a centinaia di origini dati, semplificare la preparazione dei dati e guidare l'analisi non pianificata. In questa architettura, il Power BI offre funzionalità BI per analizzare i dati mainframe replicati. Power BI è integrato in modo nativo con Fabric per l'analisi unificata.
Monitoraggio
- Monitoraggio di Azure è un servizio di monitoraggio che offre una soluzione per la raccolta, l'analisi e l'esecuzione dei dati di telemetria dagli ambienti cloud e locali. Le funzionalità includono Application Insights, log di Monitoraggio di Azure e Log Analytics. In questa architettura, Monitoraggio di Azure fornisce monitoraggio e osservabilità per i servizi Azure e i database Azure usati come destinazioni per i dati mainframe replicati.
Integrazione dei dati
Azure Databricks è una piattaforma di analisi unificata basata su Spark che si integra con librerie open source. Offre un'area di lavoro collaborativa per l'esecuzione di carichi di lavoro di analisi. È possibile usare Python, Scala, R e linguaggi SQL per compilare pipeline di estrazione, trasformazione e caricamento (ETL) e orchestrare i processi. In questa architettura Azure Databricks elabora e trasforma i dati mainframe replicati per l'utilizzo da parte dei servizi della piattaforma dati di Azure.
Fabric è una piattaforma di analisi end-to-end basata sull'intelligenza artificiale che opera su una piattaforma di calcolo Spark gestita. In questa architettura, Fabric Spark elabora e trasforma i dati mainframe replicati per renderli pronti per l'uso da parte della piattaforma dati a valle di Azure e dei servizi Fabric.
Hub eventi è un servizio di inserimento dati in tempo reale che può elaborare milioni di eventi al secondo. È possibile inserire dati da più origini e usarli per l'analisi in tempo reale e ridimensionare Hub eventi in base al volume di dati. In questa architettura, Connect Replicator Engine invia i dati relativi alle modifiche in tempo reale da Connect a Event Hubs, che li acquisisce per l'elaborazione e l'analisi quasi in tempo reale.
Precisely Connect è una piattaforma di integrazione dei dati in grado di integrare dati da più fonti e fornire la replica in tempo reale su Azure. È possibile usarlo per replicare i dati senza apportare modifiche all'applicazione. La connessione può anche migliorare le prestazioni dei processi ETL. In questa architettura, Connect funge da motore di replica dati primario che acquisisce ed esegue la migrazione dei dati mainframe a Azure in tempo reale. È possibile eseguirne il provisioning dal Azure Marketplace.
Dettagli dello scenario
È possibile usare varie strategie per eseguire la migrazione di sistemi mainframe e midrange in Azure. La migrazione dei dati svolge un ruolo chiave in questo processo. Le organizzazioni in genere iniziano con una migrazione iniziale dei dati in blocco da sistemi mainframe o midrange alla piattaforma dati Azure. Dopo la migrazione iniziale, in un'architettura cloud ibrida, è necessario stabilire la replica dei dati in corso tra sistemi mainframe o midrange e la piattaforma dati Azure per mantenere sincronizzati i dati. Per mantenere l'integrità dei dati, è necessaria la replica in tempo reale per le applicazioni business critical. La connessione può supportare la migrazione batch iniziale e la replica a lungo termine. Usare CDC per le modifiche in tempo reale o l'inserimento in batch per trasferimenti periodici.
Precisely Connect supporta le seguenti fonti di dati mainframe e midrange:
- Db2 per z/OS
- Db2 per Linux, UNIX e Windows (LUW)
- Db2 per i (AS/400)
- IBM Information Management System (IMS)
- Metodo di accesso alle risorse di archiviazione virtuale IBM (VSAM)
- File e copioni
Connect converte i dati in un formato utilizzabile e li trasmette in Event Hubs per l'acquisizione a bassa latenza. Azure Databricks o Fabric elaborano quindi i dati acquisiti in quasi tempo reale per il consumo a valle e l'archiviazione nelle destinazioni di Azure. Queste destinazioni includono SQL Database, Database di Azure per PostgreSQL Flexible Server, Database di Azure per MySQL Flexible Server, Data Lake Storage e Fabric (Fabric lakehouses, Fabric warehouses o database SQL in Fabric). Nel complesso, questa pipeline end-to-end, dall'acquisizione tramite CDC all'ingestione in Event Hubs fino all'elaborazione in Databricks o Fabric, rende i dati disponibili quasi in tempo reale per i carichi di lavoro di analisi e operativi. Precisely Connect supporta anche la scalabilità in base al volume di dati e ai requisiti dei clienti. Replica i dati senza influire sulle prestazioni o sovraccaricare la rete.
Potenziali casi d'uso
- Replica dei dati da origini dati mainframe e midrange alla piattaforma dati di Azure
- In un'architettura cloud ibrida, la sincronizzazione dei dati tra sistemi mainframe o midrange e la piattaforma dati di Azure
- Analisi quasi in tempo reale in Azure, in base ai dati operativi dei sistemi mainframe o midrange
- Migrazione dei dati da sistemi mainframe o midrange a Azure senza richiedere modifiche alle applicazioni di origine
Considerazioni
Queste considerazioni implementano i pilastri di Azure Well-Architected Framework, che è un set di principi guida che possono essere usati per migliorare la qualità di un carico di lavoro. Per altre informazioni, vedere Well-Architected Framework.
Affidabilità
L'affidabilità garantisce che l'applicazione possa soddisfare gli impegni assunti dai clienti. Per altre informazioni, vedere Elenco di controllo per la revisione della progettazione per l'affidabilità.
Usare Monitoraggio di Azure per monitorare l'integrità e le prestazioni di Hub eventi, Azure Databricks e database di destinazione Azure. Usa l'hub di monitoraggio in Fabric per monitorare i processi di Fabric. Configurare gli avvisi per abilitare la gestione proattiva durante la migrazione iniziale dei dati e la replica quasi in tempo reale in corso.
Ottimizzazione costi
L'ottimizzazione dei costi è incentrata sui modi per ridurre le spese non necessarie e migliorare l'efficienza operativa. Per altre informazioni, vedere Elenco di controllo per la revisione della progettazione per l'ottimizzazione dei costi.
- La replica dei dati in Azure ed elaborazione nei servizi Azure può essere meno costosa rispetto alla gestione dei dati in un sistema mainframe.
- Usare la visualizzazione analisi dei costi in Gestione costi per analizzare la spesa. Per un punto di partenza, vedere la stima preconfigurata nel calcolatore prezzi Azure. Modificarlo in modo che corrisponda al carico di lavoro.
- Per ottimizzare i costi, è possibile usare Azure Databricks per ridimensionare il cluster tramite la scalabilità automatica. Questo approccio può essere meno costoso rispetto a una configurazione fissa.
- Azure Advisor fornisce raccomandazioni per ottimizzare le prestazioni e la gestione dei costi.
Efficienza delle prestazioni
L'efficienza delle prestazioni si riferisce alla capacità del carico di lavoro di ridimensionarsi per soddisfare in modo efficiente le esigenze degli utenti. Per ulteriori informazioni, vedere Checklist per la revisione del design sull'efficienza delle prestazioni.
- Precisely Connect può scalare in base al volume dei dati e ottimizzare la replicazione dei dati.
- Il motore connect replicator può distribuire i dati per l'elaborazione parallela. È possibile bilanciare la distribuzione in base all'inserimento di carichi di lavoro.
- Un Serverless SQL Database può scalare automaticamente in relazione al volume dei carichi di lavoro.
- Gli Event Hubs possono essere scalati in base alle unità di throughput e al numero di partizioni. Determinare il numero di partizioni in base alla velocità effettiva massima prevista del carico di lavoro CDC.
Collaboratori
Microsoft gestisce questo articolo. I collaboratori seguenti hanno scritto questo articolo.
Autore principale:
- Seetharaman Sankaran | Senior Engineering Architect
Altro collaboratore:
- Gyani Sinha | Senior Solution Engineer
Per visualizzare i profili LinkedIn non pubblici, accedere a LinkedIn.
Passaggi successivi
- CDC con Precisely Connect
- Che cos'è ExpressRoute?
- Che cos'è un gateway VPN?
- Che cos'è il database SQL?