Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Le feature table possono essere servite in due modi:
- Distribuzione del modello: Distribuire un modello addestrato su feature table. Lo stesso endpoint viene utilizzato sia per la ricerca delle caratteristiche che per l'inferenza del modello. L'endpoint cerca o calcola automaticamente i valori delle caratteristiche, utilizzando il lineage tracciato quando il modello è stato registrato. Usare questa opzione per gestire le stime del modello.
-
Feature Serving: Distribuisci un
FeatureSpecche fa riferimento direttamente alle tabelle delle feature, senza un modello. L'endpoint restituisce gli output delle funzionalità richiesti. Usare questa opzione quando un'applicazione richiede valori di funzionalità anziché stime del modello. Se alla fine usi funzionalità per l'inferenza dei modelli, Databricks consiglia di utilizzare direttamente il model serving.
Entrambi gli approcci supportano funzionalità precomputate e on-demand.
Requisiti
- Databricks Runtime 14.2 ML o versione successiva.
- Per usare l'API Python, Feature Serving richiede
databricks-feature-engineeringversione 0.1.2 o successiva, integrata in Databricks Runtime 14.2 ML. Per le versioni precedenti di Databricks Runtime ML, installare manualmente la versione richiesta usando%pip install databricks-feature-engineering>=0.1.2. Se si usa un notebook di Databricks, è necessario riavviare il kernel Python eseguendo questo comando in una nuova cella:dbutils.library.restartPython(). - Per usare Databricks SDK, Feature Serving richiede la versione
databricks-sdk0.18.0 o successiva. Per installare manualmente la versione richiesta, usare%pip install databricks-sdk>=0.18.0. Se si usa un notebook di Databricks, è necessario riavviare il kernel Python eseguendo questo comando in una nuova cella:dbutils.library.restartPython().
Databricks Feature Serving offre un'interfaccia utente e diverse opzioni a livello di codice per la creazione, l'aggiornamento, l'esecuzione di query e l'eliminazione di endpoint. Questo articolo include istruzioni per ognuna delle opzioni seguenti:
- Interfaccia utente Databricks
- REST API (Interfaccia di Programmazione delle Applicazioni REST)
- API Python
- SDK Databricks
Per usare l'API REST o MLflow Deployments SDK, è necessario disporre di un token API databricks.
Importante
Come procedura consigliata per la sicurezza per gli scenari di produzione, Databricks consiglia di usare token OAuth da computer a computer per l'autenticazione durante l'ambiente di produzione.
Per il test e lo sviluppo, Databricks consiglia di usare un token di accesso personale appartenente alle entità servizio anziché agli utenti dell'area di lavoro. Per creare token per le entità servizio, vedere Gestire i token per un'entità servizio.
Autenticazione per la gestione delle funzionalità
Per informazioni sull'autenticazione, vedere Autorizzare l'accesso alle risorse Azure Databricks.
Crea un FeatureSpec
Un FeatureSpec è un set definito dall'utente di funzionalità e funzioni. È possibile combinare funzionalità e funzioni in un oggetto FeatureSpec.
FeatureSpecs vengono archiviati e gestiti dal Catalogo Unity e visualizzati in Esplora Cataloghi.
Le tabelle specificate in un FeatureSpec devono essere pubblicate in un feature store online o in uno store online di terze parti. Consultare il Feature Store online di Databricks.
È necessario usare il pacchetto databricks-feature-engineering per creare un oggetto FeatureSpec.
Prima di tutto, definire la funzione :
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
È quindi possibile usare la funzione in un FeatureSpecoggetto :
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Specificare i valori predefiniti
Per specificare i valori predefiniti per le funzionalità, usare il default_values parametro in FeatureLookup. Vedere l'esempio seguente:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Se le colonne di funzionalità vengono rinominate usando il rename_outputs parametro , default_values è necessario usare i nomi delle funzionalità rinominati.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Aggiungi dipendenze da Python
Se una funzione definita dall'utente (UDF) importa pacchetti Python, dichiarali quando crei il FeatureSpecfile . Il parametro extra_pip_requirements richiede databricks-feature-engineering la versione 0.17.0 o superiore. Feature Serving installa automaticamente i pacchetti MLflow e databricks-feature-lookup.
Ad esempio, se una UDF nella tua specifica di caratteristica importa NumPy, aggiungi il requisito alla specifica:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Utilizza main.default.customer_features_with_dependencies come nome della specifica durante la creazione dell'endpoint.
Ogni voce in extra_pip_requirements deve essere una stringa di requisiti PyPI, come numpy==1.26.4, oppure un percorso verso un .whl file in un volume del Catalogo Unity. Ad esempio, usa /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl per un volante che hai caricato. Il creatore dell'endpoint deve disporre di READ VOLUME nel volume e di USE CATALOG e USE SCHEMA nel catalogo e nello schema padre.
Per i pacchetti provenienti da un repository privato, configura il repository di default di Workspace. Non inserire opzioni di comando pip, come --index-url, in extra_pip_requirements.
Le dipendenze nella clausola ENVIRONMENT di una UDF di Unity Catalog si applicano all'esecuzione SQL offline. Feature Serving non le copia automaticamente. Dichiarate ogni pacchetto necessario per le UDF, comprese le UDF delle funzionalità upstream, nei requisiti della specifica della funzionalità.
Se la distribuzione dell'endpoint non riesce, controlla i log di compilazione per individuare errori di installazione dei pacchetti, conflitti di versione o errori di accesso ai file wheel. Vedere Monitorare la qualità del modello e l'integrità degli endpoint.
Per un esempio con CustomUDF e FeatureViewSource, vedi Serve le caratteristiche CustomUDF e le loro dipendenze. Per le dipendenze di servizio modello, vedi Dipendenze UDF personalizzate.
Creare un endpoint
FeatureSpec definisce l'endpoint. Per altre informazioni, vedere Creare endpoint di gestione di modelli personalizzati, la documentazione dell'API Python o la documentazione Databricks SDK per informazioni dettagliate.
Nota
Per i carichi di lavoro sensibili alla latenza o che richiedono un alto numero di query al secondo, Model Serving offre l'ottimizzazione della route sugli endpoint di servizio personalizzati, vedere Ottimizzazione della route sugli endpoint di servizio.
SDK Databricks - Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
API Python
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST API (Interfaccia di Programmazione delle Applicazioni REST)
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Per visualizzare l'endpoint, fare clic su Serve nella barra laterale sinistra dell'interfaccia utente di Databricks. Quando lo stato è Pronto, l'endpoint è pronto per rispondere alle query. Per altre informazioni sulla gestione dei modelli, vedere Model Serving.
Salvare il dataframe aumentato nella tabella di inferenza
Per gli endpoint creati a partire da febbraio 2025, è possibile configurare l'endpoint di gestione del modello per registrare il dataframe aumentato che contiene i valori delle funzionalità ricercati e i valori restituiti dalla funzione. Il dataframe viene salvato nella tabella di inferenza per il modello servito.
Per istruzioni sull'impostazione di questa configurazione, vedere Log feature lookup DataFrames to inference tables.
Per informazioni sulle tabelle di inferenza, vedi Richieste di log e risposte per servire endpoint (legacy).
Ottenere un endpoint
È possibile usare Databricks SDK o l'API Python per ottenere i metadati e lo stato di un endpoint.
SDK Databricks - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
API Python
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Ottenere lo schema di un endpoint
È possibile usare Databricks SDK o l'API REST per ottenere lo schema di un endpoint. Per ulteriori informazioni sullo schema dell'endpoint, consultare Ottenere uno schema dell'endpoint di servizio di un modello.
SDK Databricks - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
REST API (Interfaccia di Programmazione delle Applicazioni REST)
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Eseguire una query su un endpoint
È possibile usare l'API REST, MLflow Deployments SDK o l'interfaccia utente di gestione per eseguire query su un endpoint.
Il codice seguente illustra come configurare le credenziali e creare il client quando si usa MLflow Deployments SDK.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Nota
Come procedura consigliata per la sicurezza, quando si esegue l'autenticazione con strumenti automatizzati, sistemi, script e app, Databricks consiglia di usare token di accesso personali appartenenti alle entità servizio anziché agli utenti dell'area di lavoro. Per creare token per le entità servizio, vedere Gestire i token per un'entità servizio.
Interrogare un endpoint usando le API
Questa sezione include esempi di esecuzione di query su un endpoint usando l'API REST o MLflow Deployments SDK.
SDK delle distribuzioni di MLflow
Importante
L'esempio seguente usa l'API predict() di MLflow Deployments SDK. Questa API è Sperimentale e la definizione dell'API potrebbe cambiare.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST API (Interfaccia di Programmazione delle Applicazioni REST)
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Eseguire query su un endpoint usando l'interfaccia utente
È possibile eseguire una query su un endpoint di servizio direttamente dall'interfaccia utente Di servizio. L'interfaccia utente include esempi di codice generati che è possibile usare per eseguire query sull'endpoint.
Nella barra laterale sinistra dell'area di lavoro Azure Databricks fare clic su Serving.
Fare clic sull'endpoint su cui eseguire la query.
In alto a destra dello schermo, fai clic su Query endpoint.
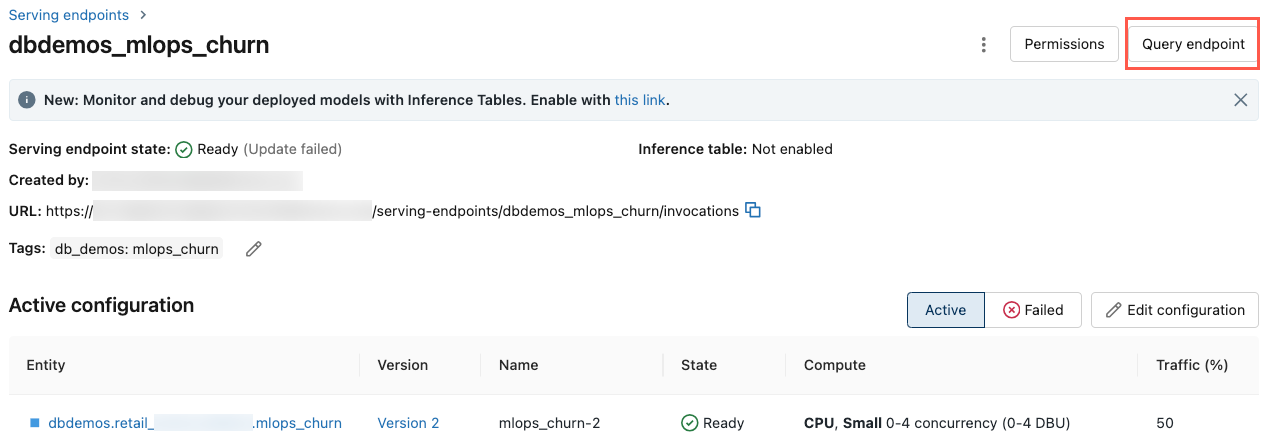
Nella casella Richiesta digitare il corpo della richiesta in formato JSON.
Fare clic su Invia richiesta.
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
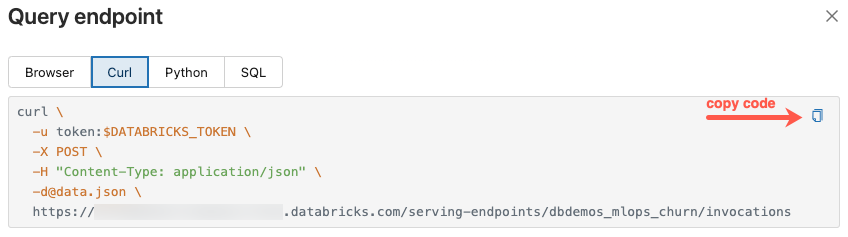
La finestra di dialogo EndpointQuery include codice di esempio generato in curl, Python e SQL. Fare clic sulle schede per visualizzare e copiare il codice di esempio.

Per copiare il codice, fare clic sull'icona di copia in alto a destra della casella di testo.
Aggiornare un endpoint
Importante
Per modificare la configurazione di un endpoint di distribuzione delle funzionalità (ad esempio, modificare le dimensioni del workload o altre configurazioni), usare sempre le API di aggiornamento descritte in questa sezione. Non eliminare e ricreare l'endpoint per applicare le modifiche. L'eliminazione di un endpoint attivo provoca un'interruzione immediata e interrompe tutte le applicazioni che lo interrogano.
È possibile aggiornare un endpoint usando l'API REST, Databricks SDK o l'interfaccia utente di gestione.
Aggiornare un endpoint usando le API
SDK Databricks - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST API (Interfaccia di Programmazione delle Applicazioni REST)
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Aggiornare un endpoint usando l'interfaccia utente
Per usare l’interfaccia utente di servizio, seguire questa procedura:
- Nella barra laterale sinistra dell'area di lavoro Azure Databricks fare clic su Serving.
- Nella tabella fare clic sul nome dell'endpoint da aggiornare. Viene visualizzata la schermata dell'endpoint.
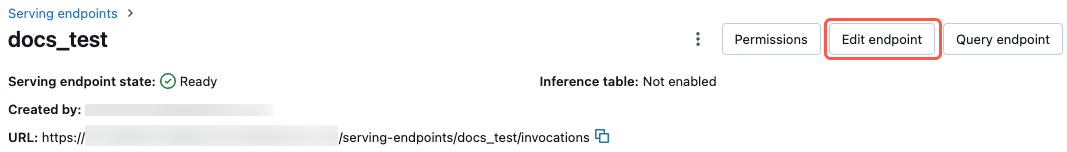
- In alto a destra della schermata fare clic su Modifica endpoint.
- Nella finestra di dialogo Modifica endpoint di gestione modificare le impostazioni dell'endpoint in base alle esigenze.
- Fare clic su Aggiorna per salvare le modifiche.
Aggiorna le dipendenze di un endpoint live di Feature Serving
Un endpoint Feature Serving risolve le sue dipendenze quando viene creato e distribuito per la prima volta: i privilegi di cui il suo service principal ha bisogno per leggere la tabella online (USE CATALOG, SELECT, e EXECUTE), e FeatureSpec sulla funzione UDF di Unity Catalog descritta nel suo USE SCHEMA. L'endpoint imposta questi permessi durante la compilazione e non li risolve nuovamente con un semplice redeploy o riavvio. Se ricrei la tabella online o l'UDF, l'endpoint perde il permesso su di essa. Se aggiorni l'UDF sovrascrivendola, l'endpoint continua a eseguire la versione originale. Le ricerche di funzionalità possono fallire o usare silenziosamente la vecchia logica UDF, anche mentre l'endpoint continua a segnalare Ready.
Per tabelle online e UDF on-demand, Databricks raccomanda una migrazione versionata: creare una nuova versione della dipendenza, creare un nuovo endpoint basato su di essa e migrare il traffico verso il nuovo endpoint. Questo ti aiuta a evitare i tempi di inattività e le modalità di guasto descritte in questa sezione.
Ricrea una tabella online
Avviso
Non cancellare e ricreare una tabella online sotto un endpoint live di Feature Serving.
Quando crei un endpoint, Model Serving concede il service principal dell'endpoint USE CATALOG sul catalogo della tabella online, USE SCHEMA sul suo schema e SELECT sulla tabella online. Eliminare e ricreare la tabella, anche con lo stesso nome, crea un nuovo securable nel Catalogo Unity, così il SELECT grant non viene trasferito. Il service principal perde l'accesso alla tabella, il minting dei token OAuth fallisce e la connessione allo store online torna all'autenticazione tramite password e fallisce. Le ricerche di funzionalità falliscono quindi con errori come KeyError: 'OAUTH_TOKEN' o password authentication failed.
Questi fallimenti sono facili da ignorare: l'endpoint segnala ancora Pronto e la pipeline di sincronizzazione mostra ancora le esecuzioni riuscite, mentre le ricerche falliscono. Cambiare la modalità di sincronizzazione di una tabella online (ad esempio, tra CONTINUOUS e SNAPSHOT) non può essere effettuata sul posto e richiede di ricreare la tabella, il che può scatenare anche questo problema.
Un endpoint non legge una tabella online specifica. Cerca le feature attraverso la tabella offline indicata nel suo FeatureSpec, e quando una feature table viene pubblicata su più di una tabella online, l'endpoint utilizza quella più vecchia. Pubblicare la stessa feature table su una seconda tabella online non riassegna un endpoint alla nuova tabella online. Vedi le limitazioni del Feature Store online.
Per minimizzare i tempi di inattività, versiona la tabella delle caratteristiche offline così come quella online:
- Crea una nuova tabella delle caratteristiche offline e includi la versione nel nome (ad esempio,
customer_features_v2). - Pubblica la nuova tabella delle funzionalità su una nuova tabella online. Vedi Pubblica una tabella delle caratteristiche.
- Crea un nuovo
FeatureSpecendpoint che utilizzi la nuova feature table, e crea un nuovo endpoint Feature Serving che lo serve. - Migra il traffico al nuovo endpoint. Quando il vecchio endpoint non riceve più traffico, eliminalo insieme alla sua tabella online.
Aggiorna un UDF on-demand
Avviso
Non modificare un UDF del Catalogo Unity usato da un FeatureSpec in-place.
L'UDF on-demand di FeatureSpec è integrato nell'endpoint di servizio al momento del deployment. Un semplice refresh o redeploy riutilizza lo stesso UDF in quell'immagine di servizio. Un aggiornamento in loco dell'UDF con lo stesso nome non ha effetto. Se si elimina e si ricrea l'UDF, anche l'endpoint perde EXECUTE su di esso, quindi le ricerche che usano l'UDF falliscono.
FeatureSpec e UDF non hanno un campo versione, quindi la versione va gestita per nome: crea un nuovo UDF e un nuovo FeatureSpec, crea un nuovo endpoint che utilizza il nuovo FeatureSpec e migra il traffico verso di esso. Consulta Creare un FeatureSpec.
Vedi Calcolo delle caratteristiche on-demand.
Recupera un endpoint dopo una modifica in loco
Se hai già modificato una dipendenza sul posto, ricostruisci l'endpoint in modo che risolva nuovamente le sue dipendenze. Crea un nuovo FeatureSpec endpoint (o, per un endpoint Model Servecing, registra una nuova versione del modello) e aggiorna l'endpoint per servirlo. Cambiare il contenuto esposto dall'endpoint ricostruisce l'endpoint, che fornisce una nuova entità servizio e riavvia la configurazione dei permessi. Nessuna di queste operazioni ricostruisce affidabilmente l'endpoint: fermarlo e avviarlo, un semplice redeploy o cambiare una variabile ambientale.
Eliminare un endpoint
Avviso
Questa azione è irreversibile. L'eliminazione di un endpoint Feature Serving causa interruzioni immediate per tutte le applicazioni che effettuano query su di esso. Se si vuole modificare la configurazione dell'endpoint, usare Aggiornare un endpoint anziché eliminare e ricreare l'endpoint.
È possibile eliminare un endpoint usando l'API REST, Databricks SDK, l'API Python o l'interfaccia utente di gestione.
Eliminare un endpoint usando le API
SDK Databricks - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
API Python
fe.delete_feature_serving_endpoint(name="customer-features")
REST API (Interfaccia di Programmazione delle Applicazioni REST)
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
Eliminare un endpoint usando l'interfaccia utente
Seguire questa procedura per eliminare un endpoint usando l'interfaccia utente di gestione:
- Nella barra laterale sinistra dell'area di lavoro Azure Databricks fare clic su Serving.
- Nella tabella fare clic sul nome dell'endpoint da eliminare. Viene visualizzata la schermata dell'endpoint.
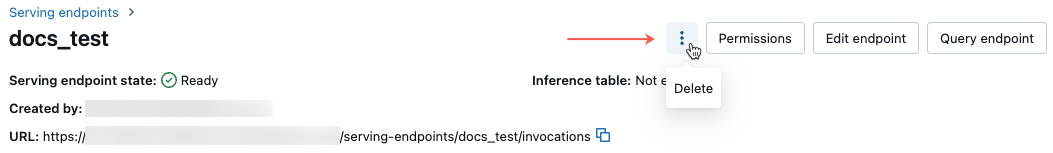
- Nell'angolo in alto a destra dello schermo, fare clic
 e selezionare Elimina.
Monitorare l'integrità di un endpoint
Per informazioni sui log e le metriche disponibili per gli endpoint di gestione delle funzionalità, vedere Monitorare la qualità del modello e l'integrità degli endpoint.
Controllo di accesso
Per informazioni sulle autorizzazioni per gli endpoint di gestione delle funzionalità, vedere Gestire le autorizzazioni per un endpoint di gestione del modello.
Notebook di esempio
Questo notebook illustra come usare Databricks SDK per creare un endpoint di gestione delle funzionalità usando Databricks Online Feature Store.