Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Questa pagina spiega il throughput riservato e provisionato per le API del Foundation Model: cos'è, quando usarlo, come dimensionare una prenotazione e come creare e gestire un endpoint che lo utilizzi.
Che cos'è il throughput con provisioning riservato?
La capacità provisionata riservata è un'opzione di capacità per le API di Azure Databricks Foundation Model. Invece di utilizzare un'offerta per token, che si basa su un pool condiviso di capacità, si riserva una quantità fissa di capacità dedicata per una durata determinata. Misuri quella capacità in unità modello, e Azure Databricks la trattiene per te per tutta la durata della prenotazione.
Poiché la capacità è dedicata e riservata in anticipo, la velocità di trasmissione e la latenza rimangono costanti per quella capacità anche quando la domanda complessiva di pay-per-token condiviso è elevata. Il traffico superiore alla tua capacità riservata è soggetto a limitazione della velocità, non servito automaticamente con pay-per-token. Per inviare quell'overflow al pay-per-token invece di rifiutarlo, configura un fallback sul servizio modello davanti al tuo endpoint. Consulta Gestire il traffico oltre la tua capacità riservata.
Quando utilizzare il throughput con provisioning riservato
Il throughput riservato con provisioning è progettato per carichi di lavoro che necessitano di capacità affidabile piuttosto che di accesso non garantito a un pool condiviso. Databricks lo consiglia quando:
- Stai eseguendo un'applicazione o un agente mission-critical, dove una funzionalità in produzione dipende dal modello e non può competere con altro traffico per la capacità condivisa.
- Hai bisogno di una disponibilità e di un uptime più costanti rispetto al pay-per-token condiviso, quindi una forte domanda sul pool condiviso ha meno impatto sul tuo throughput.
- Stai scalando verso volumi elevati o sostenuti di traffico prevedibile, e stai raggiungendo vincoli di capacità o limiti di tasso sul pay-per-token o sul pay-per-token prioritario.
Se il tuo traffico è esplorativo o a basso volume, vedi pay-per-token o pay-per-token prioritario.
Modelli supportati
La velocità di throughput riservata è disponibile sui modelli di fondazione supportati. Azure Databricks seleziona l'idoneità per modello, e il flow di creazione mostra solo i modelli che puoi riservare.
La capacità provisionata riservata è disponibile per i seguenti modelli:
| Provider | Model | Nome del punto finale |
|---|---|---|
| Zhipu AI | GLM 5.3 | databricks-glm-5-3 |
| Zhipu AI | GLM 5.3 Flash | databricks-glm-5-3-flash |
| Zhipu AI | GLM 5.2 (legacy) | databricks-glm-5-2 |
| Moonshot Intelligenza Artificiale | Kimi K3 | databricks-kimi-k3 |
| DeepSeek | DeepSeek V4.1 Flash | databricks-deepseek-v4-1-flash |
| Alibaba Cloud | Qwen3.5 122B A10B | databricks-qwen35-122b-a10b |
Note
Qwen3.5 122B A10B è in Anteprima Pubblica. Contatta il team account Databricks per l'abilitazione.
Come funziona il throughput allocato con provisioning
Riservi la capacità nelle unità di modello. Un'unità modello è un'unità di throughput provisionato che determina quanto lavoro il tuo endpoint può gestire per minuto. Più unità modello significa più throughput riservato per te. Riservi le unità modello a incrementi di 50, partendo da almeno 50.
Crei una riserva scegliendo quante unità modello riservare e per quanto tempo (la durata). Azure Databricks fornisce quella capacità dedicata per l'intero periodo. un endpoint può contenere più di una prenotazione contemporaneamente e la sua capacità totale riservata è la somma delle unità modello nelle sue prenotazioni attive.
I seguenti termini descrivono le parti di un endpoint a throughput riservato e provisionato:
| Termine | Che cosa significa |
|---|---|
| Unità modello | L'unità della capacità assegnata. Più unità modello significano più throughput riservato. Usa lo stimatore delle unità del modello per dimensionare il tuo pool rispetto al traffico previsto. |
| Reservation | Un'assegnazione prepagata di unità del modello e un periodo per un endpoint. Un endpoint può contenere più prenotazioni contemporaneamente, ciascuna con le proprie unità modello e la data di scadenza del termine. |
| Termine | La durata di una prenotazione: 1 mese o 3 mesi. Un termine più lungo comporta una tariffa per unità inferiore. |
| Coverage | Il totale delle unità di modello a cui ammontano le prenotazioni attive del tuo endpoint. |
| Risoluzione alternativa | Una destinazione di backup che configuri sul servizio di modello per il traffico oltre la tua copertura. Azure Databricks non indirizza automaticamente il traffico verso il modello pay-per-token. Senza un piano B, il traffico superiore alla tua copertura è soggetto a limitazione della velocità. Consulta Gestire il traffico oltre la tua capacità riservata. |
Decidi quanto riservare
Dipende da te quante unità di modello riservi. Puoi mettere tutto il carico di lavoro su capacità dedicata, oppure riservarne meno e inviare l'overflow al pay-per-token con un fallback (vedi Gestire il traffico sopra la tua capacità riservata):
- Riserva una base e invia i picchi a un fallback. Riserva abbastanza unità modello per coprire il traffico costante e quotidiano, e configura un fallback in modo che i picchi oltre quel livello di base vengano gestiti con il modello pay-per-token. Ti impegni a una capacità inferiore e paghi per token solo per l'eccesso, in cambio della capacità condivisa best-effort in quei burst.
- Prenota per i periodi di picco. Riserva abbastanza unità di modello per coprire il carico più intenso previsto, così tutto il carico di lavoro funziona con capacità dedicata. Questo dà il comportamento più coerente, in cambio di un impegno maggiore.
In ogni caso, traduci il carico di lavoro in unità del modello con lo strumento integrato Stima unità del modello nel flusso di creazione. Inserisci il formato previsto della richiesta e lo strumento di stima restituisce le unità modello di cui hai bisogno:
- Il numero di richieste al minuto che ti aspetti.
- Numero medio di token di input per richiesta.
- Numero medio di token di output per richiesta.
- Il tuo tasso di hit previsto della cache.
Per dimensionare una linea di base, inserisci il traffico tipico. Per prenotare per il picco di utilizzo, inserisci il traffico più intenso previsto. Puoi eseguire lo stimatore quante volte vuoi prima di impegnarti.
throughput con provisioning riservato rispetto al modello pay-per-token
Il throughput riservato e preallocato e il modello pay-per-token sono complementari, non si escludono a vicenda. Puoi riservare una capacità dedicata per il tuo traffico principale e configurare un fallback al pay-per-token per tutto ciò che va oltre il pool riservato. La tabella seguente mostra dove si inserisce ogni opzione.
| Capability | Pagamento in base al token | Throughput con provisioning riservato |
|---|---|---|
| Base prezzi | Per token, come utilizzato | Capacità riservata, fatturata per l'intero periodo |
| Capacità | Piscina condivisa, miglior sforzo | Piscina dedicata, riservata a te |
| Latenza in fase di caricamento | Può variare in base alla domanda condivisa | Coerente per la capacità riservata |
| Reservation | Nessuno | 1 o 3 mesi |
| Migliore per | Traffico spuntoso, interno o esplorativo | Applicazioni o agenti esterni, critici per il business, in produzione |
Come funziona il prezzo
La fatturazione del throughput provisionato riservato si basa sulla capacità che riservi, non sulle richieste che invii. Ti viene addebitata l'intera prenotazione per tutta la durata del tempo, indipendentemente dal fatto che tu utilizzi o meno la capacità riservata.
| Che succede | Come viene fatturato |
|---|---|
| Traffico entro la tua capacità riservata | Fatturato come capacità riservata per l'intera durata. |
| Traffico sopra la tua capacità riservata, con un fallback configurato | Pay-per-token solo sull'overflow, addebitato alla destinazione di riserva. |
| Traffico sopra la tua capacità riservata, senza fallback | Limitato dalla frequenza, non fatturato. |
| Traffico dopo la scadenza di una prenotazione | Gestito come qualsiasi traffico sopra la tua capacità riservata: pay-per-token se hai configurato un fallback, altrimenti soggetto a limitazione di frequenza. |
- Un termine più lungo comporta un tasso per unità inferiore rispetto a uno più breve.
- Quando un endpoint ha prenotazioni di durate diverse contemporaneamente, ciascuna viene prezzata indipendentemente alla propria tariffa.
- Le tariffe specifiche dipendono dal modello e dal termine.
Prima di iniziare
| Requisito | Detail |
|---|---|
| Permesso per il modello | È necessario MANAGE per il modello di base in Unity Catalog (il modello registrato system.ai.<model>). Se non ce l'hai, chiedi a un amministratore di concederlo tramite Catalog Explorer. Vedere autorizzazioni di Unity Catalog per i foundation model. |
| Un modello idoneo | Puoi creare un throughput riservato e provisionato solo sui modelli idonei. Consulta Modelli supportati. |
Crea un endpoint di throughput riservato e provisionato
Tu crei un throughput provisionato riservato in Unity Gateway.
In Unity Gateway, seleziona + Modello.
Assegna un nome al servizio modello.
Per la Destinazione, scegli il throughput provisionato, poi seleziona il link per creare un nuovo endpoint di servizio nello spazio di lavoro. Si apre la finestra di dialogo Configura un endpoint di throughput provisionato .
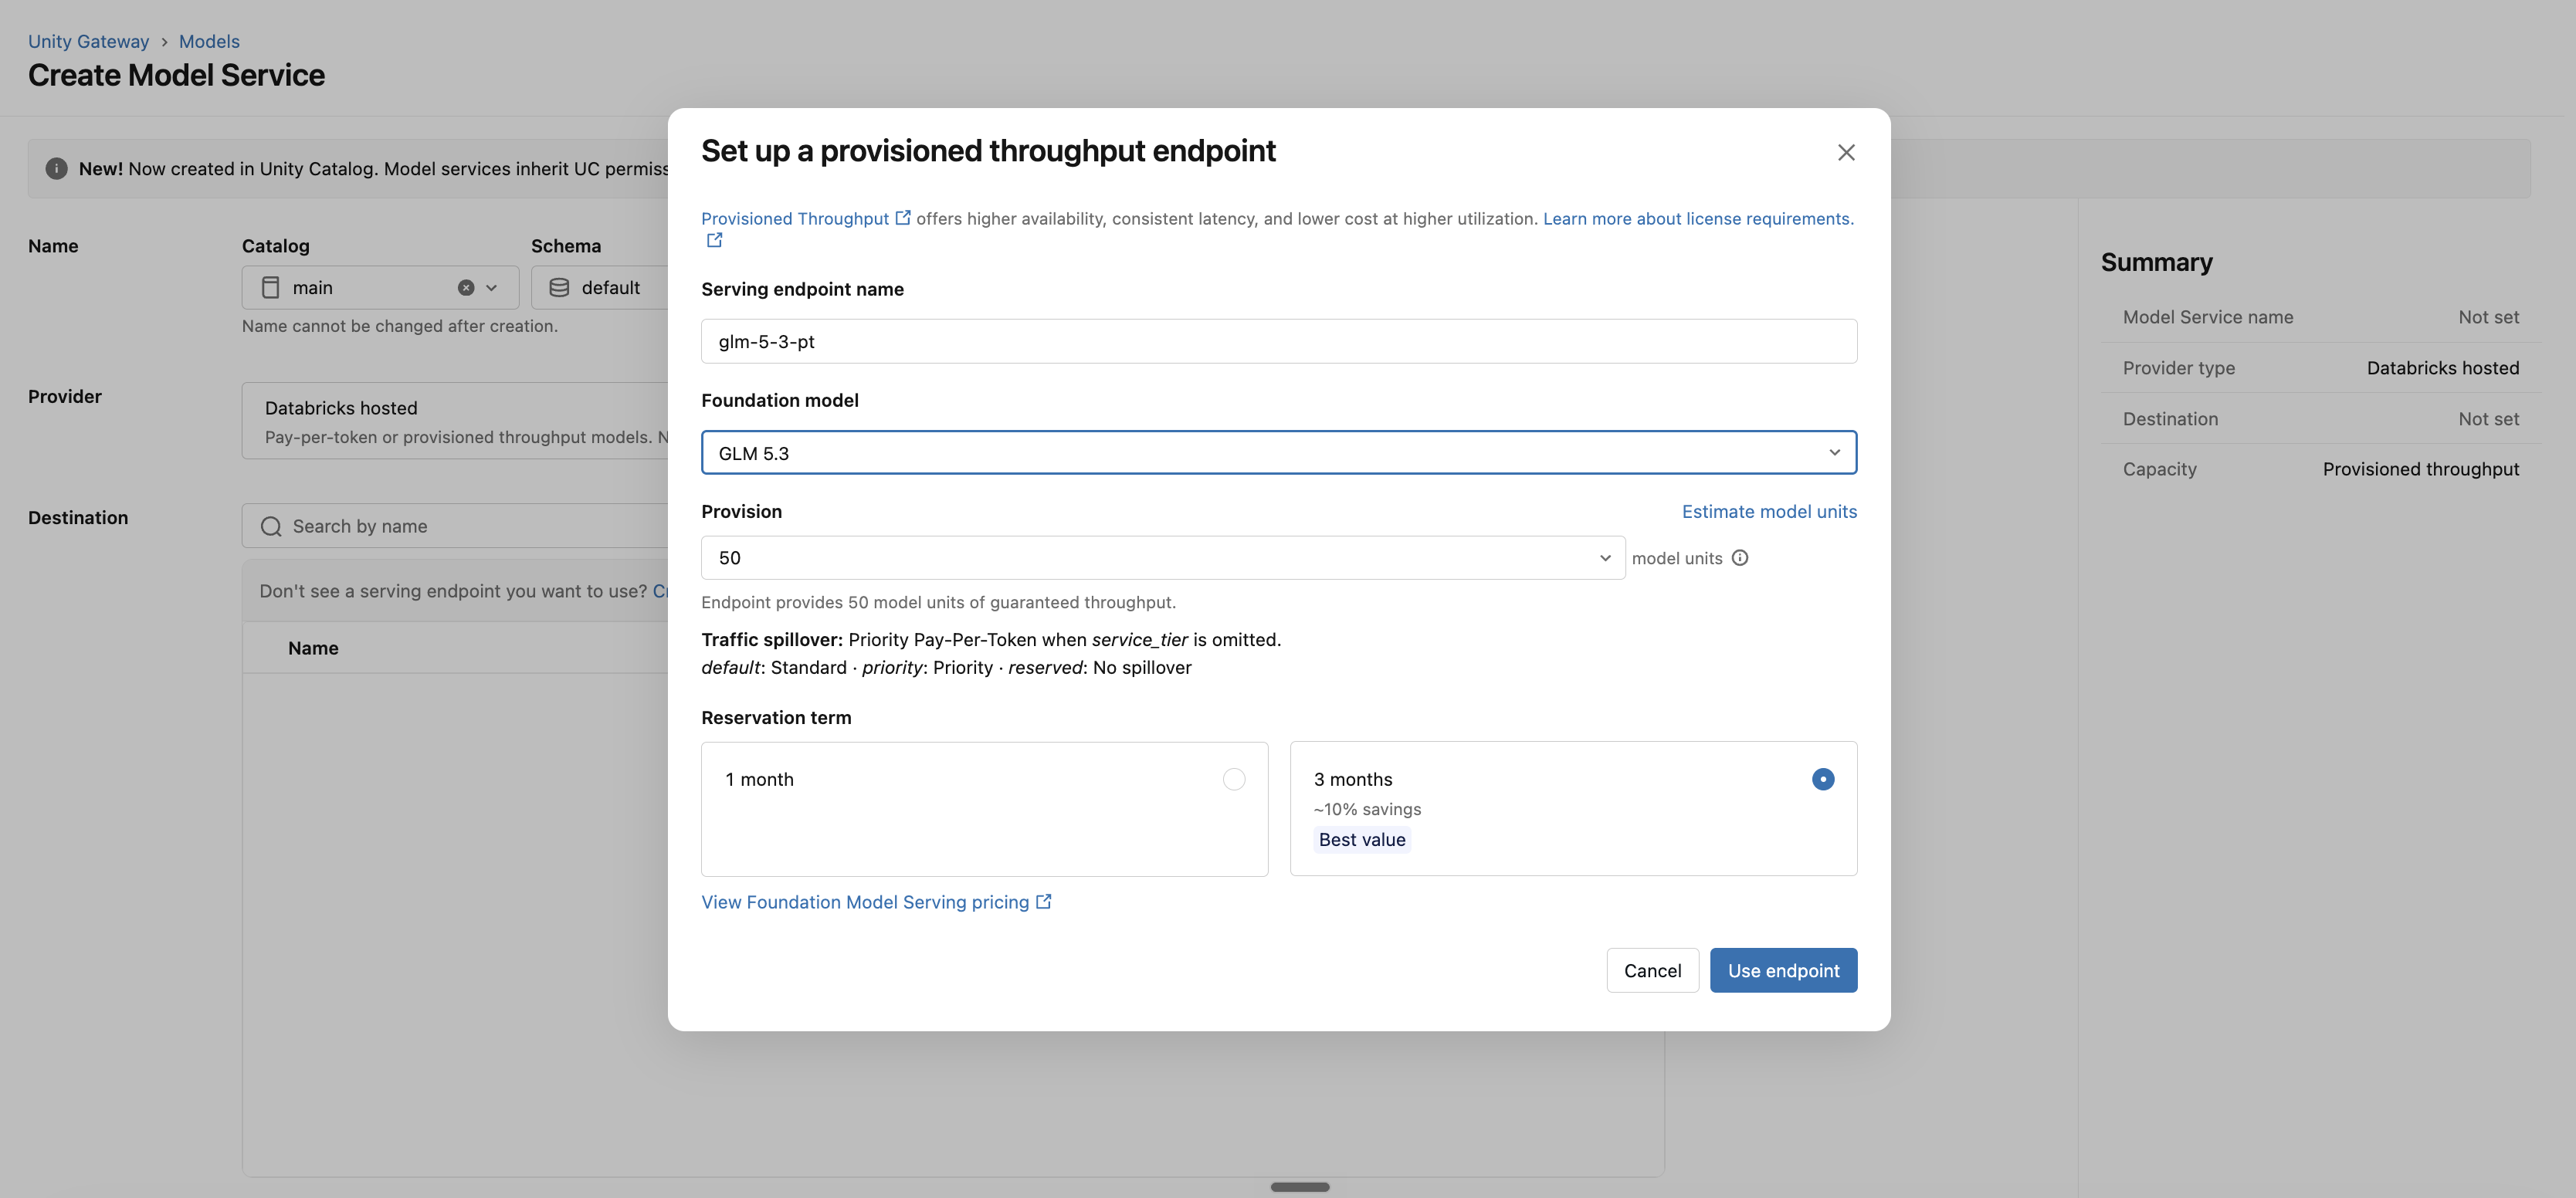
Seleziona un modello di base idoneo.
Imposta le tue unità del modello, a incrementi di 50. Per dimensionare il pool, seleziona Stima unità del modello, inserisci il carico di lavoro previsto (richieste per minuto, token media di input e output per richiesta e il tasso di successo della cache atteso), e lo stimatore restituisce le unità modello di cui hai bisogno. Vedi Decidi quanto riservare.

Scegli una durata di prenotazione: 1 mese o 3 mesi. Un termine più lungo comporta una tariffa per unità inferiore.
Rivedi le unità e la durata del modello, poi crea l'endpoint. Azure Databricks fornisce la capacità dedicata.
Note
Il tipo di capacità di un endpoint è fisso quando lo crei. Non puoi convertire un endpoint esistente in throughput riservato in seguito. Crea invece un nuovo endpoint riservato con throughput provisionato.
Visualizza e monitora
La pagina dei dettagli dell'endpoint mostra una sezione Configurazione attiva con l'intestazione Throughput con provisioning riservato che elenca le unità di modello riservate e, per ogni prenotazione, la durata, la data di scadenza e lo stato. Quando un endpoint contiene più prenotazioni accumulate, derivanti da operazioni di scale-up o aggiornamenti, queste vengono visualizzate come elenco.

La scheda Metrics mostra la telemetria di servizio usuale, inclusi richieste per minuto, conteggio errori, latenza (p50, p90, p95 e p99), conteggio dei token e tempo fino al primo token, così puoi monitorare l'utilizzo e decidere quando scalare.
Capacità di espansione
Per aggiungere capacità, apri Modifica>Aggiungi capacità, inserisci il numero di unità modello da aggiungere (in incrementi di 50) e scegli un termine. Questo crea una nuova prenotazione sovrapposta a quelle esistenti. Non modifica né interrompe ciò che già hai. La pagina dettagliata elenca poi ogni prenotazione, che scade secondo un proprio calendario.

Scadenza
- Alla scadenza, il pool riservato scade. Il traffico viene quindi gestito come qualsiasi traffico sopra la tua capacità riservata: va al fallback pay-per-token configurato, oppure è soggetto a limitazione della velocità se non hai un fallback. Consulta Gestire il traffico oltre la tua capacità riservata.
- Per mantenere la capacità riservata dopo la fine di un trimestre, crea una nuova prenotazione prima che scada quella attuale. Vedi Aumentare la capacità.
- Le prenotazioni scadute rimangono visibili con un badge scaduto e vengono conservate, non cancellate.
Gestire il traffico superiore alla tua capacità riservata
Un endpoint con throughput provisionato riservato gestisce il traffico utilizzando solo la capacità riservata. Azure Databricks non inoltra automaticamente l'overflow al pay-per-token. Quando il traffico supera la tua capacità riservata, sia per un picco improvviso sia perché una prenotazione è scaduta, queste richieste vengono respinte con un errore di limitazione della frequenza.
Per continuare a servire quell'overflow, configura un fallback sul servizio model service Unity Gateway a monte del tuo endpoint. Imposta il tuo endpoint a throughput provisionato riservato come destinazione primaria e un endpoint pay-per-token o pay-per-token prioritario come fallback. Quando l'endpoint riservato restituisce un errore di limite di velocità, il servizio del modello riprova la richiesta verso la destinazione di fallback, così il carico di lavoro continua a funzionare e paghi per token solo per l'overflow.
Per i passaggi di configurazione, vedi Configura routing e fallback per i modelli.
Limitations
- Puoi creare un endpoint a throughput riservato e provisionato per ogni modello, per ogni workspace, nella versione corrente.
- Le prenotazioni sono prepagate e sono disponibili per l'intero periodo. Non puoi cancellare una prenotazione a metà strada.
- Non puoi cancellare un endpoint che ha una riserva attiva finché la prenotazione non termina.
- Gli utenti senza
MANAGEsul modello vedono viste di sola lettura.
Per altre limitazioni delle API del modello di base, vedere Limiti e quote delle API del modello di base.