Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
L'esecuzione di query adattive (AQE) è la ri-ottimizzazione delle query che si verifica durante la loro esecuzione.
Prima che una query venga eseguita, l'ottimizzatore sceglie un piano di query basandosi sulle stime della dimensione dei dati. Queste stime potrebbero essere sbagliate se le statistiche delle tabelle sono mancanti o obsolete, se i dati sono sbilanciati o per fasi successive in una query complessa. Un piano basato su stime errate potrebbe usare una strategia di join lenta, creare troppe piccole attività dopo uno shuffle o creare alcune attività sovradimensionate che rallentano l'intera fase. AQE risolve questi problemi riottimizzando il piano mentre la query viene eseguita, basandosi sulla dimensione effettiva dei dati.
Al termine di ogni shuffle o broadcast exchange, Azure Databricks presenta statistiche accurate per i dati prodotti finora. AQE utilizza queste statistiche per scegliere una strategia fisica migliore, selezionare un numero e una dimensione ottimali delle partizioni post-shuffle, o applicare ottimizzazioni che altrimenti richiedono hint di query, come la gestione dello skew nelle join.
AQE è abilitato per impostazione predefinita. Non è necessario modificare le tue query per trarne vantaggio. Controlla se AQE ha cambiato un piano di query quando risolvi i problemi di una query lenta. Regola le impostazioni AQE solo quando i valori predefiniti non si adattano al tuo carico di lavoro. Vedi Piani di query e Configurazione.
Funzionalità
AQE ha quattro caratteristiche principali:
- Modifica dinamicamente il sort merge join trasformandolo in un broadcast hash join.
- Unisce dinamicamente le partizioni (combina partizioni di piccole dimensioni in partizioni di dimensioni ragionevoli) dopo lo scambio di shuffle. Le attività molto piccole hanno una velocità effettiva di I/O peggiore e tendono a soffrire di più dal sovraccarico di pianificazione e dal sovraccarico di configurazione delle attività. La combinazione di attività di piccole dimensioni consente di risparmiare risorse e migliorare la velocità effettiva del cluster.
- Gestisce dinamicamente lo sbilanciamento nel join di tipo merge sort e nel join di tipo hash shuffle suddividendo (e replicando, se necessario) le attività sbilanciate in attività di dimensioni approssimativamente uguali.
- Rileva e propaga dinamicamente le relazioni vuote, che sono parti di una query che non restituiscono righe.
Query supportate
AQE si applica alle query che soddisfano entrambe le condizioni:
- La query non è una query di streaming.
- La query contiene almeno uno scambio (di solito da uno join, aggregato o finestra), almeno una sottoquery o entrambi.
AQE riottimizza ogni query supportata, ma il risultato potrebbe essere lo stesso piano che l'ottimizzatore ha compilato prima dell'esecuzione della query. Per verificare se AQE ha modificato il piano di una query, vedi Query plans.
Piani di query
Le query AQE applicate contengono uno o più nodi AdaptiveSparkPlan, solitamente come nodo radice di ciascuna query principale o sottoquery. Ogni AdaptiveSparkPlan nodo ha un isFinalPlan flag. Il flag è false prima e durante l'esecuzione della query e diventa true quando la query termina.
Per visualizzare un piano di interrogazione, usa l'interfaccia di Spark, DataFrame.explain(), oppure SQL EXPLAIN. Ognuno mostra informazioni diverse su come AQE cambia il piano.
Interfaccia utente di Spark
Il diagramma del piano di query nell'interfaccia di Spark mostra il piano più recente e si aggiorna man mano che la query procede. I nodi che sono già stati eseguiti e hanno metriche non cambiano. I nodi che non sono ancora stati eseguiti potrebbero cambiare man mano che AQE riottimizza il piano.
Questo esempio mostra un diagramma del piano di query:

DataFrame.explain()
DataFrame.explain() mostra due piani sotto ciascun AdaptiveSparkPlan nodo: il piano iniziale, prima che AQE applichi eventuali ottimizzazioni, e il piano attuale. Il piano attuale cambia man mano che la query viene eseguita e diventa il piano finale quando la query termina.
L'output comprende statistiche sui dati per ogni fase di shuffle e di broadcast. Le statistiche dipendono dal fatto che la fase sia già svolta:
- Prima e durante la fase di esecuzione,
isRuntimeèfalsee le statistiche sono stime in tempo di compilazione. Ad esempio:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Dopo l'esecuzione dello stage,
isRuntimeètruee le statistiche sono le misurazioni di runtime. Ad esempio:Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Questi screenshot mostrano DataFrame.explain() l'output prima, durante e dopo l'esecuzione:
Prima dell'esecuzione

Durante l'esecuzione

Dopo l'esecuzione

SQL EXPLAIN
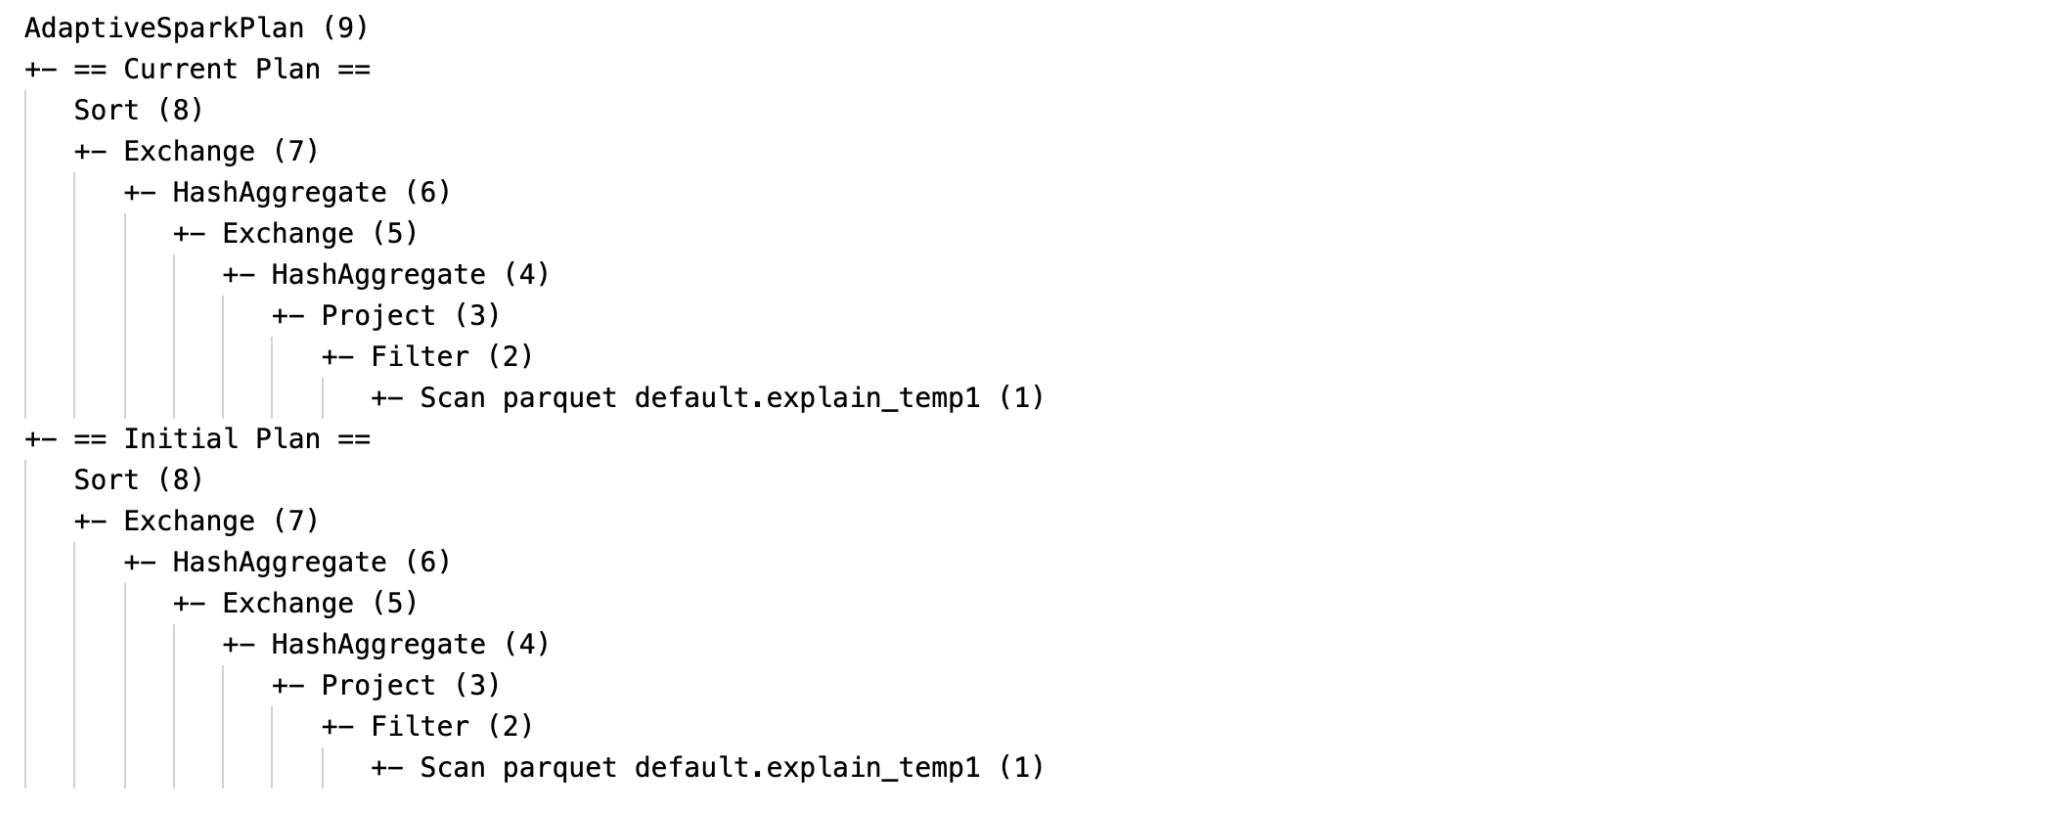
SQL EXPLAIN non esegue la query, quindi AQE non può riottimizzarla. L'output mostra solo il piano iniziale, che potrebbe differire dal piano che AQE esegue.
Questo esempio mostra output SQL EXPLAIN:
Identificare ottimizzazioni applicate in un piano di query
Quando AQE applica un'ottimizzazione, il piano di query cambia. Per identificare quali ottimizzazioni sono entrate in atto, confronta il piano attuale o finale con il piano iniziale. Ogni ottimizzazione modifica il piano in modo specifico:
Modifica della strategia di join. Il piano attuale o finale ha un nodo fisico di giunzione diverso dal piano iniziale.

Coalescenza della partizione Il piano contiene un nodo
CustomShuffleReadercon la proprietàCoalesced.

Gestione degli skew join. Il piano contiene un
SortMergeJoinnodo con ilisSkewcampo impostato atrue.

Propagazione della relazione vuota. Un
LocalTableScannodo con un campo di relazione vuoto sostituisce parte o tutto il piano.

Configurazione
Queste proprietà di configurazione di Apache Spark controllano l'AQE. La maggior parte dei carichi di lavoro non ha bisogno di cambiare i valori predefiniti.
Abilita AQE e configura le singole ottimizzazioni
Usa queste proprietà per attivare o disattivare AQE e per sintonizzare lo shuffle auto-ottimizzato, il broadcast join switching e la propagazione delle relazioni vuote:
| Proprietà | Type | Default | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Attiva o disattiva l'esecuzione adattiva delle query. |
spark.sql.shuffle.partitions |
Integer |
200 |
Numero predefinito di partizioni da usare per il mescolamento dei dati per join o aggregazioni. Impostalo su auto per abilitare lo shuffle auto-ottimizzato, che imposta questo numero in base al piano di query e alla dimensione dei dati di input della query.Per lo Structured Streaming, non puoi cambiare questo valore tra i riavvii della query dalla stessa posizione di checkpoint. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
La soglia di dimensione per passare un sort-merge join a un join hash broadcast in fase di esecuzione. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Attiva o disattiva la propagazione dinamica delle relazioni vuote. |
Unire dinamicamente le partizioni
| Proprietà | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Attiva o disattiva la coalescenza delle partizioni. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Dimensione finale dopo la fusione. Le partizioni coalescenti sono vicine a questa dimensione, ma non superiori a essa. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Dimensioni minime delle partizioni dopo l'unione. Le partizioni unite non sono più piccole di questa dimensione. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Due volte il numero di core di cluster | Numero minimo di partizioni dopo l'unione. Non impostare questa proprietà, perché impostarla sovrascrive spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Gestire dinamicamente il join sbilanciato
| Proprietà | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Attiva o disattiva la gestione delle join skew. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
Il moltiplicatore per la dimensione mediana della partizione che una partizione deve superare per essere considerata sbilanciata. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
La dimensione minima che una partizione deve superare per essere considerata sbilanciata. |
AQE considera una partizione come distorta solo quando entrambe queste condizioni sono vere: (partition size > skewedPartitionFactor * median partition size) e (partition size > skewedPartitionThresholdInBytes).
Domande frequenti
Perché AQE non ha trasmesso una piccola tabella di join?
Se la tabella è più piccola di spark.databricks.adaptive.autoBroadcastJoinThreshold ma AQE non la trasmette, controlla queste cause:
- Il tipo di join non supporta il broadcast. Alcuni tipi di join non possono replicare un solo lato. Ad esempio, AQE non può trasmettere il lato sinistro di un
LEFT OUTER JOIN. - La tabella ha molte sezioni vuote. La maggior parte delle operazioni nel sort-merge join termina rapidamente, oppure la gestione dello skew join ottimizza la join. AQE non cambia un sort-merge join in un broadcast hash join se la percentuale di partizioni non vuote è inferiore a
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Dovrei comunque usare un broadcast join hint con AQE abilitato?
Sì, se conosci bene la tua query. Una broadcast join pianificata dall'ottimizzatore prima che la query venga eseguita di solito funziona meglio di una che AQE pianifica in tempo reale. AQE potrebbe non passare a una broadcast join finché non avrà eseguito lo shuffle di entrambi i lati della join, ed è allora che apprende le dimensioni effettive delle tabelle.
AQE rispetta gli hint di query allo stesso modo dell'ottimizzazione statica, e applica comunque le ottimizzazioni dinamiche che gli hint non influenzano.
Dovrei usare il suggerimento per skew join o la gestione AQE per skew join?
Usa la gestione delle join skew AQE. È automatico e di solito funziona meglio dell'hint skew join.
Perché AQE non ha riordinato i miei join?
AQE non riordina i join durante l'esecuzione. Per migliorare l'ordine di join, raccogli statistiche della tabella affinché l'ottimizzatore basato sul costo possa scegliere un piano migliore. Vedi l'ottimizzatore basato sui costi.
Perché AQE non ha rilevato un'asimmetria dei dati?
AQE tratta una partizione come sbilanciata solo quando entrambe queste condizioni sono vere:
- La partizione è più grande di
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(predefinito256MB). - La partizione è più grande di
spark.sql.adaptive.skewJoin.skewedPartitionFactorvolte la dimensione mediana della partizione (predefinita5).
AQE gestisce inoltre lo skew solo nelle join basate su shuffle, che sono join sort-merge e join hash shuffle. Non ottimizza mai lo skew nelle broadcast joins. Per i join basati su shuffle, il tipo di join determina quale lato AQE può ottimizzare:
| Tipo di join | Skew ottimizzato sul lato sinistro | Inclinazione ottimizzata sul lato destro |
|---|---|---|
INNER |
Sì | Sì |
CROSS |
Sì | Sì |
LEFT OUTER |
Sì | No |
RIGHT OUTER |
No | Sì |
LEFT SEMI |
Sì | No |
LEFT ANTI |
Sì | No |
FULL OUTER |
No | No |
Eredità
Spark 1.6 ha introdotto una funzione chiamata esecuzione adattiva, ma AQE in Spark 3.0 è una caratteristica diversa. L'esecuzione adattiva di Spark 1.6 accorpa le partizioni solo dinamicamente. AQE è un framework che pianifica e ripianifica le query basandosi sulle statistiche di runtime, e supporta tutte le ottimizzazioni presenti in questa pagina.