Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Importante
Il training interattivo richiede l'approvazione esplicita dell'accesso. Richiedere l'accesso tramite il modulo di iscrizione dell'anteprima e attendere l'approvazione prima di creare una sessione di training.
Usare questo foglio informativo per eseguire il mapping del ciclo di training alle funzioni e ai parametri di Python SDK in Microsoft Foundry. Gli esempi si concentrano sull'API di praticità sincrona FineTuningSession . I client asincroni e i wrapper cookbook usano interfacce e modelli di completamento diversi.
Prerequisites
- Completare l'installazione, l'autenticazione e l'installazione dell'accesso.
- Usare
azure-ai-finetuningsessions==1.0.0b1, la versione di anteprima pubblica installata dal cookbook. - Ruolo Utente foundry per il training o proprietario di Foundry se si distribuisce anche il modello ottimizzato. Vedere Controllo degli accessi in base al ruolo per Microsoft Foundry.
- Selezionare un modello idoneo e la configurazione dell'adattatore supportata. Preparare i token con il tokenizer e il modello di chat corrispondenti.
- Impostare
AZURE_AI_PROJECT_ENDPOINTe confermare un budget di formazione approvato. La creazione di una sessione e l'esecuzione di operazioni di training o campionamento possono comportare addebiti.
I metodi pratici di training, campionamento e checkpoint attendono i risultati dell'operazione. Le operazioni non elaborate e gli helper asincroni hanno tipi restituiti e comportamento di completamento diversi; usare le informazioni di riferimento complete sull'SDK per tali interfacce.
Gli esempi usano l'SDK sincrono, a meno che non sia diversamente etichettato. Preparare le funzioni helper una sola volta, quindi eseguire operazioni all'interno with open_session() as session:di . Usare dati realmente con token; I frammenti di codice non forniscono un set di dati o implementano un algoritmo di training completo.
Messa a punto supervisionata
L'ottimizzazione con supervisione (SFT) esegue il training su richieste e risposte desiderate.
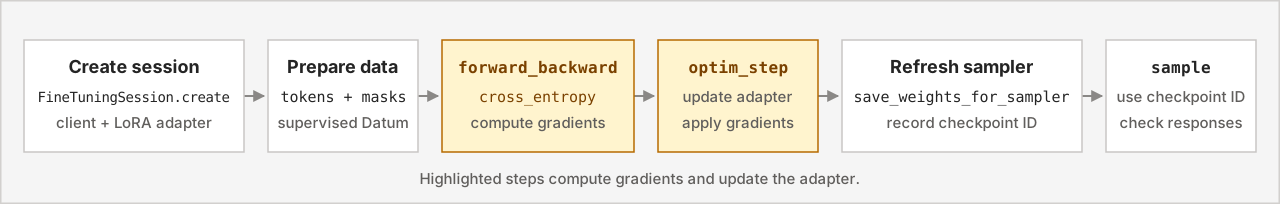
La sequenza crea > un checkpoint di valutazione > dei dati > con supervisione in avanti/indietro >>. Il campionamento non è necessario per ogni batch supervisionato.
Apprendimento per rinforzo
L'apprendimento per rinforzo esegue il training dalle risposte del modello con punteggio.

La sequenza consiste nel creare > un campionatore > di aggiornamento che raccoglie > le ricompense di calcolo e i vantaggi > del passaggio di ottimizzazione avanti/indietro>. Ripetere dall'aggiornamento del campionatore per raccogliere risposte dai criteri aggiornati.
Il raggruppamento, la classificazione e il calcolo dei vantaggi appartengono al driver, non a un algoritmo di training sdk automatico. Per esempi di training completi, esplorare il repository degli esempi di ottimizzazione.
Creare una sessione
FineTuningSessionClient si connette al progetto usando un endpoint oggetto e credential.
FineTuningSession.create inizializza un modello e un adattatore e avvia l'heartbeat della sessione.
Questo helper esegue l'autenticazione con DefaultAzureCredential, crea una sessione e lo scarica quando il contesto viene chiuso. Usare il modello approvato e la classificazione LoRA. L'ambito esplicito delle credenziali è relativo all'autenticazione Microsoft Entra.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Riferimento: FineTuningSession.create, FineTuningSessionClient e DefaultAzureCredential.
Aspettarsi un identificatore di sessione al termine del caricamento del modello. Mantenere aperta la sessione per le operazioni seguenti; chiudendo il contesto, l'heartbeat viene arrestato e viene inviata una richiesta di scaricamento.
| Parametro | Meaning |
|---|---|
base_model |
Identificatore esatto del modello di training supportato. |
lora_config |
Esplicito LoRAConfig con un oggetto supportato rank. |
type |
Tipo di sessione; usare training. Il campionamento avviene tramite la sessione di training, non un tipo di sessione di inferenza separato. |
timeout_sec |
Tempo massimo di attesa per il caricamento del modello. Un timeout non conferma la pulizia remota. |
from_checkpoint |
Facoltativo FromCheckpoint con l'origine source_session_id e checkpoint_id. Usare lo stato di training salvato compatibile. |
user_metadata |
Dizionario facoltativo dei metadati di esecuzione da associare alla sessione. |
training_type |
Selettore di livello facoltativo; i valori noti sono GlobalStandard, DatazoneStandarde DeveloperTier. L'idoneità dipende comunque dal modello e dal progetto. |
Registrare session.session_id quando si usa direttamente l'SDK. Per eseguire una ricetta di training end-to-end, vedere Introduzione.
Preparare i dati con supervisione
Datum gruppi model_input e loss_fn_inputs per un esempio.
| Digitare o campo | Meaning |
|---|---|
ModelInput |
Blocchi di input del modello ordinati. |
ModelInputChunk.tokens |
ID token di testo dal tokenizer del modello. |
LossFnInputs.target_tokens |
Destinazioni token successivo allineate alle posizioni di input. |
LossFnInputs.weights |
Pesi espliciti per token; zero esclude un bersaglio dal training tra entropia. |
TensorData.data |
Destinazioni intere o segnali di apprendimento a virgola mobile. |
Sposta gli input e le destinazioni di un token e allinea i pesi alle destinazioni. Eseguire il training sui token di assistente previsti, non su richieste o osservazioni. Vedere Funzioni di perdita e pesi dei token.
Passare token di richiesta e completamento dallo stesso renderer di chat specifico del modello a questo helper. Crea un esempio SFT a turno singolo e maschera le destinazioni di richiesta.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Riferimento: Datum, LossFnInputs e ModelInput.
Compilare batch come elenco di questi Datum valori. Le matrici di input, destinazione e peso hanno la stessa lunghezza. Per i dati a più turni, mantenere le maschere del renderer anziché trattare ogni token dopo la prima richiesta come token assistente.
Preparare i dati di sicurezza a livello di riga
Per la sicurezza a livello di riga, usare risposte campionate e segnali di apprendimento derivati dalla ricompensa:
| Field | Meaning |
|---|---|
SampledSequence.tokens |
ID token generati. |
SampledSequence.logprobs |
Probabilità del log dei token dai criteri che hanno generato la risposta, se specificato. |
LossFnInputs.logprobs |
Probabilità del log di implementazione allineate alle destinazioni di training. |
LossFnInputs.advantages |
Vantaggi per token; zero esclude le posizioni di richiesta e osservazione dal segnale RL. |
Mantenere l'allineamento tra destinazioni, probabilità di log e vantaggi. Non sostituire le probabilità di implementazione con quelle di un modello appena aggiornato. anche il costruttore di LossFnInputs Python richiede l'esplicito weights; La maschera a livello di riga usa i vantaggi.
Per un'implementazione a turno singolo, passare un campione sequence e un advantage oggetto calcolato dal driver. Questo helper mette zero vantaggi e probabilità di log in posizioni di destinazione prompt.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Riferimento: SampledSequence e LossFnInputs.
Per le chiamate agli strumenti o le implementazioni a più turni, usare il renderer della ricetta per distinguere i token di azione campionati dalle osservazioni dell'ambiente.
Sfumature di calcolo
session.forward_backward(batch, loss_fn=...) calcola l'obiettivo e accumula sfumature. Non aggiorna i pesi dell'adattatore.
batch contiene Datum valori.
loss_fn
cross_entropyseleziona , importance_sampling, ppo, cispo, o sapo. Facoltativo loss_fn_config usa il modello dell'SDK LossFnConfig . Non dedurre le chiavi di configurazione accettate da un documento sugli algoritmi.
Completare il calcolo delle sfumature prima dell'aggiornamento dell'utilità di ottimizzazione. Mantenere la riduzione della perdita coerente durante l'accumulo di diverse chiamate.
Con un oggetto live session e un SFT batchnonempty, calcolare le sfumature ed esaminare gli output per esempio:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Riferimento: FineTuningSession.forward_backward e LossFn.
Per un batch RL preparato, usare LossFn.IMPORTANCE_SAMPLING o un'altra perdita di criteri supportata.
LossFn I membri enumerazione e i relativi valori stringa selezionano la stessa perdita.
Applicare un passaggio di ottimizzazione
session.optim_step(adam_params) applica gradienti accumulati.
AdamParams Python richiede tutti e cinque i campi:
| Field | Meaning |
|---|---|
learning_rate |
Dimensioni degli aggiornamenti di Optimizer. |
beta1 |
Fattore di decadimento del primo momento. |
beta2 |
Fattore di decadimento del secondo momento. |
eps |
Termine di stabilità numerica. |
weight_decay |
Impostazione del decadimento del peso. |
Scegliere i valori per l'esperimento anziché presupporre le impostazioni predefinite universali.
Questo helper fornisce ogni campo obbligatorio e attende l'aggiornamento. I valori sono impostazioni di esempio, non raccomandazioni indipendenti dal modello.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Riferimento: FineTuningSession.optim_step e AdamParams.
Ricompilare learning_rate quando il driver usa una pianificazione. Non presupporre che una configurazione di Optimizer si applichi durante l'esecuzione.
Testo di esempio
session.save_weights_for_sampler(seq_id, ...) prepara i pesi e restituisce un identificatore del checkpoint del campionatore. Aggiornare i pesi del campionatore dopo gli aggiornamenti prima di generare dall'adattatore aggiornato.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) genera risposte dai pesi del campionatore selezionati.
| Parametro o risultato | Meaning |
|---|---|
prompt_tokens |
Richiesta con token o supportato ModelInput. |
checkpoint_id |
Identificatore del checkpoint sampler completato per questa sessione, non un percorso del checkpoint o un nome di distribuzione. |
num_samples |
Numero di risposte per la richiesta. |
SamplingParams.max_tokens |
Budget del token di completamento. |
temperature, top_p, top_k |
Impostazioni di distribuzione del campionamento. |
stop_criteria |
Un elenco di stringhe di interruzione o un elenco di ID token, non entrambi. |
response_format |
Richiesta in formato risposta facoltativa; il supporto dipende dal modello e dal provider di campionamento. |
result.sequences |
Valori generati SampledSequence . |
SamplingParams Python richiede max_tokens, temperature, top_pe top_k. Impostare lo stesso valore seq_id per l'aggiornamento e il campionamento del campionatore.
path Fornire o sampling_session_seq_id quando si salvano i pesi del campionatore.
Dopo un aggiornamento di Optimizer, aggiornare il campionatore e generare una risposta. Usare il token e prompt_tokens la corrispondenza tokenizer del modello dal driver.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Riferimento: FineTuningSession.save_weights_for_sampler, FineTuningSession.sample e SamplingParams.
Il risultato contiene una sequenza campionata. Incrementare l'identificatore del passaggio con gli aggiornamenti e aggiornare i pesi del campionatore prima di eseguire il campionamento dei criteri aggiornati.
La preparazione dei pesi del campionatore non equivale al salvataggio dello stato di training ripristinabile.
Rendere persistenti o aggiornare i pesi del campionatore
Il metodo sincrono usa sampling_session_seq_id per distinguere un aggiornamento in memoria da un checkpoint del campionatore persistente.
| Purpose | Chiamata sincrona |
|---|---|
| Aggiornare i pesi del campionatore senza persistenza | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Rendere persistente un checkpoint del campionatore |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), senza sampling_session_seq_id. |
Entrambe le chiamate restituiscono un identificatore del checkpoint sampler. Mantenerlo con l'ID sessione proprietario. Un salvataggio di campionatore durevole non stabilisce una conservazione illimitata o rende utilizzabile il checkpoint in un'altra sessione.
Eseguire un passaggio forward-only
session.forward(batch, loss_fn=...) restituisce output di funzione di perdita senza accumulare sfumature. Usarlo per esaminare un batch preparato o calcolare le metriche di valutazione.
Il risultato non popola solo il training total_loss. Esaminare loss_fn_outputs; non considerare un'aggregazione mancante come perdita zero.
Con un live session e un preparato batch, esaminare gli output per esempio senza modificare i gradienti accumulati:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Riferimento: FineTuningSession.forward.
Salvare e riprendere il training
session.save_weights(path) salva i pesi dell'adattatore e lo stato dell'utilità di ottimizzazione. Registrare il riferimento al checkpoint con la sessione di origine e lo stato del driver.
Dopo un aggiornamento completato, salvare lo stato di training e registrare il riferimento source-session/checkpoint:
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Riferimento: FineTuningSession.save_weights.
Il metodo restituisce solo dopo il completamento del salvataggio. Archiviare checkpoint_path con la posizione del set di dati e altri stati del driver prima di chiudere la sessione.
FineTuningSession.create_from_checkpoint ripristina lo stato di training in una nuova sessione:
| Parametro | Meaning |
|---|---|
checkpoint_path |
Riferimento al checkpoint di training salvato nel <source-session-id>/<checkpoint-name> modulo. |
base_model |
Modello di base compatibile con il checkpoint originale. |
lora_config |
Configurazione dell'adattatore compatibile con un rango esplicito. |
Un checkpoint sampler non è un checkpoint di training con stato completo. Ripristinare la posizione e la pianificazione del set di dati separatamente nel driver. Vedere Checkpoint.
Questo helper ripristina lo stato di training salvato tramite un oggetto autenticato client. Passare il training checkpoint_pathregistrato e mantenere il modello di base e la classificazione LoRA compatibile con la sessione di origine.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Riferimento: FineTuningSession.create_from_checkpoint.
La sessione restituita ha un nuovo ID sessione e avvia il proprio heartbeat. Chiudere la sessione ripresa al termine del ciclo, proprio come si chiude una sessione appena creata.
Usare operazioni asincrone
I wrapper asincroni e i wrapper asincroni dell'SDK non sono intercambiabili. Importare il client asincrono da azure.ai.finetuningsessions.aio. I tipi di modello provengono comunque da azure.ai.finetuningsessions.models.
| Interface | Modello di completamento |
|---|---|
FineTuningSession sincrono |
Il metodo restituisce un risultato dell'operazione completata. |
Metodi pratici dell'SDK asincrono non elaborati, ad esempio save_weights_for_sampler_async |
Attendere l'invio, quindi attendere il completamento restituito asyncio.Task . |
Metodi di training del cookbook, ad esempio save_state_async |
Attendere l'invio, quindi attendere il futuro.result_async() |
Per una sessione dinamica di proprietà di un asincrono client, questo helper rende persistenti i pesi del campionatore e restituisce l'identificatore del checkpoint completato:
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Riferimento: FineTuningSessionClient.save_weights_for_sampler_async asincrona.
Usare save_weights_and_get_sampling_client_async invece per un aggiornamento temporaneo dell'campionatore. Nel client SDK non elaborato, tale metodo restituisce comunque un'attività con un risultato dell'operazione, non un client di campionamento di cookbook.
Attendere i salvataggi necessari prima di scaricare una sessione. L'argomento di compatibilità ttl_seconds del cookbook non viene inoltrato a questi salvataggi SDK. Non considerarlo come un'impostazione di conservazione applicata.
Per gli obiettivi personalizzati, cookbook forward_backward_custom_async compone output di inoltro del servizio con il calcolo della perdita differenziabile lato client. Non è un metodo in FineTuningSessione il parametro dellloss_fn'SDK non accetta un Python arbitrario chiamabile.
Chiudere le risorse
session.close() arresta l'heartbeat e invia una richiesta di scaricamento. Chiamalo quando il ciclo viene chiuso, incluso in caso di errore; quindi chiudere il client HTTP e le credenziali.
La chiusura non conferma il completamento della pulizia remota o elimina i checkpoint.
session.delete() può essere propagato alle risorse salvate. Vedere Esaminare e scaricare le sessioni.
Usare il open_session gestore del contesto per eseguire un singolo aggiornamento SFT e salvare lo stato di training. Definire open_session e apply_optimizer_step dagli esempi precedenti e passare un oggetto SFT batchdi cui è stato eseguito il rendering senza interruzioni.
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Riferimento: FineTuningSession.close e FineTuningSession.save_weights.
L'helper restituisce un riferimento al checkpoint di training. Il contesto invia una richiesta di scaricamento anche se un'operazione di training genera un'eccezione, chiude il client e le credenziali.
Informazioni di riferimento su SDK
Usare il riferimento completo per esempi eseguibili, firme dei metodi, API asincrone, tipi di risultati ed errori: