Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Fabric Data Factory è la prossima generazione di Azure Data Factory. Usando OneLake come livello di archiviazione unificato, Fabric Data Factory riduce la complessità dell'infrastruttura e lo spostamento dei dati. Le pipeline possono funzionare direttamente con i dati in tempo reale tramite collegamenti OneLake e la condivisione tra tenant.
Questo articolo confronta le funzionalità di base, le attività, i connettori e i componenti dell'infrastruttura di entrambi i servizi. Per pianificare un aggiornamento, consulta la guida alla pianificazione degli aggiornamenti.
Comparare le funzionalità fianco a fianco
Ecco come si sovrapponino le funzionalità principali tra Azure Data Factory e Data Factory di Fabric. La tabella evidenzia ciò che è cambiato, le novità e ciò che rimane invariato.
| Azure Data Factory | Fabric Data Factory | Differenze |
|---|---|---|
| Oleodotto | Oleodotto | Migliore integrazione: le pipeline in Fabric funzionano perfettamente con lakehouse, magazzini e altri articoli Fabric appena appena usciti dalla scatola. Le pipeline fabric includono più attività basate su SaaS e differiscono nelle definizioni in JSON. Per altri dettagli, vedere il confronto delle funzionalità della pipeline . |
| Mappatura del flusso di dati | Dataflow Gen2 con trasformazioni di Mapping Flusso di dati (MDF) | Utilizzare trasformazioni MDF per mantenere la familiare esperienza di authoring del Mapping Flusso di dati e il modello di esecuzione basato su Spark. |
| Attività | Attività | Altre attività in arrivo: stiamo lavorando per portare tutte le attività di Azure Data Factory preferite in Fabric. Inoltre, si ottengono nuovi elementi come ad esempio l'attività di Office 365 Outlook che non sono disponibili in ADF. Per informazioni dettagliate, vedere il confronto delle attività . |
| Collezione di dati | Solo connessioni | Approccio più semplice: niente più configurazioni complesse dei set di dati. Per Fabric Data Factory usi le connessioni per collegarti alle fonti dati e iniziare a lavorare. Fabric elimina i set di dati, definendo le proprietà dei dati inline all'interno delle attività. |
| Servizio collegato | Connessioni | Più intuitivo: le connessioni funzionano come i servizi collegati, ma sono più facili da configurare e gestire. |
| Attivatori | Pianificare e archiviare i trigger degli eventi | Pianificazione predefinita: usare l'utilità di pianificazione e gli eventi Reflex di Fabric per eseguire automaticamente le pipeline. I trigger di eventi di file funzionano in modo nativo in Fabric senza alcuna configurazione aggiuntiva. Fabric integra i trigger nel suo framework Attivator, a differenza dei trigger standalone dell'ADF. |
| Pubblicare | Salvare ed eseguire | Nessun passaggio di pubblicazione: in Fabric, ignorare completamente il passaggio di pubblicazione. È sufficiente selezionare Salva per archiviare il lavoro oppure selezionare Esegui per salvare ed eseguire immediatamente la pipeline. |
| Risoluzione automatica e runtime di integrazione di Azure | Non necessario | Architettura semplificata: non è necessario gestire i runtime di integrazione. Fabric gestisce automaticamente il calcolo. |
| Runtime di integrazione autogestiti | Gateway dati locale | Stesso accesso on-premises: connettiti ai tuoi dati on-premises utilizzando il familiare gateway on-premises. Per altre informazioni, vedere la guida all'accesso ai dati locale. |
| runtime di integrazione Azure-SSIS | Deve essere determinato | Funzionalità future in Fabric: stiamo ancora lavorando alla progettazione per l'integrazione SSIS in Fabric. |
| Reti virtuali gestite ed endpoint privati | Da determinare. | Funzionalità future in Fabric: Continuiamo a lavorare sull'integrazione delle reti virtuali gestite e degli endpoint privati in Fabric. |
| Linguaggio delle espressioni | Linguaggio delle espressioni | Stesse espressioni: le informazioni sulle espressioni esistenti si trasferiscono direttamente. La sintassi è quasi identica. |
| Tipi di autenticazione | Tipi di autenticazione | Altre opzioni: tutti i metodi di autenticazione di Azure Data Factory più diffusi funzionano in Fabric, oltre a nuovi tipi di autenticazione. |
| Integrazione e Distribuzione Continua (CI/CD) | Integrazione e Distribuzione Continua (CI/CD) | Le funzionalità avanzate oltre ADF includono semplici operazioni di cherry-picking, promozione di singoli elementi, abilitazione del repository Git e opzioni CI/CD SaaS predefinite. |
| Esportazione/importazione di modelli ARM | Salva con nome | Duplicazione rapida: in Fabric, usare "Salva con nome" per duplicare rapidamente le pipeline per lo sviluppo o il test. |
| Monitoraggio | Hub di monitoraggio e cronologia di esecuzione | Monitoraggio avanzato: l'hub di monitoraggio offre un'esperienza moderna con informazioni dettagliate tra aree di lavoro e funzionalità di drill-down migliori. |
| Risoluzione dei problemi | Modalità interattiva | Debug semplificato: Fabric elimina la modalità debug di ADF. Sei sempre in modalità interattiva. |
| Cattura delle Modifiche ai Dati (CDC - Change Data Capture) | Processi di copia | Spostamento incrementale dei dati: Fabric gestisce lo spostamento incrementale dei dati mediante processi di copia anziché tramite artefatti CDC. |
| Collegamento ad Azure Synapse | Rispecchiamento | Replica dei dati: Fabric sostituisce collegamento ad Azure Synapse con funzionalità di mirroring per la replica dei dati. |
| Eseguire l'attività della pipeline | Richiamare l'attività della pipeline | Invocazione multipiattaforma: Fabric potenzia l'attività Execute pipeline di ADF consentendo l'invocazione multipiattaforma. |
Confronto delle funzionalità della pipeline
| Categoria | Pipeline di Azure Data Factory | Pipeline di infrastruttura |
|---|---|---|
| Tipo di servizio | Servizio PaaS per l'integrazione dei dati | Servizio SaaS per l'integrazione dei dati |
| Ambiente di creazione | Portale di Azure (ADF Studio) | Area di lavoro di Fabric / Power BI (interfaccia utente unificata con lakehouse, warehouse, ecc.) |
| Orchestrazione della pipeline | Pipeline completamente funzionali con attività, trigger e parametri | Stesso modello di orchestrazione, ricreato per l'esperienza utente di Fabric |
| Spostamento di dati | Attività di copia, flussi di dati di mappatura, supporto IR on-premise, una rete virtuale gestita | Attività di copia, dataflows Gen2, connettività integrata con OneLake ed elementi di Fabric, collegamenti OneLake per l'accesso in tempo reale ai dati senza copia, gateway dati on-premises, gateway di rete virtuale |
| Calcolo / IR | Self-hosted, SSIS e Azure IR (per lo spostamento e la trasformazione) | Connessioni cloud, connessioni locali e gateway di rete virtuale |
| Flussi di dati | Mapping Data Flows fornisce trasformazioni a basso codice, basate su Spark, con connettori sorgente e sink supportati | Dataflow Gen2 fornisce trasformazioni MDF con esecuzione basata su Spark. |
| Monitoraggio | pipeline e flussi di dati in ADF Studio con esecuzioni, trigger e avvisi | Monitoraggio di hub e spazi di lavoro con viste unificate su pipeline, flussi dati, notebook, database, ecc. |
| Attivatori | Pianificazioni, finestra a cascata, trigger basati su eventi | Pianificazioni, trigger di eventi, trigger di finestra mobile come pianificazioni degli intervalli. Le pipeline che usano dati in tempo reale tramite collegamenti OneLake e la condivisione tra tenant funzionano perfettamente con tutti i tipi di trigger di Fabric. |
| Integrazione e Distribuzione Continua (CI/CD) | Modelli ARM + integrazione del repository Azure DevOps o GitHub | Pipeline di distribuzione predefinite in Fabric; Promozione a livello di area di lavoro (sviluppo → test → produzione) e integrazione del repository esterno |
| Security | Identità gestite, integrazione con Key Vault, endpoint privati | Stesso modello di sicurezza più controllo degli accessi in base al ruolo di Fabric workspace; Integrazione della sicurezza di OneLake |
| Condivisione e governance dei dati | N/A | La condivisione dei dati tra tenant tramite i tasti di scelta rapida OneLake consente l'accesso ai dati in tempo reale e regolamentato attraverso i limiti dell'organizzazione senza duplicazione |
| Pricing | Utilizzo di Azure con pagamento in base al consumo (per esecuzione di attività, spostamento dei dati e calcolo) | Capacity-based (FABRIC F SKU) senza addebiti per attività esterne o di pipeline, solo per l'esecuzione delle attività e lo spostamento dei dati nelle pipeline. |
Annotazioni
L'esperienza di aggiornamento integrata supporta pipeline idonee di Azure Data Factory e Azure Synapse Analytics contenenti Mapping Data Flows. I flussi di dati di mapping supportati vengono aggiornati alle trasformazioni MDF in Dataflow Gen2. Rivedere i connettori supportati, le trasformazioni, i metodi di autenticazione e le limitazioni attuali prima di aggiornare. Per requisiti e istruzioni, vedi Eseguire l'upgrade delle pipeline Mapping Flusso di dati di Azure Data Factory a Fabric.
Confronto tra attività
Con Data Factory, continuiamo a mantenere un alto grado di continuità con Data Factory. Circa 90% delle attività accessibili nell'ADF sono già disponibili tramite Data Factory. Ecco una panoramica delle attività e della loro disponibilità sia in ADF che in Data Factory:
| Activity | ADF | Data Factory |
|---|---|---|
| ADX/KQL | Y | Y |
| Aggiungi variabile | Y | Y |
| Personalizzato (Azure Batch in Fabric) | Y | Y |
| Azure Databricks | Attività notebook • Attività Jar • Attività Python • Attività Job | Attività di Azure Databricks |
| Azure Machine Learning (Apprendimento Automatico di Azure) | Y | Y |
| Esecuzione batch di Azure Machine Learning | Deprecated | N/A |
| Risorsa di aggiornamento di Azure Machine Learning | Deprecated | N/A |
| Copiare | Copiare i dati | Attività di copia |
| Flusso di dati Gen2 | N/A | Y |
| Delete | Y | Y |
| Eseguire o richiamare la Pipeline | Eseguire la pipeline | Richiamare la pipeline |
| Notebook dell'infrastruttura | N/A | Y |
| Esito negativo | Y | Y |
| Filter | Y | Y |
| Per ogni | Y | Y |
| Functions | Funzione di Azure | Attività della funzione |
| Recupera metadati | Y | Y |
| HDInsight | Attività Hive • Attività Pig • Attività MapReduce • Attività Spark • Attività di streaming | Attività HDInsight |
| Condizione If | Y | Y |
| Ricerca | Y | Y |
| Flusso di dati per mapping | Y | Trasformazioni MDF in Dataflow Gen2 (Anteprima). Power Query in Dataflow Gen2 è disponibile anche come opzione alternativa di riprogettazione. |
| Outlook di Office 365 | N/A | Y |
| Power Query (solo ADF - Flusso di dati di preparazione) | Deprecated | N/A |
| Sceneggiatura | Y | Y |
| Aggiornamento del modello semantico | N/A | Y |
| Imposta variabile | Y | Y |
| Sproc | Y | Y |
| "SSIS" | Y | N/A |
| Procedura memorizzata | Y | Y |
| Interruttore | Y | Y |
| Attività di Synapse Notebook e SJD | Y | N/A |
| Teams | N/A | Y |
| Until | Y | Y |
| Validation | Y | Ottieni metadati e Condizione If |
| Wait | Y | Y |
| Rete Internet | Y | Y |
| Webhook | Y | Y |
| Gestione del flusso di dati | Y | Flusso di dati Gen2 |
Nuove attività in Fabric Data Factory
Oltre a mantenere la continuità delle attività, Fabric Data Factory introduce alcune nuove attività per soddisfare le tue esigenze di orchestrazione più ricche. Queste nuove attività sono:
- Outlook: disponibile in Fabric Data Factory per facilitare l'integrazione con i servizi outlook.
- Teams: disponibile in Fabric Data Factory per abilitare l'orchestrazione delle attività di Microsoft Teams.
- Aggiornamento semantico del modello: disponibile in Fabric Data Factory per migliorare le funzionalità di aggiornamento del modello semantico di Power BI.
- Dataflow Gen2: Disponibile in Fabric Data Factory per trasformazioni basate su Power Query e trasformazioni MDF basate su Spark. Le trasformazioni MDF sono attualmente in anteprima ed eseguite tramite l'attività Dataflow della pipeline.
Per un elenco di tutte le attività di Data Factory di Fabric disponibili, vedere Panoramica delle attività.
Confronto tra connettori
Per un confronto tra tutti i connettori e la relativa disponibilità in Azure Data Factory e Data Factory di Fabric, vedere l'articolo Confronto dei connettori.
Runtime di integrazione auto-ospitata (SHIR) vs. On-premises data gateway (OPDG)
Annotazioni
I servizi supportati da SHIR e OPDG sono diversi:
- Integration Runtime locale: Supporta Data Factory, Azure Synapse Analytics, studio di Azure Machine Learning e Azure Purview.
- Gateway dati locale: supporta Power BI, Power Apps, Power Automate, Azure Analysis Services, Logic Apps, flusso di dati Fabric Gen2, pipeline di Fabric, processo di copia di Fabric e mirroring di Fabric.
| Categoria | Runtime di integrazione self-hosted (SHIR) | Gateway dati interno (OPDG) |
|---|---|---|
| Servizi supportati | - Azure Data Factory - Azure Machine Learning Studio - Azure Synapse Analytics - Azure Purview |
- Power BI - Power Apps - Power Automate - Azure Analysis Services - Applicazioni logiche - Fabric Dataflow Gen2 - Pipeline del Fabric - Attività di copia fabric - Mirroring dell'infrastruttura |
| Installazione e registrazione | - Registrato per chiave - Viene eseguito in modalità servizio |
- Registrato con l'account Microsoft Entra ID - Supporta la modalità utente |
| Piattaforma | -Windows - Immagine del contenitore supportata |
- Solo Windows - Nessun supporto per i contenitori |
| Supporto proxy | - Supportare sia il sistema che il proxy personalizzato | - Supportare il proxy personalizzato |
| Associazione di regione | - Fissato alla regione di Data Factory - Non è possibile modificare l'area predefinita |
- L'area può essere modificata |
| Inoltro personalizzato | - Non supportato | - Supportato: i clienti possono portare il proprio relè |
| Condivisione tra servizi | - Condiviso con un massimo di 120 Data Factory - Non è possibile essere condivisi tra aree di lavoro di Azure Data Factory, Synapse, Purview o Synapse |
- Disponibile per tutti i servizi supportati all'interno di un tenant |
| Disponibilità elevata | - Fino a 8 nodi (4 impostazione predefinita) | - Fino a 10 nodi |
| Recovery | - Richiede la reinstallazione | - Chiave di ripristino supportata |
| Bilanciamento del carico | - Bilanciamento del carico a livello di attività in base al numero di ruoli di lavoro disponibili (CPU e memoria) | - Bilanciamento del carico a livello di query - Opzioni di distribuzione "round robin" o "casuale" |
| Archivio credenziali | - Archiviato localmente nei nodi SHIR - Azure Key Vault supportato |
- Archiviato centralmente nel servizio cloud gateway - Nessuna integrazione di Key Vault |
| Aggiornamento automatico | -Sostenuto | - Non supportato |
| Estendibilità del connettore | - Non supportato | -Sostenuto |
| Creazione interattiva | -Sostenuto | -Sostenuto |
| Collegamento privato per il flusso di controllo | -Sostenuto | - Non supportato |
| Controllo delle versioni | - Due versioni al mese; un push eseguito come aggiornamento automatico - Supporta gli ultimi 12 mesi di rilasci |
- Una versione al mese - Supporta le ultime sei versioni |
| CPU e limitazione della memoria | - Non supportato | -Sostenuto |
| Limiti di velocità effettiva | - Nessun limite rigido; dipendente dalla larghezza di banda di rete | Limiti specifici del servizio: Power Apps / Power Automate / Logic Apps - Scrittura: limite di payload di 2 MB - Lettura: limite di richieste di 2 MB, limite di risposta compresso di 8 MB - Limite URL richiesta GET: 2.048 caratteri Power BI DirectQuery: limite di risposta non compressa di 16 MB |
Rete virtuale gestita di ADF vs. gateway dati della rete virtuale di Fabric
Azure Data Factory (ADF) Managed Rete virtuale e il gateway dati di rete virtuale (VNet) di Fabric consentono entrambi di connettersi alle origini dati in modo sicuro, senza esporle a Internet pubblico. Sebbene entrambe le opzioni supportino la connettività privata per i carichi di lavoro cloud, differiscono in base a come vengono configurate, a chi le gestisce e ai servizi supportati.
Rete virtuale gestita di Azure Data Factory
Microsoft possiede e gestisce l'ambiente di rete. Si ottiene una configurazione semplice, ma non è possibile controllare le impostazioni di rete o le regole del firewall.Fabric VNET data gateway: distribuisci il gateway all'interno della tua rete virtuale Azure. In questo modo è possibile controllare completamente la rete, il firewall e il ridimensionamento. Si decide come il gateway si connette alle risorse e si gestiscono tutte le impostazioni di rete.
Usare la tabella seguente per confrontare le differenze principali e scegliere l'opzione più adatta alle esigenze di governance e carico di lavoro.
| Categoria | ADF Managed VNet | Gateway dati Fabric VNet |
|---|---|---|
| Servizi supportati | Pipeline di Azure Data Factory e Synapse. | Fabric dataflow Gen2, pipeline di dati di Fabric, processo di copia di Fabric, mirroring di Fabric, modelli semantici di Power BI e report paginati di Power BI |
| Proprietà della rete virtuale | Rete virtuale gestita da Microsoft (il cliente non controlla la rete). | Rete virtuale gestita dal cliente (il cliente ha il controllo completo). |
| Endpoint privati | Creazione automatica e gestione da ADF per i servizi supportati (Archiviazione di Azure, database SQL e così via). | I clienti configurano un gateway di rete virtuale per collegare i carichi di lavoro Fabric alle risorse all'interno della loro rete virtuale. |
| Controllo di rete | Limitato: i clienti possono consentire solo il runtime di integrazione della rete virtuale agli endpoint privati. | Controllo completo: il cliente configura il firewall, le regole del gruppo di sicurezza di rete, il routing nella propria rete virtuale. |
| Installazione/distribuzione | Nessuna installazione necessaria; completamente gestito da Microsoft all'interno di una rete virtuale nascosta. | Richiede la distribuzione di un gateway dati della rete virtuale nella rete virtuale del cliente. |
| Disponibilità elevata | Gestito da Microsoft, scalato automaticamente all'interno della rete virtuale di ADF. Passare alla modalità di riserva durante l'attivazione del TTL. | Supporta il ridimensionamento e la disponibilità elevata (cluster basati su nodi), ma viene eseguito all'interno della rete virtuale gestita dal cliente. Supporta fino a sette nodi. |
Funzionalità di Data Factory in Fabric
Fabric Data Factory include Copilot per Data Factory, che usa il linguaggio naturale per creare e gestire pipeline, flussi di dati e altri elementi di Data Factory.
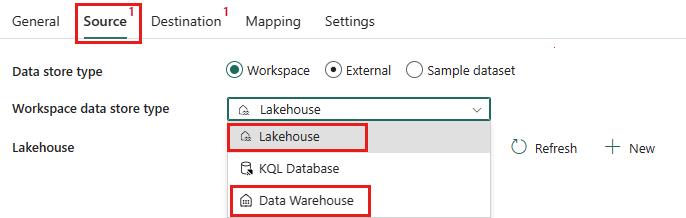
Integrazione nativa tra lakehouse e data warehouse
Uno dei principali vantaggi di Fabric Data Factory è il modo in cui si connette con le piattaforme dati. I lakehouse e i data warehouse in Fabric fungono sia da origini che da destinazioni nelle pipeline, semplificando la creazione di progetti di dati integrati. Le pipeline possono anche operare su tabelle lakehouse supportate dai collegamenti OneLake, consentendo di trasformare e orchestrare i dati da origini esterne (incluse le condivisioni tra tenant) senza prima copiarli nell'area di lavoro.

Notifiche tramite posta elettronica con Office 365
L'attività Office 365 Outlook invia notifiche di posta elettronica personalizzate relative alle esecuzioni della pipeline, allo stato dell'attività e ai risultati.

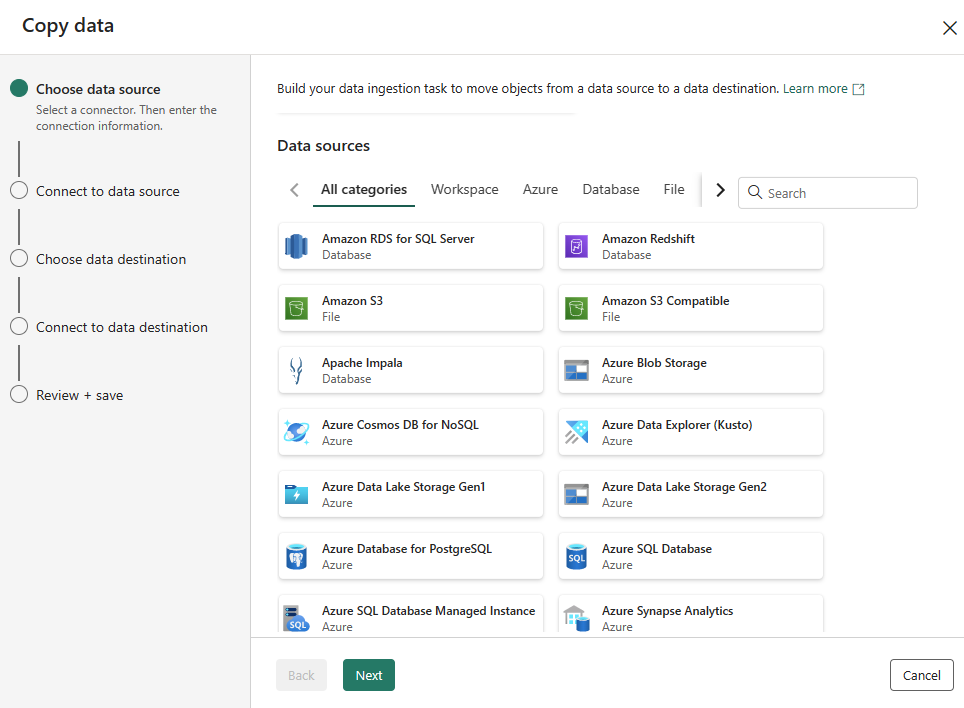
Esperienza di connessione dati semplificata
L'esperienza Recupera dati di Fabric offre una configurazione guidata per le pipeline di copia e le nuove connessioni.

Esperienza CI/CD
Fabric disaccoppia CI/CD dai modelli ARM, in modo da poter selezionare in modo mirato singoli elementi dell'area di lavoro per il check-in, il check-out, la convalida e la collaborazione. Oltre all'integrazione esterna del repository Git, Fabric offre pipeline di distribuzione predefinite che non richiedono un repository esterno.
Informazioni dettagliate sull'hub di monitoraggio e sulle attività
L'hub di monitoraggio di Fabric Data Factory offre visibilità trasversale tra le aree di lavoro su tutti i carichi di lavoro, con la possibilità di analizzare nel dettaglio le singole esecuzioni delle attività.

Per le attività di copia, selezionare il pulsante Dettagli esecuzione (icona occhiali) per visualizzare una suddivisione della durata che mostra per quanto tempo è stata eseguita ogni fase.


Duplicazione rapida della pipeline
Usare la funzionalità Salva con nome per duplicare qualsiasi pipeline esistente. Usarlo per creare copie di sviluppo, varianti di test o configurare flussi di lavoro simili.

Contenuti correlati
Annotazioni
Le nuove funzionalità sviluppate per Fabric Data Factory non vengono riportate alle pipeline di Azure Data Factory o Azure Synapse. Le due piattaforme mantengono roadmap separate. I team del prodotto valutano le richieste di backport in base al feedback della community.
Per altre informazioni, vedere le risorse seguenti:
- Pianifica il tuo aggiornamento da Azure Data Factory a Fabric Data Factory
- Procedure consigliate per il passaggio da Azure Data Factory a Fabric Data Factory
- Trasformazioni di Mapping Flusso di dati in Dataflow Gen2
- Aggiorna le pipeline di Mapping Flusso di dati di Azure Data Factory in Fabric
- Guida ai flussi di dati di Fabric per gli utenti Azure Data Factory Mapping Flusso di dati
- Ottieni la panoramica completa di Fabric Data Factory
- Creare la prima integrazione dei dati in Fabric