Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Si applica a: SQL Server
Durante un cambio di ruolo, l'intervallo di tempo in cui il mirroring del database sarà fuori servizio dipende dal tipo e dalla causa del cambio di ruolo.
Per il failover automatico, i fattori che contribuiscono alla durata dell'interruzione del servizio sono due: il tempo necessario perché il server mirror individui l'errore del server principale, ovvero il rilevamento dell'errore, e il tempo necessario per eseguire il failover del database, ovvero il tempo di failover.
Per un'operazione di servizio forzato, sebbene si sia verificato un errore, il rilevamento e la risoluzione dell'errore dipendono dalla rapidità dell'intervento umano. La potenziale interruzione del servizio può tuttavia essere stimata pari al tempo necessario al server mirror per il cambio di ruolo dopo l'esecuzione del comando di servizio forzato.
Nota
Per ridurre il tempo necessario al rilevamento di condizioni specifiche, ad esempio alcuni tipi di errori, è possibile definire avvisi per tali condizioni.
Nel caso di un failover manuale, è rilevante solo il tempo richiesto per eseguire il failover del database dopo l'esecuzione del comando di failover.
Rilevamento dell'errore
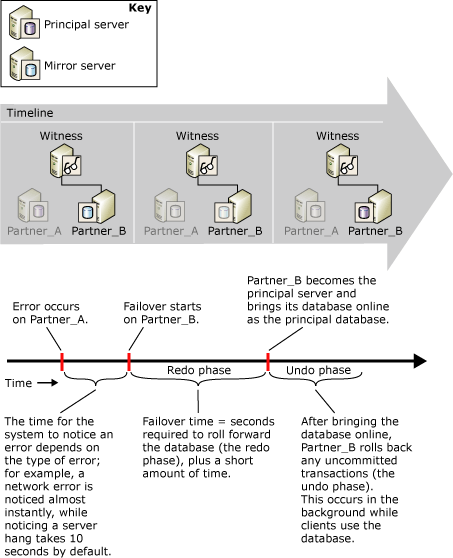
Il periodo di tempo necessario al sistema per rilevare un errore dipende dal tipo di errore. Ad esempio, un errore di rete viene rilevato quasi istantaneamente, mentre il rilevamento della mancata risposta da parte di un server richiede 10 secondi (con il timeout predefinito).
Per informazioni sugli errori che possono causare un esito negativo durante una sessione di mirroring del database e sul rilevamento di timeout in modalità a sicurezza elevata con failover automatico, vedere Possibili errori durante il mirroring del database.
Tempo di failover
Il tempo di failover è composto principalmente dal tempo necessario al server mirror precedente per eseguire il rollforward di tutti i log rimanenti nella propria coda rollforward, più un breve tempo aggiuntivo. Per altre informazioni sulla modalità usata dal server mirror per elaborare i record dei log, vedere Mirroring di database (SQL Server). Per informazioni su come stimare il tempo di failover, consultare la sezione Stima della velocità di redo del failover, più avanti in questo argomento.
Importante
Se il failover si verifica durante una transazione in cui viene creato e quindi modificato un indice o una tabella, per il failover può essere necessario un tempo superiore al normale. Ad esempio, il failover durante la serie di operazioni seguente potrebbe aumentare il tempo di failover: BEGIN TRANSACTION, CREATE INDEX in una tabella e SELECT INTO nella tabella. La possibilità di un failover prolungato durante una transazione di questo tipo permane finché la transazione non viene completata con un'istruzione COMMIT TRANSACTION o ROLLBACK TRANSACTION.
La coda di redo
Il rollforward del database consiste nell'applicare tutti i record di log attualmente presenti nella coda di riesecuzione sul server mirror. La coda di ripetizione è costituita dai record di log che sono stati scritti su disco sul server mirror ma non ancora applicati mediante rollforward al database mirror.
Il tempo di failover del database dipende dalla velocità con cui il server di mirroring è in grado di eseguire il rollforward del log nella coda di ripristino, che a sua volta è determinata principalmente dall'hardware del sistema e dal carico di lavoro corrente. È possibile che, a causa di un carico di lavoro estremamente elevato in un database principale, la velocità con la quale il server principale invia il log al server mirror sia molto più elevata rispetto a quella con la quale ne esegue il rollforward. In questo caso, il failover potrebbe richiedere molto tempo mentre il server mirror applica il log nella coda di redo. Per conoscere la dimensione corrente della coda di ripetizione, utilizzare il contatore Redo Queue nell'oggetto delle prestazioni del mirroring del database. Per altre informazioni, vedere Oggetto Database Mirroring di SQL Server.
Stima del tempo di rollforward durante il failover
È possibile misurare la quantità di tempo necessaria per ripristinare in avanti i record di log, ovvero la frequenza di ripristino, utilizzando una copia di test del database di produzione.
Il metodo utilizzato per stimare il tempo di rollforward durante il failover dipende dal numero di thread utilizzati dal server mirror durante la fase di rollforward. Il numero di thread dipende dagli elementi seguenti:
In SQL Server Standard edition il server mirror usa sempre un thread singolo per eseguire il rollforward del database.
In SQL Server Enterprise edition anche nei server mirror in computer con meno di cinque CPU viene usato unicamente un thread singolo. Con cinque o più CPU, un server di mirroring distribuisce le operazioni di roll forward tra più thread durante un failover (questo è noto come redo parallelo). Il redo parallelo è ottimizzato per utilizzare un thread per ogni quattro CPU.
Stima della velocità di redo a thread singolo
Per il redo a thread singolo, il roll forward del database mirror durante il failover richiede approssimativamente lo stesso tempo del ripristino di un backup del log necessario per eseguire il roll forward della stessa quantità di log. Per stimare il tempo di failover, creare un database di prova nell'ambiente in cui si prevede di eseguire il mirroring. Prelevare quindi un backup del log dal database di produzione. Per misurare il tempo di rollforward relativo al backup del log, verificare il tempo necessario per ripristinare il backup del log con WITH NORECOVERY nel database di prova.
Una volta nota la velocità di redo del server mirror, è possibile stimare il tempo necessario per eseguire il failover del database in un dato momento dividendo la quantità del log corrente da rieseguire sul mirror (come misurata dal contatore delle prestazioni Redo Queue) per la velocità di redo. In condizioni normali, se il server mirror riesce a tenere il passo con il carico proveniente dal server principale, la coda di ripristino è ridotta o prossima allo zero e un failover richiede solo pochi secondi.
Stima della velocità di redo parallelo
Nell'edizione Enterprise di SQL Server, il redo parallelo è ottimizzato per usare un thread per ogni quattro CPU. Per stimare il tempo di roll forward per il parallel redo, è più accurato accedere a un sistema di test in esecuzione che a un database di test. Durante il monitoraggio della coda di redo sul server mirror, aumentare il carico sul server principale. Durante il normale funzionamento, la coda di ripetizione è prossima allo zero. Aumentare il carico sul server principale fino a quando la coda di redo non inizia a crescere continuamente; il sistema è quindi alla sua velocità massima di redo e il contatore delle prestazioni Byte di redo/sec in questo momento rappresenta la velocità massima di redo. Per altre informazioni, vedere Oggetto Database Mirroring di SQL Server.
Stima dell'interruzione del servizio durante il failover automatico
Nella figura seguente viene illustrato in quale modo il rilevamento dell'errore e il tempo di failover determinano il tempo necessario per il completamento di un failover automatico su Partner_B. Il failover richiede il tempo necessario per portare avanti il database fino allo stato più recente (fase di redo), più un breve intervallo necessario per rendere il database disponibile. La fase di annullamento, che comporta il rollback di tutte le transazioni non sottoposte a commit, avviene dopo che il nuovo database primario viene messo online e continua dopo il failover. Durante la fase di rollback, il database è disponibile.