Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Si applica a: SQL ServerDatabase SQL di AzureIstanza gestita di SQL di AzureAzure Synapse AnalyticsDatabase SQL in Microsoft Fabric
SQL Server usa join per recuperare dati da più tabelle in base alle relazioni logiche tra di esse. I join sono fondamentali per le operazioni di database relazionali e consentono di combinare i dati di due o più tabelle in un singolo set di risultati.
SQL Server implementa sia operazioni di join logico (definite dalla sintassi di Transact-SQL) che operazioni di join fisico (gli algoritmi effettivi usati per eseguire i join). Comprendere entrambi gli aspetti consente di scrivere query efficienti e ottimizzare le prestazioni del database.
Le operazioni di join logiche includono:
- Inner join
- Left, right e full outer join
- Cross join
Le operazioni di join fisico includono:
- Join con loop annidati
- Merge join
- Hash join
- Join adattivi (si applica a: SQL Server 2017 (14.x) e versioni successive)
Questo articolo illustra come funzionano i join, quando usare tipi di join diversi e in che modo Query Optimizer seleziona l'algoritmo di join più efficiente in base a fattori quali le dimensioni della tabella, gli indici disponibili e la distribuzione dei dati.
Note
Per altre informazioni sulla sintassi di JOIN, vedere clausola FROM e JOIN, APPLY, PIVOT.
Nozioni fondamentali sul join
I join consentono di recuperare dati da due o più tabelle in base alle relazioni logiche esistenti tra le tabelle stesse. I join indicano la modalità con cui SQL Server usa i dati di una tabella per la selezione di righe in un'altra tabella.
Una condizione di join definisce il modo in cui due tabelle sono correlate in una query in base agli elementi seguenti:
- Specificare la colonna da ciascuna tabella da utilizzare per il join. In una condizione di join tipica viene specificata una chiave esterna di una tabella e la chiave associata nell'altra tabella.
- L'indicazione di un operatore logico, ad esempio = o <>, da usare per il confronto dei valori delle colonne.
I join vengono espressi logicamente usando la sintassi Transact-SQL seguente:
[ INNER ] JOINLEFT [ OUTER ] JOINRIGHT [ OUTER ] JOINFULL [ OUTER ] JOINCROSS JOIN
Gli inner join possono essere specificati nelle clausole FROM o WHERE. Le join esterne e le join incrociate possono essere specificate solo nella clausola FROM. Le condizioni di join vengono usate insieme alle condizioni di ricerca delle clausole WHERE e HAVING per definire le righe da selezionare nelle tabelle di base a cui viene fatto riferimento nella clausola FROM.
L'impostazione delle condizioni di join nella clausola FROM consente di separare queste condizioni da altre condizioni di ricerca specificate nella clausola WHERE. Corrisponde anche al metodo consigliato per l'impostazione dei join. La sintassi ISO semplificata per la definizione di un join nella clausola FROM è la seguente:
FROM first_table < join_type > second_table [ ON ( join_condition ) ]
- join_type specifica il tipo di join da eseguire: inner, outer o cross join. Per spiegazioni dei diversi tipi di join, vedere clausola FROM.
- La join_condition definisce il predicato da valutare per ogni coppia di righe combinate tramite join.
Il seguente codice è un esempio di specifica di join nella clausola FROM:
FROM Purchasing.ProductVendor INNER JOIN Purchasing.Vendor
     ON ( ProductVendor.BusinessEntityID = Vendor.BusinessEntityID )
Il seguente codice è un'istruzione SELECT semplice che usa tale join:
SELECT ProductID, Purchasing.Vendor.BusinessEntityID, Name
FROM Purchasing.ProductVendor INNER JOIN Purchasing.Vendor
    ON (Purchasing.ProductVendor.BusinessEntityID = Purchasing.Vendor.BusinessEntityID)
WHERE StandardPrice > $10
  AND Name LIKE N'F%';
GO
L'istruzione SELECT restituisce informazioni sul prodotto e sul fornitore per ogni combinazione di prodotti con prezzo maggiore di $ 10 fornito da una società il cui nome inizia con la lettera F.
Se in una singola query viene fatto riferimento a più tabelle, nessuno dei riferimenti alle colonne deve presentare ambiguità. Nell'esempio precedente entrambe le tabelle ProductVendor e Vendor includono una colonna denominata BusinessEntityID. I nomi di colonna duplicati in due o più tabelle a cui viene fatto riferimento nella query devono essere qualificati con il nome della tabella. Nell'esempio, tutti i riferimenti alle colonne Vendor sono qualificati.
Quando un nome di colonna non viene duplicato in due o più tabelle usate nella query, i riferimenti non devono essere qualificati con il nome della tabella. come illustrato nell'esempio precedente.
SELECT Una clausola di questo tipo è talvolta difficile da comprendere perché non c'è nulla da indicare la tabella che ha fornito ogni colonna. La query risulta più leggibile se tutte le colonne sono qualificate con i nomi delle rispettive tabelle. Il grado di leggibilità aumenta ulteriormente se si utilizzano gli alias di tabella, soprattutto quando è necessario qualificare anche i nomi delle tabelle con il nome del database e del proprietario. Il seguente codice equivale all'esempio precedente. Per rendere la query più leggibile, sono stati però assegnati alias alle tabelle e i nomi di colonna sono stati qualificati con gli alias di tabella:
SELECT pv.ProductID, v.BusinessEntityID, v.Name
FROM Purchasing.ProductVendor AS pv
INNER JOIN Purchasing.Vendor AS v
    ON (pv.BusinessEntityID = v.BusinessEntityID)
WHERE StandardPrice > $10
    AND Name LIKE N'F%';
Negli esempi precedenti le condizioni di join sono specificate nella clausola FROM (metodo consigliato). La query seguente contiene la stessa condizione di join specificata nella clausola WHERE:
SELECT pv.ProductID, v.BusinessEntityID, v.Name
FROM Purchasing.ProductVendor AS pv, Purchasing.Vendor AS v
WHERE pv.BusinessEntityID=v.BusinessEntityID
    AND StandardPrice > $10
    AND Name LIKE N'F%';
L'elenco SELECT per un join può fare riferimento a tutte le colonne delle tabelle coinvolte nel join oppure a un qualsiasi sottoinsieme delle colonne. L'elenco SELECT non è tenuto a contenere colonne da ogni tabella nel join. Ad esempio, in un join tra tre tabelle, è possibile utilizzare una sola tabella come ponte da una delle altre tabelle alla terza tabella e nessuna delle colonne della tabella intermedia deve essere necessariamente referenziata nell'elenco SELECT. Questa operazione si chiama anche anti semi join.
Sebbene le condizioni di join includano in genere confronti di uguaglianza (=), è possibile specificare altri operatori di confronto o relazionali e altri predicati. Per altre informazioni, vedere Operatori di confronto e WHERE.
Durante l'elaborazione di join in SQL Server, Query Optimizer sceglie il metodo di elaborazione del join più efficiente tra quelli possibili. Ciò include la scelta del tipo di join fisico più efficiente, l'ordine in cui verranno unite le tabelle e anche l'uso di tipi di operazioni di join logico che non possono essere espresse direttamente con Transact-SQL sintassi, ad esempio semi join e anti semi join. L'esecuzione fisica di vari join può usare molte ottimizzazioni diverse e pertanto non può essere stimata in modo affidabile. Per ulteriori informazioni sui semi join e anti semi join, vedere Riferimento agli operatori showplan logici e fisici.
Le colonne usate in una condizione di join non devono avere lo stesso nome o essere lo stesso tipo di dati. Tuttavia, se i tipi di dati non sono identici, devono essere compatibili o essere tipi che SQL Server può convertire in modo implicito. Se i tipi di dati non possono essere convertiti in modo implicito, la condizione di join deve convertire in modo esplicito il tipo di dati usando la CAST funzione . Per altre informazioni sulle conversioni implicite ed esplicite, vedere Conversione del tipo di dati (motore di database).
La maggior parte delle query che includono un join possono essere riformulate specificando una subquery, ovvero una query nidificata in un'altra query. La maggior parte delle subquery possono a loro volta essere riformulate come join. Per ulteriori informazioni sulle sottoquery, vedere Sottoquery (SQL Server).
Note
Le tabelle non possono essere messe direttamente in join su colonne di tipo ntext, text o image. Tuttavia, è possibile collegare indirettamente le tabelle su colonne di tipo ntext, text o image mediante SUBSTRING.
Ad esempio, SELECT * FROM t1 JOIN t2 ON SUBSTRING(t1.textcolumn, 1, 20) = SUBSTRING(t2.textcolumn, 1, 20) esegue un inner join tra due tabelle sui primi 20 caratteri di ogni colonna di tipo text delle tabelle t1 e t2.
È possibile anche confrontare colonne di tipo ntext e text di due tabelle confrontando la lunghezza delle colonne con una clausola WHERE, come illustrato nell'esempio seguente: WHERE DATALENGTH(p1.pr_info) = DATALENGTH(p2.pr_info)
Comprendere i join con cicli annidati
Se l'input di un join è ridotto (inferiore a 10 righe) e l'input dell'altro join è molto esteso e indicizzato in base alle rispettive colonne di join, l'operazione di join più rapida è rappresentata dai nested loop join indicizzati poiché questi richiedono la minore quantità di I/O e il minor numero di operazioni di confronto.
Il join con cicli annidati, detto anche iterazione annidata, usa un input del join come tabella esterna di input (mostrata come input superiore nel piano di esecuzione grafico) e uno come tabella interna di input (inferiore). Il ciclo esterno elabora la tabella di input esterna, una riga alla volta. Il ciclo interno, eseguito per ogni riga esterna, cerca le righe corrispondenti nella tabella di input interna.
Nel caso più semplice, ovvero un join a cicli annidati di tipo naive, la ricerca comporta l'analisi di un'intera tabella o indice. Se la ricerca sfrutta un indice, viene chiamato join con cicli annidati sull'indice. Se l'indice viene compilato come parte del piano di query (e eliminato al completamento della query), viene chiamato join di cicli annidati di indice temporaneo. Tutte queste varianti vengono elaborate da Query Optimizer.
Un nested loop join è particolarmente efficace se l'input esterno è di dimensioni ridotte mentre l'input interno è preindicizzato e di dimensioni notevoli. In molte transazioni di dimensioni ridotte, ad esempio quelle relative a set di righe limitati, i nested loop join indicizzati offrono prestazioni superiori rispetto ai merge join e agli hash join. Per le query di notevoli dimensioni, tuttavia, i nested loop join rappresentano raramente la scelta ottimale.
Quando l'attributo OPTIMIZED dell'operatore di join a cicli annidati viene impostato su True, significa che vengono usati cicli annidati ottimizzati (o l'ordinamento in batch) per ridurre al minimo le operazioni di I/O quando la tabella interna è di grandi dimensioni, indipendentemente dal fatto che sia parallelizzata o meno. La presenza di questa ottimizzazione in un determinato piano potrebbe non essere ovvia durante l'analisi di un piano di esecuzione, dato che l'ordinamento stesso è un'operazione nascosta. La presenza dell'attributo OPTIMIZED nel codice XML del piano, tuttavia, indica che il join a cicli annidati potrebbe tentare di riordinare le righe di input per migliorare le prestazioni di I/O.
Merge join
Se i due input di join non sono piccoli ma sono ordinati in base alla loro colonna di join (ad esempio, se sono stati ottenuti scansionando indici ordinati), il join merge è l'operazione di join più veloce. Se entrambi gli input di join sono di dimensioni notevoli e analoghe, un merge join con ordinamento eseguito in precedenza e un hash join offrono prestazioni simili. Le operazioni di hash join, tuttavia, risultano spesso molto più rapide se le dimensioni dei due input differiscono in modo significativo.
Il merge join richiede che entrambi gli input siano ordinati in base alle colonne di merge, specificate dalle clausole di uguaglianza (ON) del predicato di join. Il Query Optimizer esegue in genere la scansione di un indice, se ne esiste uno sull'insieme appropriato di colonne, oppure colloca un operatore di ordinamento sotto il merge join. In casi rari, possono esserci più clausole di uguaglianza, ma le colonne di unione vengono prese solo da alcune delle clausole di uguaglianza disponibili.
Poiché ogni input è ordinato, l'operatore Merge Join recupera una riga da ogni input ed esegue il confronto tra le righe. Ad esempio, per operazioni di inner join, le righe vengono restituite se sono uguali. Se non sono uguali, la riga con valore inferiore viene eliminata e un'altra riga viene ottenuta da tale input. Questo processo si ripete fino al completamento dell'elaborazione di tutte le righe.
L'operazione di merge join è un'operazione regolare o un'operazione molti-a-molti. Un join di merge molti-a-molti utilizza una tabella temporanea per memorizzare le righe. Se sono presenti valori duplicati in entrambi gli input, uno degli input deve tornare all'inizio dei duplicati durante l'elaborazione di ogni duplicato dell'altro input.
Se è presente un predicato residuo, tutte le righe conformi al predicato di merge vengono valutate da tale predicato e vengono restituite soltanto quelle che lo soddisfano.
Il merge join è di per sé un'operazione molto rapida, ma può essere una scelta onerosa se sono necessarie operazioni di ordinamento. Se tuttavia il volume dei dati è elevato ed è possibile ottenere i dati desiderati già ordinati da indici ad albero B esistenti, il merge join risulta spesso l'algoritmo di join più veloce.
Hash join
Gli hash join consentono l'elaborazione efficiente di input di grandi dimensioni, non ordinati e non indicizzati. Sono utili per i risultati intermedi nelle query complesse perché:
- I risultati intermedi non vengono indicizzati (a meno che non vengano salvati in modo esplicito su disco e quindi indicizzati) e spesso non siano ordinati in modo appropriato per l'operazione successiva nel piano di query.
- Query Optimizer stima esclusivamente le dimensioni dei risultati intermedi. Poiché le stime relative a query complesse possono essere estremamente imprecise, è necessario non solo che gli algoritmi di elaborazione dei risultati intermedi siano efficienti, ma anche che vengano ridotti gradualmente nel caso in cui un risultato intermedio risulti molto più grande del previsto.
Gli hash join consentono di ridurre la denormalizzazione. In genere, la denormalizzazione viene utilizzata per ottenere prestazioni migliori tramite la riduzione delle operazioni di join, nonostante rischi di ridondanza quali aggiornamenti non consistenti. Gli hash join riducono la necessità di utilizzo della denormalizzazione. Gli hash join rendono il partizionamento verticale (la rappresentazione di gruppi di colonne di un'unica tabella in file o indici separati) un'opzione adeguata per la progettazione fisica dei database.
Gli hash join prevedono due tipi di input, ovvero l'input di compilazione e l'input probe. L'ottimizzatore di query assegna questi ruoli in modo che il più piccolo dei due input sia l'input di compilazione.
Gli hash join vengono utilizzati per molti tipi di operazioni di corrispondenza tra insiemi: inner join; left, right e full outer join; left e right semi-join; intersezione; unione; e differenza. Una variante dell'hash join può anche eseguire la rimozione dei duplicati e il raggruppamento, ad esempio SUM(salary) GROUP BY department. Queste modifiche utilizzano un unico input sia per il ruolo di build sia per il ruolo di sonda.
Nelle sezioni seguenti vengono descritti i diversi tipi di hash join: hash join in memoria, grace hash join e hash join ricorsivo.
Hash join in memoria
L'hash join esegue in primo luogo l'analisi o il calcolo dell'intero input di compilazione, quindi compila una tabella hash in memoria. Ogni riga viene inserita in un hash bucket in base al valore hash calcolato per la chiave hash. Se l'intero input di compilazione è inferiore alla memoria disponibile, tutte le righe possono essere inserite nella tabella hash. Questa fase di compilazione è seguita dalla fase di sondaggio. Viene eseguita l'analisi o il calcolo dell'intero input probe, una riga alla volta. Per ogni riga probe viene calcolato il valore della chiave hash, viene eseguita l'analisi dell'hash bucket corrispondente e vengono prodotte le corrispondenze.
Grace hash join (tecnica di giunzione dei dati nei database)
Se l'input di build non entra in memoria, un hash join si svolge in più fasi. In questo caso, l'hash join viene definito grace hash join. Ogni passaggio prevede una fase di compilazione e una fase di sondaggio. Inizialmente, l'intero input di build e l'intero input di probe vengono elaborati e partizionati in più file, utilizzando una funzione hash applicata alle chiavi hash. L'utilizzo della funzione di hashing sulle chiavi hash garantisce che ogni coppia di record su cui si basa il join si trovi nella stessa coppia di file. Pertanto, il compito di unire due input di grandi dimensioni è stato ricondotto a più istanze, ma più piccole, della stessa operazione. L'hash join viene quindi applicato a ogni coppia di file partizionati.
Hash join ricorsivo
Se l'input di compilazione ha dimensioni tali per cui gli input per un'unione esterna standard richiedono più livelli di unione, saranno necessari più passaggi di partizionamento e più livelli di partizionamento. Se soltanto alcune partizioni sono di grandi dimensioni, i passaggi di partizionamento aggiuntivi vengono utilizzati soltanto per tali partizioni. Per velocizzare al massimo i passaggi di partizionamento vengono utilizzate operazioni di I/O asincrone di grandi dimensioni, per cui un unico thread può tenere occupate più unità disco.
Note
Se l'input di compilazione non ha dimensioni di molto superiori a quelle della memoria disponibile, gli elementi dell'hash join in memoria e del grace hash join vengono combinati in un unico passaggio, producendo un hash join ibrido.
Non è sempre possibile durante l'ottimizzazione determinare quale hash join viene usato. Pertanto, SQL Server usa inizialmente un hash join in memoria, quindi passa gradualmente a grace hash join e hash join ricorsivo a seconda delle dimensioni dell'input di compilazione.
Se Query Optimizer non prevede correttamente quale dei due input è il più piccolo, al quale quindi deve essere assegnato il ruolo di input di compilazione, i ruoli di input di compilazione e di input probe vengono invertiti dinamicamente. L'hash join si assicura di utilizzare il file di overflow più piccolo come input di build. Questa tecnica è detta inversione dei ruoli. L'inversione dei ruoli si verifica all'interno dell'hash join dopo l'esecuzione di almeno uno spill sul disco.
Note
L'inversione dei ruoli si verifica indipendentemente da qualsiasi hint di query o struttura. L'inversione del ruolo non viene visualizzata nel piano di query; quando si verifica, è trasparente per l'utente.
salvataggio hash
Il termine hash bailout è talvolta usato per descrivere grace hash join o hash join ricorsivi.
Note
Gli hash join ricorsivi e gli hash bailout causano una riduzione delle prestazioni del server. Se si osservano molti eventi Hash Warning in una traccia, aggiornare le statistiche sulle colonne usate in un join.
Per altre informazioni sugli hash bailout, vedere Hash Warning - classe di evento.
Join adattivi
Modalità batch I join adattivi consentono di rimandare a dopo la scansione del primo input la scelta tra l'esecuzione di un metodo hash join e l'esecuzione di un metodo join a cicli annidati. L'operatore Adaptive Join definisce una soglia che viene utilizzata per stabilire quando passare a un piano Nested Loops. Un piano di query può quindi passare dinamicamente a una migliore strategia di join durante l'esecuzione senza dover essere ricompilato.
Tip
I carichi di lavoro con frequenti oscillazioni tra scansioni di input delle operazioni di join di piccole e grandi dimensioni trarranno il massimo vantaggio da questa funzionalità.
La decisione in fase di esecuzione è basata sui passaggi seguenti:
- Se il conteggio delle righe dell'input del join di compilazione è così ridotto che un join a cicli annidati è preferibile a un hash join, il piano passa a un algoritmo a cicli annidati.
- Se l'input del join di compilazione supera una determinata soglia di numero di righe, non si verifica alcun cambiamento e il piano continua con un hash join.
La query seguente viene usata per illustrare un esempio di Adaptive Join:
SELECT [fo].[Order Key], [si].[Lead Time Days], [fo].[Quantity]
FROM [Fact].[Order] AS [fo]
INNER JOIN [Dimension].[Stock Item] AS [si]
       ON [fo].[Stock Item Key] = [si].[Stock Item Key]
WHERE [fo].[Quantity] = 360;
La query restituisce 336 righe. Se si attiva Statistiche query dinamiche, viene visualizzato il piano seguente:

Nel piano notare quanto segue:
- Una scansione dell'indice columnstore usata per fornire righe per la fase di costruzione del join hash.
- Il nuovo operatore di join adattivo. Questo operatore definisce una soglia utilizzata per decidere quando passare a un piano Nested Loops. In questo esempio la soglia corrisponde a 78 righe. Qualsiasi elemento con >= 78 righe userà un Hash join. Se è al di sotto della soglia, verrà utilizzato un join a cicli annidati.
- Dato che la query restituisce 336 righe, questa soglia viene superata e pertanto il secondo ramo rappresenta la fase di probe di un'operazione hash join standard. Le statistiche delle query in tempo reale visualizzano le righe che passano attraverso gli operatori, in questo caso "672 di 672".
- E l'ultimo ramo è una ricerca su indice clusterizzato, che sarebbe stata usata dal join a cicli annidati qualora la soglia non fosse stata superata. Vediamo visualizzate "0 di 336" righe (il ramo non è utilizzato).
Confronta ora il piano con la stessa query, ma quando il valore Quantity corrisponde a una sola riga nella tabella:
SELECT [fo].[Order Key], [si].[Lead Time Days], [fo].[Quantity]
FROM [Fact].[Order] AS [fo]
INNER JOIN [Dimension].[Stock Item] AS [si]
       ON [fo].[Stock Item Key] = [si].[Stock Item Key]
WHERE [fo].[Quantity] = 361;
L'interrogazione restituisce una riga. Con l'abilitazione di Statistiche query dinamiche viene visualizzato il piano seguente:

Nel piano notare quanto segue:
- Una volta restituita una riga, la ricerca nell'indice cluster ora contiene un flusso di righe.
- Poiché la fase di build dell'Hash Join non è proseguita, non ci sono righe che fluiscono attraverso il secondo ramo.
Osservazioni per i join adattivi
I join adattivi comportano un maggiore utilizzo di memoria rispetto a un piano equivalente con join Nested Loops indicizzato. La memoria aggiuntiva viene richiesta come se il join Nested Loops fosse un join Hash. C'è anche un sovraccarico per la fase di build, in quanto operazione stop-and-go, rispetto a un join equivalente di tipo Nested Loops in streaming. A tale costo aggiuntivo corrisponde una maggior flessibilità per gli scenari in cui i conteggi delle righe variano nell'input di compilazione.
I join adattivi in modalità batch funzionano per l'esecuzione iniziale di un'istruzione e, una volta compilati, le esecuzioni successive rimangono adattive in base alla soglia compilata di Adaptive Join e alle righe elaborate in fase di esecuzione che attraversano la fase di build dell'input esterno.
Se un join adattivo passa al funzionamento con cicli annidati usa le righe già lette dalla compilazione hash join. L'operatore non legge di nuovo le righe del riferimento esterno.
Monitorare l'attività di join adattivo
L'operatore Adaptive Join ha i seguenti attributi dell'operatore del piano di esecuzione:
| Attributo del piano | Description |
|---|---|
| AdaptiveThresholdRows | Visualizza l'uso della soglia che determina il passaggio da un hash join a un join a cicli annidati. |
| EstimatedJoinType | Quale potrebbe essere il tipo di join. |
| ActualJoinType | In un piano di esecuzione reale, visualizza quale algoritmo di join è stato infine scelto in base alla soglia. |
Il piano stimato visualizza la forma del piano Adaptive Join, insieme a una soglia Adaptive Join definita e al tipo di join stimato.
Tip
Query Store acquisisce e può imporre un piano di join adattivo in modalità batch.
Istruzioni idonee per i join adattivi
Alcune condizioni rendono un join logico idoneo per un join adattivo in modalità batch:
- Il livello di compatibilità del database è 140 o superiore.
- La query è un'istruzione
SELECT(attualmente le istruzioni di modifica dei dati non sono idonee). - Il join è idoneo per l'esecuzione in un algoritmo fisico di join a cicli annidati indicizzati o di hash join.
- L'Hash join usa la modalità Batch, abilitata dalla presenza di un indice columnstore nell'intera query, dal riferimento diretto nel join a una tabella con indice columnstore oppure tramite l'uso di Batch mode on rowstore.
- Il primo elemento figlio (riferimento esterno) deve essere identico per le soluzioni alternative generate dal join a cicli annidati e dall'hash join.
Righe di soglia adattive
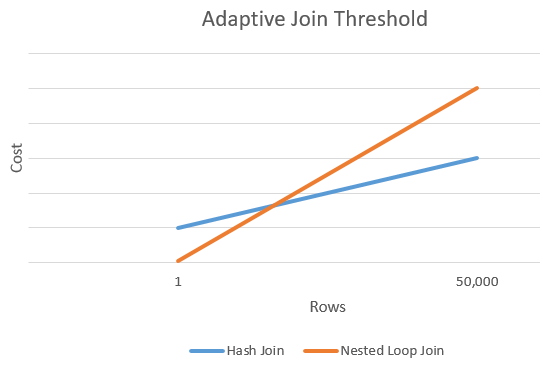
Il grafico seguente visualizza un esempio di intersezione tra il costo di un hash join e il costo di un join a cicli annidati alternativo. In questo punto di intersezione viene determinata la soglia, che a sua volta determina l'algoritmo usato per l'operazione di join.
Disabilitare i join adattivi senza modificare il livello di compatibilità
È possibile disabilitare i join adattivi a livello di database o di istruzione, pur mantenendo il livello di compatibilità del database pari a 140 o superiore.
Per disabilitare i join adattivi per tutte le esecuzioni di query provenienti dal database, eseguire l'istruzione seguente all'interno del contesto del database applicabile:
-- SQL Server 2017
ALTER DATABASE SCOPED CONFIGURATION SET DISABLE_BATCH_MODE_ADAPTIVE_JOINS = ON;

-- Azure SQL Database, SQL Server 2019 and later versions
ALTER DATABASE SCOPED CONFIGURATION SET BATCH_MODE_ADAPTIVE_JOINS = OFF;
Quando è abilitata, questa impostazione viene visualizzata come abilitata in sys.database_scoped_configurations.
Per abilitare nuovamente i join adattivi per tutte le esecuzioni di query provenienti dal database, eseguire l'istruzione seguente all'interno del contesto del database applicabile:
-- SQL Server 2017
ALTER DATABASE SCOPED CONFIGURATION SET DISABLE_BATCH_MODE_ADAPTIVE_JOINS = OFF;

-- Azure SQL Database, SQL Server 2019 and later versions
ALTER DATABASE SCOPED CONFIGURATION SET BATCH_MODE_ADAPTIVE_JOINS = ON;
È inoltre possibile disabilitare i join adattivi per una query specifica specificando DISABLE_BATCH_MODE_ADAPTIVE_JOINS come suggerimento di query USE HINT. Per esempio:
SELECT s.CustomerID,
       s.CustomerName,
       sc.CustomerCategoryName
FROM Sales.Customers AS s
LEFT OUTER JOIN Sales.CustomerCategories AS sc
       ON s.CustomerCategoryID = sc.CustomerCategoryID
OPTION (USE HINT('DISABLE_BATCH_MODE_ADAPTIVE_JOINS'));
Note
Un USE HINT hint di query ha la precedenza su una configurazione con ambito database o su un'impostazione del flag di traccia a livello di database.
Valori null e join
Quando nelle colonne delle tabelle sottoposte a join sono presenti valori null, i valori null non corrispondono tra loro. La presenza di valori null in una colonna di una delle tabelle coinvolte nel join può essere restituita solo usando un outer join, a meno che la clausola WHERE non escluda i valori null.
Le due tabelle riportate di seguito includono entrambe NULL nella colonna interessata dal join:
table1                          table2
a           b                   c            d
-------     ------              -------      ------
      1        one                 NULL         two
   NULL      three                    4        four
      4      join4
Un join che confronta i valori nella colonna con la colonna ac non ottiene una corrispondenza nelle colonne con valori di NULL:
SELECT *
FROM table1 t1 JOIN table2 t2
   ON t1.a = t2.c
ORDER BY t1.a;
GO
Viene restituita una sola riga con valore 4 nelle colonne a e c:
a           b      c           d
----------- ------ ----------- ------
4           join4  4           four

(1 row(s) affected)
I valori Null restituiti da una tabella di base non sono inoltre facilmente distinguibili dai valori Null restituiti da un outer join. Ad esempio, la seguente istruzione SELECT esegue un join esterno sinistro su queste due tabelle:
SELECT *
FROM table1 t1 LEFT OUTER JOIN table2 t2
   ON t1.a = t2.c
ORDER BY t1.a;
GO
Il set di risultati è il seguente.
a           b      c           d
----------- ------ ----------- ------
NULL        three  NULL        NULL
1           one    NULL        NULL
4           join4  4           four

(3 row(s) affected)
I risultati non consentono di distinguere facilmente un NULL nei dati da un NULL che rappresenta una mancata join. Quando NULL i valori sono presenti nei dati aggiunti, è in genere preferibile ometterli dai risultati usando un join normale.