Progettare la logica di inserimento e la configurazione dell'origine dati
La progettazione della logica di inserimento richiede di prendere decisioni critiche sul modo in cui i dati si spostano dai sistemi di origine ad Azure Databricks. Queste decisioni influiscono sull'aggiornamento dei dati, sull'efficienza di elaborazione e sull'affidabilità del sistema. Prima di selezionare strumenti o scrivere codice, è necessario comprendere le caratteristiche delle origini dati e definire strategie di estrazione allineate ai requisiti aziendali.
In questa unità vengono esaminate le considerazioni principali sulla progettazione per la logica di inserimento dati e la configurazione dell'origine dati in Azure Databricks. L'attenzione è rivolta alla logica concettuale e ai modelli di progettazione. I dettagli specifici relativi alla selezione e all'implementazione degli strumenti sono trattati in unità successive.
Comprendere i tipi di estrazione
Il tipo di estrazione determina la modalità di acquisizione dei dati dai sistemi di origine e influisce sia sulla tempestività che sull'efficienza della pipeline di dati. Azure Databricks supporta tre modelli di estrazione principali, ognuno adatto a scenari diversi.
Estrazione completa
L'estrazione completa legge l'intero set di dati dal sistema di origine durante ogni esecuzione di inserimento.

Questo approccio funziona bene quando:
- I sistemi di origine non supportano il rilevamento delle modifiche
- I volumi di dati sono sufficientemente piccoli da rielaborare in modo efficiente
- È necessario ricompilare periodicamente le tabelle di destinazione da zero
- Le relazioni tra dati sono complesse e la logica incrementale sarebbe soggetta a errori
L'estrazione completa diventa poco pratica man mano che i volumi di dati aumentano. La rielaborazione di milioni di record quando solo poche migliaia sono cambiati spreca risorse di calcolo e ritarda i consumatori a valle.
Estrazione incrementale
L'estrazione incrementale elabora solo record nuovi o modificati dall'ultima esecuzione dell'inserimento. Il motore tiene traccia dei dati elaborati e delle query solo per gli aggiornamenti.

Questo modello richiede:
- Indicatore di modifica affidabile nei dati di origine (timestamp, numero di sequenza o colonna della versione)
- Gestione dello stato per tenere traccia dell'ultima posizione elaborata
- Logica per processare i record in ritardo o fuori ordine
L'estrazione incrementale migliora significativamente l'efficienza per set di dati di grandi dimensioni. Invece di leggere milioni di righe, è possibile elaborare solo migliaia di modifiche per esecuzione.
Estrazione dello streaming
L'estrazione di streaming offre un'acquisizione dei dati quasi in tempo reale tramite l'elaborazione continua. Anziché essere in esecuzione in base a una pianificazione, i processi di streaming rimangono attivi ed elaborano i record non appena arrivano.

Prendere in considerazione lo streaming quando:
- I processi aziendali richiedono l'aggiornamento dei dati misurato in secondi o minuti
- I sistemi di origine pubblicano eventi sui bus di messaggi o nei feed di modifiche
- È necessario reagire agli eventi man mano che si verificano
L'estrazione di streaming richiede un'infrastruttura sempre attiva, ma offre la latenza più bassa per la disponibilità dei dati.
Progettare per il *Change Data Capture*
Change Data Capture (CDC) è un modello di estrazione specializzato che acquisisce le singole modifiche a livello di riga, inclusi inserimenti, aggiornamenti ed eliminazioni. CDC differisce dalla semplice estrazione incrementale perché mantiene il tipo di operazione per ogni modifica.

Quando si progetta per CDC, considerare il modo in cui il sistema di origine produce record di modifica:
- Log delle transazioni di database: i database come SQL Server possono esporre modifiche a livello di riga usando la funzionalità CDC basata sul log delle transazioni. I sistemi downstream, ad esempio Azure Databricks, possono quindi leggere queste modifiche ed elaborarle come parte della pipeline di inserimento.
- Flussi di dati delle modifiche: Le tabelle Delta e alcuni database come Azure Cosmos DB forniscono un monitoraggio delle modifiche integrato che evidenzia i cambiamenti di riga con i metadati.
- Snapshot periodici: alcuni sistemi non supportano CDC continuo, che richiede di confrontare gli snapshot per determinare le modifiche.
CDC abilita i casi d'uso che l'estrazione incrementale semplice non può supportare. È possibile replicare in modo accurato le eliminazioni, gestire i audit trail ed elaborare gli aggiornamenti che modificano le colonne chiave.
Annotazioni
CDC richiede informazioni di sequenziazione per gestire correttamente gli eventi non ordinati. I dati di origine devono avere una colonna (ad esempio un timestamp o un numero di sequenza) che stabilisce l'ordine corretto delle modifiche.
Identificare le caratteristiche del tipo di file di origine
Quando i dati arrivano come file anziché da sistemi transazionali, il formato del file influisce sulla progettazione dell'inserimento. Ogni formato ha caratteristiche distinte che influiscono sull'elaborazione.

Formati basati su testo
I file CSV e JSON sono formati di origine comuni perché sono leggibili e ampiamente supportati. Tuttavia, presentano sfide per l'elaborazione efficiente:
- Variabilità dello schema: i file potrebbero avere ordini di colonna incoerenti, campi mancanti o variazioni del tipo di dati
- Nessuna efficienza di compressione: i formati di testo in genere utilizzano più spazio di archiviazione rispetto alle alternative binarie
- Sovraccarico di analisi: ogni valore richiede la conversione da testo a tipo durante le letture
Usare formati basati su testo quando i sistemi di origine possono produrre questi formati o quando i volumi di dati sono abbastanza piccoli che non si applicano problemi di efficienza.
Formati a colonne
I file Parquet e ORC archiviano i dati in formato a colonne, consentendo query analitiche efficienti. Questi formati offrono:
- Compressione: l'archiviazione a colonne consente di ottenere rapporti di compressione migliori raggruppando valori simili
- Potatura delle colonne: le query leggono solo le colonne necessarie, riducendo le operazioni di I/O
- Schema incorporato: il file contiene metadati che descrivono i nomi e i tipi di colonna
Progetta il tuo processo di ingestione per favorire i formati di origine a colonne quando hai il controllo su come i sistemi upstream esportano i dati.
Formati semistrutturati
I file JSON XML e annidati rappresentano dati gerarchici che non rientrano in una struttura tabulare piatta. Quando si ingeriscono dati semistrutturati:
- Pianificare l'estrazione o la definizione dello schema.
- Determinare se appiattire la struttura o mantenere l'annidamento.
- Tenere conto delle diverse strutture dei documenti all'interno della stessa origine.
Considerazioni sulla connessione all'origine dati
La configurazione dell'origine dati definisce il modo in cui Azure Databricks si connette e esegue l'autenticazione con i sistemi di origine. La progettazione deve gestire la sicurezza delle connessioni, la gestione delle credenziali e i modelli di accesso.
Origini di archiviazione di oggetti cloud
L'archiviazione cloud (Azure Data Lake Storage, Amazon S3 o Google Cloud Storage) funge da zona di destinazione più comune per l'inserimento. Quando si configurano le connessioni di archiviazione:
- Usare le posizioni esterne di Catalogo Unity per gestire l'accesso ai percorsi di archiviazione.
- Configurare i metodi di autenticazione appropriati (identità gestita, entità servizio o credenziali di archiviazione).
- Progettare strutture di cartelle che supportano un'elaborazione incrementale efficiente.
La struttura delle cartelle influisce in modo significativo sull'efficienza di Azure Databricks per identificare ed elaborare nuovi file. Considerare questi modelli:
Partizionamento basato su data: organizzare i file in base alla gerarchia di date per abilitare l'eliminazione della partizione durante le letture incrementali:
/data/sales/year=2025/month=11/day=28/
/data/sales/year=2025/month=11/day=29/
Questa struttura consente alle query di analizzare solo le partizioni di data pertinenti anziché elencare tutti i file.
Organizzazione basata sull'origine: quando si acquisiscono dati da più origini, separare i dati per sistema sorgente per semplificare la logica di elaborazione.
/landing/erp/orders/
/landing/crm/customers/
/landing/web/clickstream/
Elaborazione delle cartelle di stato: usare cartelle separate per tenere traccia dello stato di elaborazione dei file:
/incoming/     # New files arrive here
/processing/   # Files currently being processed
/archive/      # Successfully processed files
/failed/       # Files that failed processing
Quando si progettano strutture di cartelle, prendere in considerazione:
- Sovraccarico di individuazione file: strutture flat con migliaia di file rallentano le operazioni di elenco. Le strutture partizionate riducono i file che Azure Databricks deve enumerare.
- Compatibilità del caricatore automatico: il caricatore automatico di Azure Databricks tiene traccia in modo efficiente dei nuovi file nell'archiviazione cloud. Strutturare le cartelle per allinearsi al modo in cui Auto Loader individua e registra i file nei checkpoint.
-
Estrazione di colonne di partizione: usare il partizionamento in stile Hive (
key=value) in modo che Azure Databricks possa estrarre automaticamente i valori di partizione come colonne senza analizzare il contenuto del file.
Origini di database
La connessione ai database transazionali richiede considerazioni diverse rispetto all'archiviazione cloud:
- Connettività di rete tra Azure Databricks e il server di database.
- Credenziali di autenticazione archiviate in modo sicuro (usando segreti anziché valori hardcoded).
- Funzionalità di pool di connessioni e trasferimento delle query.
- Impatto sulle prestazioni del sistema di origine durante l'estrazione.
Origini di streaming
I bus di messaggi e i flussi di eventi, ad esempio Hub eventi di Azure o altre piattaforme di messaggistica comuni, richiedono:
- Dettagli della connessione broker e autenticazione.
- Configurazione del gruppo di utenti per l'elaborazione parallela.
- Gestione offset per tenere traccia della posizione di consumo.
- Integrazione del registro degli schemi per la convalida del formato dei messaggi.
Origini dell'applicazione SaaS
Le applicazioni aziendali come Salesforce, ServiceNow o SAP espongono i dati tramite API con caratteristiche univoche:
- Limiti di frequenza API che vincolano la velocità effettiva di estrazione.
- Strategie di impaginazione per set di risultati di grandi dimensioni.
- Flussi di autenticazione (OAuth, chiavi API o basati su certificati).
- Funzionalità di rilevamento delle modifiche o webhook disponibili.
Applicare un framework di progettazione basato sui requisiti
La progettazione efficace dell'inserimento inizia con l'analisi dei requisiti prima di selezionare i tipi di estrazione o i formati di file. Usare il framework ripetibile seguente per guidare le decisioni di progettazione.
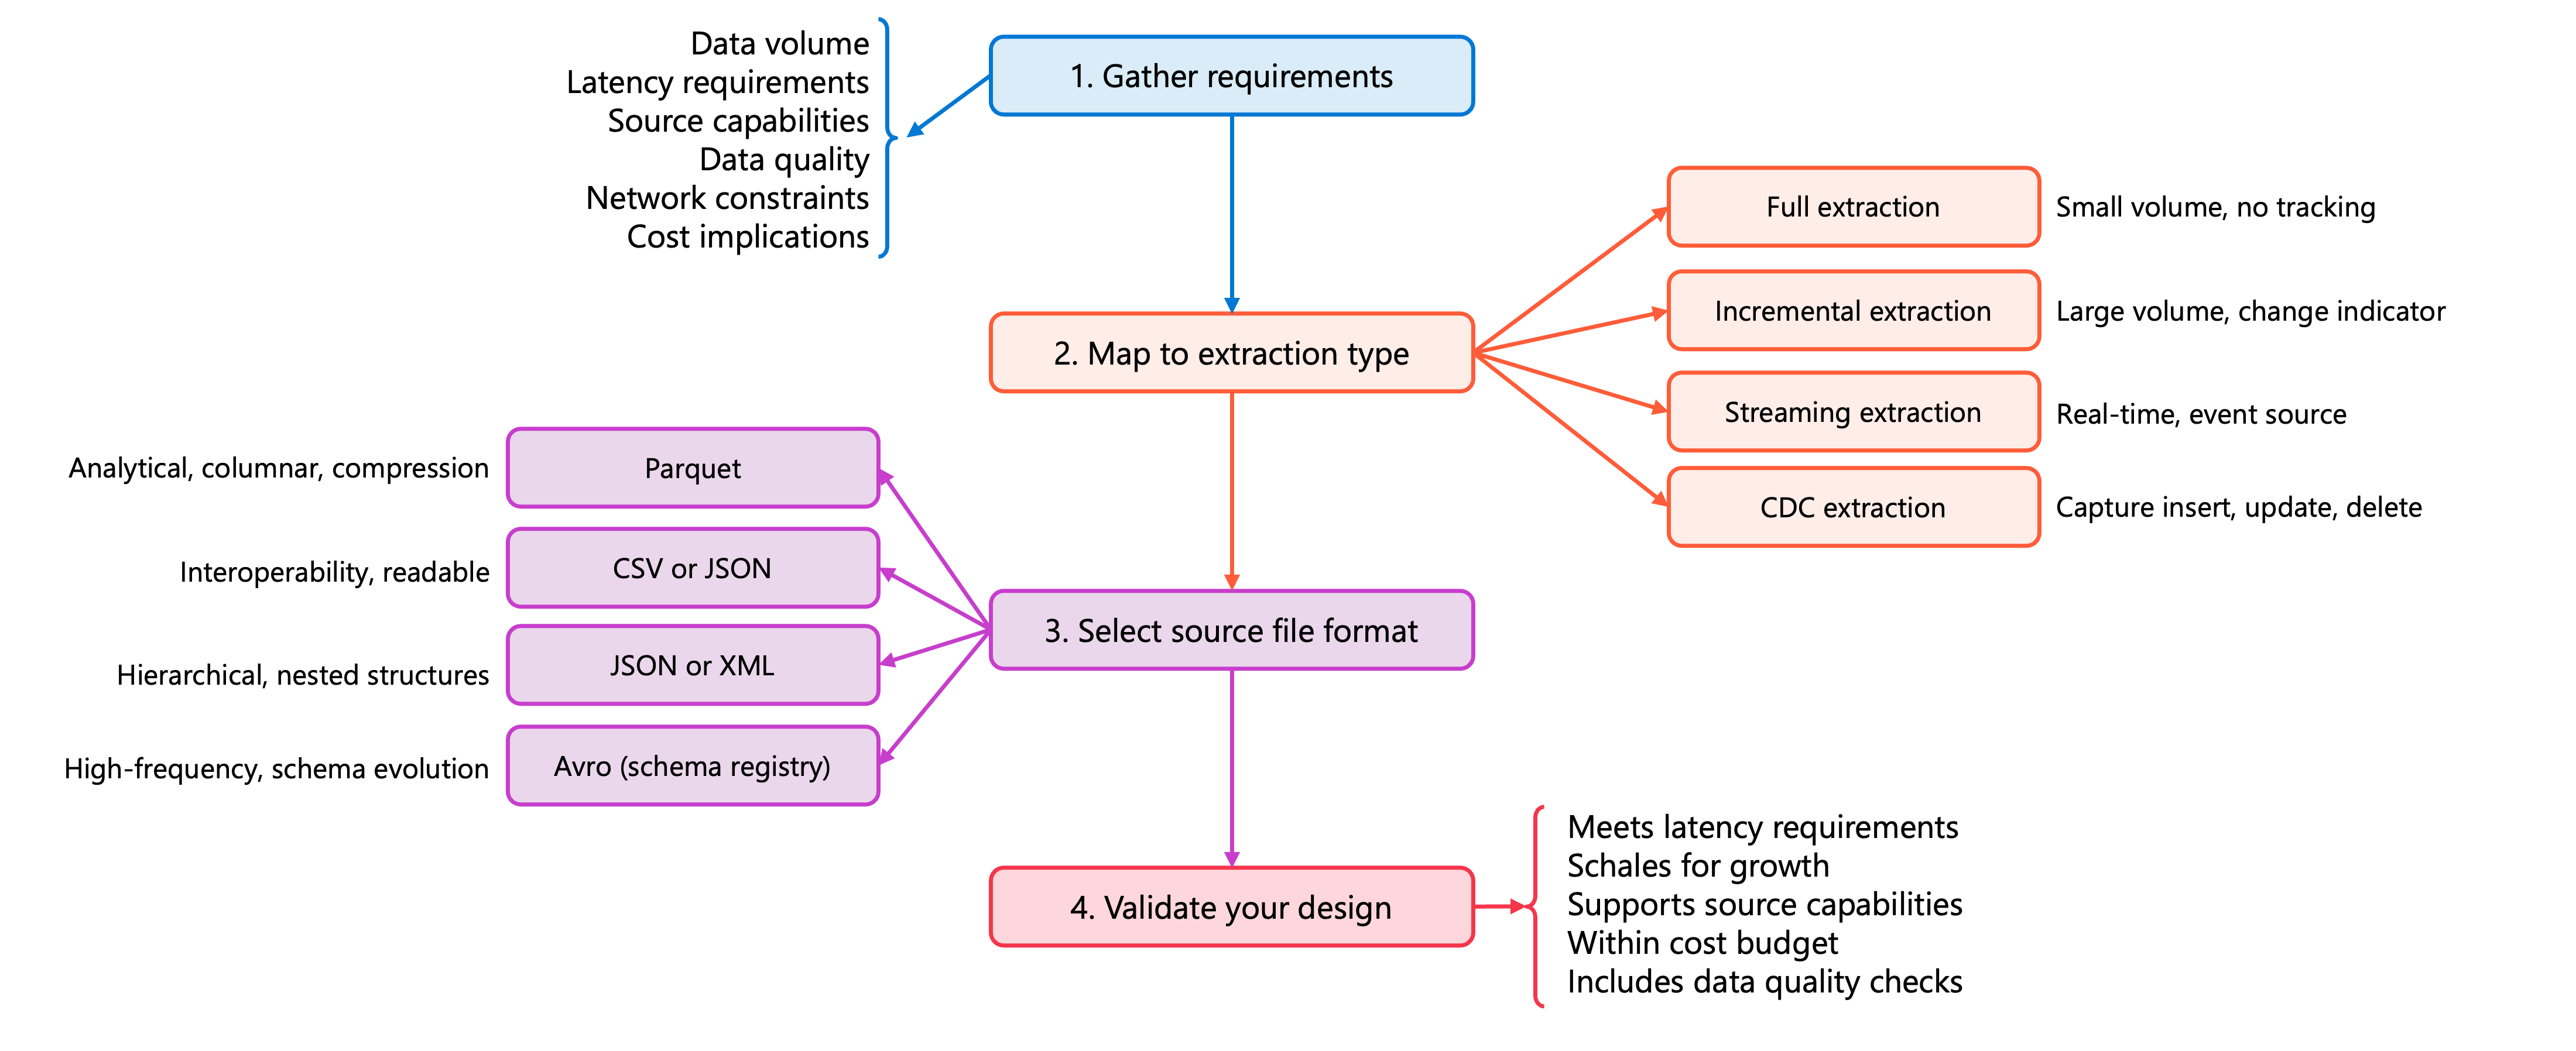
Passaggio 1: Raccogliere i requisiti
Prima di prendere decisioni tecniche, rispondere a queste domande chiave:
| Categoria del requisito | Domande a cui rispondere |
|---|---|
| Volume dei dati | Quanti dati esistono nell'origine? Quanto varia tra le esecuzioni? Qual è il tasso di crescita? |
| Requisiti di latenza | Quanto devono essere aggiornati i dati per i consumer downstream? Ci sono SLA da rispettare? |
| Funzionalità delle sorgenti | La fonte supporta il tracciamento delle modifiche, il CDC o solo l'estrazione completa? Quali formati di file possono produrre? |
| Qualità dei dati | Qual è l'affidabilità dei dati di origine? Quale convalida o pulizia è necessaria? |
| Vincoli di rete | Quale larghezza di banda esiste tra l'origine e Azure Databricks? Esistono requisiti per firewall o VPN? |
| Implicazioni relative ai costi | Quali sono i costi di calcolo, archiviazione e trasferimento dei dati di approcci diversi? |
Passaggio 2: Mappare i requisiti al tipo di estrazione
Usare l'analisi dei requisiti per selezionare il modello di estrazione appropriato:
| Se i requisiti indicano... | Quindi scegliere... |
|---|---|
| Volume di dati di piccole dimensioni (< 100.000 righe), nessun rilevamento delle modifiche disponibile, semplice ricompilazione accettabile | Estrazione completa |
| Volume di dati di grandi dimensioni, indicatore di modifica affidabile (timestamp/sequenza), aggiornamento orario o giornaliero sufficiente | Estrazione incrementale |
| È richiesto un aggiornamento in tempo reale o quasi in tempo reale; l'origine pubblica eventi e l'infrastruttura di streaming è disponibile. | Estrazione di streaming |
| È necessario acquisire eliminazioni e tipi di operazione, audit trail obbligatorio, l'origine supporta l'acquisizione del log delle transazioni | Estrazione CDC |
Passaggio 3: Selezionare il formato del file di origine
Quando si controlla il formato di origine o è necessario scegliere un formato di zona di destinazione, associare il formato alle proprie esigenze:
| Se il tuo scenario comporta... | Quindi preferisci... |
|---|---|
| Set di dati analitici di grandi dimensioni, query a colonne, richiedono la compressione | Parquet |
| Interoperabilità con molti sistemi, leggibilità umana necessaria | CSV o JSON |
| Strutture di dati gerarchici o annidate | JSON o XML |
| Streaming ad alta frequenza con evoluzione dello schema | Avro con registro schemi |
Passaggio 4: Convalidare la progettazione
Prima di implementare, verificare che la progettazione soddisfi questi problemi:
Il tipo di estrazione soddisfa i requisiti di latenza. In caso contrario, i consumer downstream ricevono dati non aggiornati, causando potenzialmente decisioni aziendali errate o violazioni del contratto di servizio.
L'approccio viene ridimensionato per gestire la crescita dei dati prevista. In caso contrario, le pipeline che funzionano oggi potrebbero fallire o diventare proibitivamente lente man mano che aumentano i volumi di dati.
Le funzionalità del sistema di origine supportano il modello scelto. In caso contrario, la pipeline ha esito negativo in fase di esecuzione o richiede soluzioni alternative costose che aggiungono complessità.
Le stime dei costi rientrano nei vincoli di budget. In caso contrario, la soluzione potrebbe essere tecnicamente solida ma finanziariamente insostenibile per l'uso di produzione.
I controlli di qualità dei dati sono pianificati per la pipeline. In caso contrario, i dati non validi o danneggiati vengono propagati ai sistemi downstream, causando errori o analisi non corrette.
Applicare il framework: un esempio pratico
Una piattaforma di e-commerce deve inserire i dati degli ordini. Gli ordini vengono archiviati in un database PostgreSQL e l'azienda richiede la creazione di report orari.
Passaggio 1: Raccogliere i requisiti:
- Volume: 50.000 nuovi ordini giornalieri, 2 milioni di righe totali, 15% crescita annuale.
- Latenza: una freschezza di un'ora è accettabile per la creazione di report.
- Origine: PostgreSQL supporta query basate su timestamp, ma non dispone di un CDC nativo.
- Qualità: i dati di origine vengono convalidati all'ingresso; pulizia minima necessaria.
- Rete: connettività diretta tramite collegamento privato di Azure.
- Costo: ridurre al minimo l'utilizzo di calcolo; i costi di archiviazione sono secondari.
Passaggio 2 - Eseguire il mapping al tipo di estrazione:
Volume di grandi dimensioni con colonna timestamp affidabile e requisito di latenza oraria → estrazione incrementale.
Perché non gli altri?
- Estrazione completa: la rielaborazione di 2 milioni di righe comporta un spreco orario quando solo circa 2.000 ordini cambiano all'ora.
- Streaming: la latenza di un'ora non giustifica il costo dell'infrastruttura di streaming always-on.
- CDC: PostgreSQL non espone CDC del log delle transazioni nativo e il caso d'uso non richiede il rilevamento delle eliminazioni o dei tipi di operazione.
Passaggio 3 - Selezionare il formato di file:
I dati arrivano in Azure Data Lake Storage per l'elaborazione → Parquet per un'archiviazione a colonne efficiente. Layout suddiviso per data per la scoperta incrementale → /landing/orders/year=2025/month=11/day=28/.
Perché non gli altri?
- CSV/JSON: dimensioni di file maggiori, nessun vantaggio di compressione e prestazioni delle query più lente per i carichi di lavoro analitici.
- Avro: È più adatto per lo streaming con l'evoluzione dello schema. L'inserimento batch non richiede le sue funzionalità orientate allo streaming.
- XML: aggiunge complessità di analisi senza vantaggi per i dati strutturati degli ordini tabulari.
Passaggio 4: Convalidare la progettazione:
- ✓ L'incremento orario soddisfa il requisito di una latenza di un'ora.
- ✓ Elaborazione solo modifiche scalabili in modo efficiente con la crescita.
- ✓ La colonna PostgreSQL
order_updated_atconsente le query incrementali. - ✓ Elaborazione di migliaia e milioni di righe riduce i costi di calcolo.
Decisione finale: order_updated_atestrazione incrementale tramite la colonna timestamp, con pianificazione oraria, con i dati che vengono salvati come file Parquet in Azure Data Lake Storage.
Suggerimento
Documentare le decisioni di progettazione e la logica sottostante. Quando si verificano problemi o modifiche ai requisiti, questa documentazione consente di comprendere il motivo per cui è stato scelto l'approccio corrente e quali compromessi sono stati effettuati. Prendere in considerazione la creazione di una documentazione delle decisioni progettuali per ciascuna pipeline principale.
Basandosi su questa base basata sui requisiti, si è pronti per valutare gli strumenti specifici e i metodi di caricamento che implementano la progettazione di inserimento.