Scegliere uno strumento di inserimento dati
Quando si progettano pipeline di dati in Azure Databricks, la selezione dello strumento di inserimento corretto influisce direttamente sull'affidabilità della pipeline, sul lavoro di manutenzione e sui costi a lungo termine. Ogni strumento risolve diversi scenari, origini dati e requisiti operativi. La comprensione di queste differenze consente di prendere decisioni informate in linea con le esigenze dell'organizzazione.
Comprendere il panorama degli strumenti di elaborazione dati
Azure Databricks offre più opzioni di inserimento che spaziano da servizi completamente gestiti a framework altamente personalizzabili. Gli strumenti scelti dipendono da fattori quali il tipo di origine dati, i requisiti di latenza e il controllo necessario per il processo di inserimento.

Al livello più gestito, Lakeflow Connect offre connettori chiavi in mano per applicazioni e database aziendali. Questi connettori gestiscono automaticamente l'autenticazione, il rilevamento delle modifiche, il ripristino degli errori e l'evoluzione dello schema. Nella parte personalizzabile, Spark Structured Streaming offre un controllo completo sul flusso dei dati attraverso la pipeline, anche se richiede uno sforzo maggiore di sviluppo e manutenzione.
Tra questi estremi sono disponibili strumenti come Il caricatore automatico per i file di archiviazione cloud, COPY INTO per il caricamento batch basato su SQL e approcci basati su notebook usando connessioni JDBC/ODBC . Azure Data Factory funge anche da livello di orchestrazione che può coordinare lo spostamento dei dati in Azure Databricks dall'ecosistema di Azure più ampio.
Lakeflow Connect
Lakeflow Connect rappresenta l'approccio moderno all'inserimento dati in Azure Databricks. Offre connettori completamente gestiti e connettori standard che si integrano con le pipeline Lakeflow per un'esperienza semplificata.
I connettori gestiti sono organizzati in tre tipi:
i connettori SaaS offrono un'integrazione predefinita con applicazioni aziendali come Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk e molte altre. Questi connettori gestiscono l'autenticazione specifica dell'origine, le letture incrementali, la limitazione della frequenza API, l'evoluzione dello schema e i tentativi automatizzati. Vengono eseguiti in un ambiente di calcolo serverless e scrivono in tabelle di streaming regolate da Unity Catalog.
Connettori Database inseriscono dati da database relazionali, tra cui MySQL, PostgreSQL e SQL Server tramite cattura delle modifiche dei dati (CDC). Poiché i connettori basati su CDC leggono dai log delle transazioni di database anziché eseguire query direttamente sulle tabelle, richiedono un gateway di inserimento distribuito nella rete e un volume di archiviazione di staging per memorizzare nel buffer le modifiche acquisite.
I connettori della community sono connettori open source creati e gestiti dalla community. Estendono Lakeflow Connect alle origini che non hanno ancora un connettore gestito. È possibile usare un connettore della community esistente o contribuire autonomamente.
Annotazioni
L'ecosistema di connettori è in rapida crescita. Vedere la documentazione sui connettori gestiti per l'elenco completo corrente delle origini supportate.
I connettori standard estendono Lakeflow Connect all'archiviazione di oggetti cloud e ai bus di messaggio. È possibile inserire dati da Amazon S3, Azure Data Lake Storage o Google Cloud Storage usando il caricatore automatico. Per i dati in tempo reale, i connettori standard supportano Apache Kafka, Google Pub/Sub e Apache Pulsar.

Considera Lakeflow Connect quando hai bisogno di un'acquisizione affidabile e con poca manutenzione da origini supportate. I connettori gestiti riducono significativamente i tempi di sviluppo e la manutenzione in corso rispetto alle soluzioni personalizzate. Tuttavia, se l'origine dati non è supportata o è necessaria una logica di inserimento altamente specializzata, potrebbe essere necessario esplorare altre opzioni.
Lakeflow Connect supporta sia l'inserimento pianificato (oraria, giornaliera, settimanale) che i trigger su richiesta , rendendoli adatti per i normali cicli di aggiornamento dei dati e scenari di caricamento ad hoc.
Connettori basati su query
I connettori basati su query sono un'alternativa leggera ai connettori di database CDC per l'inserimento pianificato da database relazionali. Anziché leggere i log delle transazioni, esegue una query sulla tabella di origine direttamente usando una colonna di cursore , ovvero un timestamp o un numero intero che tiene traccia delle righe nuove o aggiornate dall'ultima esecuzione della pipeline.
Poiché eseguono query direttamente sull'origine, i connettori basati su query non richiedono un gateway di inserimento o uno spazio di archiviazione temporaneo. In ogni esecuzione pianificata, il connettore recupera tutte le righe con un valore di colonna del cursore maggiore del livello massimo dell'esecuzione precedente, quindi scrive i risultati in tabelle di streaming in Unity Catalog.
Le origini supportate includono Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL e tutte le origini dati di Lakehouse Federation.
I connettori basati su query supportano tre modalità di rilevamento della cronologia per le tabelle di destinazione:
- ScD Type 1: sovrascrive la riga esistente con la riga di origine più recente. Non viene mantenuta alcuna cronologia.
- ScD Type 2: mantiene la cronologia completa aggiungendo nuove righe con i metadati della versione.
- Solo aggiunta: accoda ogni riga inserita senza unire o sovrascrivere.
Scegliere i connettori basati su query anziché i connettori di database CDC quando l'infrastruttura CDC o binlog non è disponibile, ma esiste una colonna cursore affidabile nell'origine. Scegliere i connettori CDC quando si necessita di ogni stato intermedio delle righe tra esecuzioni della pipeline o quando il monitoraggio delle eliminazioni temporanee è critico. Il compromesso è che i connettori basati su query inseriscono un carico maggiore direttamente sulle tabelle di origine rispetto ai connettori CDC, che leggono dal binlog.
Caricatore automatico
Il caricatore automatico fornisce l'elaborazione incrementale dei file per i dati in arrivo nell'archiviazione cloud. Invece di analizzare intere directory per trovare nuovi file, il caricatore automatico tiene traccia in modo efficiente dei file che sono stati elaborati e inserisce solo nuovi arrivi.
Il caricatore automatico funziona mantenendo lo stato in un percorso di checkpoint che tiene traccia dei file elaborati. Quando i nuovi file vengono inseriti nell'archiviazione cloud, il caricatore automatico li individua tramite l'elenco di directory o la modalità di notifica dei file. L'elenco di directory esegue periodicamente l'analisi dei nuovi file, mentre la modalità di notifica dei file usa eventi nativi del cloud per il rilevamento immediato.
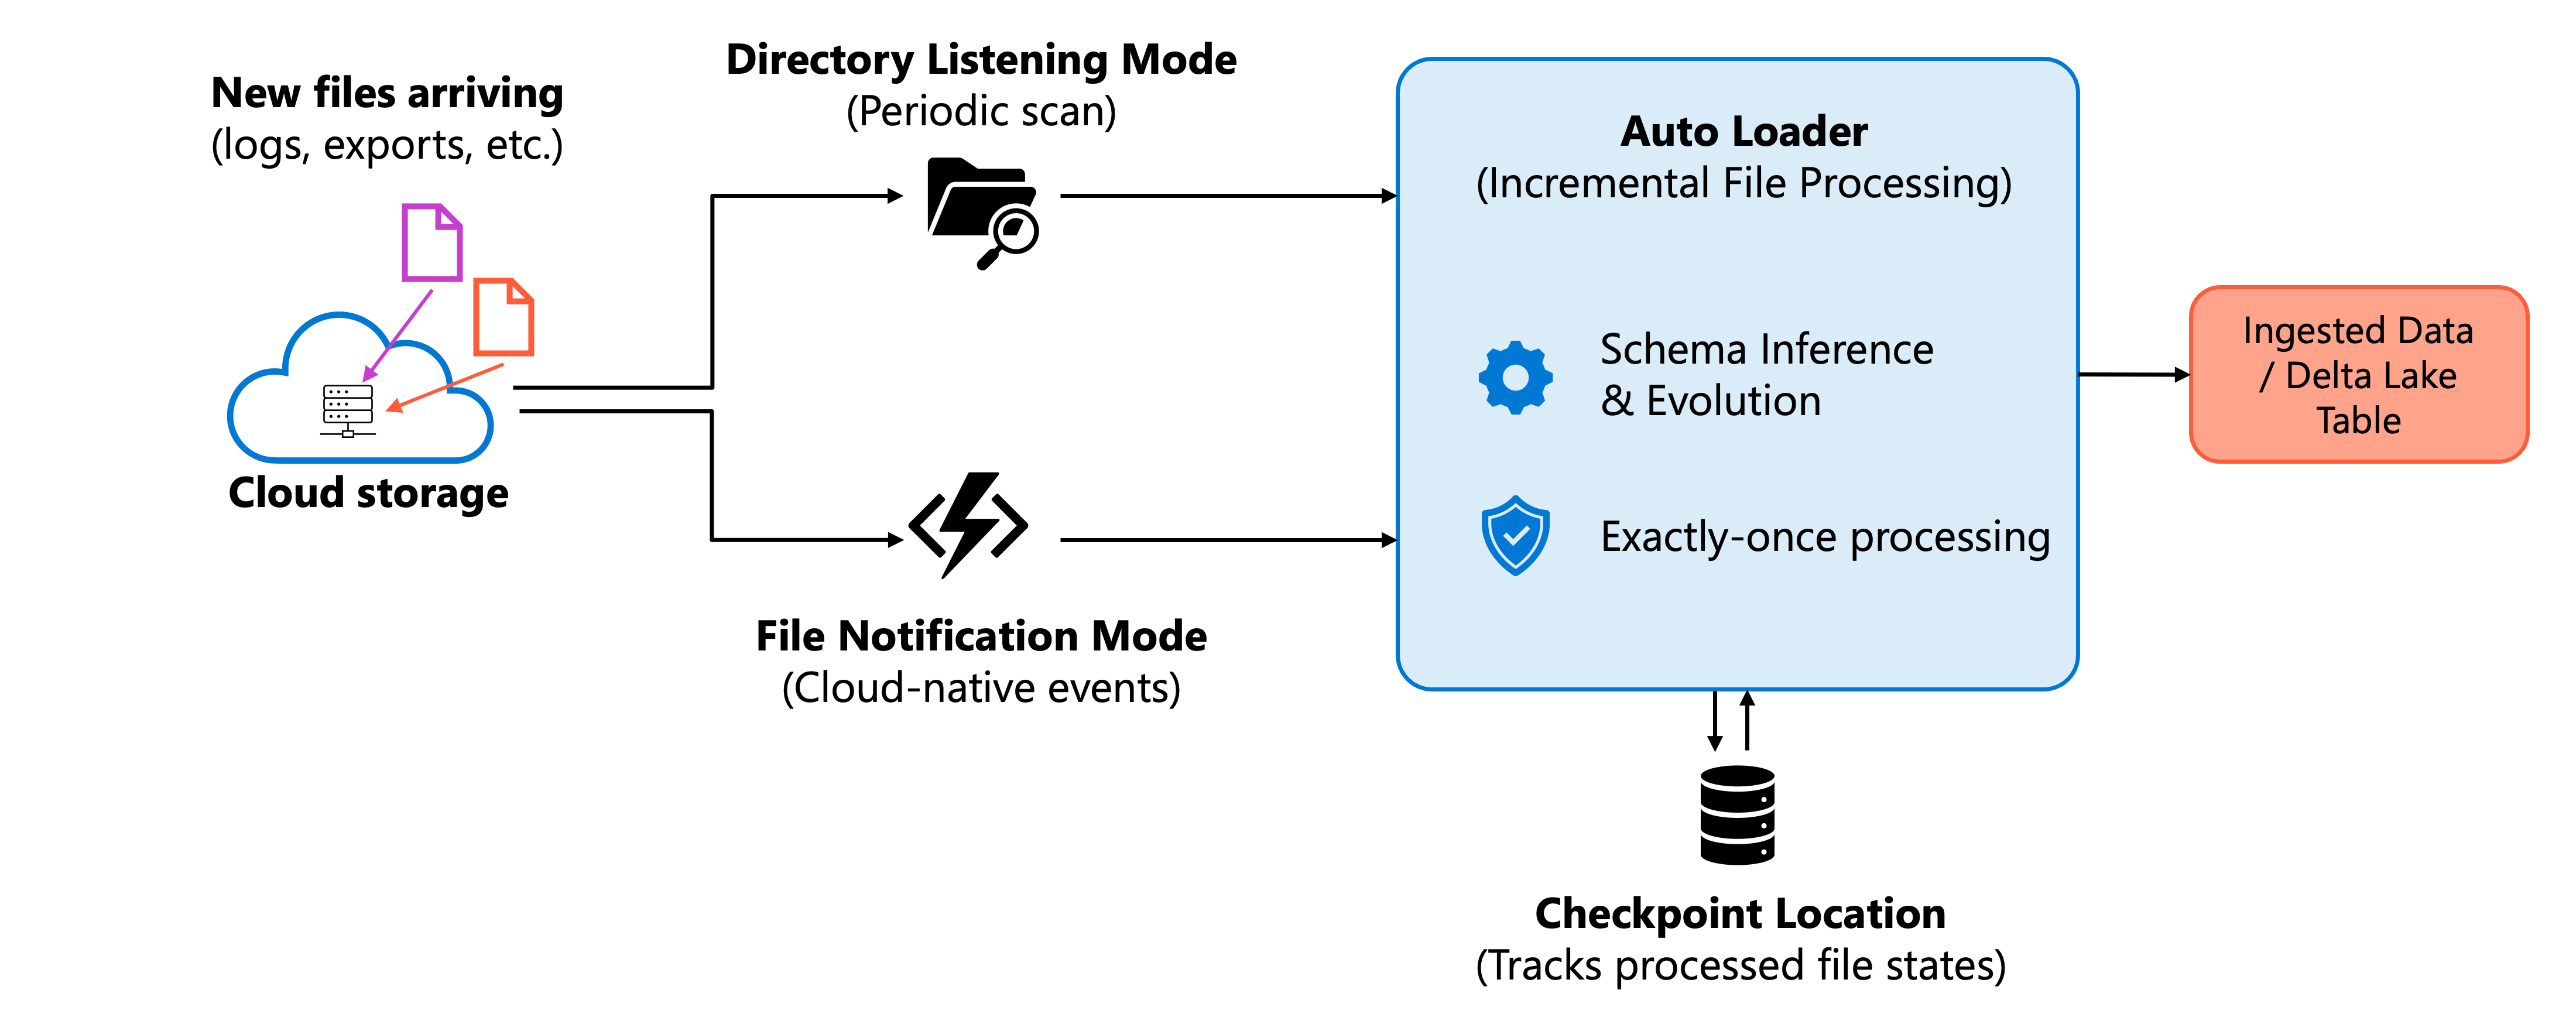
Le funzionalità principali del caricatore automatico includono:
- Inferenza ed evoluzione dello schema: rileva automaticamente lo schema dei file in ingresso e gestisce le modifiche dello schema in modo normale.
- Elaborazione esattamente una sola volta: garantisce che ogni file venga elaborato una sola volta, anche in caso di errori e riavvii.
- Scalabilità: gestisce in modo efficiente miliardi di file per il backfill o le migrazioni.
- Supporto del formato: elabora file JSON, CSV, Parquet, Avro, ORC, XML, text e binari.
Il caricatore automatico si adatta agli scenari in cui i dati arrivano come file nell'archiviazione cloud. I modelli comuni includono file di log, esportazioni da sistemi upstream e zone di destinazione dei dati. È possibile usare Auto Loader con le pipeline Lakeflow per un'esperienza gestita o con Structured Streaming per un maggiore controllo.
COPIA IN
Il COPY INTO comando SQL carica i dati dall'archiviazione cloud nelle tabelle Delta. A differenza del caricatore automatico, che viene eseguito continuamente come flusso, COPY INTO viene eseguito come operazione batch pianificata o attivata manualmente.
COPY INTO tiene traccia dei file già elaborati, rendendo l'operazione idempotente. L'esecuzione dello stesso comando più volte non duplica i dati perché i file caricati in precedenza vengono ignorati. Questa caratteristica rende COPY INTO utile per i processi batch pianificati in cui si vuole un comportamento prevedibile e ripetibile.
Annotazioni
I metadati di rilevamento vengono archiviati come parte del log delle transazioni della tabella Delta (directory _delta_log )

Gli scenari comuni per COPY INTO includono migrazioni di dati monouso, caricamenti batch pianificati dalle zone di destinazione e flussi di lavoro SQL-first in cui si preferisce la sintassi dichiarativa rispetto alle API di streaming.
Scegliere COPY INTO in Autoloader quando si esegue un caricamento batch una tantum di un set di dati di grandi dimensioni.
COPY INTO fornisce un modello di configurazione più semplice senza richiedere l'infrastruttura di streaming, rendendolo ideale per caricare centinaia di gigabyte o persino terabyte di dati in un'unica operazione. Il modello di elaborazione continua del caricatore automatico e la gestione dei checkpoint aggiungono complessità non necessaria quando è necessario caricare i dati una sola volta.
Tuttavia, per l'inserimento incrementale continuo su larga scala, il caricatore automatico offre prestazioni migliori e un'individuazione file più affidabile.
Streaming Strutturato di Spark
Spark Structured Streaming offre le basi per l'elaborazione dei dati in tempo reale in Azure Databricks. Consente l'inserimento continuo da varie fonti di streaming con garanzie di elaborazione esattamente una volta.
Le origini di streaming supportate includono:
- Apache Kafka e Hub eventi di Azure: per le architetture guidate dagli eventi e l'elaborazione della coda di messaggi.
- Feed di modifiche Delta Lake: per propagare le modifiche tra le tabelle Delta.
- Cloud storage via Auto Loader: per l'ingestione di streaming di file.
- Socket e sorgenti personalizzate: per scenari di acquisizione specializzati.
Scegli Structured Streaming quando hai bisogno di un controllo preciso sul comportamento di streaming, una logica personalizzata di marchiatura temporale o finestratura, o quando lavori con sorgenti non supportate da astrazioni di livello superiore.
Connessioni JDBC e ODBC
L'inserimento basato su notebook con JDBC o ODBC rimane un approccio pratico per estrarre dati da database relazionali. Si scrive codice che si connette direttamente ai database di origine, esegue query e carica i risultati nelle tabelle Delta.
Questo approccio supporta praticamente qualsiasi database con un driver JDBC o ODBC: SQL Server, Oracle, PostgreSQL, MySQL e molti altri. È possibile implementare caricamenti completi o incrementali scrivendo query appropriate, spesso utilizzando colonne watermark per monitorare il progresso dell'estrazione.
Anche se i connettori gestiti di Lakeflow Connect sostituiscono JDBC/ODBC per molti scenari, le connessioni basate su notebook rimangono utili quando:
- Il database non è supportato dai connettori gestiti di Lakeflow Connect.
- È necessaria una logica di estrazione personalizzata che i connettori gestiti non possano supportare.
- Stai mantenendo le pipeline esistenti che utilizzano questo modello.
- Sono necessarie ottimizzazioni specifiche per il pushdown delle query per tabelle di grandi dimensioni.
Quando si usa JDBC/ODBC, archiviare le credenziali in modo sicuro usando i segreti di Databricks anziché inserirle nel codice direttamente nei notebook. Prendere in considerazione l'impatto sulle prestazioni sui sistemi di origine e implementare la limitazione o la pianificazione appropriate per evitare il sovraccarico dei database transazionali.
Per i database locali, è necessaria un'infrastruttura di rete aggiuntiva: Azure ExpressRoute/VPN per la connettività JDBC diretta da Databricks o Azure Data Factory con un runtime di integrazione Self-Hosted per rendere prima disponibili i dati nell'archiviazione cloud.
Azure Data Factory
Azure Data Factory (ADF) funge da piattaforma di orchestrazione e spostamento dei dati nell'ecosistema di Azure. Si distingue per coordinare i flussi di lavoro che si estendono su più servizi, importando dati da origini diverse nell'archiviazione nel cloud dove Azure Databricks può elaborarli.
Azure Data Factory si integra ampiamente con i servizi Microsoft come Dynamics 365, il database SQL di Azure e Microsoft Fabric. Quando i dati provengono da queste origini, Azure Data Factory offre connettività semplice e può trasferire i dati in Azure Data Lake Storage per l'elaborazione successiva di Databricks.
Comprendere il ruolo appropriato di Azure Data Factory è importante. Usare ADF per:
- Orchestrazione: coordinamento dei flussi di lavoro che coinvolgono più servizi di Azure.
- Destinazione iniziale dei dati: spostamento dei dati dalle origini di Azure all'archiviazione cloud.
- Integrazione aziendale: quando i criteri aziendali impongono ADF per lo spostamento dei dati.

Evitare di usare ADF per le trasformazioni ETL principali all'interno di Databricks. L'esecuzione di trasformazioni tramite attività di Azure Data Factory introduce complessità non necessarie ed esegue in modo meno efficiente rispetto all'elaborazione nativa di Databricks. Consentire a Azure Data Factory di gestire lo spostamento dei dati nel lakehouse, quindi usare gli strumenti di Azure Databricks per la logica di trasformazione.
Applicare un framework decisionale
La selezione di uno strumento di inserimento diventa più chiara quando si valuta lo scenario rispetto ai criteri decisionali chiave.
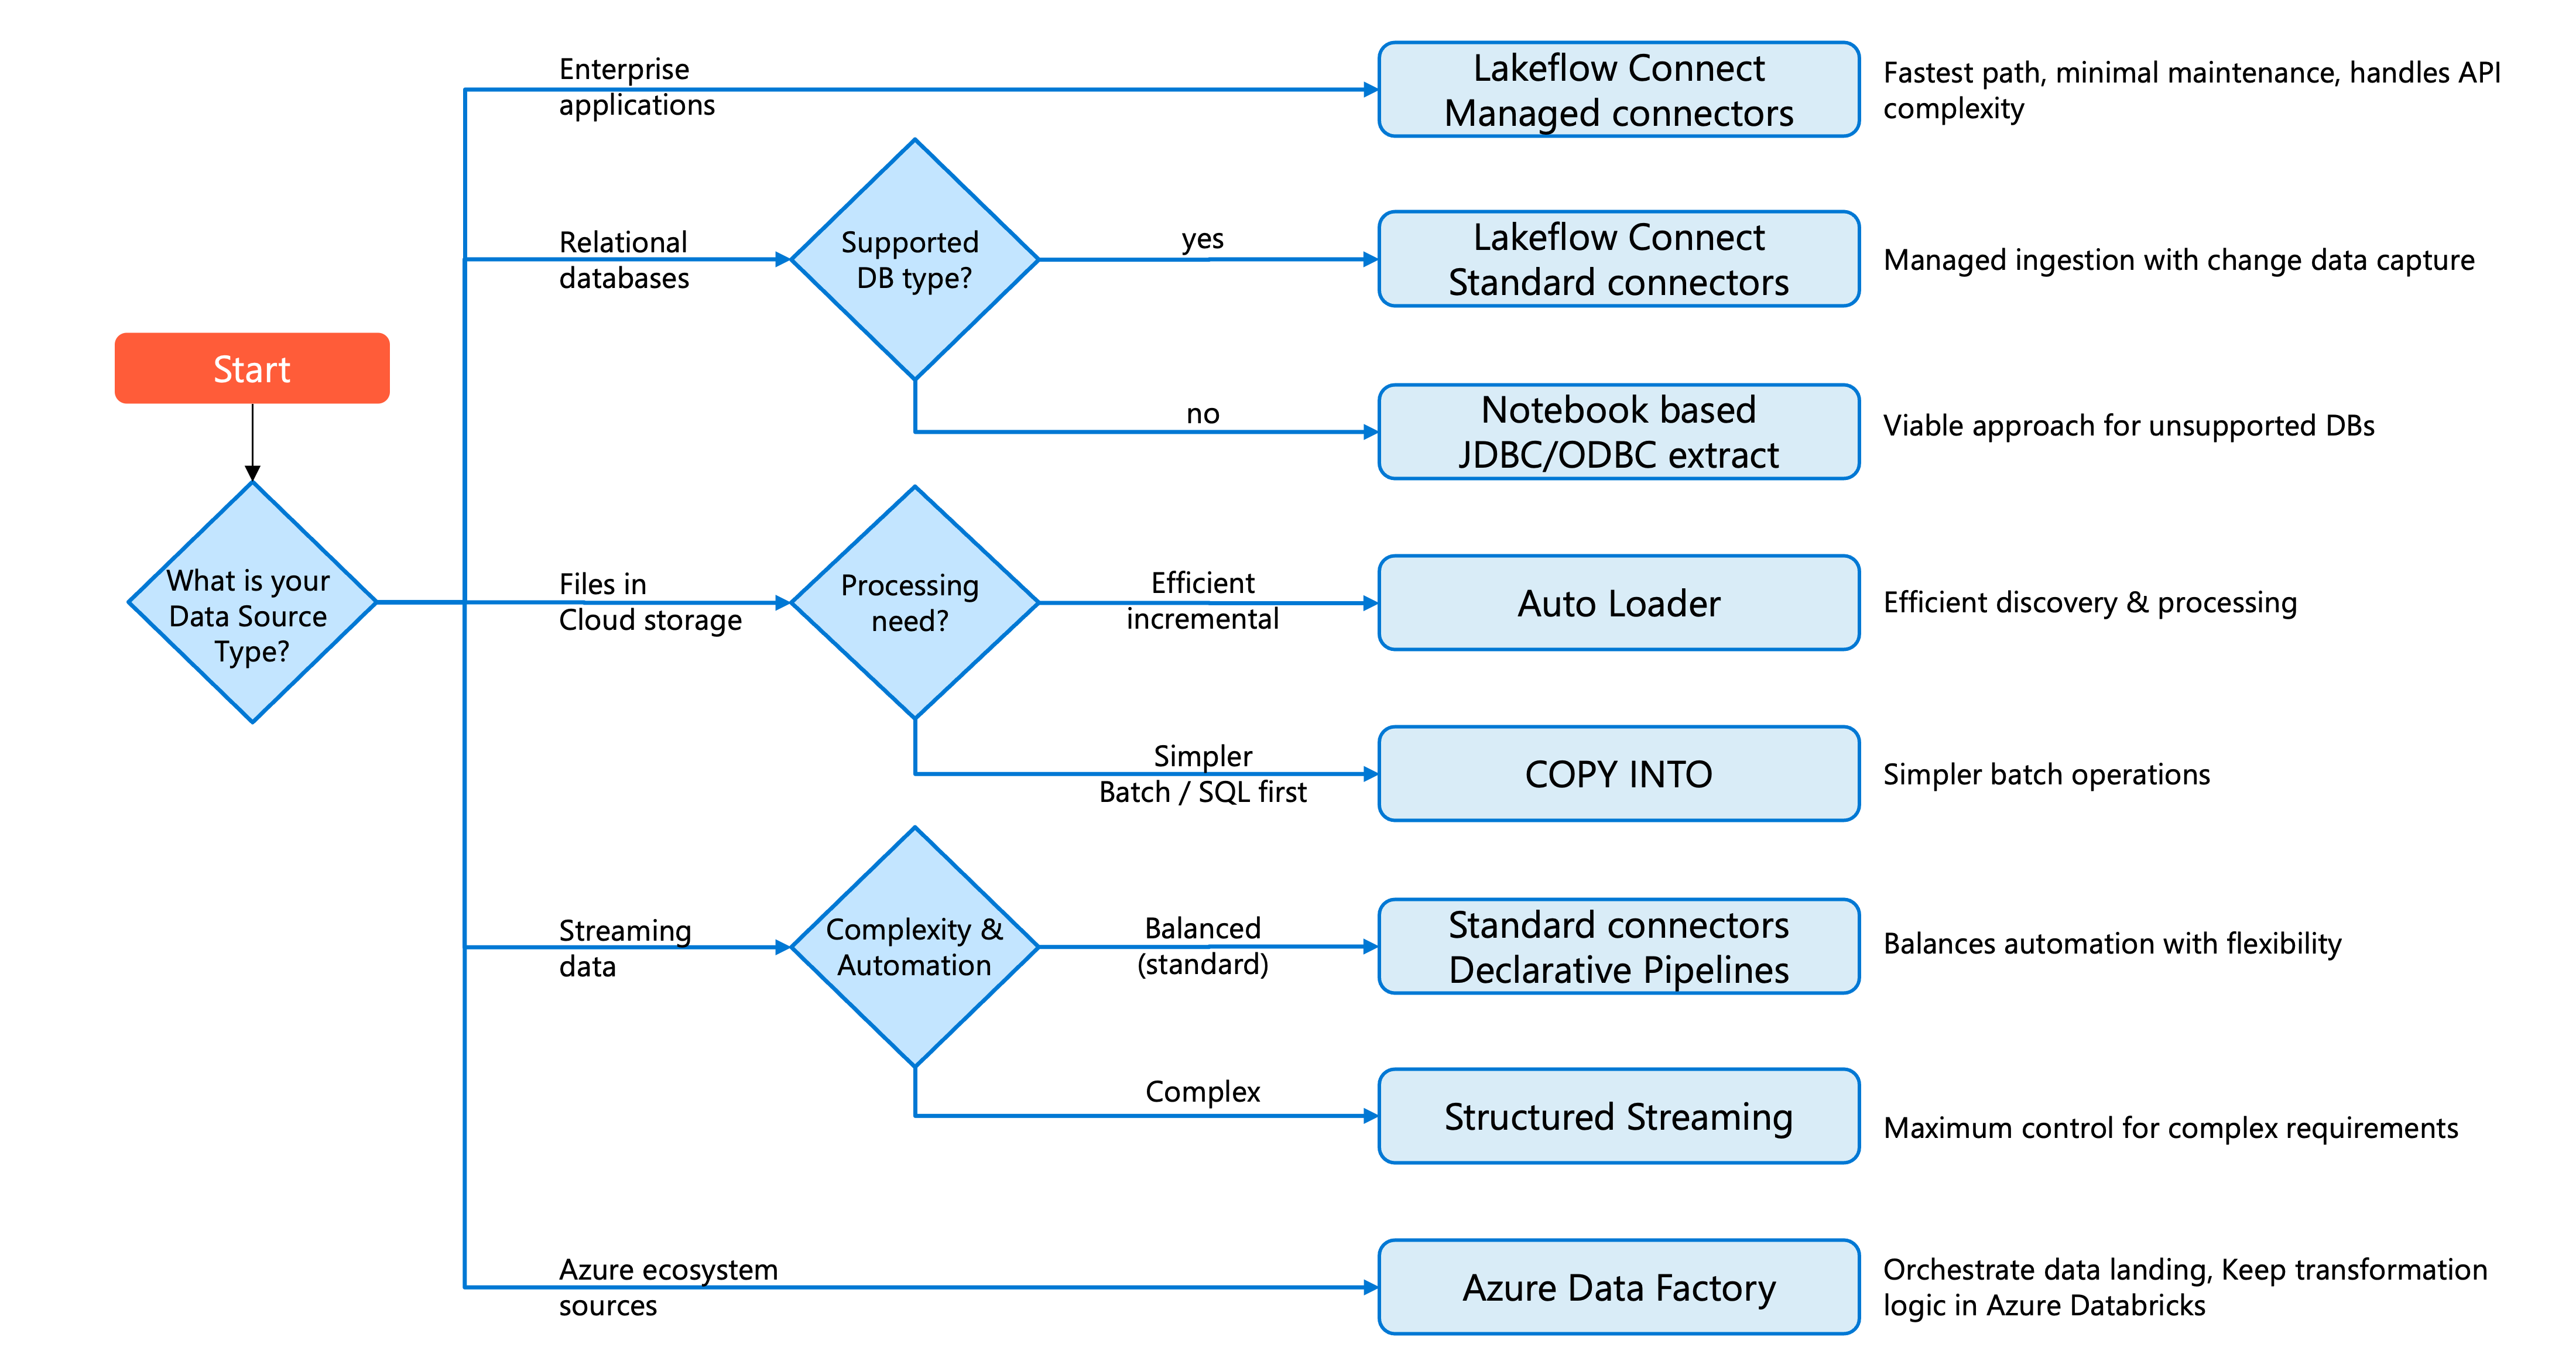
Iniziare identificando il tipo di origine dati, quindi prendere in considerazione i requisiti operativi e il contesto aziendale.
Per le applicazioni aziendali (Salesforce, ServiceNow, SharePoint), i connettori gestiti di Lakeflow Connect offrono il percorso più rapido per la produzione con manutenzione minima. Questi connettori gestiscono la complessità dell'integrazione dell'API, la limitazione della frequenza e il rilevamento delle modifiche.
Per i database relazionali con tipi supportati, Lakeflow Connect offre due percorsi gestiti: connettori di database (basati su CDC, richiede il gateway) per l'acquisizione continua delle modifiche e connettori basati su query per un inserimento pianificato più semplice tramite una colonna di cursore. Per i database non supportati, l'estrazione JDBC/ODBC basata su notebook rimane un approccio praticabile.
Per i file nell'archiviazione cloud, il caricatore automatico offre un'efficiente elaborazione e individuazione incrementale. Usare COPY INTO per scenari batch più semplici o quando si preferisce flussi di lavoro SQL-first.
Per lo streaming dei dati dai bus di messaggi (Kafka, Event Hubs, Pub/Sub), i connettori standard con le pipeline Lakeflow bilanciano l'automazione con flessibilità. Per i requisiti di streaming complessi, Structured Streaming offre il massimo controllo.
Per le origini dell'ecosistema di Azure che richiedono il coordinamento con altri servizi, Azure Data Factory può orchestrare il caricamento dei dati nel sistema lakehouse. Mantenere la logica di trasformazione all'interno di Azure Databricks anziché nei flussi di dati di Azure Data Factory.
Suggerimento
Iniziare con l'opzione più gestita che soddisfa i requisiti. I connettori gestiti riducono i tempi di sviluppo e il carico di manutenzione. Passare a approcci più personalizzabili solo quando non è possibile soddisfare requisiti specifici con astrazioni di livello superiore.
La scelta dipende anche dalle competenze del team e da standard organizzativi. Documentare le decisioni e il ragionamento sottostante per aiutare i membri futuri del team a comprendere l'architettura della pipeline.