Governance dei dati con Unity Catalog e Microsoft Purview
Tip
Per altri dettagli, vedi la scheda Testo e immagini .
La governance dei dati è fondamentale per garantire che i dati all'interno di un'organizzazione vengano gestiti in modo sicuro, efficiente e conforme alle normative.
In molte organizzazioni, i dati vengono distribuiti tra database, data warehouse, data lake e persino più cataloghi. Esiste anche in formati diversi, ad esempio Parquet, CSV e Delta Lake. Oltre ai dati strutturati nelle tabelle, sono presenti anche dati non strutturati nei file, insieme ad altri asset, ad esempio modelli di Machine Learning, notebook e dashboard che richiedono la gestione e la governance. Questa frammentazione crea silo tra origini, formati e tipi di asset.
Queste sfide di governance influenzano direttamente il valore che le organizzazioni possono ottenere dai dati e dall'intelligenza artificiale.
La governance frammentata aumenta i rischi di conformità, sicurezza e qualità dei dati, creando anche inefficienze operative, mentre i team faticano a mantenere una visualizzazione coerente dei dati e degli ambienti di intelligenza artificiale.
La connettività limitata può comportare un blocco del fornitore e rendere più difficile l'adozione di nuove tecnologie man mano che cambiano i requisiti. La scarsa interoperabilità complica anche la collaborazione e il ridimensionamento, spesso comportando costi più elevati dall'uso di più strumenti e dalla duplicazione dei dati tra sistemi.
La mancanza di intelligenza predefinita limita l'uso più ampio dei dati e delle piattaforme di intelligenza artificiale, in particolare per gli utenti non tecnici. Ciò rallenta l'innovazione, ritarda il processo decisionale e impedisce alle organizzazioni di realizzare completamente i vantaggi dei propri investimenti in dati e intelligenza artificiale.
Azure Databricks, combinato con Unity Catalog e Microsoft Purview, offre una soluzione per gestire e governare i dati in modo efficace.
Catalogo Unity
Unity Catalog offre un modo centralizzato per gestire l'accesso, l'individuazione, la derivazione, i log di controllo e il monitoraggio della qualità tra gli asset di dati e intelligenza artificiale all'interno di Azure Databricks. Si applica in modo coerente in tutte le aree di lavoro collegate allo stesso metastore.

Il metastore è il contenitore di metadati di primo livello; contiene informazioni sugli asset di dati e sulle autorizzazioni che li regolano. In genere si ha un metastore per regione e più spazi di lavoro possono condividere lo stesso metastore.
Unity Catalog organizza gli asset di dati usando una gerarchia strutturata a tre livelli:
catalog.schema.table_or_other_object
- Cataloghi di asset raggruppano risorse tipicamente allineate ai team o agli ambienti.
- Gli schemi (noti anche come database) sono suddivisioni all'interno dei cataloghi, organizzando gli asset in modo più granulare, ad esempio in base al progetto o al caso d'uso.
- Gli oggetti negli schemi includono tabelle (gestite o esterne), viste, volumi, funzioni e modelli.
Le tabelle possono essere gestite o esterne. Con le tabelle gestite, Unity Catalog gestisce sia la governance che l'archiviazione (formato Delta o Apache Iceberg). Con le tabelle esterne, Unity Catalog gestisce l'accesso da Databricks, ma il ciclo di vita o l'archiviazione dei dati viene gestito esternamente. Supporta più formati (Delta, CSV, JSON, Parquet e così via)
Il catalogo unity implementa un controllo di accesso granulare tramite comandi SQL ANSI su più livelli, ovvero metastore, catalogo, schema, fino a righe e colonne. Ad esempio, il comando seguente concede al gruppo di utenti "finance-team" l'autorizzazione per creare nuove tabelle nello schema "myschema" all'interno del catalogo "mycatalog".
GRANT CREATE TABLE ON SCHEMA mycatalog.myschema TO `finance-team`;
L'esplorazione degli asset di dati in Unity Catalog è semplice. È possibile usare Esplora cataloghi e un'interfaccia di ricerca per trovare le informazioni necessarie. Per aiutarti, gli asset hanno tag, commenti e persino descrizioni generate dall'intelligenza artificiale. Dopo aver trovato un asset di dati, è possibile usare funzionalità come derivazione, informazioni dettagliate sulle tabelle e diagrammi relazione di entità per ottenere una migliore comprensione.
Unity Catalog offre un quadro completo della cronologia dei dati. Registra l'accesso, gli audit trail e la derivazione, direttamente a livello di colonna.
Unity Catalog viene abilitato automaticamente per le aree di lavoro create dopo il 9 novembre 2023. È possibile iniziare a usare Unity Catalog con le impostazioni predefinite. Esistono tuttavia configurazioni facoltative che è possibile abilitare.
Microsoft Purview
Microsoft Purview è un servizio di governance dei dati che consente di gestire e supervisionare i dati tra sistemi locali, più cloud e piattaforme SaaS. Include funzionalità come l'individuazione dei dati, la classificazione, il rilevamento della derivazione e la governance dell'accesso.
Se integrato con Azure Databricks e Unity Catalog, Purview può individuare i dati di Lakehouse e inserire i metadati nella mappa dei dati. In questo modo è possibile applicare una governance coerente nell'intero ambiente dati, fungendo da catalogo centrale che riunisce i metadati di origini diverse.
Con questa integrazione, è possibile:
- Eseguire la scansione di Azure Databricks sia in reti pubbliche che private, grazie al runtime di integrazione completamente gestito di Microsoft Purview.
- Analizzare l'intero metastore del catalogo Unity o scegliere di analizzare solo cataloghi selettivi.
- Estrarre un set completo di metadati del catalogo Unity, inclusi i dettagli di metastore, cataloghi, schemi, tabelle/viste e colonne e così via.
- Classificare automaticamente i dati in base alle regole di classificazione di sistema predefinite o alle regole di classificazione personalizzate definite dall'utente per identificare i dati sensibili.
- Accedere a una visibilità dettagliata del lineage dei dati, mostrando come i dati vengono trasformati e spostati attraverso diversi sistemi e processi, incluso Azure Databricks.
- Eseguire l'analisi su richiesta o su una pianificazione ricorrente giornaliera/settimanale/mensile.
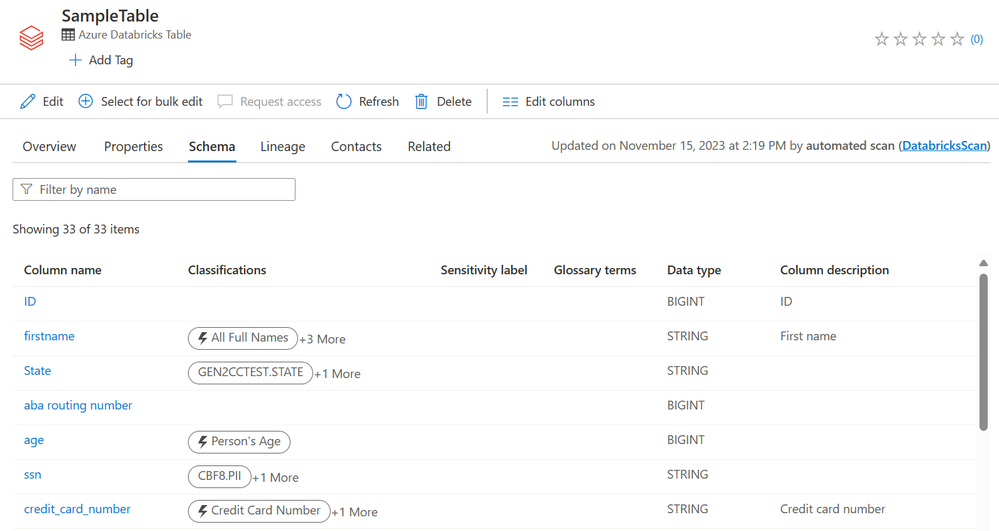
Inoltre, Microsoft Purview può analizzare il metastore Hive a livello di area di lavoro in Azure Databricks.