このコンテンツは次に適用されます:v2.1 | 最新バージョン:v4.0 (GA)
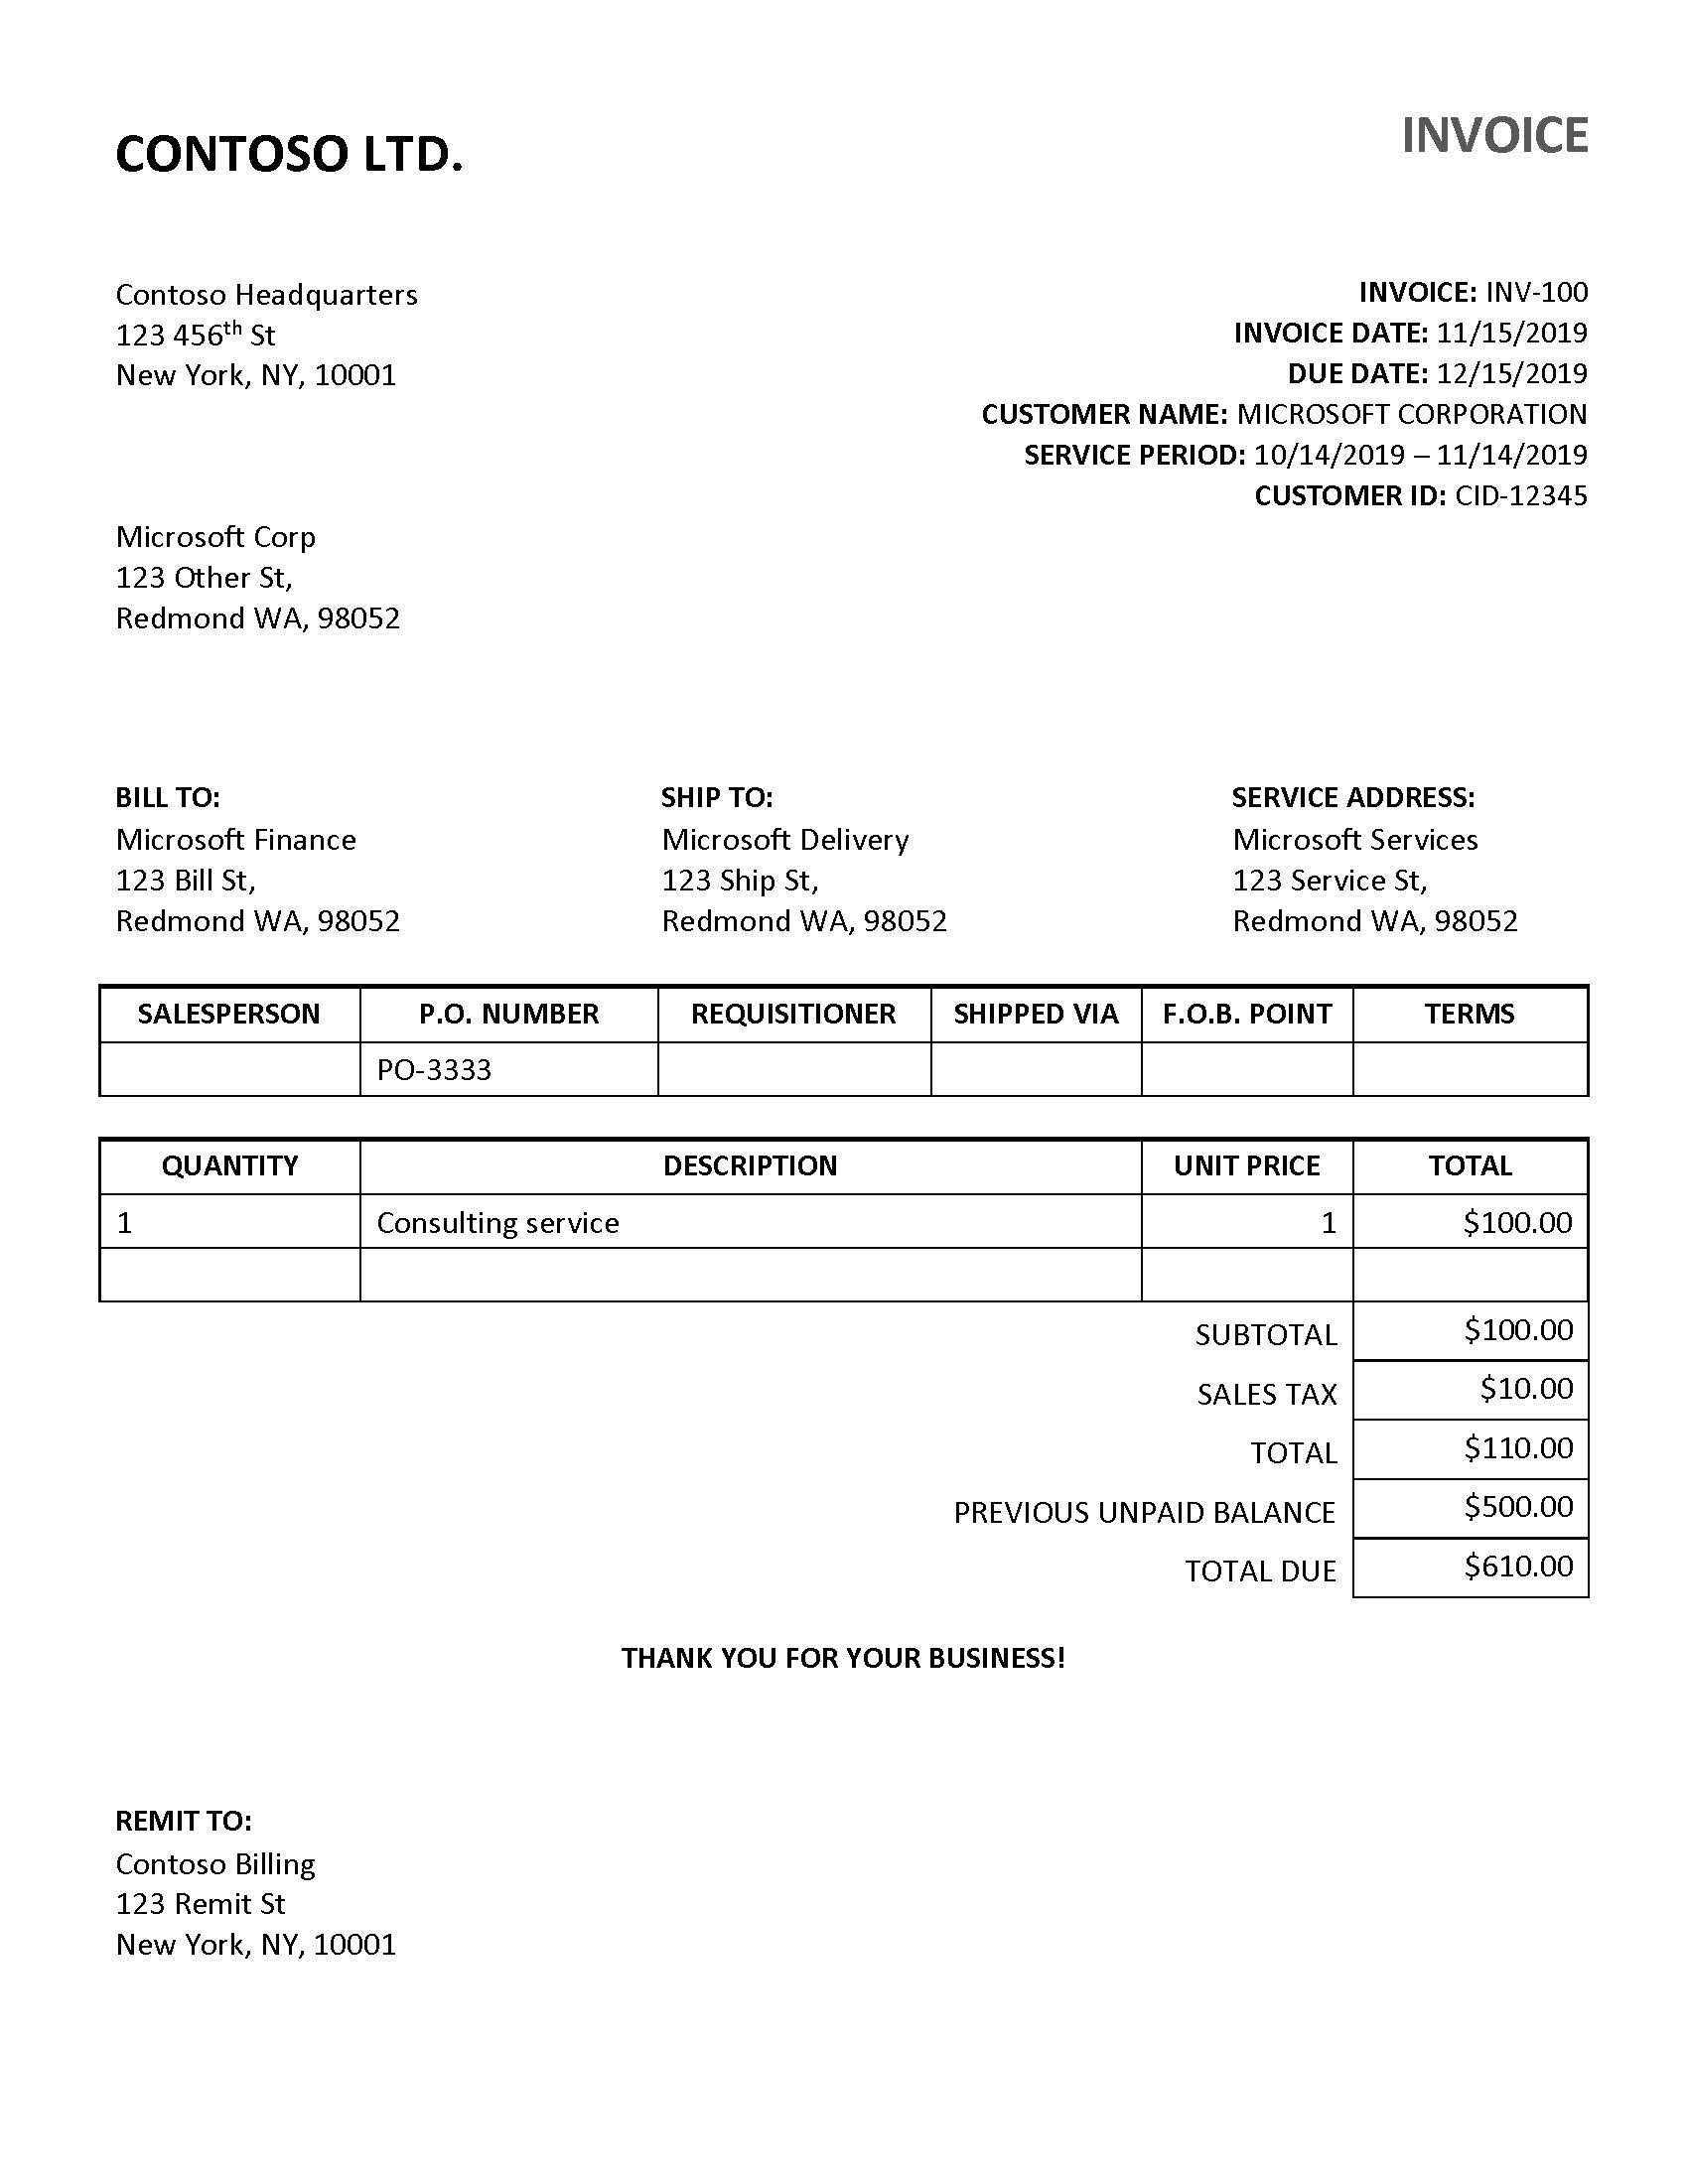
ドキュメント インテリジェンス請求書モデルでは、強力な光学式文字認識 (OCR) 機能を使用して、売上請求書、公共料金、発注書から主要なフィールドと品目を分析および抽出します。 請求書には、電話でキャプチャされた画像、スキャンされたドキュメント、デジタル PDF など、さまざまな形式と品質を使用できます。 API は請求書テキストを分析します。顧客名、請求先住所、期限、支払額などの重要な情報を抽出します。構造化された JSON データ表現を返します。 このモデルでは現在、27 言語の請求書がサポートされています。
サポートされているドキュメントの種類:
- 請求 書
- 光熱費
- 販売注文
- 発注書
自動請求書処理
自動請求書処理は、請求先アカウント ドキュメントからキー accounts payable フィールドを抽出するプロセスです。 抽出されたデータには、レビューと支払いのための買掛金 (AP) ワークフローと統合された請求書の明細が含まれます。 従来、買掛金勘定プロセスは手動で実行されるため、非常に時間がかかります。 請求書からのキー データの正確な抽出は、通常、請求書自動化プロセスの最も重要な手順の 1 つです。
Document Intelligence Studio で処理された請求書のサンプル:

ドキュメント インテリジェンスサンプルラベル付けツールで処理されたサンプル請求書:

開発オプション
ドキュメント インテリジェンス v4.0: 2024-11-30 (GA) では、次のツール、アプリケーション、ライブラリがサポートされています。
| 機能 | リソース | モデル ID |
|---|---|---|
| 請求書モデル | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
事前構築済み請求書 |
ドキュメント インテリジェンス v3.1 では、次のツール、アプリケーション、およびライブラリがサポートされています。
| 機能 | リソース | モデル ID |
|---|---|---|
| 請求書モデル | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
事前構築済み請求書 |
ドキュメント インテリジェンス v3.0 では、次のツール、アプリケーション、およびライブラリがサポートされています。
| 機能 | リソース | モデル ID |
|---|---|---|
| 請求書モデル | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
事前構築済み請求書 |
ドキュメント インテリジェンス v2.1 では、次のツール、アプリケーション、およびライブラリがサポートされています。
| 機能 | リソース |
|---|---|
| 請求書モデル | • ドキュメント インテリジェンス ラベル付けツール • REST API • クライアント ライブラリ SDK • ドキュメント インテリジェンス Docker コンテナー |
入力要件
次のファイル形式がサポートされています。
| モデル | 画像: JPEG/JPG、PNG、BMP、TIFF、HEIF |
Office: Word (DOCX)、Excel (XLSX)、PowerPoint (PPTX)、HTML |
|
|---|---|---|---|
| 読む | ✔ | ✔ | ✔ |
| レイアウト | ✔ | ✔ | ✔ |
| 一般ドキュメント | ✔ | ✔ | |
| プリビルド | ✔ | ✔ | |
| カスタム抽出 | ✔ | ✔ | |
| カスタム分類 | ✔ | ✔ | ✔ |
- 写真とスキャン: 最良の結果を得るには、ドキュメントごとに 1 つの明確な写真または高品質のスキャンを提供します。
- PDF とTIFF: PDF とTIFF の場合、最大 2,000 ページを処理できます。 (Free レベルのサブスクリプションでは、最初の 2 ページのみが処理されます)。
- ファイル サイズ: ドキュメントを分析するためのファイル サイズは、有料 (S0) レベルでは 500 MB、Free (F0) レベルでは 4 MB です。
- 画像の寸法: 寸法は、50 ピクセル x 50 ピクセルから 10,000 ピクセル x 10,000 ピクセルの間である必要があります。
- パスワード ロック: PDF がパスワードロックされている場合は、提出前にロックを解除する必要があります。
- テキストの高さ: 抽出するテキストの最小高さは、1024 x 768 ピクセルの画像で 12 ピクセルです。 このディメンションは、1 インチあたり 150 ドットの約 8 ポイントのテキストに対応します。
- カスタム モデル トレーニング: トレーニング データの最大ページ数は、カスタム テンプレート モデルの場合は 500 ページ、カスタム ニューラル モデルの場合は 50,000 ページです。
- カスタム抽出モデルトレーニング: トレーニング データの合計サイズは、テンプレート モデルの場合は 50 MB、ニューラル モデルの場合は 1 GB です。
- カスタム分類モデル トレーニング: トレーニング データの合計サイズは 1 GB で、最大 10,000 ページです。 2024-11-30 (GA) の場合、トレーニング データの合計サイズは 2 GB で、最大 10,000 ページです。
- Office ファイルの種類 (DOCX、XLSX、PPTX): 文字列の最大長の制限は 800 万文字です。
- サポートされているファイル形式: JPEG、PNG、PDF、TIFF。
- サポートされている PDF と TIFF では、最大 2,000 ページが処理されます。 Free レベルのサブスクライバーの場合、最初の 2 ページのみが処理されます。
- サポートされるファイル サイズは 50 MB 未満で、50 x 50 ピクセル以上、最大 10,000 x 10,000 ピクセルのサイズである必要があります。
請求書モデルのデータ抽出
顧客情報、仕入先の詳細、明細などのデータを請求書から抽出する方法を確認します。 次のリソースが必要です。
Azure サブスクリプション- 無料で作成できます。
Azure ポータルの Document Intelligence インスタンス。 無料価格レベル (
F0) を使用して、サービスを試すことができます。 リソースがデプロイされたら、[ リソースに移動 ] を選択してキーとエンドポイントを取得します。

ドキュメント インテリジェンス スタジオのホーム ページで、[請求書] を選択します。
サンプル請求書を分析したり、独自のファイルをアップロードしたりできます。
[ 分析の実行 ] ボタンを選択し、必要に応じて [分析] オプション を構成します。

ドキュメント インテリジェンスのサンプル ラベル付けツール
ドキュメント インテリジェンス サンプル ツールに移動します。
サンプル ツールのホーム ページで、[ 事前構築済みモデルを使用してデータを取得する ] タイルを選択します。

ドロップダウン メニューから分析する フォームの種類 を選択します。
分析するファイルの URL を次のオプションから選択します。
[ ソース ] フィールドで、ドロップダウン メニューから [URL ] を選択し、選択した URL を貼り付けて、[ フェッチ ] ボタンを選択します。

[ ドキュメント インテリジェンス サービス エンドポイント ] フィールドに、ドキュメント インテリジェンス サブスクリプションで取得したエンドポイントを貼り付けます。
キー フィールドに、ドキュメント インテリジェンス リソースから取得したキーを貼り付けます。

[ 分析の実行] を選択します。 ドキュメント インテリジェンス サンプル ラベル付けツールは、事前構築済みの分析 API を呼び出してドキュメントを分析します。
結果を表示する - 抽出されたキーと値のペア、行項目、抽出された強調表示されたテキスト、検出されたテーブルを確認します。
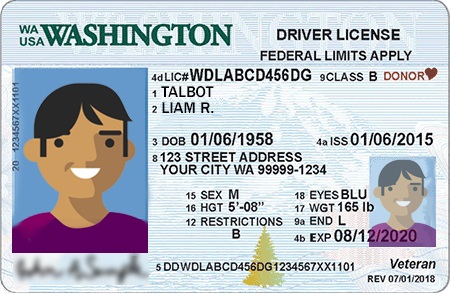
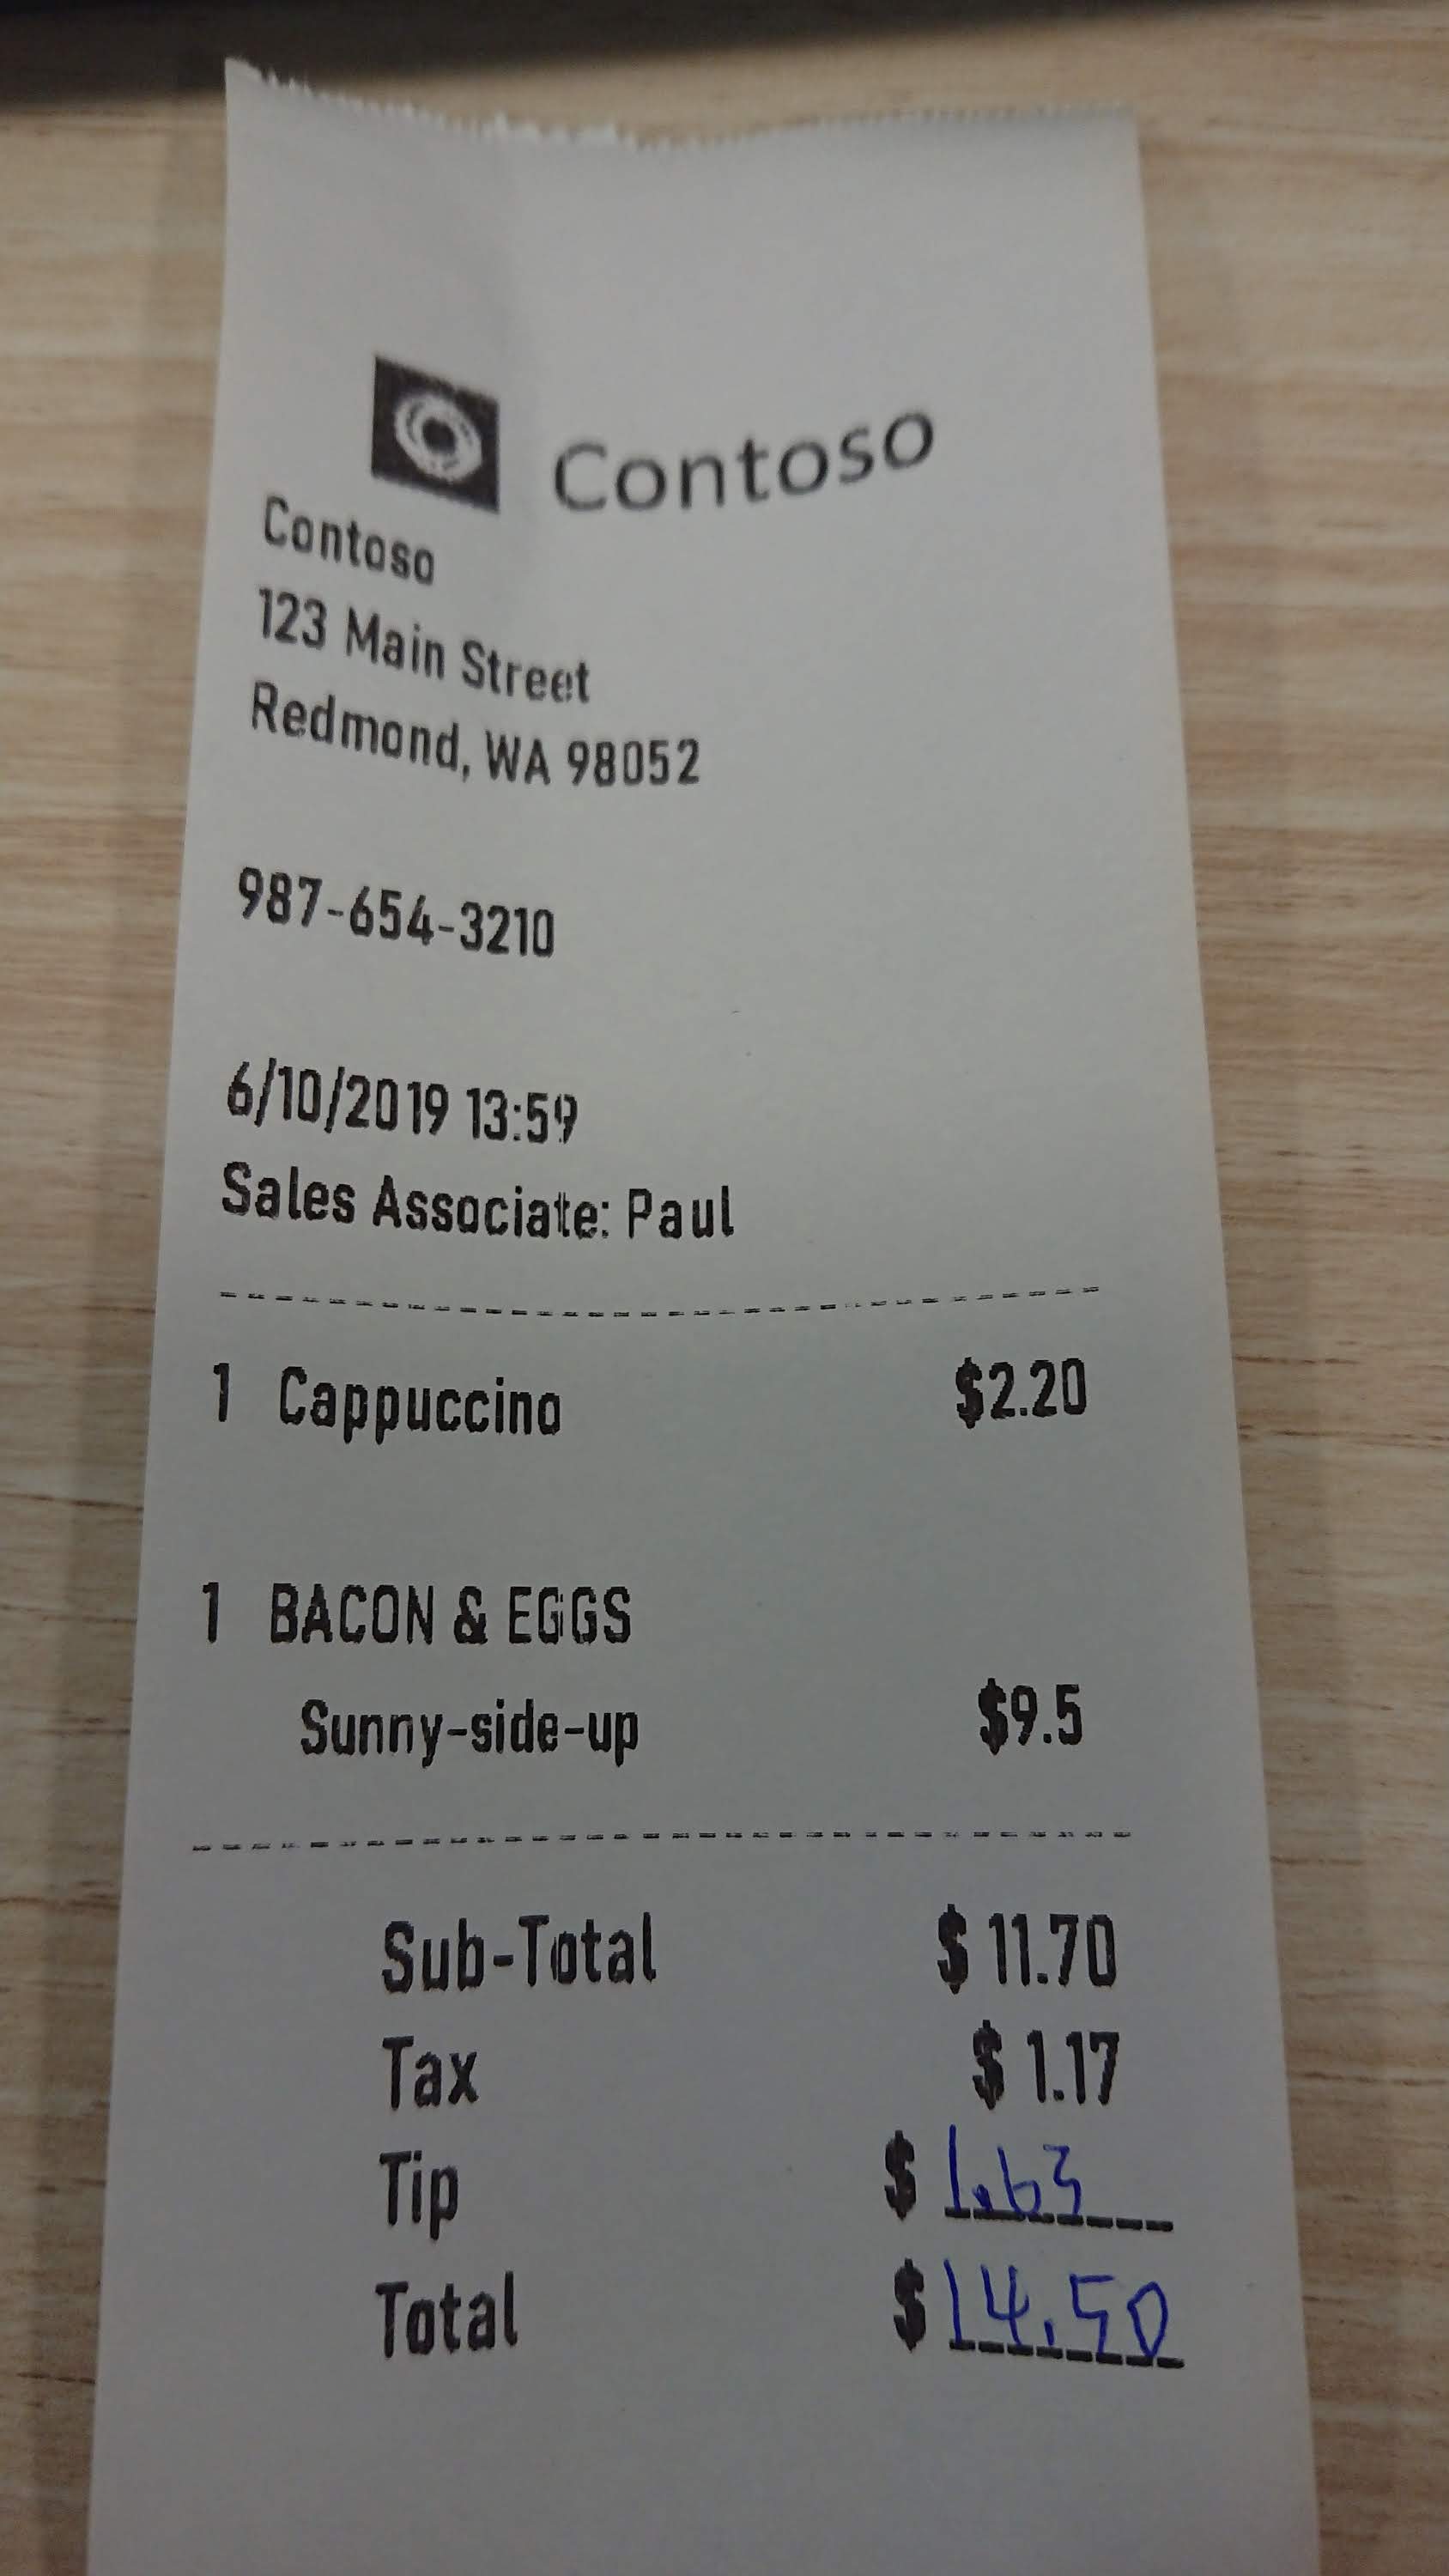

メモ
サンプル ラベル付けツールでは、BMP ファイル形式はサポートされていません。 これは、ドキュメント インテリジェンス サービスではなくツールの制限です。
サポートされている言語とロケール
サポートされている言語の完全な一覧については、事前構築済みのモデル言語のサポート ページを参照してください。
フィールド抽出
サポートされているドキュメント抽出フィールドについては、see GitHub サンプル リポジトリの invoice モデル スキーマ ページを参照してください。
抽出された請求書のキーと値のペアと品目は、JSON 出力の
documentResultsセクションにあります。
キーと値のペア
事前構築済みの請求書モデルでは、キーと値のペアの省略可能な戻り値がサポートされます。 既定では、キーと値のペアの返却は無効になっています。 キーと値のペアは、ラベルまたはキーとそれに関連付けられている応答または値を識別する請求書内の特定のスパンです。 請求書では、これらのペアは、そのフィールドまたは電話番号に対してユーザーが入力したラベルと値になります。 AI モデルは、さまざまなドキュメントの種類、形式、構造に基づいて識別可能なキーと値を抽出するようにトレーニングされています。
また、キーが存在することをモデルが検出した場合や、関連付けられた値がない場合、または省略可能なフィールドを処理するときに、キーを分離して存在することもできます。 たとえば、一部のインスタンスでは、フォームのミドル ネーム フィールドを空白のままにすることができます。 キーと値のペアは、常にドキュメントに含まれるテキストのスパンです。 顧客/ユーザーなど、同じ値が異なる方法で記述されているドキュメントの場合、関連付けられているキーは顧客またはユーザー (コンテキストに基づく) です。
JSON 出力
JSON 出力には、次の 3 つの部分があります。
-
"readResults"ノードには、認識されたすべてのテキストと選択マークが含まれています。 テキストは、ページ、行、個々の単語で整理されます。 -
"pageResults"ノードには、境界ボックスで抽出されたテーブルとセル、信頼度および readResults 内の行と単語への参照が含まれます。 -
"documentResults"ノードには、モデルが検出した請求書固有の値と品目が含まれます。 請求書 ID、出荷先、請求先、顧客、合計、明細など、請求書のすべてのフィールドを検索する場所です。
移行ガイド
- ドキュメント インテリジェンス v3.1 移行ガイドに従って、アプリケーションとワークフローで v3.0 バージョンを使用する方法について説明します。
::: moniker-end
次の手順
Document Intelligence Studio で独自のフォームとドキュメントを処理してみてください。
ドキュメント インテリジェンスのクイック スタートを完了し、選択した開発言語でドキュメント処理アプリの作成を開始します。
GitHub.
GitHub.
ドキュメント インテリジェンス サンプル ラベル付けツールを使用して、独自のフォームとドキュメントを処理してみてください。
ドキュメント インテリジェンスのクイック スタートを完了し、選択した開発言語でドキュメント処理アプリの作成を開始します。