ゲートウェイを使用して、複数の個々の要求を 1 つの要求に集約します。 このパターンは、クライアントが操作を実行するために異なるバックエンド システムに対して複数の呼び出しを行う必要がある場合に便利です。
コンテキストと問題
1 つのタスクを実行するには、クライアントがさまざまなバックエンド サービスに対して複数の呼び出しを行う必要がある場合があります。 タスクを実行するのに多くのサービスに依存するアプリケーションでは、要求ごとにリソースを展開する必要があります。 新しい機能またはサービスがアプリケーションに追加されると、追加の要求が必要になり、リソース要件とネットワーク呼び出しがさらに増加します。 クライアントとバックエンドの間のこのようなおしゃべりは、アプリケーションのパフォーマンスとスケールに悪影響を及ぼす可能性があります。 マイクロサービス アーキテクチャでは、多くの小規模なサービスを中心に構築されたアプリケーションのサービス間呼び出しの数が多いため、この問題がより一般的になりました。
次の図では、クライアントは各サービスに要求を送信します (番号は 1、2、3)。 各サービスは要求を処理し、アプリケーションに応答を返します (番号は 4、5、6)。 待機時間の長い携帯ネットワーク経由で個々の要求を送信することは非効率的であり、接続の損失や応答の不完全な原因となる可能性があります。 各要求は並列で実行される場合があります。 ただし、アプリケーションは個別の接続で要求ごとにデータを送信、待機、処理する必要があり、障害の可能性が高くなります。
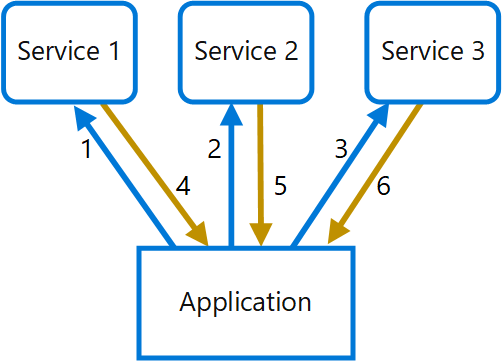
複数のバックエンド サービスを個別に呼び出し、個々の応答を受信するクライアントを示す図。 矢印は、双方向のサービス 1、2、および 3 にアプリケーションを接続します。
ソリューション
ゲートウェイを使用すると、クライアントとサービス間の頻繁な通信を削減できます。 ゲートウェイはクライアント要求を受信し、さまざまなバックエンド システムに要求をディスパッチし、クライアントに送信する前に結果を集計します。
このパターンにより、アプリケーションがバックエンド サービスに対して行う要求の数を減らし、待機時間の長いネットワークでアプリケーションのパフォーマンスを向上させることができます。
次の図では、アプリケーションはゲートウェイに要求を送信します (1)。 要求には、追加の要求のパッケージが含まれています。 ゲートウェイはこれらの要求を分解し、関連するサービスに送信することによって各要求を処理します (2)。 各サービスが応答をゲートウェイに返します (3)。 ゲートウェイは、各サービスからの応答を結合し、アプリケーションに応答を送信します (4)。 アプリケーションは、1 つの要求を行い、ゲートウェイから 1 つの応答のみを受信します。

この図は、ゲートウェイに 1 つの要求を送信するアプリケーションを示しています。ゲートウェイは複数のバックエンド サービスを呼び出し、集計された応答を返します。 ゲートウェイからサービス 1、2、3 を指す 3 つの矢印。 サービスからゲートウェイの方を指している 3 つの矢印。 1 つの矢印がアプリケーションからゲートウェイを指し、もう 1 つの矢印がゲートウェイからアプリケーションを指しています。
問題と考慮事項
このパターンを実装する方法を決定するときは、次の点を考慮してください。
ゲートウェイでは、バックエンド サービス間でサービス結合を導入しないでください。
ゲートウェイは、可能な限り待機時間を短縮するために、バックエンド サービスの近くに配置する必要があります。
ゲートウェイ サービスでは、単一障害点 (SPoF) が発生する可能性があります。 ゲートウェイがアプリケーションの可用性要件を満たすように適切に設計されていることを確認します。
ゲートウェイによってボトルネックが発生する可能性があります。 ゲートウェイが現在の負荷を処理するのに十分なパフォーマンスを備え、予想される増加に合わせてスケーリングできることを確認します。
ゲートウェイに対してロード テストを実行して、サービスに連鎖的な障害が発生しないようにします。
バルクヘッド、サーキット ブレーク、再試行、タイムアウトなどの手法を使用して、回復性のある設計を実装します。
1 つ以上のサービス呼び出しに時間がかかりすぎる場合は、タイムアウトして部分的なデータ セットを返すのが許容される可能性があります。 アプリケーションがこのシナリオを処理する方法を検討してください。
非同期の入出力 (I/O) を使用して、バックエンドでの遅延によってアプリケーションのパフォーマンスの問題が発生しないようにします。
関連付け ID を使用して分散トレースを実装し、個々の呼び出しを追跡します。
要求メトリックおよび応答のサイズを監視します。
エラーを処理するため、キャッシュ データをフェールオーバー戦略として返すことを検討してください。
ゲートウェイに集計を組み込むのではなく、ゲートウェイの背後に集約サービスを配置することを検討してください。 要求の集計は、ゲートウェイ内の他のサービスとは異なるリソース要件を持つ可能性があり、ゲートウェイのルーティングとオフロード機能に影響を与える可能性があります。
このパターンを使用する場合
このパターンは次の状況で使用します。
1 つの操作を実行するには、クライアントが複数のバックエンド サービスと通信する必要があります。
クライアントは、携帯ネットワークなど、待機時間が長いネットワークを使用する場合があります。
このパターンは、次の場合に適さない場合があります。
複数の操作で、クライアントと 1 つのサービス間の呼び出しの回数を削減したい場合。 そのシナリオでは、サービスにバッチ操作を追加する方が適している場合があります。
クライアントまたはアプリケーションはバックエンド サービスの近くに配置されており、待機時間は重要な要因ではありません。
ワークロード設計
ワークロードの設計でゲートウェイ集約パターンを使用して、Azure Well-Architected Framework の柱で説明されている目標と原則に対処する方法を評価します。 次の表は、このパターンが各柱の目標をサポートする方法に関するガイダンスを示しています。
| 支柱 | このパターンが柱の目標をサポートする方法 |
|---|---|
| 信頼性設計の決定は、故障に対するワークロードの回復性を高め、障害の発生後にワークロードを完全な機能状態に回復させるために役立ちます。 | このトポロジを使用すると、クライアント間の分散実装から一元化された実装に一時的な障害処理を移行できます。 - 一時的な障害を処理するための推奨事項 |
| セキュリティ設計の決定により、ワークロードのデータとシステムの機密性、整合性、および可用性が確保されます。 | このトポロジは、多くの場合、クライアントがシステムに備えるタッチポイントの数を減らし、パブリック のサーフェス領域と認証ポイントを減らします。 集約されたバックエンドは、クライアントから完全にネットワーク分離されたままになります。 - SE:04 セグメンテーション - SE:08 リソースのセキュリティ強化 |
| オペレーショナルエクセレンス は、標準化されたプロセスとチームの結束によってワークロードの品質を提供します。 | このパターンにより、バックエンド ロジックはクライアントとは別に進化できます。 この分離により、クライアントのタッチポイントを変更しなくても、チェーンサービスの実装やデータ ソースを柔軟に変更できます。 - OE:04 ツールとプロセス |
| パフォーマンス効率 は、スケーリング、データ、およびコードの最適化を通じて、ワークロード の需要を効率的に満たすのに役立ちます。 | この設計では、クライアントが複数の接続を確立する設計よりもレイテンシが小さくなります。 集計実装でのキャッシュにより、バックエンド システムへの呼び出しが最小限に抑えられます。 - PE:03 サービスの選択 - PE:08 データパフォーマンス |
このパターンによって柱内にトレードオフが生じる場合は、他の柱の目標に照らして検討してください。
Example
顧客の注文の概要エクスペリエンスを提供するマイクロサービス ベースのアプリケーションについて考えてみましょう。 ユーザーが注文ページを開くと、アプリケーションは、注文サービス、出荷サービス、顧客プロファイル サービスなどの複数のバックエンド サービスからデータを取得する必要があります。
マイクロサービス アーキテクチャでは、これらのサービスは個別に実装およびデプロイされます。 集計を使用しない場合、クライアントは各サービスを直接呼び出す必要があり、待機時間と複雑さが増します。
この問題に対処するために、アプリケーションはゲートウェイ集約レイヤーとして Azure API Management を使用します。 クライアントは、注文情報のコレクターとして機能する API Management 操作に 1 つの要求を送信します。 その後、API Management はサポートするバックエンド API を呼び出し、クライアントに統一された応答を返します。
この軽量構成を実装するには、API Management の送信要求ポリシー を使用して 、複数のサービスからデータを取得し、結合された応答を構築します。 この例では、バックエンド サービスは Azure Container Apps 環境 で実行され、各バックエンド サービスは、直接クライアント アクセスから隠されたままのコンテナー アプリとしてデプロイされます。
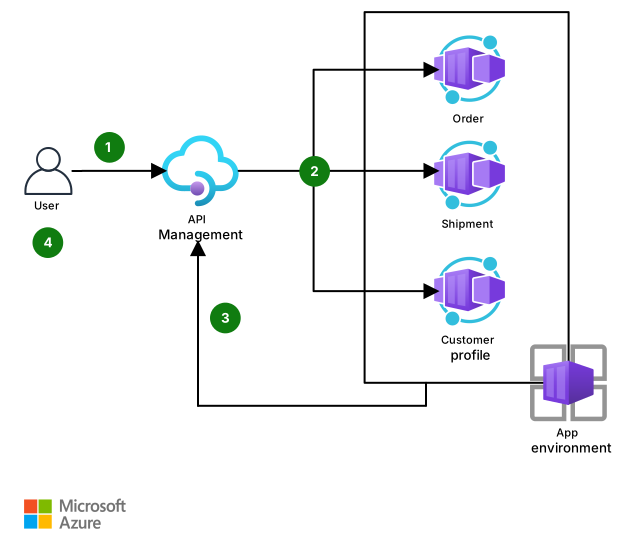
この図では、矢印が顧客から API Management を指しています。 別の矢印は API Management を指し、注文、出荷、顧客プロファイルを指す 3 つの矢印に分割されます。 アプリ環境は、顧客プロファイルの下と右側に表示されます。 ペイロードの概要から API Management を指す矢印。
このアーキテクチャのVisio ファイルをダウンロードしてください。
要求フローは、次の手順に従います。
クライアントは、API Management を介して公開された注文の概要エンドポイントに要求を送信します。
API Management は、バックエンド サービスから注文、出荷、顧客プロファイル データを収集するポリシーを適用します。
API Management は、バックエンドの応答を 1 つの注文の概要ペイロードに構成します。
API Management は、集計された応答をクライアントに返します。
この集計レイヤーを導入することで、ソリューションはクライアント間のラウンド トリップを削減し、クライアントとの対話を簡略化します。 このレイヤーは、応答しないバックエンド サービスを適切に処理し、障害が集約された応答全体にカスケードされないようにする役割を担います。 要求ごとのタイムアウト、条件付きエラー処理、および サーキット ブレーカーを使用して、API Management ポリシーを強化します。
バックエンドの 1 つがタイムアウトするか、エラーを返した場合、API Management は操作に最も適した動作を適用できます。 たとえば、不足しているデータが許容される場合に部分的な応答を返したり、完全で一貫性のある注文データが必要な場合に要求全体を失敗させたりすることがあります。 クライアントが予測可能な動作を経験できるように、ポリシー設計でこの決定を明示的に行います。
この方法は、ゲートウェイが軽量のコンポジション、シェイプ、応答のアセンブリを実行する場合に適しています。 集計にカスタム ドメイン ロジック、複雑な変換、または実行時間の長いオーケストレーションが必要な場合は、その機能をゲートウェイの背後にある専用のカスタム サービスに配置します。
監視のために、API Management の動作をバックエンド待機時間と関連付けることができるように、完全な要求パス全体でテレメトリを収集します。 1 つのクライアント操作が複数のバックエンド呼び出しに依存し、1 つの依存関係でのエラーまたは応答の低速化が最終的な集計結果に影響を与える可能性があるため、この可視性はゲートウェイ集計パターンで重要です。 中央監視プラットフォームとして Azure Monitor を使用します。 ゲートウェイとポリシー実行パスの API Management ログとメトリックを収集し、 Container Apps の監視 を有効にして、バックエンド コンテナー アプリからアプリケーション ログとメトリックをキャプチャします。 API Management とバックエンド テレメトリを Log Analytics ワークスペース にルーティングして、統合クエリ、アラート、トラブルシューティングを行います。 このテレメトリを使用すると、タイムアウト パターンを検出し、応答の一部または失敗を引き起こしたバックエンドの依存関係を特定し、待機時間またはエラー率が高いアラートを作成できます。
次のステップ
関連するリソース
- フロントエンド用バックエンド パターン
- Gateway Offloading pattern (ゲートウェイ オフロード パターン)
- Gateway Routing pattern (ゲートウェイ ルーティング パターン)