この記事では、Databricks Model Serving を使用してカスタム モデルを提供するモデル サービス エンドポイントを作成する方法について説明します。
Model Serving には、提供エンドポイントの作成に関する次のオプションが用意されています。
- サービング UI
- REST API
- MLflow デプロイ SDK
AI モデルを提供するエンドポイントの作成については、「 エンドポイントを提供する基盤モデルの作成」を参照してください。
要件
- ワークスペースは 、サポートされているリージョンに存在する必要があります。
- モデルでプライベート ミラー サーバーのカスタム ライブラリまたはライブラリを使用する場合は、モデル エンドポイントを作成する前に、「 モデル サービスでカスタム Python ライブラリを使用 する」を参照してください。
- MLflow デプロイ SDK を使用してエンドポイントを作成するには、MLflow デプロイ クライアントをインストールする必要があります。 インストールするには、以下を実行します。
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
ID とアクセス
モデル サービス エンドポイントを作成または更新するには、呼び出し元とエンドポイントの記録された作成者の両方が次の操作を行う必要があります。
- ワークスペースのメンバーになる。
-
workspace-accessの利用資格を保持します。
クリエイターのアイデンティティ
エンドポイントを作成すると、Databricks は呼び出し元 ID をエンドポイントの 作成者として記録します。 この ID (通常はサービス プリンシパル) は、エンドポイントの代わりに Unity カタログ リソースにアクセスするために使用され、作成後に変更することはできません。
記録された作成者に必要な Unity カタログの許可がない場合、またはワークスペースから削除されている場合は、エンドポイントを削除し、必要なアクセス許可を持ち、現在のワークスペース メンバーであるサービス プリンシパルで再作成する必要があります。
構成と提供エンティティの更新により、記録された作成者のワークスペース メンバーシップと許可が再評価されます。 呼び出し元に有効なアクセス許可がある場合でも、記録された作成者がワークスペース メンバーでなくなった場合、更新は PERMISSION_DENIED で失敗します。
対象エンティティの権限
記録上の作成者は、各対象エンティティに対して以下の権限を保持している必要があります。 エンドポイントの作成または更新時に検証される許可が欠落している場合、要求は PERMISSION_DENIED エラーで失敗します。 クエリ時に必要な許可は事前に検証されません。許可がない場合、エンドポイントがトラフィックを処理するときに実行時エラーが発生します。
| リソースの種類 | 必要な許可 | 検証されたとき |
|---|---|---|
| Unity カタログ モデル |
USE CATALOGカタログで、USE SCHEMAスキーマで、EXECUTEモデルで |
エンドポイントの作成または更新 |
注
Unity カタログ モデルで推移関数の依存関係が宣言されている場合、記録された作成者もそれらのアップストリーム関数に EXECUTE する必要があります。
エンドポイント アクセスの管理
モデル サービス エンドポイントのアクセス制御オプションを理解するには、モデル サービス エンドポイント に対するアクセス許可の管理に関するページを参照してください。
エンドポイントの作成
UI の提供
サービス UI を使用してサービスを提供するモデルのエンドポイントを作成できます。
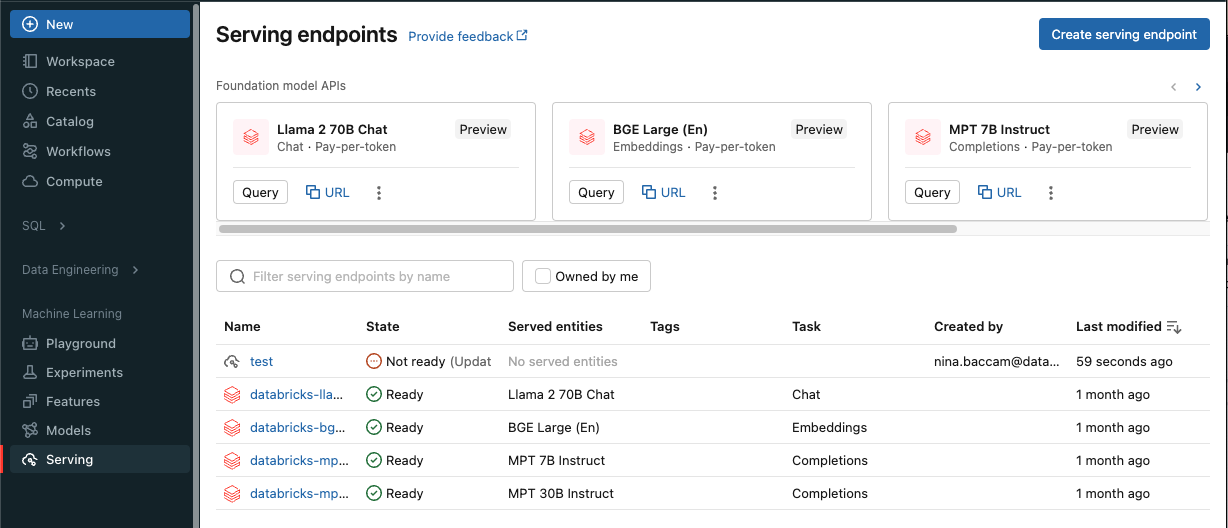
サイドバーで [Serving]\( サービス \) をクリックして、サービス UI を表示します。
[ サービス エンドポイントの作成] をクリックします。
Unity カタログ (推奨) または従来の ワークスペース モデル レジストリのモデルの場合:
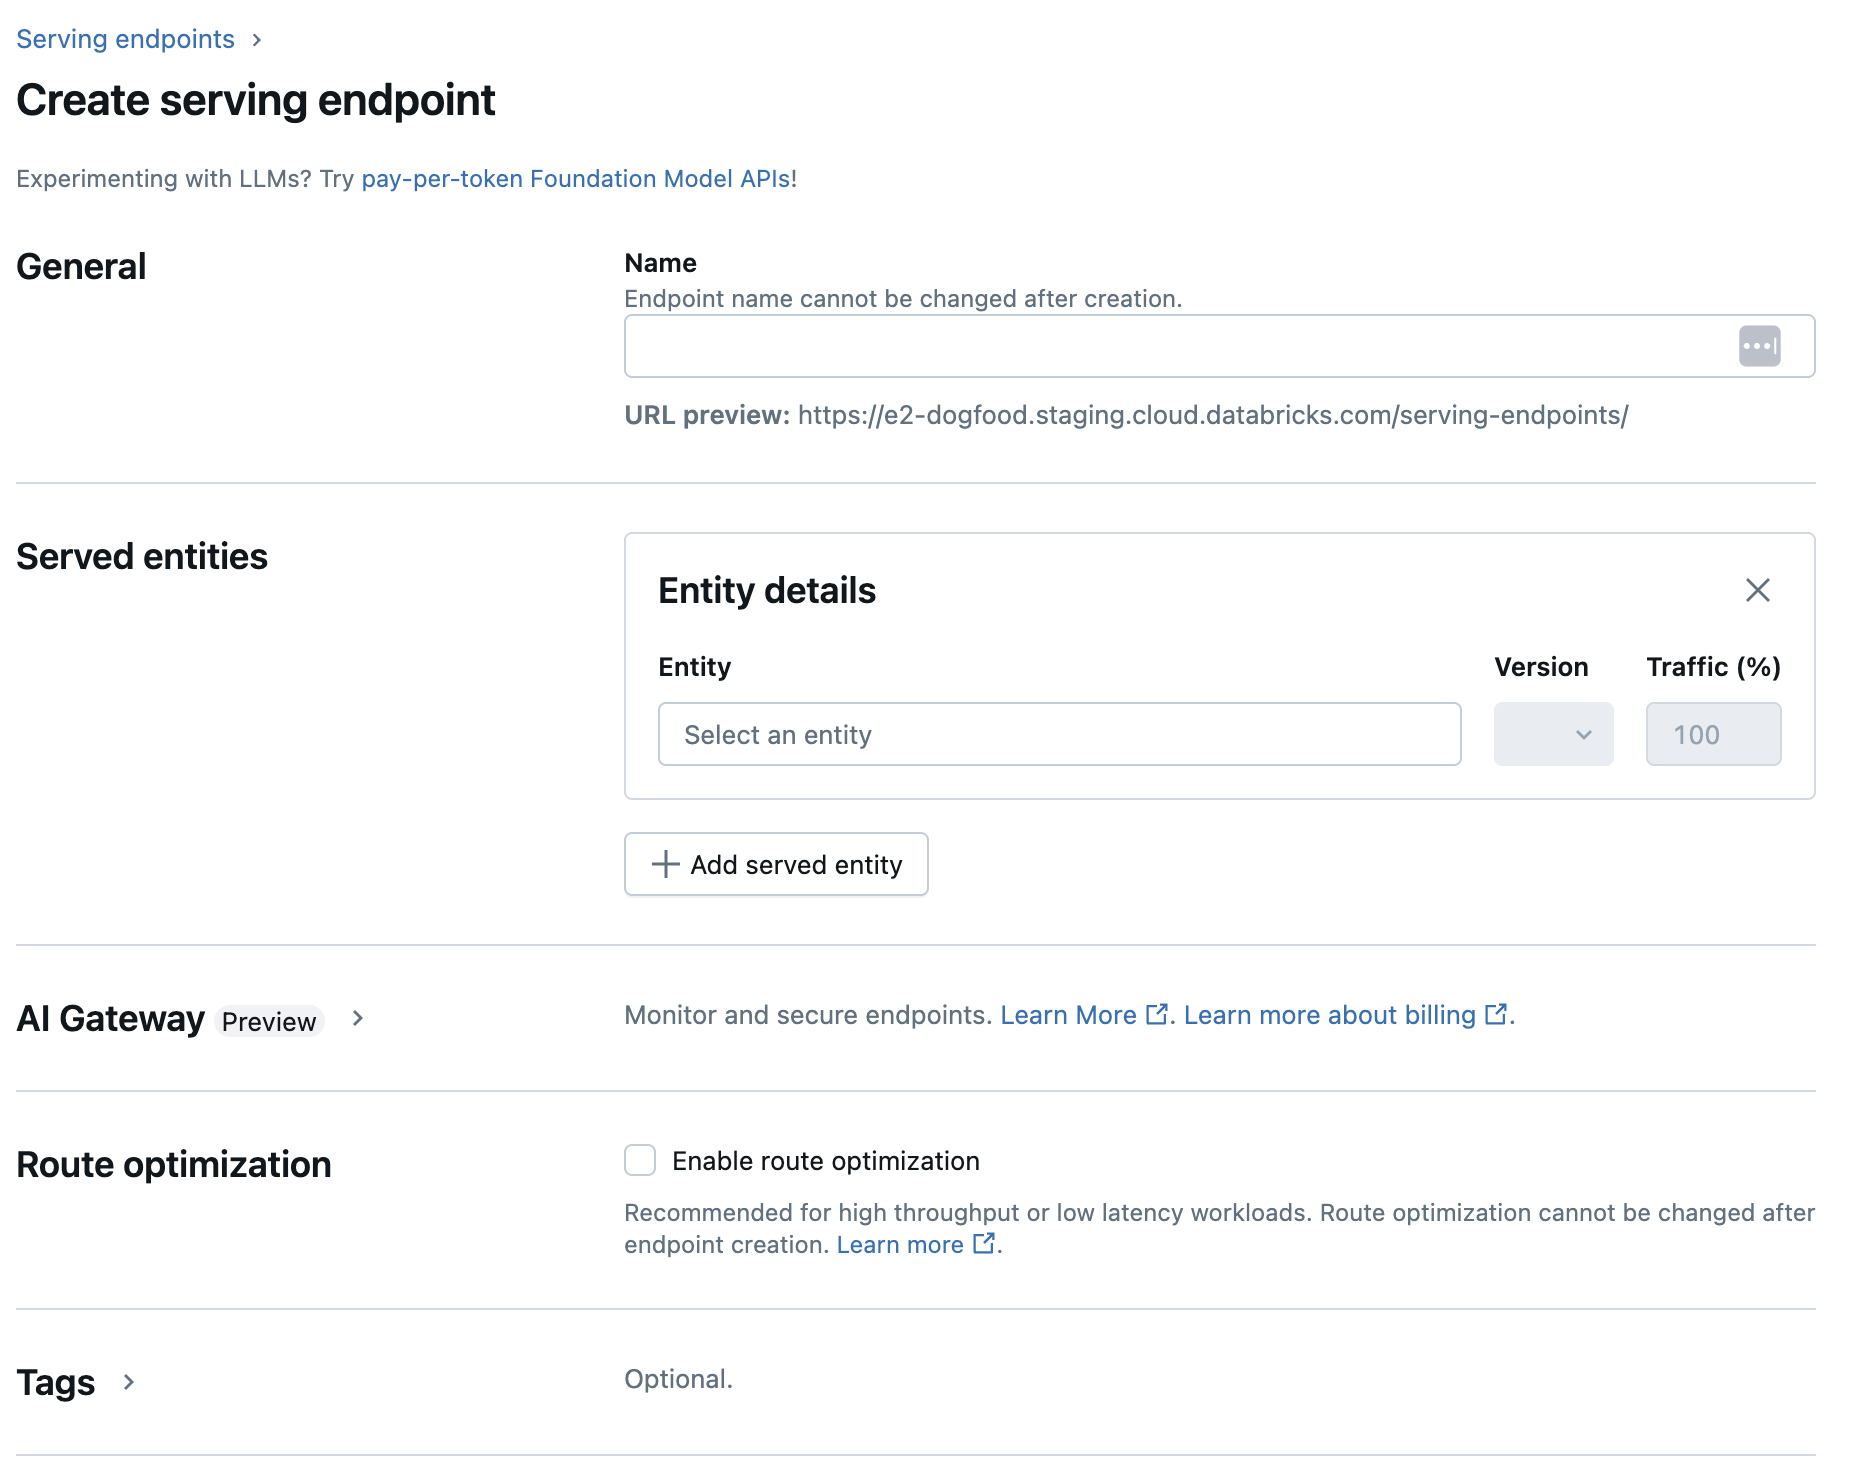
[ 名前 ] フィールドに、エンドポイントの名前を指定します。
- エンドポイント名では、
databricks-プレフィックスを使用できません。 このプレフィックスは、Databricks の事前構成済みエンドポイント用に予約されています。
- エンドポイント名では、
[Served entities]\(提供されるエンティティ\) セクションで、次のようにします。
- [エンティティ] フィールドをクリックして、[提供されたエンティティの選択] フォームを開きます。
- モデルが登録されている場所に基づいて、 マイ モデル ( Unity カタログ または マイ モデル - モデル レジストリ ) を選択します。 フォームは、選択内容に基づいて動的に更新されます。
- 提供したいモデルとモデルのバージョンを選択します。
- 提供されるモデルにルーティングするトラフィックの割合を選択します。
- 使用するコンピューティングのサイズを選択します。 ワークロードには CPU または GPU コンピューティングを使用できます。 標準のタイプより多くのメモリを必要とするモデル向けの
CPU_MEDIUMおよびCPU_LARGEオプションを含む、使用可能なワークロード タイプについては、CPUを参照してください。 GPU コードの例については、 GPU ワークロードの種類に関する説明を参照してください。 - [ コンピューティング スケールアウト] で、このサービスモデルが同時に処理できる要求の数に対応するコンピューティング スケールアウトのサイズを選択します。 この数値は、QPS にモデル実行時間を掛けた値とほぼ同じである必要があります。 顧客定義のコンピューティング設定については、 モデルサービスの制限に関する説明を参照してください。
- 使用可能なサイズは、0 から 4 要求の場合は Small 、 Medium 8 から 16 要求、16 から 64 要求の場合は Large です。
- 使用しないときにエンドポイントをゼロにスケールダウンする必要があるかどうかを指定します。 運用環境のエンドポイントでは、容量がゼロにスケーリングされると保証されないため、ゼロにスケーリングすることはお勧めしません。 エンドポイントがゼロにスケーリングされると、要求を処理するためにエンドポイントがスケールアップされるときに、追加の待機時間 (コールド スタートとも呼ばれます) が発生します。
- [ 詳細な構成] では、次のことができます。
- サービスされるエンティティの名前を変更して、エンドポイントでの表示方法をカスタマイズします。
- エンドポイントから リソースに接続する 環境変数を追加するか、 機能参照 DataFrame を エンドポイントの推論テーブルに記録します。 機能参照 DataFrame をログに記録するには、MLflow 2.14.0 以降が必要です。
- (省略可能)サービスを提供するエンティティをエンドポイントに追加するには、[ 提供されたエンティティの追加 ] をクリックし、上記の構成手順を繰り返します。 1 つのエンドポイントから複数のモデルまたはモデル バージョンを提供し、それらの間のトラフィックの分割を制御できます。 詳細については、 複数のモデルの提供 を参照してください。
[ ルートの最適化 ] セクションでは、エンドポイントのルート最適化を有効にすることができます。 ルートの最適化は、QPS とスループットの要件が高いエンドポイントに推奨されます。 サービス エンドポイントでのルートの最適化に関する説明を参照してください。
[AI Gateway] セクションでは、エンドポイントで有効にするガバナンス機能を選択できます。 Unity GatewayによるAIガバナンスを参照してください。
[ 作成] をクリックします。 [ サービス エンドポイント] ページが 表示され、 サービス エンドポイントの状態 が [準備ができていません] と表示されます。
REST API
REST API を使ってエンドポイントを作成できます。 エンドポイント構成パラメーターについては、 POST /api/2.0/serving-endpoints を参照してください。
次の例では、Unity カタログ モデル レジストリに登録されている my-ads-model モデルの 3 番目のバージョンを提供するエンドポイントを作成します。 Unity Catalog からモデルを指定するには、catalog.schema.example-model などの親カタログとスキーマを含む完全なモデル名を指定します。 この例では、 min_provisioned_concurrency と max_provisioned_concurrencyでカスタム定義のコンカレンシーを使用します。 コンカレンシー値は 4 の倍数である必要があります。
POST /api/2.0/serving-endpoints

{
  "name": "uc-model-endpoint",
  "config":
  {
    "served_entities": [
      {
        "name": "ads-entity",
        "entity_name": "catalog.schema.my-ads-model",
        "entity_version": "3",
        "min_provisioned_concurrency": 4,
        "max_provisioned_concurrency": 12,
        "scale_to_zero_enabled": false
      }
    ]
  }
}
応答の例を次に示します。 エンドポイントの config_update 状態が NOT_UPDATING され、提供されるモデルは READY 状態です。
{
  "name": "uc-model-endpoint",
  "creator": "user@email.com",
  "creation_timestamp": 1700089637000,
  "last_updated_timestamp": 1700089760000,
  "state": {
    "ready": "READY",
    "config_update": "NOT_UPDATING"
  },
  "config": {
    "served_entities": [
      {
        "name": "ads-entity",
        "entity_name": "catalog.schema.my-ads-model",
        "entity_version": "3",
        "min_provisioned_concurrency": 4,
        "max_provisioned_concurrency": 12,
        "scale_to_zero_enabled": false,
        "workload_type": "CPU",
        "state": {
          "deployment": "DEPLOYMENT_READY",
          "deployment_state_message": ""
        },
        "creator": "user@email.com",
        "creation_timestamp": 1700089760000
      }
    ],
    "config_version": 1
  },
  "tags": [
    {
      "key": "team",
      "value": "data science"
    }
  ],
  "id": "e3bd3e471d6045d6b75f384279e4b6ab",
  "permission_level": "CAN_MANAGE",
  "route_optimized": false
}
MLflow デプロイ SDK
MLflow デプロイ には、作成、更新、削除のタスク用の API が用意されています。 これらのタスクの API は、提供エンドポイントの REST API と同じパラメーターを受け取ります。 エンドポイント構成パラメーターについては、 POST /api/2.0/serving-endpoints を参照してください。
次の例では、Unity カタログ モデル レジストリに登録されている my-ads-model モデルの 3 番目のバージョンを提供するエンドポイントを作成します。 親カタログやスキーマを含む完全なモデル名を指定する必要があります (例: catalog.schema.example-model)。 この例では、 min_provisioned_concurrency と max_provisioned_concurrencyでカスタム定義のコンカレンシーを使用します。 コンカレンシー値は 4 の倍数である必要があります。
import mlflow
from mlflow.deployments import get_deploy_client

mlflow.set_registry_uri("databricks-uc")
client = get_deploy_client("databricks")

endpoint = client.create_endpoint(
    name="unity-catalog-model-endpoint",
    config={
        "served_entities": [
            {
                "name": "ads-entity",
                "entity_name": "catalog.schema.my-ads-model",
                "entity_version": "3",
                "min_provisioned_concurrency": 4,
                "max_provisioned_concurrency": 12,
                "scale_to_zero_enabled": False
            }
        ]
    }
)
ワークスペース クライアント
次の例は、Databricks Workspace Client SDK を使用してエンドポイントを作成する方法を示しています。
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

w = WorkspaceClient()

w.serving_endpoints.create(
    name="uc-model-endpoint",
    config=EndpointCoreConfigInput(
        served_entities=[
            ServedEntityInput(
                name="ads-entity",
                entity_name="catalog.schema.my-ads-model",
                entity_version="3",
                workload_size="Small",
                scale_to_zero_enabled=False
            )
        ]
    )
)
次のこともできます。
- 推論テーブルを有効に して、受信した要求と、エンドポイントを提供するモデルへの送信応答を自動的にキャプチャします。
- エンドポイントで推論テーブルが有効になっている場合は、 特徴参照 DataFrame を推論テーブルにログに記録できます。
環境変数を追加して、モデル提供の資格情報を格納することもできます。 モデル サービス エンドポイントからのリソースへのアクセスの構成を参照してください
GPU ワークロードの種類
GPU デプロイは、次のパッケージ バージョンと互換性があります。
- PyTorch 1.13.0 - 2.0.1
- TensorFlow 2.5.0 - 2.13.0
- MLflow 2.4.0 以降
次の例では、さまざまな方法を使用して GPU エンドポイントを作成する方法を示します。
UI の提供
サービス UI を使用して GPU ワークロードのエンドポイントを構成するには、エンドポイントの作成時に [コンピューティングの種類] ドロップダウンから目的の GPU の種類を選択します。 「エンドポイントの作成」と同じ手順に従いますが、CPU ではなく GPU ワークロードの種類を選択します。
REST API
GPU を使用してモデルをデプロイするには、エンドポイント構成に workload_type フィールドを含めます。
POST /api/2.0/serving-endpoints

{
  "name": "gpu-model-endpoint",
  "config": {
    "served_entities": [{
      "entity_name": "catalog.schema.my-gpu-model",
      "entity_version": "1",
      "workload_type": "GPU_SMALL",
      "workload_size": "Small",
      "scale_to_zero_enabled": false
    }]
  }
}
MLflow デプロイ SDK
次の例は、MLflow Deployments SDK を使用して GPU エンドポイントを作成する方法を示しています。
import mlflow
from mlflow.deployments import get_deploy_client

mlflow.set_registry_uri("databricks-uc")
client = get_deploy_client("databricks")

endpoint = client.create_endpoint(
    name="gpu-model-endpoint",
    config={
        "served_entities": [{
            "entity_name": "catalog.schema.my-gpu-model",
            "entity_version": "1",
            "workload_type": "GPU_SMALL",
            "workload_size": "Small",
            "scale_to_zero_enabled": False
        }]
    }
)
ワークスペース クライアント
次の例は、Databricks Workspace Client SDK を使用して GPU エンドポイントを作成する方法を示しています。
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

w = WorkspaceClient()

w.serving_endpoints.create(
    name="gpu-model-endpoint",
    config=EndpointCoreConfigInput(
        served_entities=[
            ServedEntityInput(
                entity_name="catalog.schema.my-gpu-model",
                entity_version="1",
                workload_type="GPU_SMALL",
                workload_size="Small",
                scale_to_zero_enabled=False
            )
        ]
    )
)
使用可能な GPU ワークロードの種類は、次の表に示すように、クラウド プロバイダーによって異なります。
| GPU ワークロードの種類 | GPU インスタンス | GPU メモリ |
|---|---|---|
GPU_SMALL |
1xT4 | 16 GB |
GPU_LARGE |
1xA100 | 80 GB |
GPU_LARGE_2 |
2xA100 | 160 GB |
GPU_LARGE_4 |
4xA100 | 320 GB |
GPU エンドポイントの場合、コンカレンシー値によって、モデルに対応するために割り当てられるレプリカの数が決まります。 レプリカの数は、コンカレンシー値を 4 で割った値と等しくなります。 たとえば、 min_provisioned_concurrency を 12 に設定すると、3 つのレプリカがプロビジョニングされます。
カスタム モデル エンドポイントを変更する
カスタム モデル エンドポイントを有効化すると、必要に応じてコンピューティング構成を更新できます。 特にモデルのリソースを増やす必要が生じた場合に、この構成を有効活用できます。 モデルを提供するためのリソース割り当てには、ワークロードのサイズとコンピューティング構成が重要な役割を果たします。
注
構成の更新と提供エンティティの更新では、エンドポイントに記録されている作成者のワークスペース メンバーシップと、提供エンティティごとの付与権限が再検証されます。 更新を送信する前に、両方が引き続き有効であることを確認してください。ID とアクセスを参照してください。
更新エラーを回避するには:
- チームが所有する有効期間の長いサービス プリンシパルをエンドポイント作成者として使用します。
- 後でワークスペースから非アクティブ化または削除される可能性がある個人用ユーザー アカウントは使用しないでください。
- 記録された作成者は、エンドポイントの有効期間中、ワークスペース メンバーのままである必要があります。
注
エンドポイント構成の更新が失敗する可能性があります。 障害が発生した場合、既存のアクティブな構成は、更新が行われなかったかのように有効なままです。
エンドポイントの状態を確認して、更新プログラムが正常に適用されたことを確認します。
新しい構成の準備ができるまでは、古い構成が予測トラフィックを提供し続けます。 更新が進行中の間は、別の更新を行うことはできません。 ただし、進行中の更新は、Serving UI から取り消すことができます。
UI の提供
モデル エンドポイントを有効にしたら、[ エンドポイントの編集] を選択してエンドポイントのコンピューティング構成を変更します。
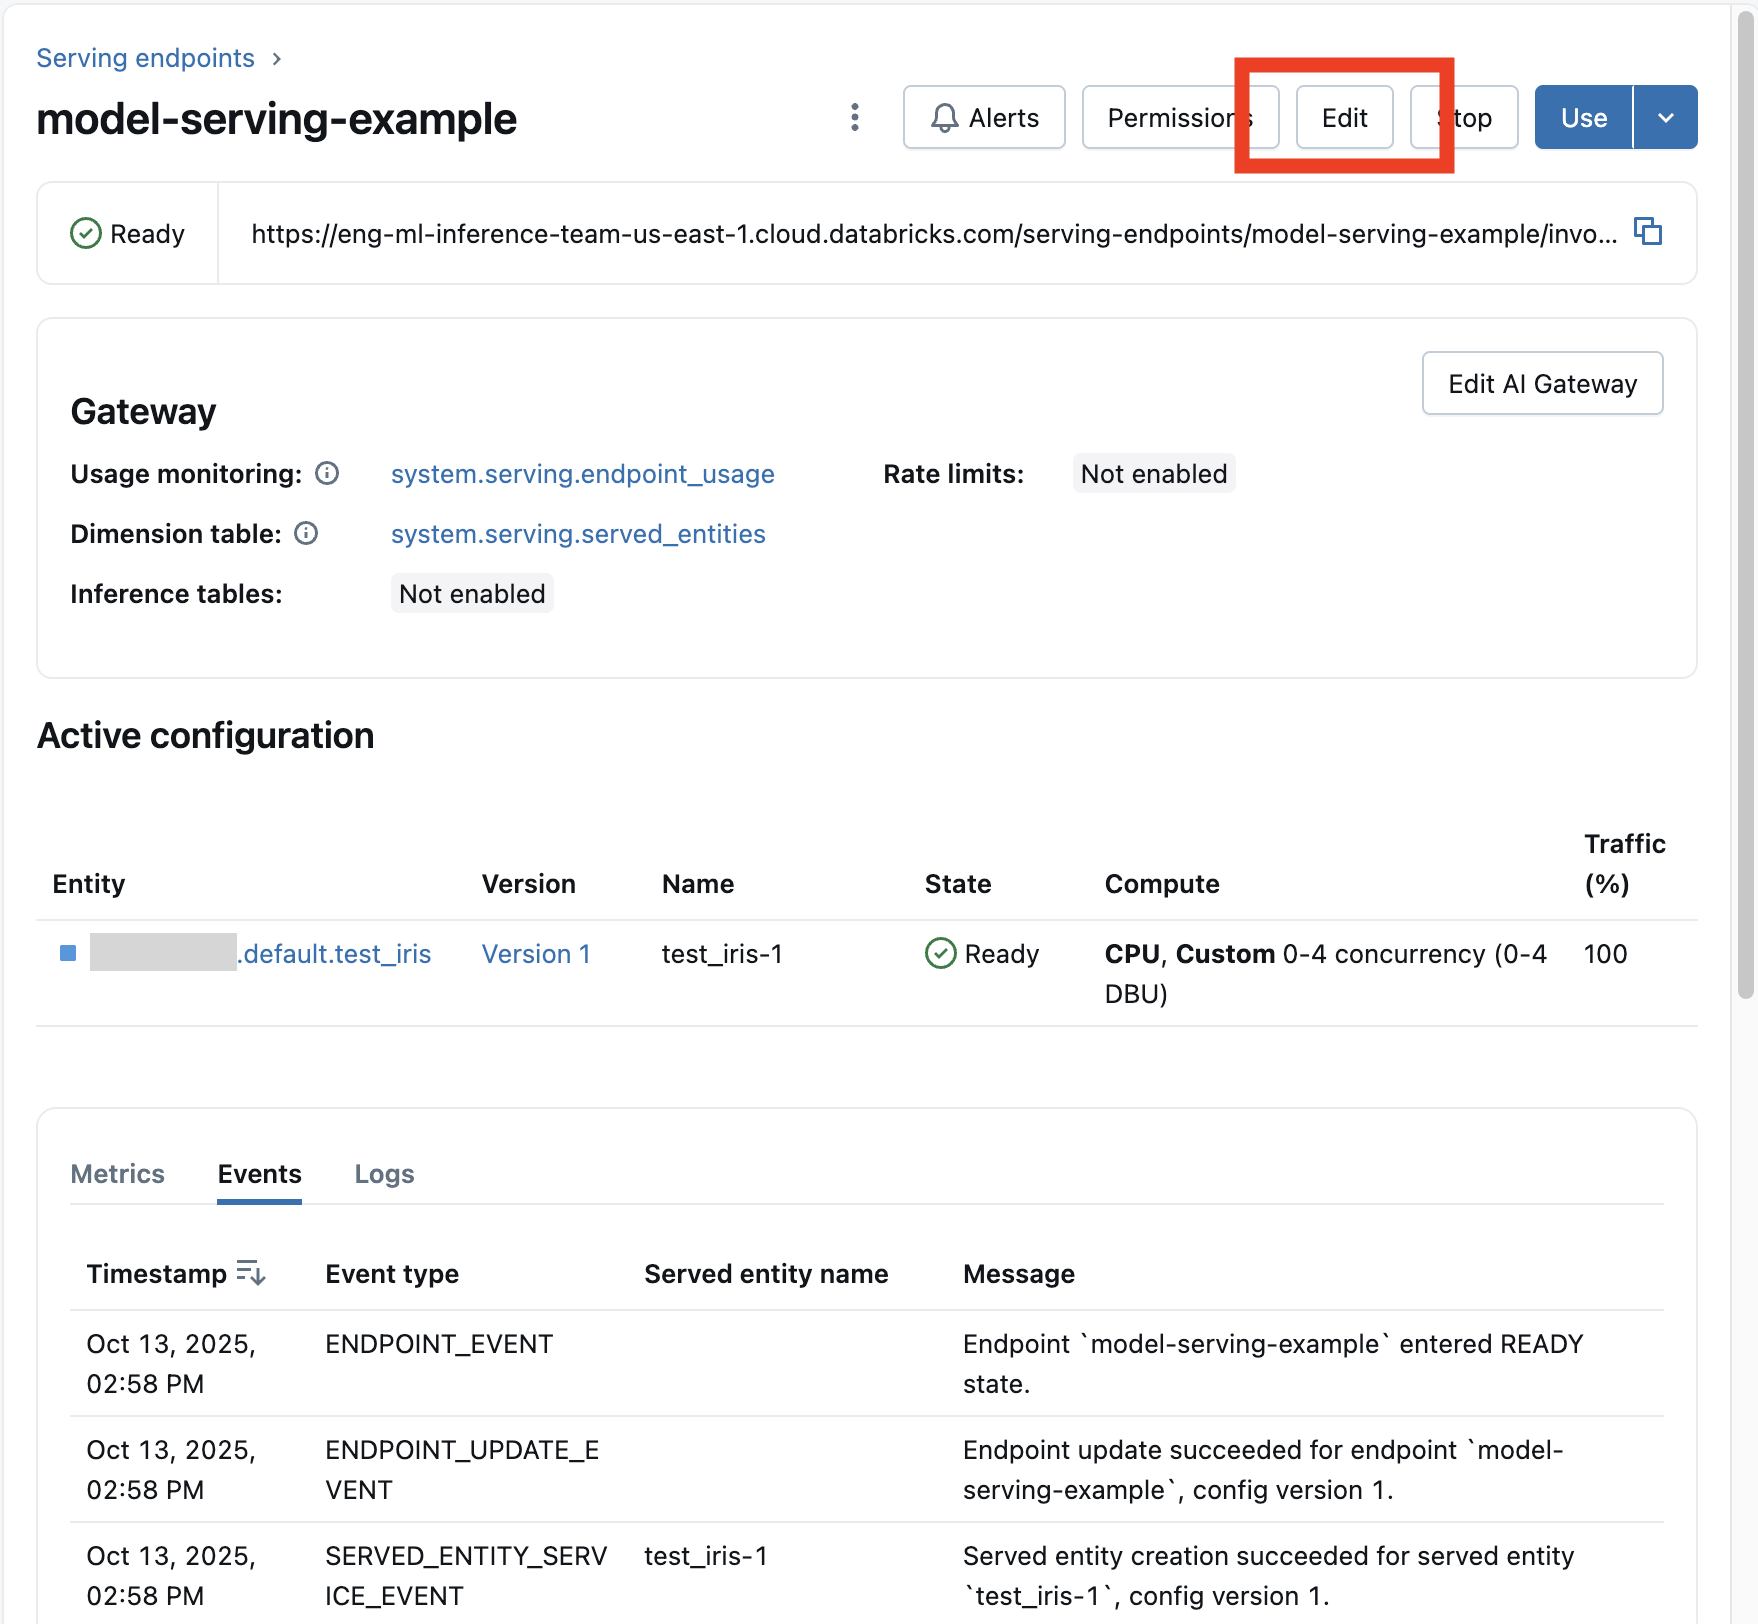
エンドポイント名と特定の変更できないプロパティを除き、エンドポイント構成のほとんどの側面を変更できます。
エンドポイントの詳細ページで [更新の取り消し] を選択すると、進行中の構成 の更新を取り消 すことができます。
REST API
REST API を使用したエンドポイント構成の更新例を次に示します。 PUT /api/2.0/serving-endpoints/{name}/config を参照してください。
PUT /api/2.0/serving-endpoints/{name}/config

{
  "name": "unity-catalog-model-endpoint",
  "config":
  {
    "served_entities": [
      {
        "entity_name": "catalog.schema.my-ads-model",
        "entity_version": "5",
        "workload_size": "Small",
        "scale_to_zero_enabled": true
      }
    ],
    "traffic_config":
    {
      "routes": [
        {
          "served_model_name": "my-ads-model-5",
          "traffic_percentage": 100
        }
      ]
    }
  }
}
MLflow デプロイ SDK
MLflow Deployments SDK は REST API と同じパラメーターを使用します。要求と応答のスキーマの詳細については、 PUT /api/2.0/serving-endpoints/{name}/config を参照してください。
次のコード サンプルでは、Unity カタログのモデル レジストリのモデルを使用します。
import mlflow
from mlflow.deployments import get_deploy_client

mlflow.set_registry_uri("databricks-uc")
client = get_deploy_client("databricks")

endpoint = client.update_endpoint_config(
  endpoint=f"{endpointname}",
  config={
    "served_entities": [
        {
            "entity_name": f"{catalog}.{schema}.{model_name}",
            "entity_version": "1",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ],
    "traffic_config": {
        "routes": [
            {
                "served_model_name": f"{model_name}-1",
                "traffic_percentage": 100
            }
        ]
    }
  }
)
モデル エンドポイントのスコアリング
モデルのスコアを付けるには、モデル サービング エンドポイントに要求を送信します。
- カスタム モデルのクエリ サービス エンドポイントを参照してください。
- 基礎モデルの使用を参照してください。
その他のリソース
- モデルの提供エンドポイントを管理します
- 外部モデル。
- Python を使用する場合は、 Databricks リアルタイムサービス Python SDK を使用できます。
ノートブックの例
以下のノートブックには、モデル サービング エンドポイントを起動して実行するために使用できるさまざまな Databricks の登録モデルが含まれています。 その他の例については、「 チュートリアル: カスタム モデルのデプロイとクエリ」を参照してください。
モデルの例は、「ノートブックのインポート」の指示に従ってワークスペース にインポートできます。 いずれかの例からモデルを選択して作成した後、 Unity カタログに登録し、モデルの提供に関する UI ワークフロー の手順に従います。