アダプティブ クエリ実行 (AQE) は、クエリの実行中に発生するクエリの再最適化です。
クエリを実行する前に、オプティマイザーはデータサイズの推定に基づいてクエリプランを選択します。 表の統計が欠落している、または古くなっている場合、データが歪んでいる場合、あるいは複雑なクエリの後続のステップでは、推定値が誤っている可能性があります。 誤った見積もりに基づく計画は、低速な結合戦略を使用したり、シャッフル後に小さなタスクを多数作成したり、ステージ全体を足止めする少数の大きすぎるタスクを作成したりする可能性があります。 AQEはクエリを実行しながら、実際のデータサイズに基づいて計画を再最適化することでこれらの問題を解決します。
各シャッフルまたはブロードキャスト交換の終了時に、Azure Databricks はこれまでに生成されたデータの正確な統計を保持します。 AQEはこれらの統計を用いて、より良い物理戦略を選択したり、ポストシャッフルパーティションの最適な数とサイズを選んだり、スキュージョイン処理など通常はクエリヒントを必要とする最適化を適用したりします。
AQE は既定で有効になっています。 検索内容を変えなくても、その恩恵を受けられます。 遅いクエリのトラブルシューティングを行う際に、AQEがクエリプランを変更したかどうかを確認してください。 AQE設定は、デフォルトがワークロードに合わない場合にのみ調整してください。 「クエリ プラン」と「構成」を参照してください。
資格
AQEには4つの主要な特徴があります。
- 並べ替えマージ結合をブロードキャスト ハッシュ結合に動的に変更します。
- シャッフル交換後にパーティションを動的に結合します (小さなパーティションを合理的なサイズのパーティションに結合します)。 非常に小さいタスクでは、I/O スループットが低下し、スケジュールのオーバーヘッドとタスクのセットアップのオーバーヘッドが多くなる傾向があります。 小さなタスクを組み合わせると、リソースが節約され、クラスターのスループットが向上します。
- 偏りのあるタスクをほぼ均等なサイズのタスクに分割 (および必要に応じて複製) することにより、並べ替えマージ結合およびシャッフル ハッシュ結合でスキューを動的に処理します。
- 行を返さないクエリの一部である空のリレーションを動的に検出し、伝播します。
対応クエリ
AQEは、これら両方の条件を満たすクエリに適用されます:
- クエリはストリーミングクエリではありません。
- クエリは、少なくとも1つのexchange(通常は結合、集約、またはウィンドウに由来するもの)、少なくとも1つのサブクエリ、またはその両方を含みます。
AQEはサポートされるすべてのクエリを再最適化しますが、その結果は、オプティマイザがクエリ実行前にコンパイルしたプランと同じになる場合があります。 AQEがクエリの計画を変更したかどうかを確認するには 、「クエリ計画」を参照してください。
クエリ プラン
AQE 適用クエリには、通常、各メイン クエリまたはサブクエリのルート ノードとして、1 つ以上の AdaptiveSparkPlan ノードが含まれます。 各 AdaptiveSparkPlan ノードには isFinalPlan フラグがあります。 フラグはクエリ実行の前および実行中は false であり、クエリが終了すると true に変わります。
クエリプランを見るには、Spark UI、 DataFrame.explain()、または SQL EXPLAINを使用します。 それぞれの図は、AQEがどのように計画を変えるかについて異なる情報を示しています。
Spark ユーザーインターフェイス (UI)
SparkのUIにあるクエリプラン図は、最新のプランを表示し、クエリの実行中に更新されます。 すでに実行済みで指標があるノードは変更されません。 まだ実行されていないノードは、AQEが計画を再最適化する際に変更される可能性があります。
この例はクエリプランの図を示しています:

DataFrame.explain()
DataFrame.explain() 各 AdaptiveSparkPlan ノードの下に、AQEが最適化を適用する前の最初のプランと現在のプランの2つのプランが表示されます。 クエリを実行すると現在の計画は変わり、クエリ終了時に最終計画となります。
出力には、各シャッフルおよびブロードキャスト ステージのデータ統計が含まれています。 統計はステージが実行されたかどうかによって異なります:
- ステージ実行の前および実行中、
isRuntimeはfalse、統計はコンパイル時の推定値です。 たとえば、「Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false)」のように入力します。 - ステージ実行後、
isRuntimeはtrue、統計はランタイムの測定値です。 たとえば、「Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true)」のように入力します。
これらのスクリーンショットは、実行前、実行中、実行後の DataFrame.explain() 出力を示しています:
実行前

実行中
実行中の

実行後

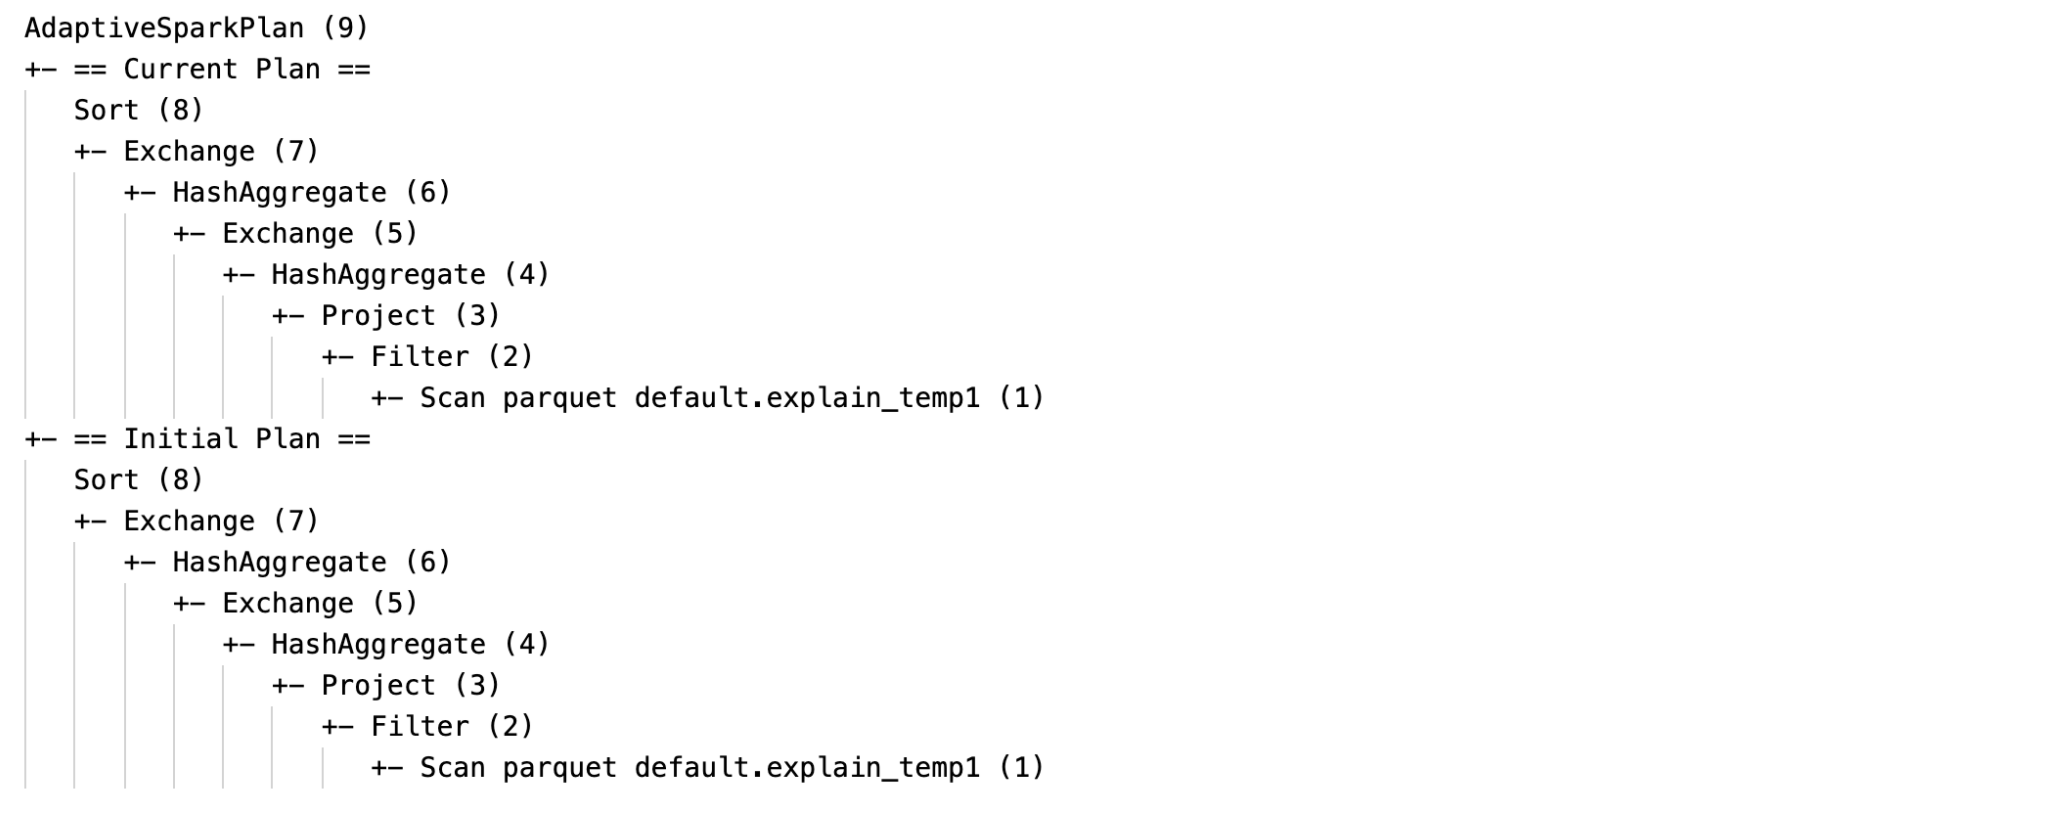
SQL EXPLAIN
SQL EXPLAIN はクエリを実行しないため、AQE はクエリを再最適化できません。 出力は初期プランのみを示しており、AQEが実行するプランとは異なる場合があります。
この例は SQL EXPLAIN 出力を示します:
クエリ プランにおける適用された最適化を特定する
AQEが最適化を適用すると、クエリプランが変わります。 どの最適化が効果を発揮したかを特定するために、現在の計画または最終計画と初期の計画を比較してください。 各最適化は計画を特定の方法で変化させます:
結合戦略の変更。 現在の計画または最終計画は、初期の計画とは異なる物理的な結合ノードを持っています。

パーティションの結合 プランには
CustomShuffleReaderプロパティを持つCoalescedノードが含まれています。

スキュージョインの取り扱い。 このプランには
trueフィールドがSortMergeJoinに設定されたisSkewノードが含まれています。

空のリレーションの伝播。 空の関係フィールドを持つ
LocalTableScanノードは、計画の一部または全部を置き換えます。

構成
これらのApache Sparkの設定プロパティはAQEを制御します。 ほとんどのワークロードはデフォルトを変更する必要はありません。
AQEを有効にし、個別の最適化を調整する
これらのプロパティを使用して AQE のオンとオフを切り替えたり、自動最適化シャッフル、ブロードキャスト結合の切り替え、空のリレーションの伝播を調整したりします。
| 財産 | タイプ | Default | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
アダプティブクエリ実行をオンまたはオフに切り替えます。 |
spark.sql.shuffle.partitions |
Integer |
200 |
結合または集計のデータをシャッフルするときに使用する既定のパーティション数。
autoに設定すると、自動最適化されたシャッフルが有効になり、この数値はクエリプランとクエリ入力データサイズに基づいて設定されます。構造化ストリーミングの場合、同じチェックポイントの場所からクエリの再起動間でこの値を変更することはできません。 |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
ソートマージジョインを実行時にブロードキャストハッシュジョインに切り替える際のサイズ閾値。 |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
動的空関係伝播のオンまたはオフを切り替えます。 |
パーティションを動的に結合する
| 財産 | タイプ | Default | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
パーティションの結合をオンまたはオフにします。 |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
結合後のターゲット サイズ。 結合されたパーティションは、このサイズに近いものの、このサイズを超えません。 |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
結合後のパーティションの最小サイズ。 結合されたパーティションはこのサイズより小さくはありません。 |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
クラスター コア数の2倍 | 結合後のパーティションの最小数。 このプロパティは設定しないでください。設定すると spark.sql.adaptive.coalescePartitions.minPartitionSizeを上書きしてしまうからです。 |
スキュー結合を動的に処理する
| 財産 | タイプ | Default | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
スキュー結合処理をオンまたはオフにします。 |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
分割が偏っているとみなされるために、分割が超えなければならない中央値分割サイズの乗数。 |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
スキュー状態とみなされるために、パーティションが超える必要のある最小サイズ。 |
AQEは、パーティションが偏っていると見なすのは、これら両方の条件((partition size > skewedPartitionFactor * median partition size) と (partition size > skewedPartitionThresholdInBytes))が成り立つ場合のみです。
よく寄せられる質問 (FAQ)
AQE が小さな結合テーブルをブロードキャストしなかったのはなぜですか?
テーブルが spark.databricks.adaptive.autoBroadcastJoinThreshold より小さいがAQEがブロードキャストしない場合は、以下の原因を確認してください:
- ジョインタイプはブロードキャストをサポートしていません。 一部のジョインタイプは片側をブロードキャストできません。 たとえば、AQE は
LEFT OUTER JOINの左側をブロードキャストできません。 - テーブルには多くの空のパーティションがあります。 ソート マージ結合のほとんどのタスクはすぐに完了するか、スキュー結合処理で結合が最適化されます。 AQEは、空でないパーティションの割合が
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin未満であれば、ソートマージジョインをブロードキャストハッシュジョインに変更しません。
AQEを有効にしたままブロードキャスト結合のヒントを使うべきでしょうか?
はい (クエリを十分把握している場合)。 クエリ実行前にオプティマイザーが計画するブロードキャストジョインは、AQEが実行時に計画するものよりも通常より良いパフォーマンスを発揮します。 AQEは、結合の両側をシャッフルした後、その時点で実際のテーブルサイズが分かるため、それまでブロードキャストジョインに切り替えないことがあります。
AQEは静的最適化と同様にクエリのヒントを尊重しつつ、ヒントが影響しない動的最適化も適用します。
スキュージョイントのヒントを使うべきか、それともAQEスキュージョインハンドリングを使うべきか?
AQEのスキュージョインハンドリングを使いましょう。 自動で、通常はスキュージョインヒントよりも良い性能を示します。
なぜAQEは私のジョインを並べ替えなかったのですか?
AQEは実行時にジョインの順序を変えません。 結合順序を改善するために、テーブル統計を収集し、コストベース最適化器がより良いプランを選択できるようにします。 コストベースオプティマイザを参照してください。
AQE がデータ スキューを検出しなかったのはなぜですか?
AQEは、以下の両方の条件が成り立つ場合にのみ、パーティションがスキューしていると見なします。
- パーティションは
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytesより大きい(デフォルトの256MB)。 - パーティションは中央値パーティションサイズの
spark.sql.adaptive.skewJoin.skewedPartitionFactor倍(デフォルト5)より大きいです。
AQE は、ソート マージ結合やシャッフル ハッシュ結合であるシャッフルベースの結合でのみスキューを処理します。 ブロードキャスト結合におけるスキュー最適化は決して行いません。 シャッフルベースの結合の場合、結合タイプによってAQEが最適化できる側が決まります:
| 結合の種類 | 左側用に最適化されたスキュー | 右側に最適化した傾き |
|---|---|---|
INNER |
イエス | イエス |
CROSS |
イエス | イエス |
LEFT OUTER |
イエス | いいえ |
RIGHT OUTER |
いいえ | イエス |
LEFT SEMI |
イエス | いいえ |
LEFT ANTI |
イエス | いいえ |
FULL OUTER |
いいえ | いいえ |
遺産
Spark 1.6 では、アダプティブ実行と呼ばれる機能が導入されましたが、Spark 3.0 の AQE は別の機能です。 Spark 1.6 のアダプティブ実行はパーティションを動的に結合するだけです。 AQEはランタイム統計に基づいてクエリを計画・再計画するフレームワークであり、このページのすべての最適化をサポートしています。