Important
プログラミングされたトレーニングには、明示的なアクセスの承認が必要です。 プレビュー サインアップ フォームを使用してアクセスを要求し、トレーニング セッションを作成する前に承認を待ちます。
このチートシートを使用して、トレーニング ループを Microsoft Foundry の Python SDK の関数とパラメーターにマップします。 この例では、同期 FineTuningSession 便利な API に焦点を当てています。 非同期クライアントとクックブック ラッパーでは、さまざまなインターフェイスと完了パターンが使用されます。
Prerequisites
- インストール、認証、アクセスのセットアップを完了します。
- クックブックによってインストールされるパブリック プレビュー バージョンである
azure-ai-finetuningsessions==1.0.0b1を使用します。 - トレーニングには Foundry ユーザー ロール、または微調整されたモデルもデプロイする場合は Foundry 所有者 ロールが必要です。 Microsoft Foundry のロールベースのアクセス制御を参照してください。
- 対象となるモデルとサポートされているアダプター構成を選択します。 一致するトークナイザーとチャット テンプレートを使用してトークンを準備します。
-
AZURE_AI_PROJECT_ENDPOINT設定し、承認済みのトレーニング予算を確認します。 セッションを作成し、トレーニング操作またはサンプリング操作を実行すると、料金が発生する可能性があります。
トレーニング、サンプリング、チェックポイントの便利なメソッドは、操作の結果を待機します。 生の操作と非同期ヘルパーには、戻り値の型と完了動作が異なります。これらのインターフェイスについては、完全な SDK リファレンス を使用してください。
この例では、特にラベルが付かない限り、同期 SDK を使用します。 ヘルパー関数を 1 回準備してから、 with open_session() as session:内で操作を実行します。 トークン化された実際のデータを使用する。スニペットはデータセットを提供したり、完全なトレーニング アルゴリズムを実装したりしません。
教師あり微調整
プロンプトと必要な応答に対する教師あり微調整 (SFT) トレーニング。
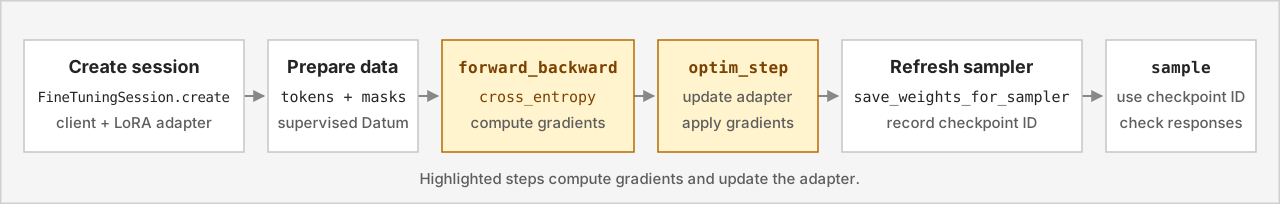
シーケンスは、チェックポイント>評価>、監視対象データ>前後>オプティマイザー ステップ>準備作成されます。 監視対象のバッチごとにサンプリングが必要なわけではありません。
強化学習
スコア付けされたモデル応答からの強化学習 (RL) トレーニング。

シーケンスは更新サンプラー>作成>、>オプティマイザステップ>コンピューティング報酬と利点>ロールアウトを収集します。 サンプラー更新から繰り返して、更新されたポリシーからの応答を収集します。
グループ化、評価、および利点の計算は、自動 SDK トレーニング アルゴリズムではなく、ドライバーに属します。 完全なトレーニング例については、微調整サンプル リポジトリを参照してください。
セッションを作成する
FineTuningSessionClient は、 endpoint と credentialを使用してプロジェクトに接続します。
FineTuningSession.create はモデルとアダプターを初期化し、セッション ハートビートを開始します。
このヘルパーは、 DefaultAzureCredentialで認証し、セッションを作成し、コンテキストが終了したときにアンロードします。 承認されたモデルと LoRA ランクを使用します。 明示的な資格情報スコープは、Microsoft Entra認証用です。
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
リファレンス: FineTuningSession.create、 FineTuningSessionClient、 DefaultAzureCredential。
モデルの読み込みが完了した後にセッション識別子が必要です。 以下の操作のためにセッションを開いたままにします。コンテキストを閉じるとハートビートが停止し、アンロード要求が送信されます。
| Parameter | Meaning |
|---|---|
base_model |
正確にサポートされているトレーニング モデル識別子。 |
lora_config |
サポートされているrankを使用した明示的なLoRAConfig。 |
type |
セッションの種類。 trainingを使用します。 サンプリングは、個別の推論セッションの種類ではなく、トレーニング セッションを通じて行われます。 |
timeout_sec |
モデルの読み込みを待機する最大時間。 タイムアウトしても、リモート クリーンアップは確認されません。 |
from_checkpoint |
ソース source_session_idとcheckpoint_idを使用した省略可能なFromCheckpoint。 互換性のある保存されたトレーニング状態を使用します。 |
user_metadata |
セッションに関連付ける実行メタデータの省略可能なディクショナリ。 |
training_type |
オプションのレベル セレクター。既知の値は、 GlobalStandard、 DatazoneStandard、および DeveloperTierです。 適格性は、モデルとプロジェクトによって変わります。 |
SDK を直接使用するときに session.session_id を記録します。 エンドツーエンドのトレーニングレシピを実行するには、「はじめに」 を参照してください。
監視対象データを準備する
Datum グループ model_input し、1 つの例に対して loss_fn_inputs します。
| 型またはフィールド | Meaning |
|---|---|
ModelInput |
順序付けされたモデル入力チャンク。 |
ModelInputChunk.tokens |
モデルのトークナイザーからのテキスト トークン ID。 |
LossFnInputs.target_tokens |
入力位置に合わせた次トークン ターゲット。 |
LossFnInputs.weights |
明示的なトークンごとの重み。0 はクロスエントロピ トレーニングからターゲットを除外します。 |
TensorData.data |
整数ターゲットまたは浮動小数点学習シグナル。 |
入力とターゲットを 1 つのトークンでシフトし、重みをターゲットに合わせます。 プロンプトや観察ではなく、目的のアシスタント トークンでトレーニングします。 Loss 関数とトークンの重みを参照してください。
同じモデル固有のチャット レンダラーからこのヘルパーにプロンプトトークンと完了トークンを渡します。 シングルターン SFT の例を作成し、プロンプト ターゲットをマスクします。
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
リファレンス: Datum、 LossFnInputs、 ModelInput。
これらのDatum値の一覧としてbatchを構築します。 入力配列、ターゲット配列、および重み配列の長さは同じです。 マルチターン データの場合は、最初のプロンプトの後のすべてのトークンをアシスタント トークンとして扱うのではなく、レンダラーのマスクを保持します。
RL データを準備する
RL の場合は、サンプリングされた応答と報酬派生学習シグナルを使用します。
| Field | Meaning |
|---|---|
SampledSequence.tokens |
生成されたトークン ID。 |
SampledSequence.logprobs |
指定された場合、応答を生成したポリシーからのトークン ログ確率。 |
LossFnInputs.logprobs |
トレーニング ターゲットに合わせたロールアウト ログの確率。 |
LossFnInputs.advantages |
トークンごとの利点。0 は、RL 信号からプロンプト位置と観測位置を除外します。 |
ターゲット間のアラインメント、ログ確率、および利点を保持します。 ロールアウトの確率を、新しく更新されたモデルの確率に置き換えないでください。 PythonのLossFnInputsコンストラクターには明示的なweightsも必要です。RL マスクには利点が使用されます。
1 ターンロールアウトの場合は、サンプリングされた sequence とドライバーによって計算された advantage を渡します。 このヘルパーは、プロンプトターゲットの位置にゼロの利点と対数確率を設定します。
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
リファレンス: SampledSequence と LossFnInputs。
ツール呼び出しまたは複数ターンロールアウトの場合は、レシピのレンダラーを使用して、サンプリングされたアクション トークンと環境の観察を区別します。
グラデーションの計算
session.forward_backward(batch, loss_fn=...) は目的を計算し、グラデーションを蓄積します。 アダプターの重みは更新されません。
batch には、 Datum 値が含まれています。
loss_fn は、 cross_entropy、 importance_sampling、 ppo、 cispo、または sapoを選択します。 省略可能な loss_fn_config は、SDK の LossFnConfig モデルを使用します。アルゴリズム ペーパーから受け入れられた構成キーを推測しないでください。
オプティマイザーの更新前にグラデーション計算を完了します。 複数の呼び出しを蓄積する場合は、 損失の削減に一貫性 を保ちます。
ライブ session と空でない SFT batchでは、グラデーションを計算し、例ごとの出力を調べます。
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
リファレンス: FineTuningSession.forward_backward と LossFn。
準備された RL バッチの場合は、 LossFn.IMPORTANCE_SAMPLING またはサポートされている別のポリシー損失を使用します。
LossFn enum メンバーとその文字列値は、同じ損失を選択します。
オプティマイザー ステップを適用する
session.optim_step(adam_params) は、累積グラデーションを適用します。 PythonのAdamParamsには、次の 5 つのフィールドがすべて必要です。
| Field | Meaning |
|---|---|
learning_rate |
オプティマイザーの更新サイズ。 |
beta1 |
第 1 瞬間減衰係数。 |
beta2 |
第 2 モーメント減衰係数。 |
eps |
数値安定性の用語。 |
weight_decay |
重み減衰の設定。 |
汎用の既定値を想定するのではなく、実験の値を選択します。
このヘルパーは、すべての必須フィールドを指定し、更新を待機します。 値は設定例であり、モデルに依存しない推奨事項ではありません。
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
リファレンス: FineTuningSession.optim_step と AdamParams。
ドライバーがスケジュールを使用するときに learning_rate を再計算します。実行中に 1 つのオプティマイザー構成が適用されるとは想定しないでください。
サンプル テキスト
session.save_weights_for_sampler(seq_id, ...) は重みを準備し、サンプラー チェックポイント識別子を返します。 更新されたアダプターから生成する前に、更新後にサンプラーの重みを更新します。
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) は、選択したサンプラーの重みから応答を生成します。
| パラメーターまたは結果 | Meaning |
|---|---|
prompt_tokens |
トークン化されたプロンプト、またはサポートされている ModelInput。 |
checkpoint_id |
チェックポイント パスまたはデプロイ名ではなく、このセッションの完了したサンプラー チェックポイント識別子。 |
num_samples |
プロンプトの応答の数。 |
SamplingParams.max_tokens |
完了トークンの予算。 |
temperature、top_p、top_k |
サンプリング配布の設定。 |
stop_criteria |
停止文字列の一覧またはトークン ID の一覧 。両方ではありません。 |
response_format |
省略可能な応答形式の要求。サポートは、モデルとサンプリング プロバイダーによって異なります。 |
result.sequences |
生成された SampledSequence 値。 |
PythonのSamplingParamsには、max_tokens、temperature、top_p、およびtop_kが必要です。 サンプラーの更新とサンプリングに同じ seq_id を設定します。 サンプラーの重みを節約する場合は、 path または sampling_session_seq_id を指定します。
オプティマイザーを 1 回更新した後、サンプラーを更新して応答を生成します。 モデルのトークン化された prompt_tokens と、ドライバーからの一致する tokenizer を使用します。
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
リファレンス: FineTuningSession.save_weights_for_sampler、 FineTuningSession.sample、 SamplingParams。
結果には、サンプリングされたシーケンスが 1 つ含まれます。 更新されたポリシーをサンプリングする前に、更新プログラムと更新サンプラーの重みを使用してステップ識別子をインクリメントします。
サンプラーの重みの準備は、再開可能なトレーニング状態の保存と同じではありません。
サンプラーの重みを保持または更新する
同期メソッドでは、 sampling_session_seq_id を使用して、メモリ内の更新と永続化されたサンプラー チェックポイントを区別します。
| Purpose | 同期呼び出し |
|---|---|
| 永続化なしでサンプラーの重みを更新する | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| サンプラー チェックポイントを保持する |
session.save_weights_for_sampler(seq_id=step, path="sampler-final")、 sampling_session_seq_idなし。 |
どちらの呼び出しも、サンプラー チェックポイント識別子を返します。 所有しているセッション ID のままにします。 永続的なサンプラーの保存では、無期限の保持が確立されたり、チェックポイントが別のセッションで使用可能になったりすることはありません。
前方専用パスを実行する
session.forward(batch, loss_fn=...) は、グラデーションを累積せずに損失関数の出力を返します。 これを使用して、準備されたバッチを検査したり、評価メトリックを計算したりします。
その結果、トレーニング専用の total_lossは設定されません。
loss_fn_outputs検査します。不足している集計をゼロ損失として扱わないようにします。
ライブ session と準備された batchを使用して、累積されたグラデーションを変更せずに、例ごとの出力を検査します。
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
リファレンス: FineTuningSession.forward。
トレーニングを保存して再開する
session.save_weights(path) は、アダプターの重みとオプティマイザーの状態を保存します。 ソース セッションとドライバーの状態でチェックポイント参照を記録します。
更新が完了したら、トレーニング状態を保存し、ソース セッション/チェックポイント参照を記録します。
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
リファレンス: FineTuningSession.save_weights。
このメソッドは、保存が完了した後にのみ返されます。 セッションを閉じる前に、データセットの位置やその他のドライバーの状態と共に checkpoint_path を格納します。
FineTuningSession.create_from_checkpoint は、新しいセッションでトレーニング状態を復元します。
| Parameter | Meaning |
|---|---|
checkpoint_path |
<source-session-id>/<checkpoint-name>形式で保存されたトレーニング チェックポイント参照。 |
base_model |
元のチェックポイントと互換性のある基本モデル。 |
lora_config |
明示的なランクを持つ互換性のあるアダプター構成。 |
サンプラー チェックポイントは、完全な状態のトレーニング チェックポイントではありません。 ドライバーでデータセットの位置とスケジュールを個別に復元します。 チェックポイントを参照してください。
このヘルパーは、認証済みの clientを使用して、保存されたトレーニング状態を復元します。 記録されたトレーニング checkpoint_pathを渡し、ベース モデルと LoRA ランクとソース セッションとの互換性を維持します。
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
リファレンス: FineTuningSession.create_from_checkpoint。
返されたセッションには新しいセッション ID があり、独自のハートビートが開始されます。 新しく作成したセッションを閉じるのと同じように、再開されたセッションをループが終了したら閉じます。
非同期操作を使用する
SDK の非同期クライアントラッパーとクックブック ラッパーは互換性がありません。
azure.ai.finetuningsessions.aioから非同期クライアントをインポートします。モデルの種類は引き続きazure.ai.finetuningsessions.modelsから取得されます。
| Interface | 完了パターン |
|---|---|
同期的 FineTuningSession |
このメソッドは、完了した操作の結果を返します。 |
生の非同期 SDK の便利なメソッド (例: save_weights_for_sampler_async |
送信を待ってから、返された asyncio.Task が完了するのを待ちます。 |
Cookbook training-wrapper メソッド (例: save_state_async |
提出を待ってから、将来の result_async()を待つ。 |
非同期 clientが所有するライブ セッションの場合、このヘルパーはサンプラーの重みを保持し、完了したチェックポイント識別子を返します。
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
リファレンス: 非同期FineTuningSessionClient.save_weights_for_sampler_async。
エフェメラル サンプラーの更新には、代わりに save_weights_and_get_sampling_client_async を使用してください。 生の SDK クライアントでは、そのメソッドは、クックブック サンプリング クライアントではなく、操作結果を持つタスクを返します。
セッションをアンロードする前に、必要な保存を待機します。 クックブックの互換性 ttl_seconds 引数は、これらの SDK セーブに転送されません。強制保持設定としては扱いません。
カスタム目標の場合、cookbook forward_backward_custom_async は、クライアント側の異なる損失計算を使用してサービス転送出力を作成します。 これはFineTuningSessionのメソッドではなく、SDK の loss_fn パラメーターは任意のPython呼び出し可能なパラメーターを受け入れていません。
リソースを閉じる
session.close() はハートビートを停止し、アンロード要求を送信します。 失敗時を含め、ループが終了したときにそれを呼び出します。次に、HTTP クライアントと資格情報を閉じます。
終了しても、リモート クリーンアップの完了やチェックポイントの削除は確認されません。
session.delete() は、保存されたリソースにカスケードできます。
セッションの検査とアンロードを参照してください。
open_session コンテキスト マネージャーを使用して、単一の SFT 更新を実行し、トレーニング状態を保存します。 前の例の open_session と apply_optimizer_step を定義し、空でないレンダリングされた SFT batchを渡します。
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
リファレンス: FineTuningSession.close と FineTuningSession.save_weights。
ヘルパーは、トレーニング チェックポイント参照を返します。 そのコンテキストは、トレーニング操作で例外が発生した場合でもアンロード要求を送信し、クライアントと資格情報を閉じます。
SDK リファレンス
実行可能な例、メソッド シグネチャ、非同期 API、結果の種類、エラーの完全なリファレンスを使用します。