この記事では、エクスポート中のパフォーマンスを向上させるのに役立つヒントを提供します。
JOIN を持つ計算列を回避する
計算列では JOIN を使用しないでください。 代わりに、計算をデータ ソースとして計算するために必要なすべてのテーブルを追加します。
計算列は、データ エンティティ ビューを実行するプロセスの一環として SQL Server によって返される計算値です。 既定値の返し、プログラムのロジック、書式設定値など、多くの可能な用途があります。 SQL Server で値をすばやく計算でき、大量のストレージ領域を必要としないように、計算列の数式を記述する必要があります。
計算された列式を書くときは、テーブルやビューへの結合を避けてください。 そのような結合により、SQL Server は値行を行によって計算し、それらをすべて一時的な記憶域に保持します。 代わりに、式に必要なテーブルをエンティティ ビューのデータ ソースとして追加します。 その後、SQL Server では、各行のプロセスを繰り返す代わりに、すべてのテーブル データを 1 つの操作のすべての行に結合できます。
計算が遅くなっているかどうかをテストするには、次の手順に従います。
ファイル名を指定してデータベースに接続し、
sp_helptextコマンドを実行してビュー定義を取得します。別の SQL Server Management Studio ウィンドウに出力をコピーし、次の変更を行います。
- 改行を削除します。
- ビュー 定義コマンドの開始から
CREATE VIEW [SOME NAME] ASを削除して、selectコマンドだけが存在します。
コマンドを実行し、すべてのデータを返すのにかかる時間を記録します。
計算列の数式をコメント アウトし、コマンドをもう一度実行し、すべてのデータを返すのにかかる時間を記録します。 必要な時間が 1 秒から 2 秒以上高速で計算しない場合、計算が遅くなります。
可能な場合 postLoad の実装を避ける
エクスポートにステージングが強制的に行うので、postLoad の実装は行いません。
エンティティ作成者は、データ エンティティに多数の方法を実装することにより、エンティティが使用された場合の処理をカスタマイズできます。 使用を避ける必要がある方法の 1 つが postLoad です。 この方法では、エクスポート データをステージング テーブルにコピーして、各行に対して 1 回だけエクスポート データを呼び出す必要があります。 その後、ステージング テーブルからコピー先のデータベースまたはファイルにデータをコピーする必要があります。 すべてのデータを 2 回コピーした方が効率的ではありません。 さらに、完全なエクスポートの場合、ステージング テーブルのサイズは時間のとなるとすぐに増加します。 その結果、ステージング テーブルの insert、update、select の操作の速度が低下します。
エクスポートの前に変更する値がある場合は、計算列の式を使用して変更された値を返します。 エンティティにインポートする直前に値を設定する必要がある場合は、postStaging の使用を検討してください。 さらに、エンティティの insert と update のメソッドをカスタマイズして特定の列の値を変更することもできます。 これらの代替方法を使用すると、エクスポート用のステージングをスキップできます。
ユーザー インターフェイス (UI ) でエクスポート プロジェクトを作成する場合、エンティティに postLoad メソッドまたは仮想フィールド (X++ メソッドによって計算された値) がある場合、またはテーブルをエクスポートする必要がない限り、ステージングを使用してエクスポートを設定することはできません。 ステージングによってエクスポートするには、データをステージング テーブルに 1 回、出力先に 1 回だけエクスポートする必要があります。 したがって、この方法は、ステージング プロセスでのみ実行できるものをエクスポートする必要がある場合にのみ使用します。
エンティティの列が無効な構成キーにリンクされている場合、無効な列を選択した場合、ステージングを使用しない限りエクスポートは失敗します。 エンティティがステージングによってエクスポートした場合にのみ機能する場合は、構成キーを持つフィールドをチェックします。 さらに、構成キーの設定は、テーブル エンティティ ビュー フィールドまたはデータ エンティティ ビュー フィールドの代わりに、オブジェクトまたは拡張データ型 (EDT) に対して存在する場合が多くの場合、列挙型および EDT の構成キーをチェックします。 フィールド、列挙型、および EDT に構成キーが設定されている場合は、ステージングを通じてエクスポートされません。 代わりに、無効なすべての列のマッピングを削除して、ステージングをスキップすることができます。 この方法の処理は、ステージングよりも迅速に行うことができます。
データ ソースの番号の制限
エンティティまたはビューのデータ ソースの数を制限します。 結合の数が少ない場合は、結果の返品が迅速に行える数になります。 多くのデータ エンティティはインポートを念頭に置いて作成され、設定する必要がある場合には、すべての関連テーブルのすべての可能なフィールドを公開しました。 この動作は、少量のレコードをインポートする場合でも許容できます。 ただし、エクスポートの場合は、使用する項目のみを選択する必要があります。 エンティティのデータ ソースの一覧、そしてより重要な点を参照する他のエンティティを確認します。 これらのデータ ソースを、エクスポート データを使用するプロセスの要件と比較します。 これらのプロセスでデータ ソースの値が使用できない場合は、そのデータ ソースを削除します。
エクスポート エンティティの結合の総数を小さくしてください。
- 0–3 – この結合の数が正常に機能しています。
- 4–7 – パフォーマンスは少し遅くなります。
- 8–13 – パフォーマンスが遅い。
- 14 以上 – この多くの統合は使用しないでください。
実行 しない ことの例として、BIExchangeRateView ビューを考慮してください。 簡単に言って、そのビューとテーブルが 1 つだけの単純な外観になります。 ただし、ExchangeRateEffectiveView ビューを密接に見て、16 以上の他のビューについての組合が表示され、それらのビューには他のビューに対する和集合があります。
結合するカスタム テーブルに存在するインデックスを分析します。 フィルタ処理または結合する列を含むテーブルのインデックスがありますか。 SQL Server は、データ エンティティを使用するクエリのクエリ計画を作成する必要があります。 このクエリ計画では、SQL Server はデータ エンティティ定義からのフィルタおよび参加を行います。 結合を確認し、結合またはテーブルがカスタムである場合は、結合をテーブル インデックスと比較します。 フィルタ処理または結合する列を含むインデックスがテーブルにまだ存在しない場合は、SQL Server がデータをすばやく返すかどうかをテストするためにインデックスを追加します。 インデックスによってビューの実行時間が改善しない場合は、削除します。 役立つインデックスが見つけた場合は、テーブルのテーブル メタデータにインデックスを追加します。
データ エンティティまたはビューをデータ ソースとして使用するのを避ける
その他のデータ エンティティまたはビューをデータ ソースとして使用するのを避ける エンティティをより高速にするには、結合の数、実行する計算の数、返される列の数を制限します。
必要な値が別のデータ エンティティに存在する場合でも、不要な結合や使用しない計算式が含まれる場合があります。 他のエンティティを使用する代わりに、エンティティに必要なテーブルと同じテーブルを追加し、他のエンティティがエンティティと結合する方法でそれらを結合します。 エクスポートに必要ないテーブルのデータ ソースは削除してください。
データ エンティティからの SELECT 操作の列数の最小化
データ エンティティからの select 操作に含める列が少ないほど、転送先へのデータ転送が高速になります。
エクスポート プロジェクトの既定のマッピングには、すべての列が含まれます。 標準エンティティをエクスポートする場合は、そのエンティティに含っている列をチェックします。 使用していない列が見つかる場合があります。 この場合、不必要なデータを転送しないので、それらの列をマッピングから削除します。 自分のエンティティをエクスポートする場合は、エンティティ自体から不要な列を削除します。 エンティティが選択する列の合計数を 200 以下にしてください。
defaultCTQuery を実装して、変更を追跡するテーブルを指定し、処理する必要がある変更データの量を制限します
このガイダンスは、データ管理のインクリメンタルエクスポートにおける SQL変更追跡 にも適用されます。 テーブルの除外については、「 変更トラッキングのためのテーブルの適格性」をご覧ください。 別行バージョンのメカニズムについては、カスタム変更追跡クエリを除外する データエンティティ検証ルールを参照してください。
データ エンティティのテーブル上の変更データの差分エクスポート クエリと、変更されたレコードに関連する行のみをエクスポートします。 ただし、多くのエンティティには、エンティティ データを使用するプロセスにとって重要ではないテーブルへの多数の結合または結合があります。 データ エンティティに defaultCTQuery メソッドを実装することで、処理する変更レコードを制限できます。 変更データが必要なテーブルに参加するクエリを返します。 プロセスで値が違う値を示すテーブルは削除してください。 この方法では、重要ないエンティティ テーブルの変更データをスキップすることで、差分エクスポートの速度を速くすることができます。
Important
DimensionAttributeValueCombination、DimensionAttributeValueSet、または InventDim ターブルの変更を追跡したりしないでください。 これらの 3 つの大規模な会社間テーブルではレコードの更新は許可されておらず、これらにはすべて毎日大量の挿入を持っています。 これらのテーブルの変更を追跡する必要はないので、追跡するとエクスポートが遅くなる可能性があります。
レコードの財務分析コードデータまたは在庫分析コード データを変更するプロセスは、分析コード値のその組み合わせに対して新規レコードが存在しない場合に、新しいレコードを作成します。 関連レコードも更新され、分析コード レコードを指しています。 分析コード値への参照を格納するテーブルは、値が変更された場合は常に更新されます。 新しい分析コード レコードに関連するエンティティ内の任意の行は、分析コード値への参照を格納するテーブル内の変更されたレコードにも関連付け合うので、関連するテーブルを追跡することができます。
ステージング データ クリーンアップ ジョブのスケジュール
時間が経つにつれ、ステージングを通じてエンティティをエクスポートしたり、エンティティをインポートしたりするために使用される、ステージング テーブルのデータ量が高くなる可能性があります。 その結果、インポートおよびエクスポートの速度が遅くなります。
ステージング テーブルの行数が 2,000 万を超える場合は、テーブルのデータを減らす必要があります。 データ管理 ワークスペース から、古いインポートまたはエクスポートに関連するステージング データを検索および削除するバッチ データ クリーンアップ ジョブをスケジュールできます。 このジョブをスケジュールする際には、実行できる時間数を増やして、毎日実行します。 通常は 1 日に 2 時間の既定値を使用すると問題が生じします。 6 時間または 8 時間の作業時間が向上します。 このジョブは、削除するデータが使い切らされた場合に停止します。
ユーザー定義のエンティティやカスタマイズされたエンティティは、実際のデータでテストするまで追加しない
場合によっては、データ量が原因でパフォーマンスの問題が開発環境に表示されない場合があります。 ただし、これらのデータは、実際のデータを実際のファイル環境でテストする際に表示されます。 サンドボックス内の新しいエンティティのエクスポートを常にテストします。 エクスポート プロセスが遅い場合は、エンティティを生産に配置する前に改善してください。
エクスポート中の出力先テーブルのブロックの回避
コピー先テーブルから読み取ったプロセスを、それらのテーブルにエクスポートするのと同じ時間スケジュールを設定しないでください。 データベースにエクスポートする場合は、出力先テーブルのデータを変更する必要があります。 完全なエクスポートを実行する前に、エクスポートしている会社のデータを削除するコマンドと、差分エクスポート用にエクスポートされた古いバージョンのレコードを削除するコマンドが実行されます。 エンティティ データを同時に使用する別のプロセスでは、これらのコマンドの速度が低下する可能性があります。 したがって、出力先データベースの同じエンティティ テーブルに対してレポートが実行されていない場合は、エクスポートをスケジュールしてください。
他のプロセスがエクスポートと同じテーブルを使用しているかどうかは必ずしも違います。 データベースへのエクスポートが遅い場合は、出力先データベースをブロックしているクエリを実行します。 Azure portal で、データベースが、データベースのトランザクション ユニット (DTU) の制限であるかどうかを確認します。
データベース エクスポートのインデックス タイプの設定の確認
データベース エクスポート接続を設定するときは、作成するインデックスの種類を検討してください。 デフォルトでは、クラスタ化された列の店舗インデックスが作成されます。 このタイプのインデックスは select クエリを速くし、コピー先テーブルのレポートに役立ちます。 ただし、これは insert と delete の操作を遅くします。
エクスポート クエリにフィルターを追加してエクスポート データのパフォーマンスを向上する
エクスポートされるレコード数を減らしてパフォーマンスを向上するために、データ エクスポート クエリにフィルターを追加します。
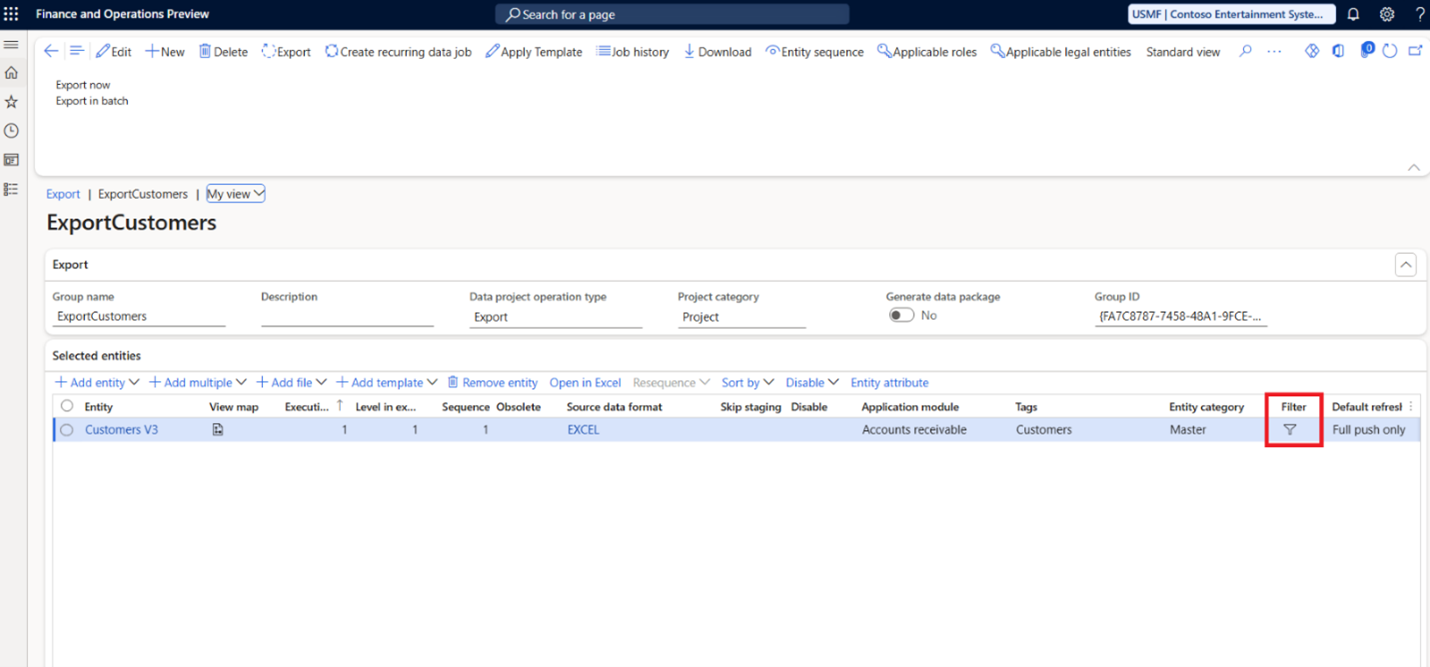
エクスポート クエリにフィルターを追加するには、次の手順に従います。
データ管理ワークスペースに移動します。
データ エクスポート プロジェクトの一覧からプロジェクトを選択し、フィルターを適用して、エクスポートするレコード数を減らします。