適用対象: SQL ServerAzure SQL DatabaseAzure SQL Managed InstanceMicrosoft Fabric の SQL データベース
SQL Server データベース エンジンは、ローカル テーブル、パーティション テーブル、複数のサーバーに分散されたテーブルなど、さまざまなデータ ストレージ アーキテクチャでクエリを処理します。 以下のセクションでは、データベース エンジンがどのようにクエリを処理し、実行計画キャッシュを通じてクエリ再利用を最適化するかを説明します。
この記事のコードサンプルは、AdventureWorks2025、AdventureWorksDW2025、またはAdventureWorksLT2025サンプルデータベースを使用しており、Azure Data SQL Samples Repository GitHubリポジトリからダウンロードできます。
実行モード
SQL Server データベース エンジンは2つの異なる処理モードを用いて Transact-SQL(T-SQL)文を処理できます。
- 行モード実行
- バッチ モード実行
行モード実行
行モード実行 は、行ストアテーブルやインデックスで使われるクエリ処理手法で、データは行形式で格納されます。 クエリが実行され、行ストアテーブルやインデックスのデータにアクセスすると、実行木演算子と子演算子はオブジェクトスキーマで指定されたすべての列にわたって必要な各行を読み込みます。 読み取った各行から、データベース エンジンは結果集合に必要な列を、SELECT文、JOIN述語、またはフィルター述語で参照して取得します。
注
行モードの実行はOLTPシナリオでは非常に効率的ですが、大量のデータをスキャンする場合、例えばデータウェアハウジングのシナリオでは効率が劣ることがあります。
バッチ モード実行
バッチモード実行 は、複数の行を同時に処理するクエリ処理手法です(これが「 バッチ」という用語の由来です)。 バッチ内の各列は、別個のメモリ領域のベクトルとして格納されています。そのため、バッチ モード処理はベクトル基準となります。 バッチモード処理は、最新のプロセッサにおける拡張命令セットや増加したメモリスループットに最適化されたアルゴリズムも使用します。
バッチモードの実行はもともとコラムストアのストレージ形式を前提として統合・最適化されていました。 SQL Server 2019(15.x)以降、Azure SQL Databaseではバッチモードの実行にカラムストアインデックスは不要になりました。 詳細については、「行ストアでのバッチ モード」を参照してください。
バッチモード処理は可能な限り圧縮データで動作し、行モード実行で使用される 交換演算子 を排除します。 結果的に、並行処理の向上と高速なパフォーマンスが得られます。
クエリがバッチモードで実行され、カラムストアインデックスのデータにアクセスすると、実行木演算子と子演算子は複数の行を列セグメントで同時に読み込みます。 データベース エンジンは、SELECTステートメント、JOIN述語、またはフィルター述語で参照される、結果に必要な列のみを読み込みます。 コラムストアのインデックスについての詳細は、 Columnstore Index Architectureをご覧ください。
注
バッチモードの実行は、大量のデータを読み込み集約できるデータウェアハウジングのシナリオで非常に効率的です。
SQL ステートメントの処理
単一のT-SQL文を処理することは、データベース エンジンがT-SQL文を実行する最も基本的な方法です。 以下の手順は、ローカルベーステーブルのみを参照する単一の SELECT 文を処理する基本的なプロセスを示しています(ビューやリモートテーブルは参照しません)。
論理演算子の優先順位
文に複数の論理演算子を使う場合、 NOT が最初に評価され、次に AND、最後に ORが評価されます。 論理演算子の前に算術演算子やビット演算子が扱われます。 詳細については、演算子の優先順位を参照してください。
以下の例では、色条件は製品モデル21には適用されますが、製品モデル20には適用されません。なぜなら、 AND が ORより優先されるからです。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
必要でなくても括弧を使うことで、クエリの可読性が向上し、オペレーターの優先順位によるミスの可能性を減らすことができます。 以下の例は前の例よりも読みやすく、同じ意味を持っています。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
OR が必ず最初に評価されるように、かっこを付け加えることでクエリの意味を変えることができます。 次のクエリでは、モデル 20 とモデル 21 で赤色の製品のみが検索されます。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
SELECT ステートメントを最適化する
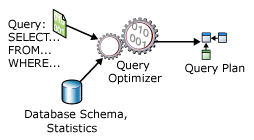
SELECT ステートメントは非手続き型であり、要求したデータを取得するときにデータベース サーバーで使用する手順が細かく指定されません。 この宣言的な動作は、データベースサーバーが文とデータベースを分析し、要求されたデータを最も効率的に抽出する方法を決定することを意味します。 このプロセスは クエリプラン最適化と呼ばれます。 このタスクを実行するコンポーネントはクエリオプティマイザーです。 クエリオプティマイザへの入力は、クエリ、データベーススキーマ(オブジェクト定義)、およびオブジェクト統計で構成されています。 クエリオプティマイザーの出力は クエリ実行計画であり、クエリ プラン や 実行計画とも呼ばれます。 実行計画の内容については、実行計画のキャッシュと再利用でより詳しく説明されています。
以下の図は、単一の SELECT 文の最適化中のクエリオプティマイザの入力と出力を示しています。
SELECT文は次のもののみを定義します:
- 結果セットの形式。 ほとんどの場合、選択リスト内で指定します。 ただし、
ORDER BYやGROUP BYなどの句も結果セットの最終形式に影響します。 - ソースデータが含まれているテーブル。 これは
FROM句で指定します。 -
SELECTステートメントを実行するためにテーブルを論理的に関連付ける方法。 これは結合式で定義されており、その結合式はWHERE節またはONに続くFROM節に現れることがあります。 - 基になるテーブルの行が
SELECTステートメントの対象になるために満たす必要がある条件。WHERE句とHAVING句で指定します。
クエリ実行計画は次のように定義されます:
基になるテーブルにアクセスする順序。
通常、データベースサーバーはさまざまな順序でベーステーブルにアクセスして結果セットを作成できます。 たとえば、
SELECTステートメントが 3 つのテーブルを参照している場合、データベース サーバーは最初にTableAにアクセスし、TableAのデータを使用してTableBから一致する行を抽出します。次に、TableBのデータを使用してTableCのデータを抽出することができます。 データベースがテーブルにアクセスする際に可能な順序には、次の組み合わせがあります。TableC、TableB、TableA、または
TableB、TableA、TableC、または
TableB、TableC、TableA、または
TableC、TableA、TableB各テーブルからデータを取り出すための方法。
通常、各テーブルのデータにアクセスする方法にも何とおりかあります。 特定のキー値を持つ数行だけが必要な場合、データベースサーバーは素早く行を検索したり、小さなインデックス範囲をスキャンしたりできます。 テーブル内のすべての行が必要な場合は、データベースサーバーがテーブル全体やインデックス全体をスキャンできます。 テーブル内のすべての行が必要で、キー列が
ORDER BYに含まれるインデックスがある場合、テーブルスキャンの代わりにインデックススキャンを行うことで、結果セットを別途ソートする手間を省ける可能性があります。 テーブルが非常に小さい場合、ほぼすべてのアクセスにおいてフルスキャンが最も効率的な方法かもしれません。計算に使用される方法と、各テーブルのデータのフィルター処理、集計、並べ替えを行う方法。
テーブルからデータにアクセスすると、異なる手法がスカラー値の計算やクエリテキストで定義されたデータの集約・ソートなど、データに対して計算を行います。 例えば、
GROUP BY節やORDER BY節を使用する場合や、WHERE節やHAVING節を使用してデータをフィルタリングする方法です。
可能性のある多数のプラン候補の中から実行プランを 1 つ選択する処理を最適化と呼びます。 クエリ オプティマイザーは、データベース エンジンの最も重要なコンポーネントの 1 つです。 クエリオプティマイザはクエリの分析と計画選択に多少のオーバーヘッドを使用しますが、効率的な実行計画を選択すると、このオーバーヘッドをはるかに上回る効果が通常得られます。 たとえば、2 つの建築会社が一軒の住宅に同じ青写真を提供する場合について考えてみます。 もし一方の会社が最初に数日かけて家をどう建てるかを計画し、もう一方の会社が計画なしに作業を始めると、プロジェクトの計画に時間をかけた会社のほうが、おそらく先に完成します。
クエリオプティマイザーはコストベースのオプティマイザーです。 実行プラン候補ごとに、計算に使用するリソースの量の観点から関連するコストが異なります。 クエリ オプティマイザーでは、候補のプランを分析し、算出コストが最も低いプランを選択する必要があります。 複雑なステートメントの中には、数千通りの実行計画が存在するものもあります。 このような場合、クエリ オプティマイザーはすべての組み合わせを分析するわけではありません。 複雑なアルゴリズムを使用して、理論上の最低コストに最も近い実行プランを迅速に見つけ出します。
クエリオプティマイザーは必ずしも最も見積もられるコストの低い実行計画を選ぶわけではありません。 最適化に利用可能な時間内で妥当な推定コストの計画を見つけます。 並列実行計画は、推定経過時間を短縮しつつ、シリアル計画よりも多くのリソースを使う可能性があります。
SQL Serverクエリオプティマイザーは、テーブルやインデックスから情報を抽出するための異なる手法のリソースコストを推定する際に統計に依存しています。 列とインデックスの統計は保持され、基礎データの密度1 に関する情報を保持します。 この情報は、特定のインデックスや列の値の選択性を示します。 たとえば、車を表すテーブルの場合、同メーカーの車がいくつもあります。ただし、VIN (車両番号) はそれぞれの車両固有のものです。 VIN 上のインデックスは、製造元でのインデックスより選択度が高くなります。これは VIN の密度が製造元の場合より低いからです。 インデックス統計が最新でない場合、クエリ オプティマイザーはテーブルの現在の状態に最適な選択ができないことがあります。 密度の詳細については、「統計」を参照してください。
1密度では、データ内に存在する一意の値の分布、または特定の列における重複値の平均数が定義されます。 密度が減少するにつれて、値の選択度が高くなります。
クエリオプティマイザーは、開発者やデータベース管理者の入力を必要とせずに、データベースサーバーがデータベースの変化する状況に動的に調整できる点で重要です。 この機能により、開発者はクエリの最終結果の記述に集中できます。 彼らは、文のクエリ計画が最適化されるたびに、Query Optimizerがデータベースの状態に対して効率的な実行計画を構築することを信頼できます。
注
SQL Server Management Studio には、実行プランを表示するための 3 つのオプションがあります。
- Estimated Execution Plan。これは、クエリ オプティマイザーによって生成されるコンパイル済みのプランです。
- 実際の実行計画(Actual Execution Plan)は、コンパイルされた計画に実行コンテキストを加えたものです。 この文脈には、実行完了後に利用可能な実行時の情報(例えば実行警告や、データベース エンジンの新しいバージョンでは実行時の経過時間や使用されたCPU時間)が含まれます。
- ライブ クエリ統計は、コンパイル済みプランにその実行コンテキストを加えたものです。 このコンテキストには実行進行中のランタイム情報が含まれ、毎秒更新されます。 実行時情報には、例えば演算子を通過する実際の行数が含まれます。
SELECT ステートメントを処理する
データベース エンジンは以下のステップに従って単一のSELECT文を処理します。
- パーサーが
SELECTステートメントをスキャンし、キーワード、式、演算子、識別子などの論理単位に分解します。 - クエリツリーは、時にシーケンスツリーとも呼ばれ、ソースデータを結果セットに必要なフォーマットに変換するために必要な論理的ステップを記述します。
- クエリオプティマイザーは、ソーステーブルにアクセスするさまざまな方法を分析します。 より少ないリソースで結果を最も速く返す一連のステップを選択します。 この一連の手順を正確に記録するためにクエリツリーを更新します。 この最終的に得られた最適化済みのクエリ ツリーを実行プランと呼びます。
- 関係型エンジンが計画を実行し始めます。 ベーステーブルのデータを必要とするステップを処理する際、ストレージエンジンから必要な行セットを要求します。
- リレーショナル エンジンでは、ストレージ エンジンから返されたデータが結果セット用に定義された形式に変換され、結果セットをクライアントに返します。
定数たたみ込みと式評価
データベース エンジン では、クエリのパフォーマンスを向上させるため、いくつかの定数式が前もって評価されます。 クエリオプティマイザで用いられるこの最適化手法は、実行時ではなくコンパイル時に式を簡素化することを目指しています。 クエリのコンパイル中に定数式を評価して、結果の実行プランの効率を高める必要があります。 この過程は 定数折りたたみと呼ばれます。 定数とは、 3、 'ABC'、 '2025-12-31'、 1.0e3、 0x12345678などのT-SQLリテラルを指します。 たとえば、次のクエリを実行します。
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
ここで、30 * 12 は定数式です。 データベース エンジンはコンパイル中にこの式を評価し、内部的にクエリを次のように書き換えることができます:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
たたみ込み可能な式
データベース エンジンは以下の種類の式で定数折りたたみを使用しています:
- 定数のみから構成される数式 (
1 + 1、5 / 3 * 2など)。 - 定数のみから構成される論理式 (
1 = 1、1 > 2 AND 3 > 4など)。 - データベース エンジンがfolding可能と見なす組み込み関数(
CASTやCONVERTを含む)。 一般的に、組み込み関数は入力のみの関数であり、SETオプション、言語設定、データベースオプション、暗号鍵などの他の文脈情報には依存しない場合に定数畳み込み可能です。 非決定論的関数はたたみ込み不可能です。 組み込みの決定的関数はたたみ込み可能ですが、一部例外があります。 - CLR ユーザー定義型の決定論的メソッドと決定論的なスカラー値 CLR ユーザー定義関数。 詳細については、「CLR ユーザー定義関数およびメソッドの定数たたみ込み」を参照してください。
注
大規模オブジェクト型には例外が適用されます。 フォールディング プロセスの出力型がラージ オブジェクト型 (text、ntext、image、nvarchar(max)、varchar(max)、varbinary(max)、json、または xml) の場合、データベース エンジン はその式を折りたたみません。
たたみ込み不可能な式
その他の種類の式は、すべてたたみ込み不可能です。 具体的には、次に示す種類の式は折り畳み可能ではありません。
- 定数ではない式 (結果が列の値によって変わる式など)。
- 結果がローカル変数またはパラメーター (
@xなど) によって変わる式。 - 非決定的関数。
- ユーザー定義のT-SQL関数。
- 結果が言語設定によって変わる式。
- 結果が
SETオプションに依存する式。 - 結果がサーバー構成オプションによって変わる式。
たたみ込み可能/不可能な定数式の例
次のクエリがあるとします。
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
このクエリに対して PARAMETERIZATION データベースオプションが FORCED に設定されていない場合、式 117.00 + 1000.00 は評価され、クエリコンパイル前に結果 1117.00に置き換えられます。 この定数畳み込みのメリットには以下が含まれます:
- 実行時に式を繰り返し評価する必要がありません。
- 式の評価後の値はクエリ オプティマイザーによって、
TotalDue > 117.00 + 1000.00で示されたクエリの部分の結果セットのサイズを推定するために使われます。
一方、dbo.fがユーザー定義のスカラー関数であれば、式dbo.f(100)は折りたたまれません。なぜなら、データベース エンジンはユーザー定義関数を含む式を折りたたみません。たとえそれが決定論的であってもです。 パラメータ化の詳細については、「 強制パラメータ化」を参照してください。
式の評価
また、定数畳み込みが行われないものの、引数がコンパイル時に確定する式については、引数がパラメーターであれ定数であれ、最適化時にクエリオプティマイザーのカーディナリティ(結果セットのサイズ)推定機能によって評価されます。
具体的には、次の組み込み関数と特殊演算子は、入力がすべて確定する場合コンパイル時に評価されます: UPPER、LOWER、RTRIM、DATEPART( YY only )、GETDATE、CAST、CONVERT。 次に示す演算子も、入力がすべて確定する場合コンパイル時に評価されます。
- 算術演算子:
+、-、*、/、単項- - 論理演算子:
AND、OR、NOT - 比較演算子:
<、>、<=、>=、<>、LIKE、IS NULL、IS NOT NULL
上記以外の関数および演算子は、カーディナリティを推定するときにはクエリ オプティマイザーによって評価されません。
コンパイル時の式の評価の例
次のストアド プロシージャについて考えてみましょう。
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
このストアド プロシージャの SELECT ステートメントを最適化するとき、条件 OrderDate > @d + 1 に対する結果セットの予測カーディナリティがクエリ オプティマイザーによって評価されます。 式 @d + 1 は @d がパラメーターであるため、定数折り畳みされません。 しかし、最適化のときにはパラメーターの値が確定しています。 この値により、クエリオプティマイザーは結果セットのサイズを正確に推定でき、良いクエリプランの選択に役立ちます。
次に、前の例と同様の例を考えてみましょう。ただし、ローカル変数 @d2 クエリ内の @d + 1 が置き換えられ、式がクエリではなく SET ステートメントで評価される点が異なります。
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
MyProc2のSELECT文がデータベース エンジンで最適化されると、@d2の値は分かりません。 したがって、クエリオプティマイザーは OrderDate > @d2 の選択性のデフォルト推定値(この場合は30%)を使用します。
その他のステートメントを処理する
SELECT文を処理する基本的な手順は、INSERT、UPDATE、DELETEなど他のT-SQL文にも適用されます。
UPDATE文もDELETE文も、修正または削除する行の集合をターゲットにしなければなりません。 これらの行を特定する処理は、 SELECT ステートメントの結果セットを得るために使用された、基になる行を特定する処理と同じです。
UPDATE文もINSERT文も、更新または挿入するためのデータ値を提供する埋め込まれたSELECT文を含む場合があります。
データ定義言語(DDL)文、例えば CREATE PROCEDURE や ALTER TABLEも、システムカタログテーブル上の一連のリレーショナル操作として実行され、時には(ALTER TABLE ADD COLUMNのように)データテーブルに対して処理されます。
作業テーブル
リレーショナルエンジンは、T-SQL文で指定された論理操作を実行するためにワークテーブルを構築する必要があるかもしれません。 ワークテーブルは中間結果を保持する内部テーブルです。 作業テーブルは、特定の GROUP BYクエリ、 ORDER BYクエリ、 UNION クエリで生成されます。 例えば、ある ORDER BY 節がインデックスでカバーされていない列を参照している場合、リレーショナルエンジンは結果セットを要求された順序にソートするためのワークテーブルを生成する必要があるかもしれません。 また、クエリ プランの一部を実行した結果を一時的に格納するためのスプールとして作業テーブルが使用されることもあります。 ワークテーブルはtempdb内で作成され、不要になると自動的に削除されます。
ビュー解像度
データベース エンジンクエリプロセッサは、インデックス付きビューと非インデックスビューを異なる方法で扱います。
- データベースはインデックスビューの行をテーブルと同じ形式で保存します。 クエリオプティマイザーがクエリプランでインデックスビューを使う場合、インデックスビューをベーステーブルと同じように扱います。
- インデックスなしのビューでは、ビューの行ではなく、定義のみが格納されます。 クエリ オプティマイザは、非インデックス付きビューを参照する T-SQL 文に対して作成する実行計画に、ビュー定義のロジックを組み込みます。
クエリオプティマイザーがインデックスビューの使用を判断するロジックは、テーブルでインデックスを使うタイミングを判断するロジックに似ています。 インデックスされたビューのデータがT-SQL文の全部または一部をカバーし、クエリオプティマイザーがビュー上のインデックスが低コストアクセスパスであると判断した場合、クエリがビュー名を参照しているかどうかに関わらず、そのインデックスを選択します。
T-SQL文が非インデックスビューを参照する場合、パーサとクエリオプティマイザーはT-SQL文とビューの両方のソースを分析し、それらを単一の実行計画にまとめます。 T-SQL文とビューは別々のプランを持っていません。
たとえば、次のビューがあるとします。
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
この見解に基づき、これら両方のT-SQL文はベーステーブルに対して同じ操作を行い、同じ結果を生み出します。
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
SQL Server Management Studio(SSMS)Showplanの特徴は、リレーショナルエンジンがこれら両方のSELECT文に対して同じ実行計画を構築していることを示しています。
ビューでヒントを使用する
クエリ内のビューにヒントを置くと、ビューがベーステーブルにアクセスするために展開した際に発見される他のヒントと競合することがあります。 この競合が発生すると、クエリはエラーを返します。 たとえば、定義にテーブル ヒントが含まれている、次のビューについて考えてみます。
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
ここで次のクエリを入力したとします。
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
クエリは失敗します。なぜなら、SERIALIZABLEビューの Person.AddrStateヒントが、展開されるとビュー内のPerson.AddressテーブルとPerson.StateProvinceテーブルの両方に伝播するためです。 しかし、ビューを展開することで、 NOLOCK の Person.Addressヒントも公開されます。 その結果、 SERIALIZABLE ヒントと NOLOCK ヒントが競合するので、クエリ結果は正しくありません。
PAGLOCK、NOLOCK、ROWLOCK、TABLOCK、TABLOCKXテーブルのヒントは互いに競合し、HOLDLOCK、NOLOCK、READCOMMITTED、REPEATABLEREAD、SERIALIZABLEテーブルのヒントも同様です。
ヒントは、入れ子になったビューの階層を通じて伝播することができます。 たとえば、クエリでビュー HOLDLOCK に v1ヒントが適用されるとします。
v1を拡張すると、ビューv2はその定義の一部であることがわかります。
v2の定義では、ベース テーブルの 1 つに NOLOCK ヒントが含まれています。 しかし、このテーブルはビュー HOLDLOCK のクエリから v1ヒントも継承します。 その結果、 NOLOCK ヒントと HOLDLOCK ヒントが競合するので、クエリが失敗します。
ビューを含むクエリで FORCE ORDER ヒントを使うと、順序付き構文におけるビューの位置がビュー内のテーブルの結合順序を決定します。 たとえば、次のクエリは 3 つのテーブルとビューから選択を行います。
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
そして View1 は以下の例のように定義されます。
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
クエリ プランでの結合順序は、 Table1、 Table2、 TableA、 TableB、 Table3の順になります。
ビューのインデックスを解決する
他のインデックスと同様に、データベース エンジンはクエリオプティマイザーが有益と判断した場合に限り、クエリ計画でインデックスビューを使用します。
データベース エンジンのどのエディションでもインデックスビューを作成できます。 一部の版ではクエリオプティマイザーがインデックスビューを自動的に考慮しますが、他の版では NOEXPAND テーブルヒントを使う必要があります。 クエリ オプティマイザーによるインデックス付きビューの自動使用は、SQL Server の特定のエディションでのみサポートされています。
注
Azure SQL Database と Azure SQL Managed Instance では、NOEXPAND ヒントを指定せずにインデックス付きビューを自動的に使用できます。
クエリオプティマイザーは、以下の条件が満たされた場合にインデックスビューを使用します。
- 次のセッション オプションが
ONに設定されている。ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
-
NUMERIC_ROUNDABORTセッションオプションはOFFに設定されています。 - クエリオプティマイザーはビューインデックスの列とクエリ内の要素の一致を見つけます。例えば:
-
WHERE節の検索条件述語 - 結合操作
- 集計関数
-
GROUP BY句 - テーブルの参照
-
- クエリ オプティマイザーが検討したアクセス方法の中で、インデックスを使用した場合の推定コストが最小である。
- クエリ内で (直接、またはビューを展開して基になるテーブルにアクセスすることにより) 参照しているテーブルのうち、インデックス付きビュー内のテーブル参照に対応しているすべてのテーブルについて、クエリ内で適用されているヒントの組み合わせが同じである。
注
現在のトランザクション分離レベルにかかわらず、このコンテキストでは READCOMMITTED ヒントと READCOMMITTEDLOCK ヒントは常に異なるヒントと見なされます。
SET オプションおよびテーブル ヒントの要件を除くと、上記の条件は、テーブル インデックスがクエリをカバーするかどうかを判断するためにクエリ オプティマイザーにより使用されるルールと同じです。 インデックスビューを使うためにクエリで他に何かを指定する必要はありません。
クエリの FROM 句でインデックス付きビューを明示的に参照しなくても、クエリ オプティマイザーはインデックス付きビューを使用します。 ベース テーブル内の列に対する参照がクエリに含まれており、その参照がインデックス付きビューにも存在する場合、クエリ オプティマイザーは、インデックス付きビューの使用によりアクセス コストを最小にできると推定できれば、インデックス付きビューを選択します。これはクエリ オプティマイザーが、ベース テーブルのインデックスを、クエリ内で直接参照されていない場合に選択するのと同じ手法です。 クエリ内で指定されている 1 つ以上の列をカバーするオプションとして最もコストが低ければ、クエリで参照されていない列がビューに含まれていても、クエリ オプティマイザーがそのビューを選択することがあります。
クエリ オプティマイザーは FROM 句で参照されているインデックス付きビューを標準のビューとして扱います。 最適化処理の開始時には、ビューの定義をクエリにまで拡張します。 そのうえで、インデックス付きビューの照合を実行します。 クエリ オプティマイザーが選択した最終的な実行プランでは、インデックス付きビューが使用されることも、ビューが参照するベース テーブルにアクセスすることにより、ビュー内の必要なデータが具体化されることもあります。 クエリオプティマイザは、最もコストが低い代替案を選択します。
インデックス付きビューでヒントを使用する
EXPAND VIEWS クエリ ヒントを指定すると、ビューのインデックスがクエリで使用されるのを禁止できます。 NOEXPAND テーブル ヒントを指定すると、クエリの FROM 句で指定したインデックス付きビューのインデックスを強制的に使用することができます。 ただし、各クエリを使用するための最適なアクセス方法はクエリ オプティマイザーによる動的な判断に任せることをお勧めします。
EXPAND および NOEXPAND を使用するのは、テストで結果パフォーマンスの大幅な向上が示された場合のみにしてください。
EXPAND VIEWSオプションは、クエリ オプティマイザーに対し、クエリ全体に関してビュー インデックスを使用しないことを指定します。ビューに対して
NOEXPANDを指定すると、クエリ オプティマイザーはそのビューで定義されている任意のインデックスの使用を検討します。NOEXPANDをオプションのINDEX()句で指定すると、クエリ オプティマイザーの判断で指定されたインデックスが強制的に使用されます。 インデックスされたビューだけにNOEXPAND指定でき、インデックスされていないビューには指定できません。 クエリオプティマイザーによるインデックスビューの自動使用は、特定のSQL Serverのエディションでのみサポートされています。注
Azure SQL Database と Azure SQL Managed Instance では、
NOEXPANDヒントを指定せずにインデックス付きビューを自動的に使用できます。
ビューを含んだクエリで NOEXPAND と EXPAND VIEWS のいずれも指定しない場合、基になるテーブルにアクセスするためにビューが拡張されます。 ビューを構成するクエリにテーブル ヒントが含まれている場合、基になるテーブルにヒントが反映されます (このプロセスはビューの解決でより詳しく説明されています。) ビューの基盤となるテーブル上に存在するヒントのセットが互いに同一であれば、クエリはインデックス付きビューの一致対象となる可能性があります。 ほとんどの場合、これらのヒントは互いに一致します。なぜなら、それらはビューから直接受け継がれているからです。 ただし、クエリの参照先がビューではなくテーブルであり、これらのテーブルに直接適用されているヒントがテーブルによって異なる場合、そのようなクエリはインデックス付きビューと一致しません。 ビューの展開後、INDEX、PAGLOCK、ROWLOCK、TABLOCKX、UPDLOCK、XLOCK のいずれかのヒントがクエリの参照先テーブルに適用される場合、クエリはインデックス付きビューと一致しません。
INDEX ( index_val [ ,...n] ) という形式のテーブル ヒントでクエリ内のビューを参照しているときに、NOEXPAND ヒントを指定しない場合、インデックス ヒントは無視されます。 特定のインデックスを使用するように指定するには NOEXPAND を使用します。
一般的に、クエリオプティマイザーがインデックスされたビューをクエリにマッチさせると、クエリ内のテーブルやビューで指定されたヒントを直接インデックスビューに適用します。 クエリオプティマイザーがインデックス付きビューを使用しないことを選択した場合、ビューで参照されたテーブルにヒントを直接伝播させます。 詳細については、「解像度を表示」をご覧ください。 この伝達は、結合ヒントには当てはまりません。 クエリ内の元の位置にのみ適用されます。 クエリオプティマイザーは、インデックスされたビューにクエリをマッチングする際に結合ヒントを考慮しません。 結合ヒントを含むクエリの一部に一致したインデックス付きビューがクエリ プランで使用される場合、その結合ヒントはプランに使用されません。
インデックス付きビューの定義ではヒントが許可されていません。 データベース エンジンは、インデックス付きビュー定義内のヒントを、それらの保守時やインデックス付きビューを使用するクエリの実行時に無視します。
詳細については、「テーブル ヒント」を参照してください。
分散パーティション ビューを解決する
データベース エンジンクエリプロセッサは分散パーティションビューのパフォーマンスを最適化します。 分散パーティション ビューのパフォーマンスで最も重要な点は、メンバー サーバー間で転送されるデータの量を最小限に抑えることです。
データベース エンジンは、分散クエリを効率的に活用してリモートメンバーテーブルからデータにアクセスするインテリジェントで動的なプランを構築します。
- クエリ プロセッサでは、最初に OLE DB を使用して、各メンバー テーブルから CHECK 制約の定義が取得されます。 この方法により、クエリプロセッサはメンバーテーブル間でキー値の分布をマッピングできます。
- クエリプロセッサは、T-SQL文
WHERE節で指定されたキーレンジを、メンバーテーブル内の行の分布を示すマップと比較します。 クエリプロセッサは、分散クエリを用いてT-SQL文を完成させるために必要なリモート行のみを取得するクエリ実行計画を構築します。 実行計画はまた、データやメタデータのリモートメンバーテーブルへのアクセスが、情報が必要になるまで遅延されるように構築されています。
たとえば、Customers テーブルが Server1 (CustomerID 1 から 3299999)、Server2 (CustomerID 3300000 から 6599999)、および Server3 (CustomerID 6600000 から 9999999) にパーティション分割されたシステムがあるとします。
Server1 で実行される次のクエリ用に構築される実行プランを考えてみます。
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
このクエリの実行プランでは、ローカル メンバー テーブルから CustomerID のキー値が 3200000 ~ 3299999 の行が抽出され、分散クエリを実行して Server2 からキー値が 3300000 ~ 3400000 の行が取得されます。
データベース エンジンクエリプロセッサは、プラン作成時にキー値が不明なT-SQL文のクエリ実行計画に動的ロジックを組み込むこともできます。 たとえば、次のようなストアド プロシージャがあるとします。
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
データベース エンジンは、手続きが実行されるたびに@CustomerIDParameterパラメータからどのキー値が供給されるかを予測することはできません。 キー値は予測できないため、クエリプロセッサはどのメンバーテーブルにアクセスする必要があるかも予測できません。 このケースに対応するため、データベース エンジンは条件付き論理(動的フィルターと呼ばれる)を用いた実行計画を構築し、入力パラメータ値に基づいてどのメンバーテーブルにアクセスするかを制御します。
GetCustomerストアドプロシージャがServer1上で実行されたと仮定すると、実行計画ロジックは以下の出力のように表現できます。
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
データベース エンジンは、パラメータ化されていないクエリに対しても、このような動的実行計画を構築することがあります。 クエリ オプティマイザーはクエリをパラメーター化し、実行プランを再利用できるようにします。 クエリオプティマイザがパーティションビューを参照するクエリをパラメータ化すると、必要な行が指定されたベーステーブルから来ると仮定できなくなります。 その後、実行計画に動的フィルターを使わなければなりません。
ストアド プロシージャとトリガー実行
データベース エンジンはストアドプロシージャとトリガーのソースのみを保存します。 ストアド プロシージャまたはトリガーを最初に実行するときに、ソースが実行プランにコンパイルされます。 時間が経過して実行プランがメモリから削除される前にストアド プロシージャまたはトリガーを再度実行すると、リレーショナル エンジンは既存の実行プランを検出してそれを再利用します。 プランがメモリから削除されると、新しいプランが作成されます。 このプロセスは、データベース エンジンがすべてのT-SQL文に対して従うプロセスと類似しています。 データベース エンジンにおけるストアドプロシージャやトリガーが動的T-SQLのバッチと比べて持つ主なパフォーマンス優位性は、それらのT-SQL文が常に同じであることです。 したがって、リレーショナル エンジンを既存の実行プランに容易に適合させることができます。 その結果、ストアド プロシージャやトリガーのプランを簡単に再利用できます。
ストアド プロシージャとトリガーの実行プランは、ストアド プロシージャを呼び出すバッチやトリガーを起動するバッチの実行プランとは別に実行されます。 この分離により、ストアドプロシージャやトリガー実行計画の再利用が可能になります。
実行プランのキャッシュと再利用
データベース エンジンは実行計画とデータバッファの両方を保存するためにメモリを使用します。 実行計画やデータバッファに割り当てられるメモリの割合は、システムの状態に応じて動的に調整されます。 実行計画を格納するメモリ部分は プランキャッシュと呼ばれます。
プラン キャッシュ ストア
プラン キャッシュには、すべてのコンパイル済みプラン用の 2 つのストアがあります。
- オブジェクト プラン キャッシュ ストア (OBJCP)。これは、ストアド プロシージャ、関数、トリガーなどの永続オブジェクトに関連するプラン用です。
- SQL プラン キャッシュ ストア (SQLCP) は、オートパラメータ化、動的、または準備されたクエリに関連するプラン用です。
以下のクエリは、これら2つのキャッシュストレージのメモリ使用量に関する情報を提供します:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
プランキャッシュには、プランを保存しない2つの追加ストアがあります:
- バウンド ツリー キャッシュ ストア (PHDR)。ビュー、制約、および既定値のプラン コンパイル時に使用されるデータ構造用。 これらの構造は 結合木 または 代数化木として知られています。
- 拡張ストアドプロシージャ キャッシュ ストア (XPROC)。sp_executesql や xp_cmdshell などの、あらかじめ定義されたシステム プロシージャ用。 これらのストアドプロシージャはT-SQL文の代わりにDLLを使用します。 キャッシュされた構造体は、関数名と、プロシージャが実装されているDLL名のみを含みます。
実行計画の構成要素
データベース エンジンの実行計画には、以下の主要なコンポーネントがあります:
コンパイル済みプラン(またはクエリ プラン)
コンパイル プロセスで生成されるクエリ プランはほとんどの場合、任意の数のユーザーによって使用される、再入可能な読み取り専用のデータ構造です。 これには、次の情報が格納されます。
論理演算子で記述される操作を実装する物理演算子。
データにアクセスし、フィルター処理し、集約する順序を決定する、これらの演算子の順序。
演算子を通過する推定行の数。
注
クエリプランはまた、カーディナリティ推定に使われる統計オブジェクトに関する情報も保存します。
作業テーブルや作業ファイルといったサポートオブジェクトを
tempdbに作成する必要があります。
クエリプランはユーザーのコンテキストやランタイム情報を一切保存しません。 データベース エンジンはプランキャッシュからプランを取得するたびにワーカースレッドの数を決定します。 キャッシュされた並列計画はシリアル実行も可能です。
実行コンテキスト
クエリを実行している各ユーザーは、パラメータ値など、その実行に特有のデータを保持するデータ構造を持っています。 このデータ構造は 実行コンテキストと呼ばれます。 実行コンテキストのデータ構造は再利用されますが、その内容は再利用されません。 別のユーザーが同じクエリを実行すると、新しいユーザーのコンテキストでデータ構造が再初期化されます。
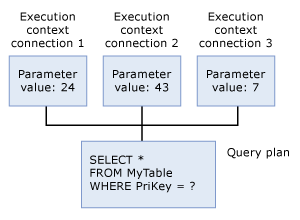
同一のステートメントの再利用計画
データベース エンジンが任意のT-SQL文を実行する際、まずプランキャッシュを確認し、同じT-SQL文の実行計画が存在するかを確認します。 T-SQL文は、キャッシュされたプランを持つ以前に実行されたT-SQL文と文字どおり1文字単位で一致する場合、既存と見なされます。 データベース エンジンは見つかった既存の計画を再利用し、T-SQL文の再コンパイルのオーバーヘッドを節約します。 実行計画が存在しない場合、データベース エンジンはクエリのために新しい実行計画を生成します。
注
プランキャッシュは、行ストア上で動作するバルク操作文や大きな文字列リテラルを含む文など、一部のT-SQL文の実行計画を永続化しません。 これらのプランはクエリが実行中のみ存在します。
データベース エンジンは効率的なアルゴリズムを用いて、特定のT-SQL文に対する既存の実行計画を見つけます。 ほとんどのシステムでは、このスキャンが使用する最小限のリソースは、すべてのT-SQL文をコンパイルする代わりに既存のプランを再利用することで節約されるリソースよりも少ないです。
新しいT-SQL文をプランキャッシュ内の既存の未使用実行計画にマッチさせるアルゴリズムでは、すべてのオブジェクト参照が完全修飾されている必要があります。 例えば、SELECT は、次の Person ステートメントを実行するユーザーのデフォルトのスキーマであると仮定します。 この例では Person テーブルを完全修飾して実行する必要はありませんが、2つ目の文は既存の実行プランと一致せず、3つ目の文は一致します。
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
特定の実行について、以下のSETオプションのいずれかを変更すると、データベース エンジン が定数の折りたたみを実行し、これらのオプションがそのような式の結果に影響するため、プランの再利用能力に影響が出ます。
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
同じクエリに対する複数のプランをキャッシュする
クエリおよび実行プランは、データベース エンジンで一意に識別でき、フィンガープリントとよく似ています。
- クエリ プラン ハッシュは、特定のクエリの実行プランで計算されるバイナリ ハッシュ値であり、類似する実行プランを一意に識別するために使用されます。
- クエリ ハッシュ はクエリのT-SQLテキスト上で計算された二進ハッシュ値であり、クエリを一意に識別するために用いられます。
プランハンドルを使ってプランキャッシュからコンパイル済みのプランを取得できます。 この一時識別子は、プランがキャッシュ内に残る間のみ一定のままです。 プラン ハンドルは、バッチ全体のコンパイル済みプランから派生したハッシュ値です。 コンパイル済みプランのプランハンドルは、バッチ内の1つ以上の文が再コンパイルされても同じままです。
注
単一の文ではなくバッチ用のプランをコンパイルする場合、プランハンドルとステートメントオフセットを使ってバッチ内の個々のステートメントのプランを取得できます。
sys.dm_exec_requestsDMVには各レコードのstatement_start_offset列とstatement_end_offset列が含まれています。 これらの列は、現在実行中のバッチまたは永続オブジェクトの現在実行中のステートメントを指します。 詳細については、「sys.dm_exec_requests」を参照してください。
sys.dm_exec_query_stats DMVにも各レコードごとにこれらの列が記載されています。 これらの列は、バッチや永続オブジェクト内のステートメントの位置を指します。 詳細については、「sys.dm_exec_query_stats」を参照してください。
バッチの実際のT-SQLテキストは、プランキャッシュとは別のメモリ空間である SQL Manager キャッシュ(SQLMGR)に格納されます。 SQLハンドルを使って、コンパイル済みプランのT-SQLテキストをSQL Managerキャッシュから取得できます。 この一時識別子は、それを参照する少なくとも1つのプランがプランキャッシュに残る限り一定のままです。 SQLハンドルはバッチ テキスト全体から導き出されたハッシュ値であり、すべてのバッチごとに一意であることが保証されています。
注
コンパイルされた計画と同様に、T-SQLテキストはバッチごとに保存され、コメントも含まれます。 SQLハンドルはバッチテキスト全体のMD5ハッシュを含み、すべてのバッチで一意であることが保証されています。
以下のクエリは、SQL Managerキャッシュのメモリ使用量に関する情報を提供します。
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
SQLハンドルとプランハンドルの間には一対多の関係があります。 この条件は、コンパイルされたプランのキャッシュキーが異なる場合に発生します。 この違いは、同じバッチの2回の実行間で SET オプションが変更されることで生じることがあります。
次のストアド プロシージャについて考えてみます。
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
プランキャッシュ内の情報は以下のクエリで確認してください:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
結果セットは次のとおりです。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
次に、実行コンテキストに変更を加えずに異なるパラメータでストアドプロシージャを実行します。
EXECUTE usp_SalesByCustomer 8;
GO
プランキャッシュで見つかるものをもう一度確認してください。 結果セットは次のとおりです。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
usecounts値が2に増加していることに注目してください。これは、実行コンテキストデータ構造が再利用されるため、同じキャッシュされたプランがそのまま再利用されることを意味します。 次に SET ANSI_DEFAULTS オプションを変更し、同じパラメータを使ってストアドプロシージャを実行します。
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
プランキャッシュで見つかるものをもう一度確認してください。 結果セットは次のとおりです。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
sys.dm_exec_cached_plans DMV の出力に、現在、2 つのエントリがあることに注目してください。
-
usecounts列は最初のレコードで値1を示します。 この値はSET ANSI_DEFAULTS OFFで 1 回実行されたプランを表します。 -
usecounts列は2番目のレコードの値2を示します。 この値は、2回実行されたため、SET ANSI_DEFAULTS ONを用いて実行された計画を表します。 - 異なる
memory_object_addressで、プラン キャッシュ内の別の実行プラン エントリが参照されます。 しかし、sql_handle値は両方のエントリで同じになります。これは、同じバッチが参照されているためです。-
ANSI_DEFAULTSをOFFに設定した実行には新しいplan_handleがあり、同じSETオプションセットのコールでも再利用可能です。SETオプションが変更されたため、実行コンテキストが再初期化されたため、新しいプラン ハンドルが必要です。 しかし、その変更は再コンパイルを引き起こすものではありません。両方のエントリは同じプランとクエリを参照しており、同じquery_plan_hashとquery_hashの値からも分かるように、同一のものです。
-
この場合、キャッシュ内に同じバッチに対応する2つのプランエントリが存在することになります。 同じクエリを繰り返し実行する際に、プランキャッシュに影響する SET オプションが同じであることの重要性を強調しています。 このアプローチはプランの再利用を最適化し、プランキャッシュサイズを必要な最小に抑えます。
ヒント
一般的な落とし穴は、 SET オプションに対して異なるクライアントが異なる既定値を持つことです。 例えば、SQL Server Management Studioを通じた接続は自動的にQUOTED_IDENTIFIERをONに設定し、SQLCMDはQUOTED_IDENTIFIERをOFFに設定します。 これら2つのクライアントから同じクエリを実行すると、複数のプランになります(前述の例で説明した通り)。
プラン キャッシュから実行プランを削除する
実行計画は、メモリが十分にある限りプランキャッシュに残ります。 メモリ負荷が発生する場合、SQL Server データベース エンジンはコストベースのアプローチでどの実行計画をプランキャッシュから削除するかを決定します。 コストベースの意思決定を行うために、SQL Server データベース エンジンは以下の要因に基づいて各実行計画の現在のコスト変数を増減します。
ユーザープロセスがキャッシュに実行計画を挿入すると、ユーザープロセスが現在のコストを元のクエリコンパイルコストと等しく設定します。 アドホック実行計画の場合、ユーザープロセスは現在のコストをゼロに設定します。 その後、ユーザープロセスが実行計画を参照するたびに、現在のコストを元のコンパイルコストにリセットします。 アドホック実行計画の場合、ユーザープロセスは現在のコスト値を増加させます。 すべてのプランについて、現在のコストの最大値は元のコンパイル コストです。
メモリ負荷が発生すると、SQL Server データベース エンジンはプランキャッシュから実行計画を削除します。 どのプランを削除するかを決めるために、SQL Server データベース エンジンは各実行プランの状態を繰り返し検証して、現在のコストがゼロであるプランを削除します。 現在のコストがゼロの実行計画は、メモリ不足が発生しても自動的に削除されません。 SQL Server データベース エンジンがプランを調査し、現在のコストがゼロである場合にのみ削除されます。 SQL Server データベース エンジンは、実行プランを検証するとき、クエリがそのプランを現在使用していない場合は、現在のコストを減少させ、ゼロに近づけます。
SQL Server データベース エンジンは、メモリ要件を満たすまで十分な数の実行プランを削除するまで、実行計画を継続的にチェックします。 メモリ負荷が存在する場合、実行プランのコストは数回にわたって増減することになります。 メモリ負荷がなくなると、SQL Server データベース エンジン は未使用の実行計画の現在のコストを減少させることを停止します。 すべての実行計画は、コストがゼロであっても計画キャッシュに残ります。
SQL Server データベース エンジンはリソース モニターとユーザー ワーカー スレッドを使用して、メモリ負荷に応じてプラン キャッシュからメモリを解放します。 リソースモニターとユーザーワーカースレッドは、未使用の実行プランごとに現在のコストを削減するため、実行プランを同時に調べることができます。 リソース モニターは、グローバルなメモリ負荷が存在する場合に、実行プランをプラン キャッシュから削除します。 メモリを解放することにより、システム メモリ、プロセス メモリ、リソースプールメモリ、およびすべてのキャッシュの最大サイズに関するポリシーを適用します。
すべてのキャッシュの最大サイズは、バッファー プール サイズの関数で、最大サーバー メモリを超えることはできません。 最大サーバーメモリの設定についての詳細は、max server memoryのsp_configure設定をご覧ください。
ユーザー ワーカー スレッドは、単一キャッシュ メモリ負荷が存在する場合に、実行プランをプラン キャッシュから削除します。 単一キャッシュの最大サイズおよび最大エントリのポリシーを強制的に適用します。
次の例では、どの実行プランがプラン キャッシュから削除されるかを示しています。
- 実行プランは頻繁に参照されるため、そのコストがゼロになることはありません。 プランはプランキャッシュに残り、メモリの負荷がかかって現在のコストがゼロである限り削除されません。
- アドホック実行プランは挿入され、メモリ負荷が生じるまでは再度参照されることはありません。 アドホックプランは現在のコストがゼロで初期化されるため、SQL Server データベース エンジンが実行計画を調査すると、現在のコストゼロを確認し、プランキャッシュからプランを削除します。 アドホック実行計画はメモリ プレッシャーが存在しない場合、現在のコストがゼロでプランキャッシュに残ります。
キャッシュから 1 つまたはすべてのプランを手動で削除するには、 DBCC FREEPROCCACHEを使用します。
また、DBCC FREESYSTEMCACHEを使ってプランキャッシュを含むあらゆるキャッシュをクリアすることもできます。 SQL Server 2016 (13.x) 以降では、スコープ内のデータベースのプロシージャ (プラン) キャッシュをクリアするには、ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE を使用します。
sp_configure と reconfigure を使用した一部の構成設定の変更でも、プラン キャッシュからプランが削除されます。 これらの構成設定の一覧については、「DBCC FREEPROCCACHE」の記事の「注釈」を参照してください。 この設定変更を行うと、以下の情報メッセージがエラーログに書き込まれます:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
実行プランを再コンパイルする
データベースの特定の変更は実行計画を非効率的または無効にすることがあります。 データベース エンジンはこれらの変更を検知し、プランを無効とマークします。 このため、クエリを実行する次回の接続用に新しい実行プランを再コンパイルする必要があります。 計画を無効にする条件には以下が含まれます:
- クエリが参照するテーブルやビューの変更(
ALTER TABLEおよびALTER VIEW)。 - 単一のプロシージャへの変更により、そのプロシージャのプランをすべてキャッシュから削除します(
ALTER PROCEDURE)。 - 実行プランで使用されるインデックスに変更を加えた場合
- 実行計画で使用される統計の更新 (
UPDATE STATISTICSのようなステートメントで明示的に生成されるものも、自動的に生成されるものも)。 - 実行プランに使用されるインデックスを削除すること
-
sp_recompileを明示的に呼び出した場合 - クエリによって参照されるテーブルを変更する他のユーザーが、
INSERTステートメントまたはDELETEステートメントを使用して大量の変更をキーに加えた場合 - トリガーを含むテーブルで、inserted テーブルまたは deleted テーブルの行数が大幅に増加する場合
-
WITH RECOMPILEオプションを使ってストアドプロシージャを実行すること。
ほとんどの再コンパイルは、ステートメントの正確性のためか、より高速なクエリ実行計画を得るために必要です。
バッチ内の文が再コンパイルをトリガーした場合、その文だけが再コンパイルされ、バッチ全体が再コンパイルされるわけではありません。 このルールは、バッチがストアドプロシージャ、トリガー、アドホックバッチ、またはプリペアドステートメントのいずれかを通じて送信される場合にも適用されます。
文レベルの再コンパイルがパフォーマンスに有益であるのは、ほとんどの場合、再コンパイルと、それに伴うCPU時間やロックの面でのペナルティを引き起こす文は少数だからです。 したがって、再コンパイルを必要としないバッチ内の他の文についてはこれらのペナルティが回避されます。
sql_statement_recompile拡張イベント (XEvent) は、ステートメント レベルの再コンパイルを報告します。 この XEvent は、任意の種類のバッチでステートメント レベルの再コンパイルが必要な場合に発生します。 この要件にはストアドプロシージャ、トリガー、アドホックバッチ、クエリが含まれます。 バッチは sp_executesql、動的SQL、Prepareメソッド、実行メソッドなど複数のインターフェースを通じて送信できます。
recompile_cause XEvent のsql_statement_recompile列には、再コンパイルの理由を示す整数コードが含まれています。 以下のリストは、考えられる理由を示しています。
- カーソル オプションの変更
- コンパイルの遅延
- 変更された
FOR BROWSEアクセス許可 - 要求した
OPTION (RECOMPILE) - パラメーター化されたプランが消去された
- パーティション ビューが変更された
- データベース バージョンの変更がプランに影響を与えた
- クエリ通知環境の変更
- クエリ ストアにプランが欠けている
- クエリ ストア プラン強制の失敗
- クエリ ストア プラン強制ポリシーの変更
- リモート行セットが変更されました
- スキーマの変更
-
SETオプションが変更されました - 統計の変更
- 一時テーブルが変更された
注
AUTO_UPDATE_STATISTICSデータベースオプションをONに設定すると、統計が更新されたり、前回の実行から基数が大きく変化したテーブルやインデックスビューを対象にクエリが再コンパイルされます。 この動作は、標準のユーザー定義テーブル、一時テーブル、および DML トリガーによって作成された inserted テーブルと deleted テーブルに当てはまります。
AUTO_UPDATE_STATISTICSをOFFに設定するとこれらの再コンパイルは停止しますが、古い統計情報は通常、再コンパイルよりもクエリ パフォーマンスを低下させることがよくあります。 詳細については、 AUTO_UPDATE_STATISTICS オプションをご覧ください。 DML INSTEAD OF トリガーの挿入および削除テーブルは tempdb で作成されるため、tempdb の AUTO_UPDATE_STATISTICS 設定に従います。
プランの再利用には明示的なパラメーターを使う
ADO.NETアプリケーションでの命名パラメータやOLE DBやODBCアプリケーションでのパラメータマーカーなどのパラメータを使用することで、実行計画の再利用を増やすことができます。
警告
型、長さ、形式、および範囲をテストすることによってユーザー入力を必ず検証してください。 詳細については、「SQL インジェクション」を参照してください。
次の 2 つの SELECT ステートメントでは、 WHERE 句で比較する値のみが異なっています。
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
これらのクエリの実行プランでは、 ProductSubcategoryID 列に対して比較用に格納された値のみが異なります。 目標は、データベース エンジンがステートメントが実質的に同じプランを生成すると常に認識し、プランを再利用することですが、データベース エンジンは複雑なT-SQL文ではこの類似性を検出しないことがあります。
パラメータを使ってT-SQL文から定数を分離することで、リレーショナルエンジンが重複した実行プランを認識するのに役立ちます。 パラメータの利用方法は以下の通りです:
T-SQLでは、
sp_executesqlを使用します:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;このメソッドは、SQL文を動的に生成するT-SQLスクリプト、ストアドプロシージャ、またはトリガーに推奨されます。
ADO.NET で
SqlClientを使用する場合は、@Parmなどの名前付きパラメーターを使用します。 OLE DBとODBCはパラメータマーカーを使用します。 パラメータマーカーは、SQL文の定数を置き換える疑問符(?)で、プログラム変数にバインドされます。 たとえば、ODBC アプリケーションでは次のような操作を実行できます。SQLBindParameterを使用して、整数変数を SQL ステートメントの最初のパラメーター マーカーにバインドします。変数に整数値を代入します。
文を実行し、パラメータ マーカー(
?)を指定します:SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
SQL ServerネイティブクライアントOLE DBプロバイダーとSQL ServerネイティブクライアントODBCドライバーは、アプリケーションでパラメータマーカーが使われた際にSQL Serverにステートメントを送るために
sp_executesqlを使用します。設計上、パラメーターを使用するストアド プロシージャを作成します。
アプリケーション設計にパラメータを明示的に組み込んでいない場合でも、クエリオプティマイザーが単純なパラメータ化のデフォルト動作を使って自動的にクエリをパラメータ化してくれることにも頼ることができます。 また、PARAMETERIZATION ステートメントの ALTER DATABASE オプションを FORCED に設定することで、クエリ オプティマイザーにデータベース内のすべてのクエリをパラメーター化するように強制できます。
簡易パラメーター化
データベース エンジンでは、T-SQL文にパラメータやパラメータマーカーを使用することで、リレーショナルエンジンが新しいT-SQL文と既存のコンパイル済み実行計画をマッチングする能力が向上します。
警告
型、長さ、形式、および範囲をテストすることによってユーザー入力を必ず検証してください。 詳細については、「SQL インジェクション」を参照してください。
パラメータなしでT-SQL文が実行された場合、データベース エンジンは既存の実行計画と照合できる可能性を高めるために内部でその文をパラメータ化します。 この過程は パラメータ化と呼ばれます。 デフォルトは シンプルなパラメーター化で、データベースに対して 強制パラメーター化 を有効にすることもできます。
次のステートメントについて考えてみます。
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
文の最後にパラメータとして値 1 を指定することができます。 リレーショナルエンジンは、値 1の代わりにパラメータを指定したかのように、このバッチの実行計画を作成します。 この単純なパラメータ化により、データベース エンジンは以下の2つの文が本質的に同じ実行計画を生成することを認識し、2番目の文に最初の計画を再利用します。
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
複雑なT-SQL文を処理する際、リレーショナルエンジンはどの式をパラメータ化できるか判別に苦労することがあります。 リレーショナル エンジンが複雑な T-SQL ステートメントを既存の未使用の実行プランと照合する能力を高めるために、sp_executesql またはパラメーター マーカーを使用してパラメーターを明示的に指定します。
注
+、-、*、/、または %算術演算子を使ってint、smallint、tinyint、bigintの定数値をfloat、real、decimal、または numericデータ型に暗黙的または明示的に変換する場合、データベース エンジンは特定のルールを適用して式の型と精度を計算します。 これらのルールは、クエリがパラメータ化されているかどうかによって異なります。 したがって、クエリ内の類似の式から異なる結果が生成される場合があります。
単純なパラメータ化のデフォルト動作では、データベース エンジンは比較的小さなクエリのクラスをパラメータ化します。 ただし、いくつかの制約はありますが、 PARAMETERIZATION コマンドの ALTER DATABASE オプションを FORCEDに設定することにより、データベース内のすべてのクエリをパラメーター化するように指定できます。 この変更により、大量の同時クエリが行われるデータベースのパフォーマンスが向上し、クエリのコンパイル頻度が減少します。
単一のクエリと、それと構文的に同等でパラメーター値のみ異なる他のクエリをパラメーター化することを指定できます。
ヒント
Entity Framework (EF) のようなオブジェクト リレーショナル マッピング (ORM) ソリューションを使用する場合、手動の LINQ クエリ ツリーや特定の生の SQL クエリなどのアプリケーション クエリがパラメータ化されないことがあります。 この制限はプランの再利用やクエリ ストアでのクエリ追跡能力に影響を与えます。 詳細については、EF クエリのキャッシュとパラメーター化および EF の未加工の SQL クエリに関する記事を参照してください。
強制パラメーター化
データベース内のすべてのSELECT、INSERT、UPDATE、およびDELETE文を、一定の制限の下ですべてパラメータ化するよう指定することで、データベース エンジン の既定の単純なパラメータ化動作をオーバーライドできます。 強制パラメータ化を有効にするには、FORCED ステートメントで ALTER DATABASE オプションを PARAMETERIZATION に設定してください。 強制パラメーター化を行うと、クエリをコンパイルおよび再コンパイルする頻度が低くなるので、データベースによってはパフォーマンスが向上する可能性があります。 一般的に POS (point-of-sale) などのアプリケーションから大量のクエリが同時に実行されるデータベースは、強制パラメーター化によりパフォーマンスが向上します。
PARAMETERIZATIONオプションをFORCEDに設定すると、SELECT、INSERT、UPDATE、またはDELETE文に含まれるリテラル値は、どのような形式で送信された場合でも、クエリ コンパイル中にパラメータに変換されます。 ただし、次に示すクエリ構造に現れるリテラルは例外です。
-
INSERT...EXECUTEステートメント。 - ストアド プロシージャ、トリガー、またはユーザー定義関数の本体内のステートメント。 データベース エンジンはすでにこれらのルーチンのためにクエリプランを再利用しています。
- クライアント側アプリケーションですでにパラメータ化されたプリペアドステートメント。
- XQuery メソッド呼び出しを含んでいるステートメントを、
WHERE句など通常は引数がパラメーター化されるコンテキストで使用した場合。 引数がパラメーター化されないコンテキストでこのメソッドが現れた場合は、ステートメントの残りの部分がパラメーター化されます。 - T-SQLカーソル内の文。 (API カーソル内の
SELECTステートメントはパラメーター化されます)。 - 非推奨のクエリ構造。
-
ANSI_PADDINGまたはANSI_NULLSがOFFに設定されているコンテキストで実行されるステートメント。 - パラメーター化が可能なリテラルが 2,097 を超えるステートメント。
-
WHERE T.col2 >= @bbなど、変数を参照するステートメント。 -
RECOMPILEクエリ ヒントを含んだステートメント。 -
COMPUTE句を含むステートメント。 -
WHERE CURRENT OF句を含むステートメント。
以下のクエリ節はパラメータ化されていません。 これらの場合、句のみがパラメーター化されません。 同じクエリ内のその他の句では強制パラメーター化が可能な場合もあります。
- 任意の
<select_list>文のSELECT。 このリストにはSELECT個のサブクエリのリストとSELECT文内のINSERTリストが含まれます。 -
SELECTステートメント内のサブクエリのIFステートメント。 - クエリの
TOP句、TABLESAMPLE句、HAVING句、GROUP BY句、ORDER BY句、OUTPUT...INTO句、FOR XML句。 -
OPENROWSET、OPENQUERY、OPENDATASOURCE、OPENXML、または任意のFULLTEXT演算子に渡す引数。直接渡すか、サブ式として渡すかは問いません。 -
LIKE句の pattern 引数と escape_character 引数。 -
CONVERT句におけるスタイル引数。 -
IDENTITY句内の整数の定数。 - ODBC 拡張機能の構文で指定した定数。
- 演算子
+、-、*、/、%の引数であり、定数の畳み込みが可能な式。 強制パラメータ化の適格性を考慮する際、データベース エンジンは以下のいずれかの条件が成り立つ場合、式を定数折りたたみ可能とみなします。- 式に列、変数、およびサブクエリが使用されていない。
- 式に
CASE句が含まれている。
- クエリヒント節への引数。これには、クエリヒントの
FAST引数、クエリヒントのMAXDOP引数、クエリヒントのMAXRECURSION引数が含まれます。
パラメータ化は個々のT-SQL文レベルで行われます。 つまり、バッチ内では個々のステートメントがパラメーター化されます。 コンパイル後、パラメータ付きクエリは元々提出されたバッチの文脈で実行されます。 クエリの実行計画がキャッシュされている場合、sql動的管理ビューのsys.syscacheobjects列を参照することで、クエリがパラメータ化されているかどうかを判断できます。 クエリがパラメータ化されている場合、パラメータの名前やデータ型はこの列の提出バッチのテキストの前に置かれます(例: (@1 TINYINT))。
注
パラメーター名の規則はありません。 ユーザーやアプリケーションは特定の命名順に頼るべきではありません。 また、SQL Server のバージョンや累積更新 (CU) のアップグレード間で変更される項目として、パラメーター名、パラメーター化されるリテラルの選択、およびパラメーター化されたテキスト内のスペースがあります。
パラメーターのデータ型
データベース エンジンがリテラルをパラメータ化すると、パラメータは以下のデータ型に変換されます:
- 整数リテラルのサイズが int データ型に収まるはずのリテラルは intにパラメータ化されます。比較演算子を含む述語の一部であるより大きな整数リテラル(
<、<=、=、!=、>、>=、!<、!>、<>、ALL、ANY、SOME、BETWEEN、IN)はnumeric(38,0)にパラメータ化されます。 比較演算子を含む述語の一部でない大きなリテラルは、numeric 型としてパラメーター化され、その精度はその桁数を表現するのにちょうど十分で、スケールは 0 です。 - 比較演算子を含む述語の一部である固定小数点数値リテラルは、精度が38で、そのスケールがそのサイズを支えるのにちょうど十分な numeric 型として扱われます。 比較演算子を含む述語の一部ではない固定小数点数値リテラルは、そのサイズを表現できるだけの精度とスケールを持つ numeric 型としてパラメーター化されます。
- 浮動小数点数値リテラルは float(53)にパラメータ化されます。
- Unicode以外の文字列リテラルは、リテラルが8,000文字以内に収まる場合は varchar(8000) にパラメータ化し、8,000文字を超える場合は varchar(max) にパラメータ化します。
- Unicode文字列リテラルは、リテラルが4,000文字以内に収まる場合はnvarchar(4000)にパラメータ化され、リテラルが4,000文字を超える場合はnvarchar(max)にパラメータ化されます。
- バイナリリテラルは、リテラルが8,000バイト内に収まる場合、varbinary(8000)にパラメータ化されます。 8,000バイトを超える場合は varbinary(max)に変換されます。
- money リテラルは money にパラメーター化されます。
強制パラメーター化使用のガイドライン
PARAMETERIZATIONオプションをFORCEDに設定する際は、以下のポイントを考慮してください。
- 強制パラメータ化は、クエリのリテラル定数をクエリのコンパイル時にパラメータに変更します。 そのため、クエリ オプティマイザーで最適なクエリ プランが選択されない可能性があります。 特に、クエリ オプティマイザがクエリをインデックス付きビューや計算列のインデックスに一致させることは少ないです。 パーティション テーブルおよび分散パーティション ビューに発行するクエリについても、最適なプランが選択されない場合があります。 インデックス化されたビューや計算されたカラムにインデックスを大きく依存する環境では、強制パラメータ化は使わないでください。 一般的に、経験豊富なデータベース専門家のみが、パフォーマンスに悪影響がないことを確認した後に
PARAMETERIZATION FORCEDオプションを使うべきです。 - 複数のデータベースを参照する分散クエリでは、そのクエリを実行しているデータベースのコンテキストで
PARAMETERIZATIONオプションがFORCEDに設定されていれば強制パラメーター化を行うことができます。 -
PARAMETERIZATIONオプションをFORCEDに設定すると、現在コンパイル中、再コンパイル中、または実行中のものを除くすべてのクエリプランがデータベースのプランキャッシュからフラッシュされます。 設定変更中にコンパイルまたは実行中のクエリの計画は、次回実行時にパラメータ化されます。 -
PARAMETERIZATIONオプションの設定は、データベースレベルの排他ロックを必要としないオンライン操作です。 -
PARAMETERIZATIONオプションの現在の設定は、データベースを再アタッチまたは復元するときも維持されます。
強制パラメータ化の動作を上書きするには、単一のクエリ、および構文的に等価でパラメータ値だけが異なる他のクエリに対して、単純なパラメータ化を試みるよう指定できます。 逆に、データベースで強制パラメーター化の動作が無効になっている場合に、構文が同じクエリに対してのみ強制パラメーター化の動作を指定することもできます。 この目的には プラン ガイド を活用してください。
注
PARAMETERIZATION オプションを FORCED に設定すると、PARAMETERIZATION オプションを SIMPLE に設定する場合と比べて、報告されるエラー メッセージに違いが現れる場合があります。複数のエラー メッセージが強制パラメーター化で報告される場合があり、簡易パラメーター化よりも多くのエラー メッセージが報告されることがあります。また、エラーが発生した行番号が間違って報告されることがあります。
強制パラメーター化が有効になっている場合でも、簡易パラメーター化が行われる可能性はあります。 たとえば、強制パラメーター化のルールに従えば、次のクエリはパラメーター化できません。
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
ただし、簡易パラメーター化のルールに従ってパラメーター化することはできます。 強制パラメーター化の試行に失敗した場合でも、簡易パラメーター化が続けて試行されます。
SQL ステートメントを準備する
データベース エンジンは実行前にT-SQL文の準備をサポートします。 アプリケーションがT-SQL文を複数回実行する必要がある場合、データベースAPIを使って以下を行うことができます:
- ステートメントを 1 回準備します。 このステップでは、T-SQL文を実行計画にコンパイルします。
- ステートメントを実行する必要があるたびに、事前コンパイル済みの実行計画を実行します。 この方法は、最初の実行後に各実行でT-SQL文を再コンパイルするのを防ぎます。 ステートメントの準備と実行は、API の関数およびメソッドによって制御されます。 SQL Server Native Client OLE DB ProviderおよびSQL Server Native Client ODBCドライバーは、T-SQL 文を実行するための prepare/execute モデルをサポートします。 準備要求時に、プロバイダーまたはドライバーから SQL Server に対し、準備要求と共にステートメントが送信されます。 データベース エンジンは実行計画をコンパイルし、そのプランのハンドルをプロバイダーまたはドライバーに返します。 実行要求時に、プロバイダーまたはドライバーのいずれかによって、ハンドルに関連付けられたプランの実行要求がサーバーに送信されます。
プリペアド ステートメントはデータベース エンジンで一時的なオブジェクトを作成することはできません。 また、準備されたステートメントでは、一時テーブルなどの一時オブジェクトを作成するシステム ストアド プロシージャを参照できません。 このようなプロシージャは、直接実行する必要があります。
準備/実行モデルの過剰使用はパフォーマンスを低下させる可能性があります。 ステートメントが一度だけ実行される場合、直接実行はサーバーへのネットワーク往復1回だけで済みます。 一度しか実行しないT-SQL文を準備して実行するには、追加のネットワーク往復が必要です。文の準備に1往復、実行に1往復必要です。
ステートメントの準備はパラメータマーカーを使うことでより効果的です。 たとえば、あるアプリケーションに対して、 AdventureWorksLT2025 サンプル データベースから製品情報を取得するように頻繁に要求する場合を考えます。 アプリケーションがこのタスクを行う方法は2つあります。
最初の方法を用いることで、アプリケーションは要求された各製品ごとに別々のクエリを実行できます:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
第2のアプローチを用いると、アプリケーションは以下の操作を実行します。
パラメータマーカー(
?)を含むステートメントを作成します。SELECT * FROM Production.Product WHERE ProductID = ?;プログラム変数をパラメーター マーカーにバインドします。
製品情報が必要になるたびに、バインドした変数にキー値を入力し、ステートメントを実行します。
文が3回を超えて実行される場合、2つ目の方法のほうがより効率的です。
データベース エンジンでは、prepare/executeモデルは直接実行に比べて大きな性能優位性を持ちません。これはデータベース エンジンが実行計画を再利用する方法のためです。 データベース エンジンは、同じT-SQL文の事前実行時に生成された実行計画と現在のT-SQL文を効率的にマッチングするアルゴリズムを持っています。 アプリケーションがパラメーター マーカー付きの T-SQL ステートメントを複数回実行した場合、データベース エンジンは 2 回目以降の実行では最初の実行時の実行プランを再利用します(プランがプラン キャッシュから削除されない限り)。 準備/実行のモデルには次の利点もあります。
- 識別用ハンドルで実行計画を見つけることは、T-SQL文を既存の実行計画にマッチングするアルゴリズムよりも効率的です。
- アプリケーションは実行計画の作成と再利用のタイミングを制御できます。
- 準備/実行のモデルは、以前のバージョンの SQL Server など、他のデータベースに移植できます。
パラメーターの感度
パラメータ感度(パラメータスニッフィングとも呼ばれる)は、データベース エンジンがコンパイルまたは再コンパイル中に現在のパラメータ値をスニッフし、それをクエリオプティマイザーに渡して、より効率的なクエリ実行計画の作成を支援するプロセスを指します。
パラメーター値は、次のようなバッチのコンパイルまたは再コンパイル中にスニッフィングされます。
- ストアド プロシージャ
-
sp_executesqlを介して送信されたクエリ - 準備されたクエリ
パラメータスニッフの問題のトラブルシューティングについての詳細は、以下をご覧ください:
- パラメーターに依存する問題を調査して解決する
- プラン再利用には明示的なパラメータを使う
- パラメーターに依存するプランの最適化
- Azure SQL Database で、パラメーター依存クエリ実行プランの問題があるクエリをトラブルシューティングする
- Azure SQL Managed Instance で、パラメーター依存クエリ実行プランの問題があるクエリをトラブルシューティングする
データベース エンジン のクエリがOPTION (RECOMPILE)ヒントを使用すると、クエリ最適化器はパラメーター変数とローカル変数をコンパイル時定数に変換し、それらを定数折りたたみによってリテラルへ簡約できるようにします。 コンパイル中、最適化者はその文の直前にあるパラメータや局所変数の現在の実行時値を把握し、使用できます。
OPTION (RECOMPILE)ヒントにより、オプティマイザーは特定の値に合わせた、より最適なクエリ プランを生成し、実行時に最良の基礎インデックスを活用できます。 パラメーターの場合、このプロセスは、最初にバッチまたはストアド プロシージャに渡された値ではなく、再コンパイル時の値を参照します。 これらの値は、 RECOMPILEを含む文に到達する前に手続き内で変更されることがあります。 この挙動は、非常に変動的または偏った入力データを持つクエリのパフォーマンスを向上させることができますが、その代償として実行するたびにクエリをコンパイルするコストがかかります。 この費用は高額になることがあります。
RECOMPILEヒントは、ワークロード全体への影響を評価せずに使用しないでください。
局所変数とカーディナリティ推定
クエリがローカル変数を使う場合、データベース エンジンはコンパイル時にその値をスニッフできないため、利用可能な統計やヒューリスティックを使って基数を推定します。 統計が存在する場合は、通常、統計ヒストグラムの All Density 値 ( 平均密度とも呼ばれます) を使用して、述語に一致する行数を推定します。 しかし、列で使用可能な統計量がない場合、データベース エンジン はヒューリスティックな推定値にフォールバックし、たとえば等号述語に対しては 10% の選択性、不等式や範囲に対しては 30% を仮定します。 これらの見積もりは実行計画の精度を損なう可能性があります。 ローカル変数を使用するクエリの例を次に示します。
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
この場合、データベース エンジンはクエリの最適化に100の値を使いません。 一般的な見積もりを使用します。
並列クエリ処理
データベース エンジンは、複数のマイクロプロセッサ(CPU)を持つコンピュータ向けにクエリ実行およびインデックス操作を最適化するための並列クエリを提供します。 データベース エンジンは複数のオペレーティングシステムのワーカースレッドを使いながらクエリやインデックス操作を並列に実行できるため、操作は迅速かつ効率的に完了します。
クエリ最適化の際、データベース エンジンは並列実行が有益になりそうなクエリやインデックス操作を探します。 これらのクエリに対して、データベース エンジンはクエリ実行計画に交換オペレーターを挿入し、並列実行の準備を行います。 交換操作とは、プロセス管理、データの再配布、およびフロー制御を行うクエリ実行プラン内の操作です。 交換演算子にはDistribute Streams、Repartition Streams、およびGather Streamsなどの論理演算子がサブタイプとして含まれており、これらは並列クエリの実行計画のShowplan出力に現れることがあります。
重要
特定の構文要素は、データベース エンジンが実行計画全体または実行計画の一部に対して並列処理を使用する能力を妨げます。
並列処理を妨げる構造は次のとおりです。
| 構造体 | 説明 |
|---|---|
| スカラーUDF | スカラーユーザー定義関数の詳細については、「 ユーザー定義関数の作成」をご覧ください。 SQL Server 2019(15.x)以降、SQL Server データベース エンジンはこれらの関数をインライン化し、クエリ処理中に並列処理を使用できるようになりました。 スカラーUDFインライン化の詳細については、「 SQLデータベースにおけるインテリジェントクエリ処理」を参照してください。 |
| リモート クエリ | リモート クエリの詳細については、論理および物理ショープラン演算子リファレンスをご覧ください。 |
| 動的カーソル | カーソルの詳細については、「DECLARE CURSOR」をご覧ください。 |
| 再帰クエリ | 再帰についての詳細は、再帰的共通テーブル式の定義と使用に関するガイドラインおよびT-SQL における再帰をご覧ください。 |
| 複数ステートメント テーブル値関数 (MSTVF) | MSTVFの詳細については、「ユーザー定義関数の作成(データベース エンジン)」をご覧ください。 |
TOP キーワード |
詳細については、「TOP」を参照してください。 |
クエリ実行プランでは、並列処理が使用されなかった理由を説明する NonParallelPlanReason 属性が QueryPlan 要素に含まれる場合があります。 この属性の値は次のとおりです。
| NonParallelPlanReason の値 | 説明 |
|---|---|
MaxDOPSetToOne |
最大並列度は 1に設定されています。 |
EstimatedDOPIsOne |
推定並列度は 1です。 |
NoParallelWithRemoteQuery |
並列処理はリモート クエリではサポートされていません。 |
NoParallelDynamicCursor |
並列プランは動的カーソルではサポートされていません。 |
NoParallelFastForwardCursor |
並列プランは高速順方向カーソルではサポートされていません。 |
NoParallelCursorFetchByBookmark |
ブックマークによってフェッチされるカーソルに対しては、並列プランはサポートされていません。 |
NoParallelCreateIndexInNonEnterpriseEdition |
並列インデックスの作成は Enterprise 以外のエディションではサポートされていません。 |
NoParallelPlansInDesktopOrExpressEdition |
並列プランは Desktop および Express エディションではサポートされていません。 |
NonParallelizableIntrinsicFunction |
クエリは並列化できない組み込み関数を参照しています。 |
CLRUserDefinedFunctionRequiresDataAccess |
データ アクセスを必要とする CLR UDF の場合、並列処理はサポートされていません。 |
TSQLUserDefinedFunctionsNotParallelizable |
クエリは並列化できない T-SQL ユーザー定義関数を参照しています。 |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
テーブル変数トランザクションは入れ子になった並列トランザクションをサポートしていません。 |
DMLQueryReturnsOutputToClient |
DML クエリからクライアントに出力が返されます。また、並列化できません。 |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
1 つのオンライン インデックス ビルドにサポートされていない直列プランと並列プランが混在しています。 |
CouldNotGenerateValidParallelPlan |
並列プランの検証に失敗したため、シリアルにフォールバックします。 |
NoParallelForMemoryOptimizedTables |
参照されるインメモリ OLTP テーブルでは並列処理はサポートされていません。 |
NoParallelForDmlOnMemoryOptimizedTable |
インメモリ OLTP テーブル上の DML では並列処理はサポートされていません。 |
NoParallelForNativelyCompiledModule |
参照されているネイティブ コンパイル モジュールでは並列処理はサポートされていません。 |
NoRangesResumableCreate |
再開可能な作成操作の範囲の生成に失敗しました。 |
交換操作を挿入すると、並列クエリの実行プランになります。 並列クエリの実行プランでは複数のワーカー スレッドを使用できます。 並列でない (直列) クエリで使用する直列の実行プランの場合、実行時に使用するワーカー スレッドは 1 つのみです。 並列クエリで使用される実際のワーカースレッド数は、クエリプラン実行の初期化時に決定され、計画の複雑さや並列度に依存します。
並列度(DOP)は、並列タスクを実行するために使用できる最大プロセッサ数を指定します。 DOPはクエリで使われるワーカースレッドの総数を示しません。 DOP の制限は、タスクごとに設定されます。 この設定は、要求ごとまたはクエリ制限ごとではありません。 つまり、並列クエリ実行中に、1 つの要求で、スケジューラに割り当てられてた複数のタスクを生成することができます。 異なるタスクが同時に実行される場合、 MAXDOP で指定されたより多くのプロセッサがクエリ実行の任意の時点で同時に使用されることがあります。 詳細については、「スレッドとタスクのアーキテクチャ ガイド」を参照してください。
クエリオプティマイザーは、以下のいずれかの条件が当てはまる場合、クエリに対して並列実行計画を使用しません。
シリアル実行計画は単純であるか、並列処理のコスト閾値を超えません。
直列実行プランの推定サブツリー コストの合計は、オプティマイザーによって探索されたどの並列実行プランよりも低くなります。
クエリに、並列では実行できないスカラー演算子または関係演算子が含まれる場合。 演算子によっては、クエリ プランのセクションまたはプラン全体が直列モードで実行される場合があります。
注
並列プランの推定サブツリー コストの合計は、並列処理設定のコストしきい値より低い場合があります。 つまり、シリアル プランの推定サブツリー コストがそれを超えたため、推定サブツリー コストの低いクエリ プランが選ばれました。
並列処理の次数 (DOP)
データベース エンジンは、並列クエリ実行またはインデックスデータ定義言語(DDL)操作の各インスタンスに対して最適な並列度を自動検出します。 この値は以下の基準に基づいて決定されます。
SQL Server が、SMP (対称型マルチプロセッシング) コンピューターなど、複数のマイクロプロセッサまたは CPU を搭載したコンピューターで実行されているかどうか。 並列クエリを使用できるのは、複数の CPU を搭載したコンピューターだけです。
十分な数のワーカー スレッドを使用できるかどうか。 各クエリまたはインデックス操作では、一定数のワーカー スレッドを実行する必要があります。 並列プランの実行には直列プランの場合よりも多くのワーカー スレッドが必要になり、必要なワーカー スレッド数は並列処理の次数が高くなるほど増加します。 並列計画の特定の並列度に対するワーカースレッド要件を満たせない場合、SQL Server データベース エンジンは自動的に並列度を下げるか、並列プランを直列的に実行します。
実行するクエリまたはインデックス操作の種類。 インデックスの作成や再構築またはクラスター化インデックスの削除を行うインデックス操作、および CPU サイクルを大量に使用するクエリは並列プランの候補として最適です。 たとえば、大きなテーブルの結合、大量の集計、および大きな結果セットの並べ替えは候補として適しています。 トランザクション処理アプリケーションでよく見られる基本的なクエリでは、クエリを並列実行するために必要な追加の調整が、潜在的なパフォーマンス向上を上回ることがよくあります。 並列処理の利点を得られるクエリとそうでないクエリを区別するために、SQL Server データベース エンジンは cost threshold for parallelism 値を使用して、クエリまたはインデックス操作を実行するための推定コストを比較します。 適切なテストで動作中のワークロードにより適した値が見つかった場合、ユーザーは
5を使ってのデフォルト値を変更できます。処理する十分な数の行があるかどうか。 クエリ オプティマイザーによって行数が少なすぎると判断されると、行を分散するための交換操作は導入されません。 したがって、操作は直列に実行されます。 直列プランで操作を実行すると、並列操作を実行したときに得られる効果より、起動、分散、および調整のコストの方が上回る事態を回避することができます。
現在の統計を利用できるかどうか。 並列処理の最高次数が不可能な場合、並列プランが放棄される前に、それより低い次数が検討されます。 例えば、ビューにクラスタインデックスを作成する際、クラスタインデックスがまだ存在しないため統計情報は評価できません。 この場合、SQL Server データベース エンジンでは、インデックス操作用に並列処理の最高次数を提供できません。 ただし、並べ替えやスキャンなどの一部の操作では、それまでどおり並列実行の利点を得ることができます。
注
並列インデックス操作は、SQL Server Enterprise Edition、Developer Edition、および Evaluation Edition でのみ使用できます。
既に説明したような現在のシステムのワークロードと構成情報で並列実行が可能かどうかは、実行時に SQL Server データベース エンジンによって判断されます。 並列実行の条件を満たしている場合、SQL Server データベース エンジンにより、最適なワーカー スレッド数が判断され、これらのワーカー スレッド全体に並列プランの実行が分散されます。 複数のワーカー スレッドでクエリまたはインデックス操作が並列実行で開始された後は、操作で使用されるワーカー スレッド数は操作の完了時まで変化しません。 SQL Server データベース エンジンは、プラン キャッシュから実行プランを取得するたびに、最適なワーカー スレッド数を再調査して決定します。 例えば、キャッシュされた並列計画の1回の実行は直列実行が可能で、同じ計画の後の実行では3つのワーカースレッドを使い、3回目の実行では4つのワーカースレッドを使えます。
並列クエリ実行プランの更新および削除演算子は直列に実行されますが、WHERE または UPDATE ステートメントの DELETE 句は並列に実行される場合があります。 実際のデータ変更は、データベースに直列に適用されます。
データベース互換性レベル110からは、SELECT ... INTO 文は並列実行できます。 他の種類のインサートオペレーターも、以前のバージョンで説明された通りに動作します。
データベース互換性レベル130から、ヒープやクラスタ化されたカラムストアインデックス(CCI)に挿入し、INSERT ... SELECTヒントを使う際にTABLOCK文を並列に実行できます。 ローカルの一時テーブル( # プレフィックスで識別)やグローバル一時テーブル( ## プレフィックスで識別)への挿入も、 TABLOCK ヒントを用いて並列処理が可能です。 詳細については、INSERTを参照してください。
静的カーソルとキーセット ドリブン カーソルは、並列実行プランによって作成できます。 ただし、動的カーソルの動作は、直列実行の場合だけ有効です。 クエリ オプティマイザーは、動的カーソルの一部であるクエリに対しては必ず直列実行プランを生成します。
並列処理の次数をオーバーライドする
並列プランの実行で使用するプロセッサの数は、並列処理の次数によって設定されます。 この構成は様々なレベルで設定できます:
サーバーレベルでは、最大並列度(
MAXDOP)サーバー構成オプションを使用して。適用対象: SQL Server
SQL Server 2019 (15.x) では、インストール プロセス中に
MAXDOPサーバー構成オプションの設定に関する推奨事項が自動的に提示されるようになりました。 セットアップのユーザー インターフェイスでは、推奨設定を受け入れることも、独自の値を入力することもできます。 詳細については、「[データベース エンジンの構成] - [MAXDOP] ページ」を参照してください。MAX_DOPResource Governorワークロードグループ設定オプションを使った、ワークロード レベル。適用対象: SQL Server
データベース レベルでは、
MAXDOPデータベース スコープ構成を使用します。適用対象:SQL Server、Azure SQL Database、およびAzure SQL Managed Instance
クエリまたはインデックス ステートメント レベル。
MAXDOPquery hint またはMAXDOPインデックス オプションを使用 例えば、MAXDOPオプションを使って、オンラインインデックス操作に割り当てられるプロセッサの数を増減させることで制御できます。 このようにして、インデックス操作で使われるリソースと同時利用者のリソースのバランスを取ることができます。適用対象:SQL Server、Azure SQL Database、およびAzure SQL Managed Instance
max degree of parallelismオプションを0(デフォルト)に設定すると、データベース エンジンは最大64個までの利用可能なすべてのプロセッサを並列プラン実行で使用できます。 データベース エンジンはMAXDOPオプションが0に設定されたときに64の論理プロセッサの実行目標を設定しますが、必要に応じて手動で別の値を設定することも可能です。 クエリやインデックスに対してMAXDOPを0に設定すると、データベース エンジンは並列プラン実行において、与えられたクエリやインデックスに対して利用可能なすべてのプロセッサを最大 64 個まで使用できます。
MAXDOP はすべての並列クエリに強制される値ではなく、並列処理の対象となるすべてのクエリに対する暫定的なターゲットです。 つまり、実行時に十分なワーカースレッドが利用できない場合、クエリは MAXDOP サーバー設定オプションで指定された並列度よりも低いまま実行されることがあります。
並列クエリの例
以下のクエリは、2024年4月1日から始まる特定の四半期に行われた注文の数を数え、その注文の少なくとも1つの明細項目が確約日より遅れて顧客に届いたものを対象とします。 このクエリは、注文を注文優先度ごとにグループ化し、優先度の昇順に並べ替えて、各優先度ごとに注文数を示します。
この例には、架空のテーブル名と列名を使用しています。
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
lineitem テーブルと orders テーブルで次のインデックスが定義されていると想定します。
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
上記のクエリに対して生成される並列プランの例を次に示します。
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
以下の図は、並列度が 4 に等しいクエリ計画を示し、2テーブル結合を含みます。
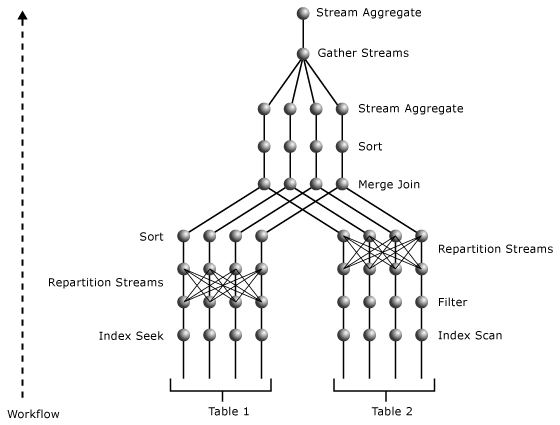
並列プランには、3 つの並列処理操作が含まれています。
o_datkey_ptr インデックスの Index Seek 操作と l_order_dates_idx インデックスの Index Scan 操作が並列で実行されます。 この過程では、インデックススキャンおよびインデックスシーク演算子上の最も近い並列性演算子からそれぞれ特定できる個別のストリームが生成されます。 両演算子は Exchange の種類を再パーティション化しています。 ストリーム間でデータをシャッフルし、出力上でも入力と同じ数のストリームを生成します。 このストリーム数は並列処理の次数と同じになります。
l_order_dates_idxインデックススキャン演算子の上にある並列演算子は、L_ORDERKEYの値をキーとして入力ストリームを再分割します。 このようにして、同じ L_ORDERKEY の値が同じ出力ストリームで終了します。 同時に、出力ストリームは L_ORDERKEY 列の順序を維持し、Merge Join 操作の入力要件を満たします。
インデックスシーク演算子の上の並列演算子は、 O_ORDERKEYの値を用いて入力ストリームを再分割します。 入力は O_ORDERKEY 列の値でソートされておらず、この列が Merge Join 演算子の結合列であるため、並列操作とマージジョイン演算子の間のソート演算子は、結合列の Merge Join 演算子に対して入力がソートされていることを確認します。
Sort 操作は、Merge Join 操作と同様に並列処理されます。
最上位にある並列操作は、複数のストリームから得た結果を 1 つのストリームに集めます。 この並列操作の下位にある Stream Aggregate 操作で実行された部分集計は、並列操作の上位にある Stream Aggregate 操作の SUM の異なる値ごとに 1 つの O_ORDERPRIORITY 値に累計されます。 このプランは2つの交換セグメントを持ち、並列度は 4であるため、8本のワーカースレッドを使用します。
この例で使用されている演算子の詳細については、「論理的および物理的ショープラン演算子リファレンス」を参照してください。
並列インデックス操作
インデックスを作成または再構築したり、クラスタ化されたインデックスをドロップしたりするインデックス操作のクエリプランは、複数のプロセッサを持つコンピュータ上で並列かつマルチスレッドの操作をサポートできます。
注
並列インデックス操作はエンタープライズ版でのみ利用可能です。
データベース エンジンは、他のクエリと同様に、インデックス操作の並列度(実行すべきワーカースレッドの総数)を決定するアルゴリズムを用いています。
max degree of parallelism サーバー構成オプションは、インデックス操作の最大並列度を設定します。 個々のインデックス操作の max degree of parallelism 値は、ALTER INDEX、DROP INDEX、ALTER TABLE、MAXDOP 文で CREATE INDEX インデックスオプションを設定することで上書きできます。
SQL Server データベース エンジンがインデックス実行計画を構築する際、並列操作の数は以下の中から最も小さい値に設定されます:
- コンピュータ内のプロセッサ、つまりCPUの数。
-
max degree of parallelismサーバー設定オプションで指定された番号 - SQL Server ワーカー スレッドの処理負荷のしきい値をまだ超えていない CPU の数です。
例えば、8つのCPUを持つコンピュータで max degree of parallelism が 6に設定されている場合、インデックス操作は最大6つの並列ワーカースレッドしか使用しません。 インデックス実行プランを構築するとき、コンピューター内の 5 基の CPU が SQL Server のワークのしきい値を超えている場合は、実行プランによって指定される並列ワーカー スレッドの数は 3 つだけになります。
並列インデックス操作の主な段階には以下が含まれます:
- 調整ワーカー スレッドがテーブルを迅速かつランダムにスキャンし、インデックス キーの分布を算出します。 調整役のワーカースレッドは、並列操作の度合いに等しい数のキー範囲を作成するキー境界を設定します。各キー範囲はほぼ同じ数の行をカバーすると推定されます。 例えば、テーブルに400万行があり、並列度が4の場合、調整ワーカースレッドは各セットに100万行ずつ含まれる4組の行セットを区切るキー値を決定します。 もし協調するワーカースレッドがすべてのCPUを使える十分なキーレンジを確立できなければ、それに応じて並列度を下げます。
- 調整ワーカー スレッドは、並列操作の限度と等しい数のワーカー スレッドを優先して、それらのワーカー スレッドの作業が完了するまで待ちます。 各ワーカー スレッドは、ワーカー スレッドに割り当てられた範囲内のキー値を持つ行だけを取得するフィルターを使用して、ベース テーブルをスキャンします。 各ワーカー スレッドは、そのキーの範囲内で行のインデックス構造を構築します。 パーティション インデックスの場合、各ワーカー スレッドで指定した数のパーティションが構築されます。 パーティションはワーカー スレッド間では共有されません。
- すべての並列ワーカー スレッドが完了した後、コーディネーター ワーカー スレッドはインデックス サブユニットを単一のインデックスに結合します。 このフェーズは、オフライン インデックス操作にのみ適用されます。
個々の CREATE TABLE 文や ALTER TABLE 文は複数の制約を持ち、インデックス作成が必要です。 これらの複数のインデックス作成操作は連続して実行されますが、個別のインデックス作成操作は複数の CPU を備えたコンピューターでは並列操作になることがあります。
分散クエリ アーキテクチャ
データベース エンジンは、T-SQL文で異種なOLE DBデータソースを参照するための2つの方法をサポートしています:
リンクサーバー名
システムのストアドプロシージャ
sp_addlinkedserverとsp_addlinkedsrvloginを使って、OLE DBのデータソースにサーバー名を割り当てます。 これらのリンク サーバー内のオブジェクトは、4 部構成名を使用して T-SQL ステートメントで参照できます。 たとえば、DeptSQLSrvrというリンク サーバー名が SQL Server の別のインスタンスで定義されている場合、次のステートメントはこのサーバー上のテーブルを参照します。SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;また、OLE DBのデータソースから行セットを開くために、リンクされたサーバー名を
OPENQUERY文で指定することもできます。 その後、この行セットをT-SQL文のテーブルのように参照できます。アドホック コネクタ名
データソースへのまれな参照については、リンクされたサーバーに接続するために必要な情報を含む
OPENROWSETまたはOPENDATASOURCE関数を指定します。 その後、T-SQL文でテーブルを参照するのと同じ方法で行セットを参照できます:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
データベース エンジンは、リレーショナルエンジンとストレージエンジン間でOLE DBを使用して通信します。 リレーショナルエンジンは、各 T-SQL 文を、ストレージエンジンがベーステーブルから開く基本的な OLE DB 行セット上の一連の操作に分解します。 このプロセスにより、リレーショナルエンジンは任意のOLE DBデータソース上で基本的なOLE DB行セットを開くことも可能です。
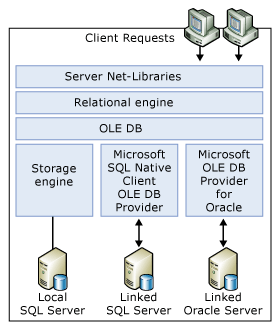
リレーショナル エンジンは OLE DB API (アプリケーション プログラミング インターフェイス) を使用して、リンク サーバー上の行セットを開き、行をフェッチし、トランザクションを管理します。
リンクサーバーとしてアクセスする各OLE DBデータソースに対して、SQL Serverを実行しているサーバーはOLE DBプロバイダーを持っている必要があります。 特定のOLE DBデータソースに対して使用できるT-SQL操作のセットは、OLE DBプロバイダーの能力に依存します。
各 SQL Server インスタンスに対して、sysadmin 固定サーバー ロールのメンバーは、SQL Server DisallowAdhocAccess プロパティを使用して、OLE DB プロバイダーのアドホック アクセス名の使用を有効または無効にできます。 アドホックアクセスを有効にすると、そのインスタンスにログインした任意のユーザーは、OLE DBプロバイダーがアクセス可能なネットワーク上の任意のデータソースを参照するアドホックコネクタ名を含むT-SQL文を実行できます。 データ ソースへのアクセスを制御するために、sysadmin 固定サーバー ロールのメンバーは、その OLE DB プロバイダーのアドホック アクセスを無効にし、管理者が定義したリンク サーバー名で参照されるデータ ソースのみにユーザーを制限できます。 既定では、SQL Server OLE DB プロバイダーではアドホック アクセスが有効化されており、他のすべての OLE DB プロバイダーでは無効化されています。
分散クエリは、SQL Serverサービスが動作するWindowsアカウントのセキュリティコンテキストを利用して、ユーザーが他のデータソース(例:ファイルやActive Directoryなどの非リレーショナルデータソースなど)にアクセスすることを可能にします。 SQL ServerはWindowsログインに対して適切にログインを借用します。 しかし、SQL Serverログインではそのなりすましはできません。 この制限により、分散クエリユーザーが権限がない別のデータソースにアクセスする可能性がありますが、SQL Serverサービスが動作するアカウントには権限はあります。 対応するリンク サーバーにアクセスする権限のある特定のログインを定義するには、 sp_addlinkedsrvlogin を使用します。 このコントロールはアドホック名では使用できないため、OLE DBプロバイダーをアドホックアクセス用に有効にする際は注意してください。
可能な限り、データベース エンジンは結合、制限、投影、ソート、グループ別操作などのリレーショナル操作をOLE DBのデータソースにプッシュします。 データベース エンジン では、ベース テーブルを SQL Server に取り込んでスキャンし、リレーショナル操作自体を実行することが既定の動作ではありません。 データベース エンジンはOLE DBプロバイダーにクエリし、サポートされているSQL文法のレベルを判定し、その情報に基づいてできるだけ多くのリレーショナル操作をプロバイダーにプッシュします。
データベース エンジンは、OLE DBプロバイダーがOLE DBデータソース内でキーの分布状況を示す統計を返す仕組みを規定しています。 この仕組みにより、データベース エンジン Query Optimizerは各T-SQL文の要件に照らしてデータソース内のデータパターンをより正確に分析でき、最適な実行計画を生成する能力が向上します。
パーティションテーブルおよびインデックスでのクエリ処理
データベース エンジンは、パーティション分割されたテーブルやインデックスに対してパーティション認識型クエリ処理をサポートしています。 このセクションでは、クエリプロセッサがパーティション化されたオブジェクトをどのように扱うか、パーティション化を含む実行計画の解釈方法、パーティション化されたオブジェクト上のクエリ性能向上のベストプラクティスについて説明します。
注
パーティション分割されたテーブルとインデックスは、SQL Server 2016(13.x)のサービスパック1からSQL Server Standard版でサポートされています。
新しいパーティション対応のシーク操作
データベース エンジンでは、クエリプロセッサは内部的にパーティション テーブルを PartitionID を先頭列とする多列インデックスとして認識します。
PartitionID は、特定の行を含むパーティションの ID を表すために内部的に使用される非表示の計算列です。 例えば、テーブル Tが T(a, b, c)として定義され、列 aでパーティション分割され、列 bにクラスタ化されたインデックスがあると仮定します。 このパーティションテーブルは、スキーマ T(PartitionID, a, b, c) と複合キー (PartitionID, b)上のクラスタインデックスを持つ非パーティションテーブルとして扱われます。 この表現により、クエリ オプティマイザは任意のパーティション化されたテーブルやインデックスの PartitionID に基づいてシーク操作を行うことが可能になります。
シーク操作において、パーティション削除が実施されるようになりました。
さらに、クエリオプティマイザは拡張され、PartitionID(論理先頭列として)および場合によっては他のインデックスキー列に対して、1つの条件によるシークまたはスキャン操作を実行できるようになっています。 クエリプロセッサは、異なる条件で、1つ以上の追加カラムに対して第2レベルのシークを行います。これは、第1レベルのシーク操作の条件を満たす各異なる値に対してです。 この操作は パーティションスキップスキャンと呼ばれ、クエリオプティマイザーが1つの条件に基づいてシークまたはスキャン操作を行い、アクセスすべきパーティションを特定し、その演算子内で異なる条件を満たす行を返す第2レベルのインデックスシーク操作を可能にします。 たとえば、次のクエリについて考えてみます。
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
この例では、表 T は T(a, b, c) として定義され、列 a でパーティション分割され、列 b にクラスター化インデックスがあると仮定します。 次の分割関数は、表 Tの分割境界を定義しています:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
クエリを解決するために、クエリ プロセッサによって最初のレベルのシーク操作が実行され、条件 T.a < 10を満たす行を含むすべてのパーティションが検索されます。 この操作はアクセスすべきパーティションを特定します。 各パーティション内で、プロセッサは列 b のクラスタインデックスに第2レベルのシークを行い、条件 T.b = 2 と T.a < 10を満たす行を探します。
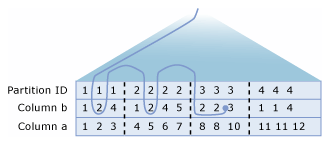
以下の図は分割スキップスキャン操作の論理的な表現です。 列 T および a にデータが格納されているテーブル b を示しています。 パーティションには 1 ~ 4 の番号が割り当てられており、パーティション境界は破線の縦線で表示されています。 分割に対する第一レベルのシーク演算 (図には示されていない) により、パーティション 1、2、3 が、テーブルに対して定義されたパーティション分割と列 a 上の述語(T.a < 10)によって暗黙的に示されるシーク条件を満たすことが判定されます。 第二レベルのシークが通過する経路は曲線で示されています。 本質的には、この操作は条件 b = 2を満たす行をこれらの各パーティションで探します。 この操作の総コストは、3つの別々のインデックスシークのコストと同じです。
クエリ実行プランのパーティション分割情報を表示する
分割されたテーブルやインデックスに対するクエリの実行計画は、T-SQLの SET 文 SET SHOWPLAN_XML または SET STATISTICS XML、またはSSMSのグラフィカル実行計画出力を使って確認できます。 例えば、クエリ エディター のツール バーで Display Estimated Execution Plan を選択するとコンパイル時の実行プランを表示でき、Include Actual Execution Plan を選択すると実行時の実行プランを表示できます。
これらのツールを使うことで、以下の情報を見つけることができます。
- パーティション化されたテーブルやインデックスにアクセスする、スキャン、シーク、挿入、更新、マージ、削除などの操作
- クエリによってアクセスされるパーティション。 例えば、実行時の実行計画には、アクセスされたパーティションの総数とアクセスされる連続したパーティションの範囲が含まれます。
- シーク操作またはスキャン操作で、1 つ以上のパーティションからデータを取得するためにパーティション スキップ スキャン操作が使用される場合。
パーティション情報に関する機能強化
データベース エンジンは、コンパイル時および実行時の実行計画の両方に対して強化されたパーティショニング情報を提供します。 実行プランで次の情報が示されるようになりました。
- シーク、スキャン、挿入、更新、マージ、削除などの演算子がパーティションテーブル上で実行されることを示すオプションの
Partitioned属性です。 - 新しい
SeekPredicateNew要素には、SeekKeysサブ要素があり、先頭のインデックス キー列としてPartitionIDを含み、PartitionIDに対して範囲シークを指定するフィルター条件が含まれています。 2つのSeekKeys部分要素が存在することは、PartitionIDでの分割スキップスキャンを示しています。 - アクセスされるパーティションの総数を示す概要情報。 この情報は、実行時のプランでのみ確認できます。
この情報をグラフィカル実行プラン出力と XML プラン表示出力の両方で表示する方法の説明のために、パーティション テーブル fact_salesに対する次のクエリについて考えます。 このクエリでは、2 つのパーティションのデータが更新されます。
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
次の図は、このクエリの実行時の実行プランにおける Clustered Index Seek 操作のプロパティを示しています。
fact_salesテーブルの定義と分割定義を見るには、例を参照してください。

分割された属性
Index Seek などの操作がパーティション テーブルまたはインデックスに対して実行される場合、コンパイル時および実行時のプランに Partitioned 属性が表示され、True (1) に設定されます。 属性は False (0)に設定されていると表示されません。
Partitioned 属性は、次の物理操作と論理操作で表示されます。
- テーブル スキャン
- インデックス スキャン
- インデックス検索
- 挿入
- 更新
- 削除
- 結合する
前の図に示されているように、この属性はその属性が定義されている演算子のプロパティに表示されます。 XML Showplanの出力では、この属性は、その属性が定義されている演算子のPartitioned="1"ノード内で RelOp として表示されます。
新しい検索述語
XML Showplanの出力では、SeekPredicateNew 要素はその要素が定義されている演算子に表示されます。 この要素には、SeekKeys サブ要素が最大 2 つ含まれることがあります。 最初の SeekKeys アイテムは、論理インデックスのパーティション ID レベルで最初のレベルのシーク操作を指定します。 つまり、このシーク操作はクエリの条件を満たすためにアクセスすべきパーティションを決定します。 2番目の SeekKeys 項目は、第1レベルのシークで特定された各パーティション内で発生する第2レベルのシークを指定します。
パーティションの概要情報
実行時の実行プランでは、パーティションの概要情報に、アクセスしたパーティションの数やアクセスした実際のパーティションの ID が示されます。 この情報を使用して、クエリで正しいパーティションにアクセスしているかどうか、および他のすべてのパーティションが考慮の対象から除外されているかどうかを確認できます。
示される情報は、 Actual Partition Countと Partitions Accessedです。
Actual Partition Count は、クエリでアクセスされるパーティションの総数です。
Partitions Accessed は、XML Showplan 出力では、その演算子の RelOp ノード内の新しい RuntimePartitionSummary 要素に表示されるパーティション サマリー情報です。 次の例に、合計 2 つのパーティション (パーティション 2 および 3) にアクセスすることを示す RuntimePartitionSummary 要素の内容を示します。
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
他のショープラン方式を用いてパーティション情報を表示
SHOWPLAN_ALL、SHOWPLAN_TEXT、STATISTICS PROFILE の Showplan メソッドでは、この記事で説明したパーティション情報はレポートされません。ただし、以下の例外があります。 ただし、例外として、アクセスされるパーティションが、 SEEK 述語の一部としてパーティション ID を表す計算列の範囲述語によって特定されます。 次の例に、 SEEK 演算子の Clustered Index Seek 述語を示します。 パーティション 2 および 3 にアクセスし、シーク オペレーターによって条件 date_id BETWEEN 20190802 AND 20190902を満たす行がフィルター選択されます。
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
パーティション分割されたヒープの実行プランを解釈する
パーティション化されたヒープは、パーティションIDを基にした論理インデックスとして扱われます。 実行計画において、分割ヒープ上の分割消去は、パーティションIDに対するTable Scan述語を伴うSEEK演算子として表現されます。 次の例は、Showplan により提供される情報を示しています。
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
併置結合の実行プランを解釈する
結合のコロケーションは、同じパーティション関数または同等のパーティション関数を使用して 2 つのテーブルをパーティション分割し、結合の両側のパーティション列をクエリの結合条件に指定すると発生します。 クエリ オプティマイザーでは、同じパーティション ID を持つ各テーブルのパーティションが個別に結合されるプランを生成できます。 併置結合では必要なメモリが少なくなり、処理時間が短縮されることがあるので、この結合は非併置結合よりも処理が高速になる場合があります。 クエリ オプティマイザーでは、コストの推定に基づいて、非併置プランまたは併置プランが選択されます。
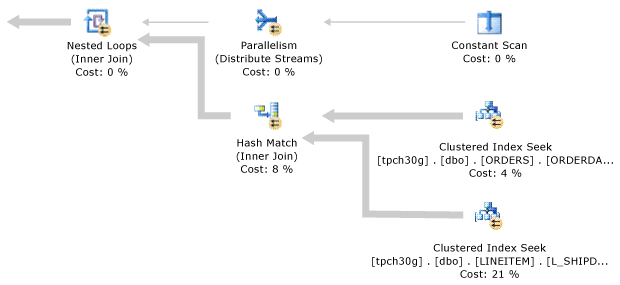
併置プランでは、 Nested Loops 結合は内側の 1 つ以上の結合テーブルまたはインデックス パーティションを読み取ります。
Constant Scan 操作内の数値は、パーティション番号を表します。
パーティション テーブルまたはパーティション インデックスに対して併置結合の並行プランが生成された場合、結合操作 Constant Scan と Nested Loops の間に Parallelism 操作が表れます。 その場合、結合外部にある複数のワーカー スレッドがそれぞれ異なるパーティションに対して読み取りや操作を行います。
次の図は、併置結合の並列クエリ プランを示しています。
パーティション分割されたオブジェクトの並列クエリの実行戦略
クエリ プロセッサは、パーティション分割されたオブジェクトから選択するクエリに対して並列実行を使用します。 クエリ プロセッサでは、実行戦略の一環として、クエリに必要なテーブル パーティションと、各パーティションに割り当てるワーカー スレッドの数を決定します。 ほとんどの場合、クエリ プロセッサは、各パーティションに同数またはほぼ同数のワーカー スレッドを割り当て、パーティション全体でクエリを並列実行します。 以降、ワーカー スレッドの割り当てについてさらに詳しく説明します。
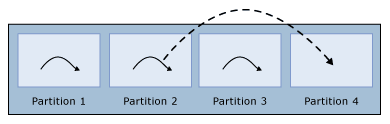
ワーカー スレッドの数がパーティションの数よりも少ない場合、クエリ プロセッサが各ワーカー スレッドを別々のパーティションに割り当てると、最初に、ワーカー スレッドが割り当てられていないパーティションが 1 つ以上残ります。 ワーカースレッドがパーティション上で実行を終えると、クエリプロセッサはそのスレッドを次のパーティションに割り当て、各パーティションに単一のワーカースレッドが割り当てられるまで続きます。 この割り当ては、クエリプロセッサがワーカースレッドを他のパーティションに再割り当てする唯一のケースです。
終了後に再割り当てが行われたワーカー スレッドを示します。 ワーカー スレッドの数とパーティションの数が同じ場合、クエリ プロセッサは各パーティションに 1 つのワーカー スレッドを割り当てます。 ワーカー スレッドの終了時に、そのワーカー スレッドが別のパーティションに再割り当てされることはありません。
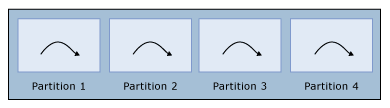
ワーカー スレッドの数がパーティションの数よりも多い場合、クエリ プロセッサは各パーティションに同じ数のワーカー スレッドを割り当てます。 ワーカースレッドの数がパーティション数の正確な倍数でない場合、クエリプロセッサは利用可能なすべてのワーカースレッドを使うために、いくつかのパーティションに1つの追加のワーカースレッドを割り当てます。 パーティションが1つだけの場合、すべてのワーカースレッドはそのパーティションに割り当てられます。 以下の図では、4つのパーティションと14のワーカースレッドがあります。 各パーティションには3つのワーカースレッドが割り当てられ、さらに2つのパーティションには追加のワーカースレッドが割り当てられており、合計で14のワーカースレッド割り当てがあります。 ワーカー スレッドは、終了時に別のパーティションに再割り当てされることはありません。
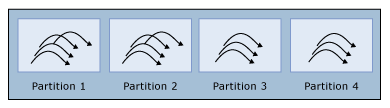
前述の例はワーカースレッドの割り当てを簡潔に示唆していますが、実際の戦略はより複雑で、クエリ実行中に発生する他の変数も考慮しています。 例えば、テーブルがパーティション分割されていて、列 A にクラスタ化されたインデックスがあり、クエリの述語節が WHERE A IN (13, 17, 25)の場合、クエリプロセッサは各テーブルパーティションではなく、これら3つのシーク値(A = 13、 A = 17、 A = 25)それぞれに1つ以上のワーカースレッドを割り当てます。 これらの値を含むパーティションでのみクエリを実行すればよく、これらのシーク述語がすべて同じテーブル パーティションにある場合、すべてのワーカー スレッドは同じテーブル パーティションに割り当てられます。
別の例を挙げると、テーブルの列 A に境界点(10, 20, 30)を持つ4つのパーティションがあり、列 Bにインデックスがあり、クエリに述語節 WHERE B IN (50, 100, 150)があるとします。 テーブルパーティションは Aの値に基づいているため、 B の値はどのテーブルパーティションにも存在し得ます。 したがって、クエリプロセッサは4つのテーブルパーティションそれぞれの3つの B (50、100、150) の値それぞれを探します。 クエリプロセッサは、これら12個のクエリ スキャンそれぞれを並列実行できるように、ワーカースレッドを比例的に割り当てます。
列に基づくテーブル パーティション A |
各テーブルパーティションの列 B を探します |
|---|---|
表パーティション1: A < 10 |
B = 50、 B = 100、 B = 150 |
表パーティション2: A >= 10 AND A < 20 |
B = 50、 B = 100、 B = 150 |
テーブル パーティション 3: A >= 20 AND A < 30 |
B = 50、 B = 100、 B = 150 |
表パーティション4: A >= 30 |
B = 50、 B = 100、 B = 150 |
ベスト プラクティス
大規模なパーティションテーブルやインデックスから大量のデータにアクセスするクエリのパフォーマンスを向上させるために、以下のベストプラクティスを遵守してください:
各パーティションを多くのディスクにわたってストライピングします。 この方法は特に回転式ディスクを使用する際に関連性があります。
可能な場合は、アクセス頻度の高いパーティションまたはすべてのパーティションを保持できる十分なメイン メモリがあるサーバーを使用して、I/O コストを軽減します。
もしクエリするデータがメモリに収まらない場合は、テーブルやインデックスを圧縮してI/Oコストを削減しましょう。
高速なプロセッサおよびできるだけ多くのプロセッサ コアを搭載したサーバーを使用して、並列クエリ処理機能を活用します。
サーバーに十分な I/O コントローラーの帯域幅があることを確認します。
すべての大きなパーティション テーブルにクラスター化インデックスを作成して、B ツリーのスキャンの最適化を活用します。
パーティションテーブルにデータを一括読み込む際は、ホワイトペーパー『 The Data Loading Performance Guide』のベストプラクティスの推奨事項に従ってください。
例
次の例では、7 つのパーティションを持つ 1 つのテーブルを含むテスト データベースを作成します。 コンパイル時計画と実行時計画の両方のパーティショニング情報を見るには、この例のクエリを実行する際に「クエリ実行計画でパーティショニング情報を表示する」で説明されているツールを使用してください。
注
この例では、100 万以上の行をテーブルに挿入します。 この例を実行すると、ハードウェアによっては数分かかる場合があります。 この例を実行する前に、1.5 GB を超えるディスク領域が確保されていることを確認してください。
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO