Profile data (プロファイル データ)
データをクレンジングまたは変換する前に、テーブルの内容を理解する必要があります。 プロファイリング データ とは、データセットを調べて、データの品質と構造を明らかにする集計統計 (カウント、平均、値の分布、null の割合) を生成することを意味します。 この基盤は、欠損値、外れ値、予期しないパターンなどの問題を特定し、ダウンストリームで問題を引き起こす前に特定するのに役立ちます。
このユニットでは、Azure Databricks で SQL コマンドとデータ プロファイル機能を使用して概要統計を生成する方法について説明します。
SQL を使用して概要統計を生成する
Azure Databricks には、テーブルに関する統計情報を収集して表示する SQL コマンドが用意されています。 これらの統計は、クエリ オプティマイザーが効率的な実行プランを選択し、データの特性に関する分析情報を提供するのに役立ちます。
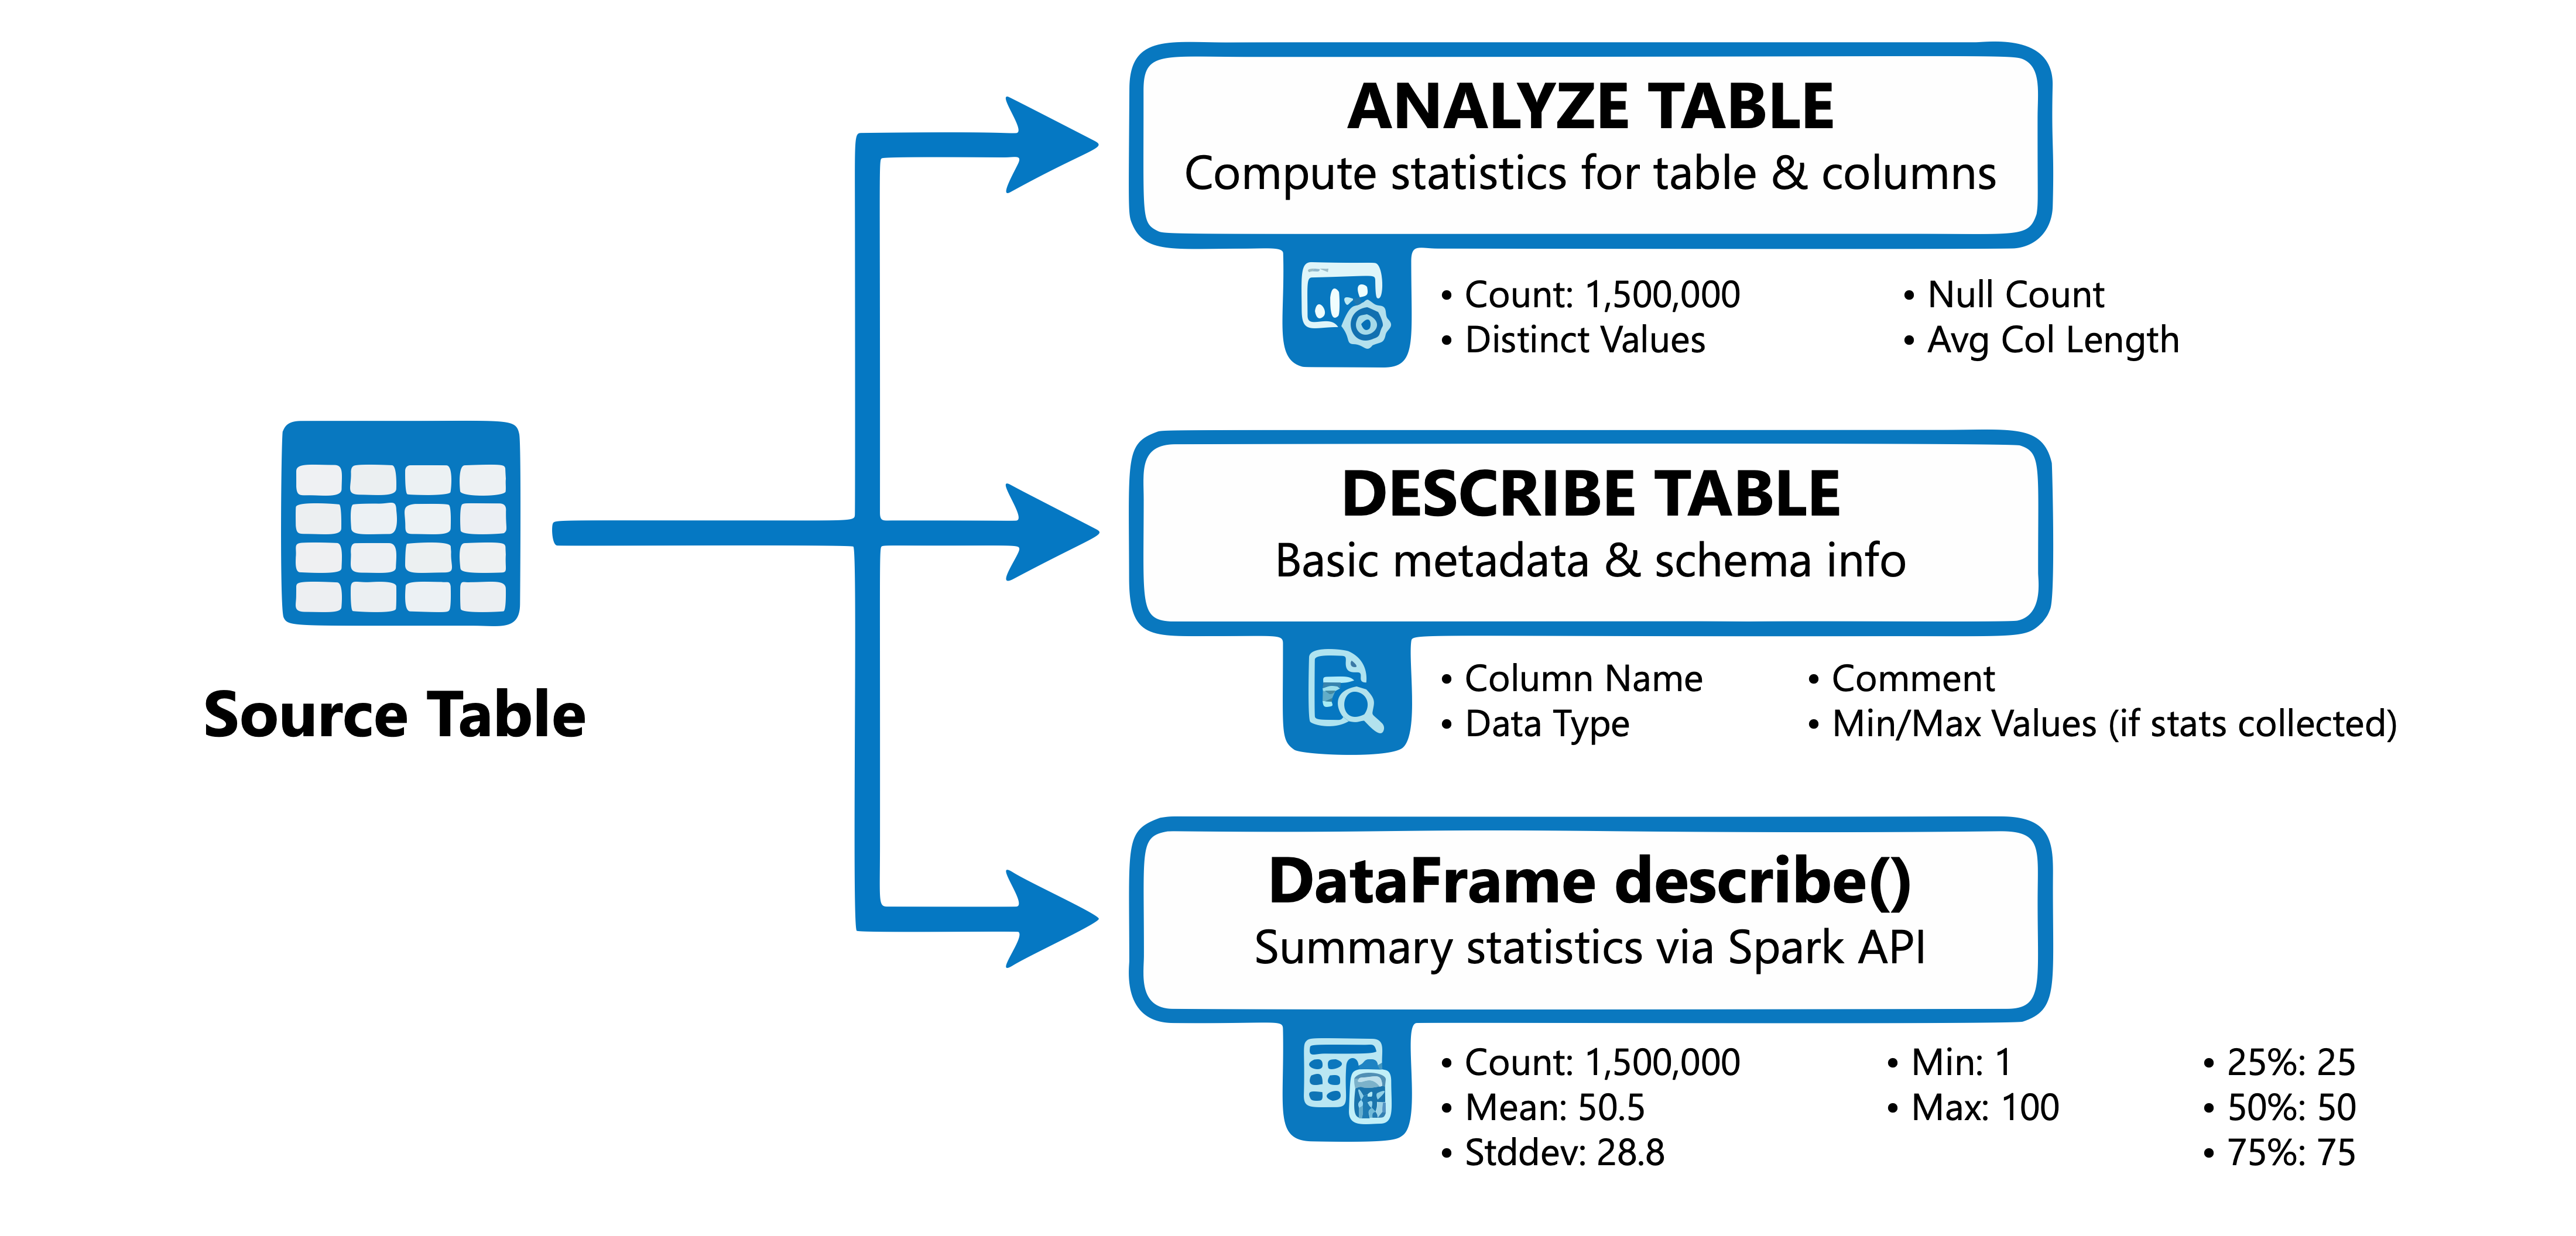
ANALYZE TABLE を使用して統計を収集する
ANALYZE TABLE コマンドは、テーブルまたは特定の列の統計を計算します。 これらの統計には、行数、最小値と最大値などの列レベルのメトリック、null カウント、個別の値カウントが含まれます。
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
特定の列を分析すると、詳細なメトリックが表示されます。
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
これにより、最小値、最大値、null の数、個別のカウント、平均列の長さ、列の最大長などのメトリックが返されます。
DESCRIBE TABLE を使用して統計を表示する
DESCRIBE TABLE EXTENDED コマンドは、収集された統計をテーブル メタデータと共に表示します。
DESCRIBE TABLE EXTENDED sales.transactions;
PySpark を使用してテーブル メタデータを取得し、概要統計を生成することもできます。
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
describe()メソッドは、数値列と文字列列に対する count、mean、標準偏差、min、max を返します。
DESCRIBE TABLE EXTENDED出力には、テーブルのサイズをバイト単位で示すStatistics行が含まれ、ANALYZE TABLE ... COMPUTE STATISTICSを実行した後は行数も示します。 Unity カタログのマネージド テーブルの場合、予測最適化は統計を最新の状態に保つために ANALYZE 自動的に実行されます。
ヒント
一括データの読み込み後または大幅な変更後に ANALYZE TABLE 実行して、効率的なクエリを計画するための正確な統計をクエリ オプティマイザーに確実に含めます。
Unity カタログでデータ プロファイルを使用する
Azure Databricks では、SQL コマンド以外にも、Unity カタログでの データ品質の監視 が提供されます。これは、次の 2 つの異なる機能をカバーする傘です。
- 異常検出 (パブリック プレビュー) では、スキーマ内のすべてのテーブルが自動的に監視されます。 履歴パターンを分析して、各テーブルの鮮度 (最近更新された方法) と完全性 (予想される行数が到着したかどうか) を評価します。 カタログ エクスプローラーでスキーマ レベルで 1 回有効にし、各テーブルをスキャンする頻度を Azure Databricks が決定します。 異常検出を使用すると、テーブル単位の構成を使用せずに、すべてのテーブルに対して広範で自動化されたカバレッジを実現できます。
- データ プロファイル では、詳細なテーブルごとの統計分析 (分布の追跡、null の割合、誤差メトリック、時間の経過に伴うモデルのパフォーマンス) が提供されます。 テーブルごとに個別に構成します。 詳細な履歴傾向が必要な最も重要なテーブルには、データ プロファイルを使用します。
クレンジングと品質に重点を置いたデータ エンジニアリング作業では、すべてのテーブルの早期警告システムとしての異常検出と、キー テーブルの詳細な監視のためのデータ プロファイルの両方を使用します。

プロファイルの種類について
データ プロファイルでは、それぞれ異なるシナリオに適した 3 種類の分析がサポートされています。
| プロファイルの種類 | 利用シーン | 主な特性 |
|---|---|---|
| Snapshot | 汎用テーブル | 更新ごとにテーブル全体のメトリックを計算します |
| 時系列 | タイムスタンプ列を含むテーブル | 時間枠全体のメトリックを追跡して傾向を検出する |
| 推論 | ML モデル推論テーブル | 時間の経過に伴うモデルの入力、予測、および精度を監視します |
データ品質に重点を置いたデータ エンジニアリング タスクでは、スナップショットプロファイルと時系列プロファイルが最も関連性が高くなります。
UI を使用してプロファイルを作成する
カタログ エクスプローラーでプロファイルを作成するには:
- カタログ エクスプローラーでテーブルに移動します。
- [ 品質 ] タブを選択します。
- スキーマに対して異常検出が有効 になっていない 場合は、[ 有効] を選択します。 異常検出が既に有効になっている場合は、[構成] を選択 します。
- [ データ品質の監視 ] ダイアログの [ データ プロファイル ] フィールドで、[ 構成] を選択します。
- プロファイルの種類を選択し、粒度やスケジュールなどのオプションを構成します。
プロファイルでは、概要統計を含むプロファイル メトリック テーブルと、時間の経過に伴う分布の変化を追跡するドリフト メトリック テーブルが生成されます。 Azure Databricks は、ベースライン テーブルまたは連続した時間ウィンドウが利用可能な場合、ドリフト メトリックテーブルにデータを入力します。
API を使用してプロファイルを作成する
プログラムからアクセスするには、Databricks SDK を使用します。 SDK をインストールまたはアップグレードして、現在の API を取得します。
%pip install "databricks-sdk>=0.68.0"
次に、テーブルのスナップショット プロファイルを作成します。
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
プロファイルを更新してメトリックを更新するには:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
プロファイリング結果を解釈する
プロファイリングでは、データ品質を評価し、注意が必要な問題を特定するのに役立つメトリックが生成されます。
調べる主なメトリック
プロファイル メトリック テーブルには、各列の統計情報が含まれています。
| メトリック | それが明らかにするもの |
|---|---|
count および num_nulls |
データの完全性 - null の割合が高い場合は、インジェストの問題を示している可能性があります |
distinct_count |
カーディナリティ - 予期しない値がデータ品質の問題を示唆する可能性がある |
min、 max、 avg、 stddev |
分布特性 - 外れ値または傾斜分布 |
frequent_items |
最も一般的な値 - 主要なカテゴリや重複を特定するのに役立ちます |
quantiles |
値の分布 - 歪みを検出するのに役立ちます |
データ品質の問題を検出する
プロファイリング結果を調べるときは、次の一般的なインジケーターを探します。
- 値を持つ必要がある列の null の割合が高い
- 一意であるべきなのに一意でない識別子などの、予期しない個別カウント
- 期待される範囲を超える値、例えば正の値のみが有効な場合の負の値など
- 時間の経過に伴う分布の変化(データドリフトを示す可能性があります)
誤差メトリック テーブルでは、数値列の Kolmogorov-Smirnov (KS) 検定やカテゴリ列のカイ二乗検定などの統計検定が計算されます。 これらのテストは、変化した分布の量を定量化します。
これらのパターンを理解することは、データ パイプラインに適したクレンジングと検証ルールを設計するのに役立ちます。