データ インジェスト ツールを選択する
Azure Databricks でデータ パイプラインを設計する場合、適切なインジェスト ツールを選択すると、パイプラインの信頼性、メンテナンス作業、および長期的なコストに直接影響します。 各ツールは、さまざまなシナリオ、データ ソース、運用要件に対応します。 これらの違いを理解することは、組織のニーズに合った情報に基づいた意思決定を行うのに役立ちます。
インジェスト ツールのランドスケープを理解する
Azure Databricks には、フル マネージド サービスから高度にカスタマイズ可能なフレームワークまで、さまざまなインジェスト オプションが用意されています。 選択するツールは、データ ソースの種類、待機時間の要件、インジェスト プロセスに必要な制御量などの要因によって異なります。

最も管理されたエンドで、 Lakeflow Connect はエンタープライズ アプリケーションとデータベース用のターンキー コネクタを提供します。 これらのコネクタは、認証、変更の追跡、エラーの回復、スキーマの進化を自動的に処理します。 カスタマイズ可能な最後に、 Spark Structured Streaming を使用すると、パイプラインを通過するデータの流れを完全に制御できますが、開発とメンテナンスの作業がさらに必要になります。
これらの極端な間には、クラウド ストレージ ファイル用 の自動ローダー 、SQL ベースのバッチ読み込みの COPY INTO 、 JDBC/ODBC 接続を使用したノートブックベースのアプローチなどのツールがあります。 さらに、 Azure Data Factory は、より広範な Azure エコシステムから Azure Databricks へのデータ移動を調整できるオーケストレーション レイヤーとして機能します。
レイクフロー・コネクト
Lakeflow Connect は、Azure Databricks でのデータ インジェストに対する最新のアプローチを表します。 これは、合理化されたエクスペリエンスのために Lakeflow パイプラインと統合されるフル マネージド コネクタと標準コネクタの両方を提供します。
マネージド コネクタは、次の 3 種類に分類されます。
SaaS コネクタは、Salesforce、ServiceNow、SharePoint、HubSpot、Jira、Microsoft Dynamics 365、Workday、Zendesk などのエンタープライズ アプリケーションとのすぐに使える統合を提供します。 これらのコネクタは、ソース固有の認証、増分読み取り、API レート制限、スキーマの進化、自動再試行を処理します。 サーバーレス コンピューティングで実行され、Unity カタログによって管理されるストリーミング テーブルに書き込まれます。
Database コネクタ変更データ キャプチャ (CDC) を使用して、MySQL、PostgreSQL、SQL Serverなどのリレーショナル データベースからデータを取り込みます。 CDC ベースのコネクタはテーブルに直接クエリを実行するのではなく、データベース トランザクション ログから読み取るため、キャプチャされた変更をバッファー処理するために、ネットワークにデプロイされた インジェスト ゲートウェイ とステージング ストレージ ボリュームが必要です。
コミュニティ コネクタ は、コミュニティによって構築および管理されるオープン ソース コネクタです。 これらは、まだマネージド コネクタを持たないソースに Lakeflow Connect を拡張します。 既存のコミュニティ コネクタを使用することも、独自に投稿することもできます。
注
コネクタエコシステムは急速に成長しています。 サポートされているソースの現在の完全な一覧については、 マネージド コネクタのドキュメント を参照してください。
標準コネクタは、 Lakeflow Connect をクラウド オブジェクト ストレージとメッセージ バスに拡張します。 自動ローダーを使用して、Amazon S3、Azure Data Lake Storage、または Google Cloud Storage からデータを取り込むことができます。 リアルタイム データの場合、標準コネクタは Apache Kafka、Google Pub/Sub、Apache Pulsar をサポートします。

サポートされているソースからの信頼性の高い低メンテナンスインジェストが必要な場合は、Lakeflow Connect を検討してください。 マネージド コネクタは、カスタム ソリューションと比較して、開発時間と継続的なメンテナンスを大幅に削減します。 ただし、データ ソースがサポートされていない場合や、高度に特殊化されたインジェスト ロジックが必要な場合は、他のオプションを調べる必要があります。
Lakeflow Connect では、 スケジュールされた インジェスト (時間単位、毎日、毎週) と オンデマンド トリガーの両方がサポートされているため、通常のデータ更新サイクルやアドホック読み込みシナリオに適しています。
クエリ ベースのコネクタ
クエリ ベースのコネクタは、リレーショナル データベースからのスケジュールされたインジェストのための CDC データベース コネクタの軽量な代替手段です。 トランザクション ログを読み取る代わりに、 カーソル列 を使用してソース テーブルに直接クエリを実行します。これは、前回のパイプライン実行以降に新規または更新された行を追跡する単調に増加するタイムスタンプまたは整数です。
ソースに直接クエリを実行するため、クエリ ベースのコネクタではインジェスト ゲートウェイやステージング ストレージは必要ありません。 スケジュールされた各実行で、コネクタは前の実行の高基準値より大きいカーソル列値を持つすべての行を取得し、Unity カタログのストリーミング テーブルに結果を書き込みます。
サポートされるソースには、Oracle、Teradata、SQL Server、MySQL、MariaDB、PostgreSQL、およびすべての Lakehouse フェデレーション データ ソースが含まれます。
クエリ ベースのコネクタでは、変換先テーブルに対して 3 つの履歴追跡モードがサポートされます。
- SCD タイプ 1: 既存の行を最新のソース行で上書きします。 履歴は保持されません。
- SCD Type 2: バージョン メタデータを含む新しい行を追加することで、完全な履歴を保持します。
- 追加のみ: マージまたは上書きせずに、取り込まれたすべての行を追加します。
CDC または binlog インフラストラクチャを使用できないが、信頼できるカーソル列がソースに存在する場合は、CDC データベース コネクタよりもクエリベースのコネクタを選択します。 パイプラインの実行間ですべての中間行の状態が必要な場合や、ソフトデリートの追跡が重要な場合は、CDCコネクタを選択します。 トレードオフとして、クエリ ベースのコネクタは、binlog から読み取る CDC コネクタと比較して、ソース テーブルに直接負荷が高くなります。
自動ローダー
自動ローダーは、クラウド ストレージに到着するデータの増分ファイル処理を提供します。 自動ローダーは、ディレクトリ全体をスキャンして新しいファイルを検索するのではなく、処理されたファイルを効率的に追跡し、新しい到着のみを取り込みます。
自動ローダーは、処理されたファイルを追跡するチェックポイントの場所で状態を維持することによって機能します。 新しいファイルがクラウド ストレージに格納されると、自動ローダーはディレクトリ一覧またはファイル通知モードでファイルを検出します。 ディレクトリ一覧では新しいファイルが定期的にスキャンされますが、ファイル通知モードではクラウドネイティブ イベントを使用して即時検出が行われます。
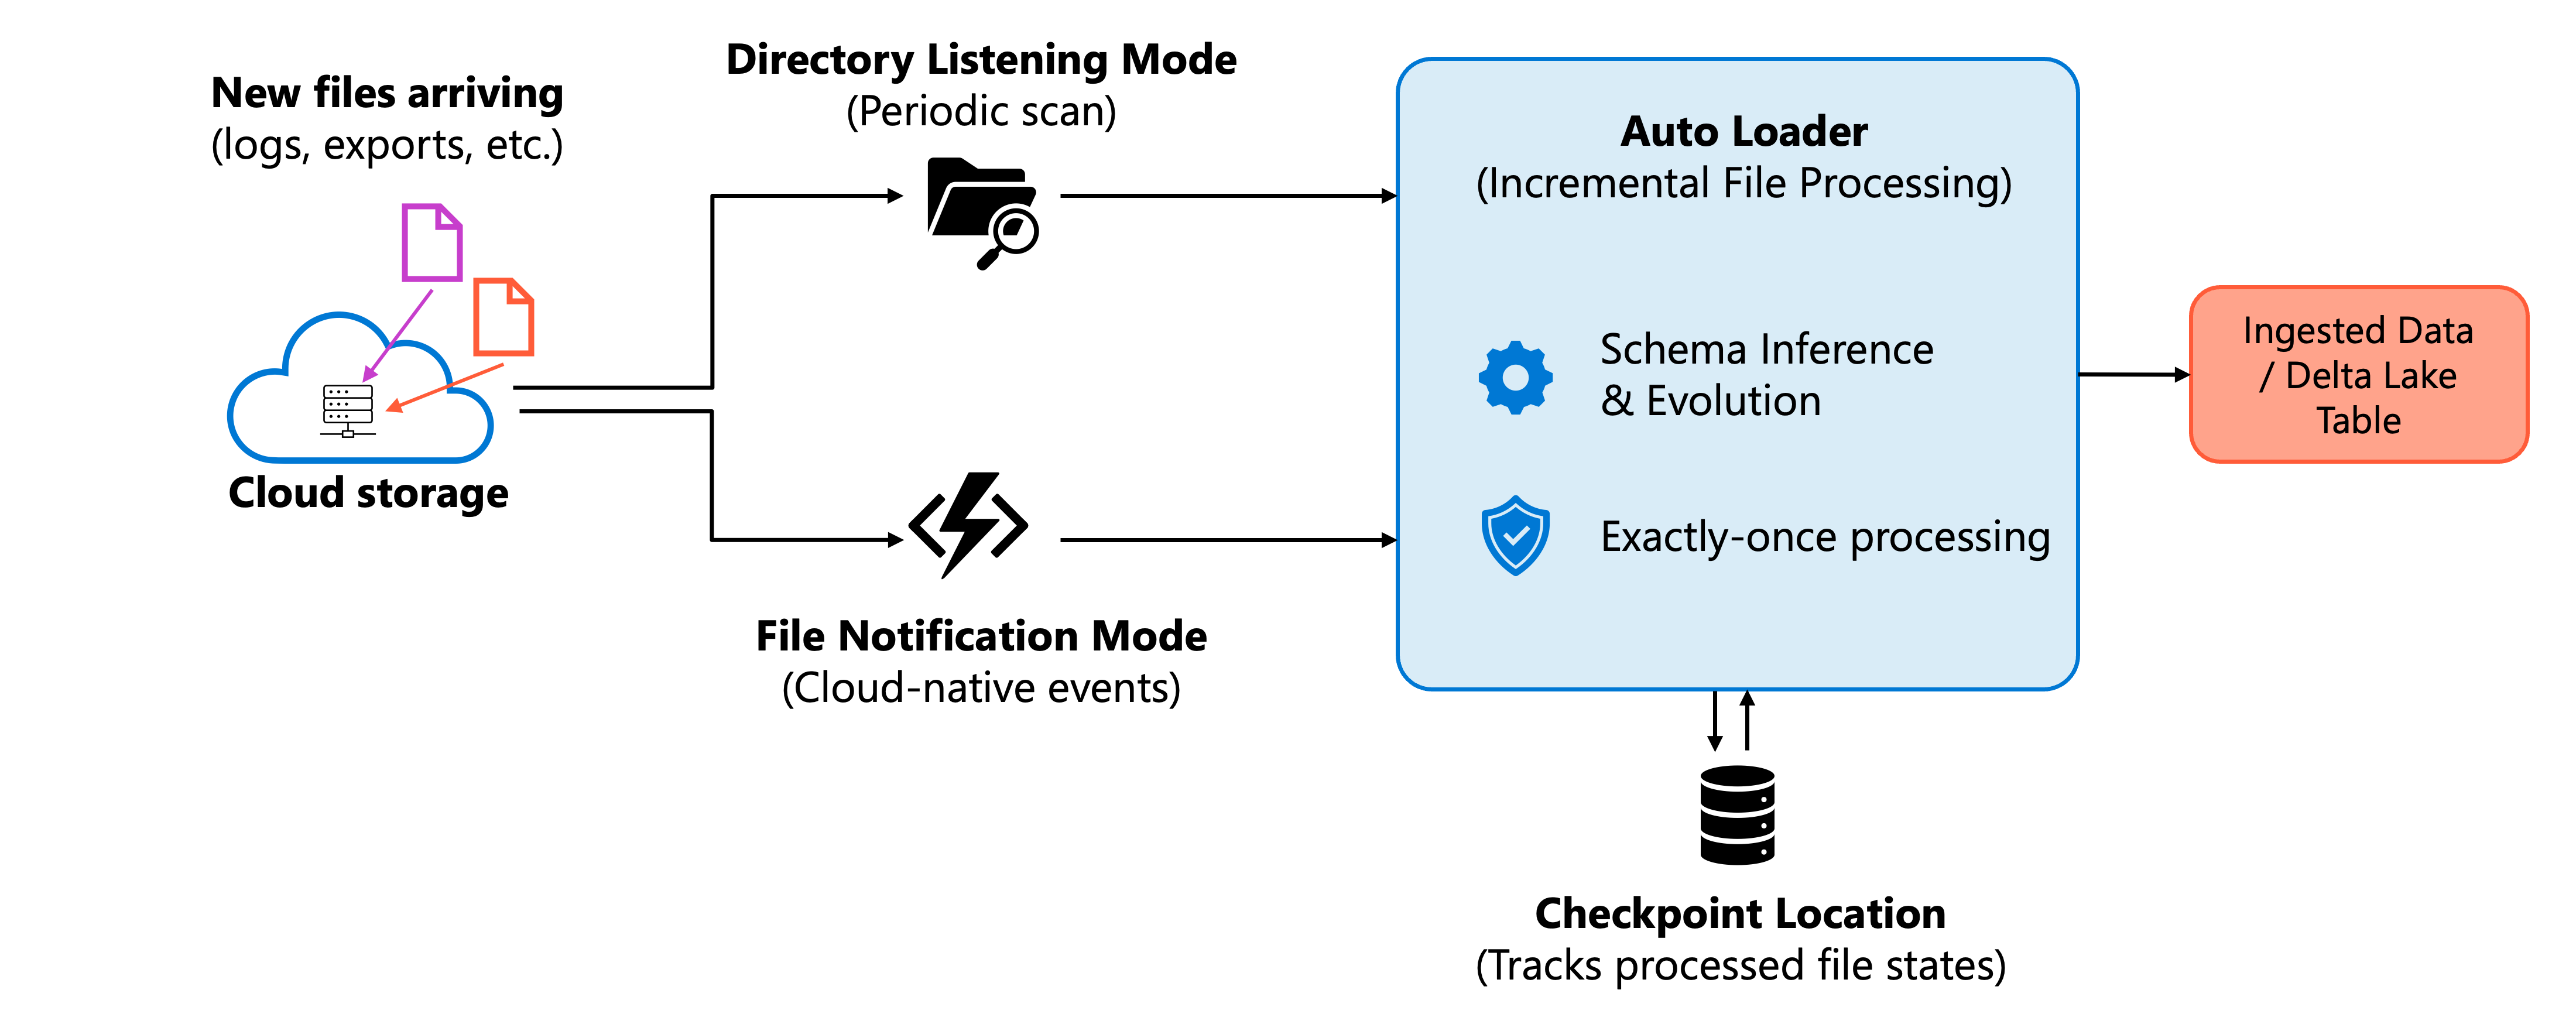
自動ローダーの主な機能は次のとおりです。
- スキーマの推論と進化: 受信ファイルのスキーマを自動的に検出し、スキーマの変更を適切に処理します。
- 厳密に 1 回の処理: エラーや再起動の間でも、各ファイルが 1 回処理されるようにします。
- スケーラビリティ: バックフィルまたは移行のために数十億ものファイルを効率的に処理します。
- 形式のサポート: JSON、CSV、Parquet、Avro、ORC、XML、テキスト、バイナリ ファイルを処理します。
自動ローダーは、データがクラウド ストレージ内のファイルとして到着するシナリオに適しています。一般的なパターンには、ログ ファイル、アップストリーム システムからのエクスポート、データ ランディング ゾーンなどがあります。 Auto Loaderは、管理された環境を実現するために Lakeflow パイプラインと組み合わせて使用することも、より詳細な制御を行うために構造化ストリームと組み合わせて使用することもできます。
COPY INTO
COPY INTO SQL コマンドは、クラウド ストレージから Delta テーブルにデータを読み込みます。 ストリームとして継続的に実行される自動ローダーとは異なり、 COPY INTO は、手動でスケジュールまたはトリガーするバッチ操作として実行されます。
COPY INTO は、すでに処理されたファイルを追跡し、操作がべき等であることを確実にします。 以前に読み込まれたファイルはスキップされるため、同じコマンドを複数回実行してもデータは重複しません。 この特性 COPY INTO 、予測可能で反復可能な動作が必要なスケジュールされたバッチ ジョブに役立ちます。
注
追跡メタデータは、Delta テーブルのトランザクション ログ ( _delta_log ディレクトリ) の一部として格納されます。

COPY INTOの一般的なシナリオとしては、1 回限りのデータ移行、ランディング ゾーンからのスケジュールされたバッチ読み込み、ストリーミング API よりも宣言型構文を使用する SQL 優先ワークフローなどがあります。
大規模なデータセットの 1 回限りのバッチ読み込みを実行する場合は、自動ローダーよりも COPY INTO を選択します。
COPY INTO は、ストリーミング インフラストラクチャを必要とせず、よりシンプルな構成モデルを提供するため、1 回の操作で数百ギガバイトまたは数テラバイトのデータを読み込むのに最適です。 オートローダーの連続処理モデルとチェックポイント管理は、データを 1 回だけ読み込む必要がある場合に不要な複雑さを増します。
ただし、大規模な増分インジェストを継続的に行う場合、自動ローダーはパフォーマンスが向上し、ファイル検出が堅牢になります。
Spark 構造化ストリーミング
Spark Structured Streaming は、Azure Databricks でのリアルタイム データ処理の基盤を提供します。 これにより、正確に 1 回の処理が保証されたさまざまなストリーミング ソースからの継続的なインジェストが可能になります。
サポートされているストリーミング ソースは次のとおりです。
- Apache Kafka と Azure Event Hubs: イベント ドリブン アーキテクチャとメッセージ キュー処理用。
- Delta Lake の変更フィード: Deltaテーブル間で変更を伝播するためのものです。
- 自動ローダーを使用したクラウド ストレージ: ファイル ベースのストリーミング インジェスト用。
- ソケットとカスタム ソース: 特殊なインジェスト シナリオ用。
ストリーミング動作、カスタム透かしまたはウィンドウ ロジックをきめ細かく制御する必要がある場合、または上位レベルの抽象化でサポートされていないソースを操作する場合は、[構造化ストリーミング] を選択します。
JDBC 接続と ODBC 接続
JDBC または ODBC を使用したノートブック ベースのインジェストは、リレーショナル データベースからデータを抽出するための実用的なアプローチです。 ソース データベースに直接接続し、クエリを実行し、結果を Delta テーブルに読み込むコードを記述します。
このアプローチでは、SQL Server、Oracle、PostgreSQL、MySQL など、JDBC または ODBC ドライバーを使用するほぼすべてのデータベースがサポートされます。 完全読み込みまたは増分読み込みを実装するには、適切なクエリを記述します。多くの場合、透かし列を使用して抽出の進行状況を追跡します。
Lakeflow Connect マネージド コネクタは多くのシナリオで JDBC/ODBC を置き換えていますが、ノートブックベースの接続は次のような場合に価値があります。
- データベースは、Lakeflow Connect マネージド コネクタではサポートされていません。
- マネージド コネクタでは対応できないカスタム抽出ロジックが必要です。
- このパターンを使用する既存のパイプラインを維持している。
- 大規模なテーブルには、特定のクエリ プッシュダウンの最適化が必要です。
JDBC/ODBC を使用する場合は、ノートブックにハードコーディングするのではなく、Databricks シークレットを使用して資格情報を安全に格納します。 ソース システムに対するパフォーマンスへの影響を考慮し、トランザクション データベースの負荷を抑えるために適切な調整またはスケジュールを実装します。
オンプレミス データベースの場合は、追加のネットワーク インフラストラクチャ (Databricks からの直接 JDBC 接続用の Azure ExpressRoute/VPN、最初にクラウド ストレージにデータを格納するための Self-Hosted Integration Runtime を使用した Azure Data Factory) が必要です。
Azure Data Factory
Azure Data Factory (ADF) は、Azure エコシステム内のオーケストレーションおよびデータ移動プラットフォームとして機能します。 複数のサービスにまたがるワークフローを調整し、さまざまなソースのデータを Azure Databricks が処理できるクラウド ストレージにランディングすることに優れています。
ADF は、Dynamics 365、Azure SQL Database、Microsoft Fabric などの Microsoft サービスと広範囲に統合されています。 データがこれらのソースから生成されると、ADF は簡単な接続を提供し、後続の Databricks 処理のために Azure Data Lake Storage にデータを格納できます。
ADF の適切な役割を理解することが重要です。 次の場合に ADF を使用します。
- オーケストレーション: 複数の Azure サービスを含むワークフローの調整。
- 初期データランディング: Azure ソースからクラウド ストレージへのデータの移動。
- エンタープライズ統合: 会社のポリシーで ADF にデータ移動が義務付けられている場合。

Databricks 内の主要な ETL 変換には ADF を使用しないでください。 ADF アクティビティを使用して変換を実行すると、不要な複雑さが生じ、Databricks ネイティブ処理よりも効率が低くなります。 ADF がレイクハウスへのデータ移動を処理し、変換ロジックに Azure Databricks ツールを使用できるようにします。
意思決定フレームワークを適用する
主要な決定基準に基づいてシナリオを評価すると、インジェストツールを選択する際の指針がより明確になります。
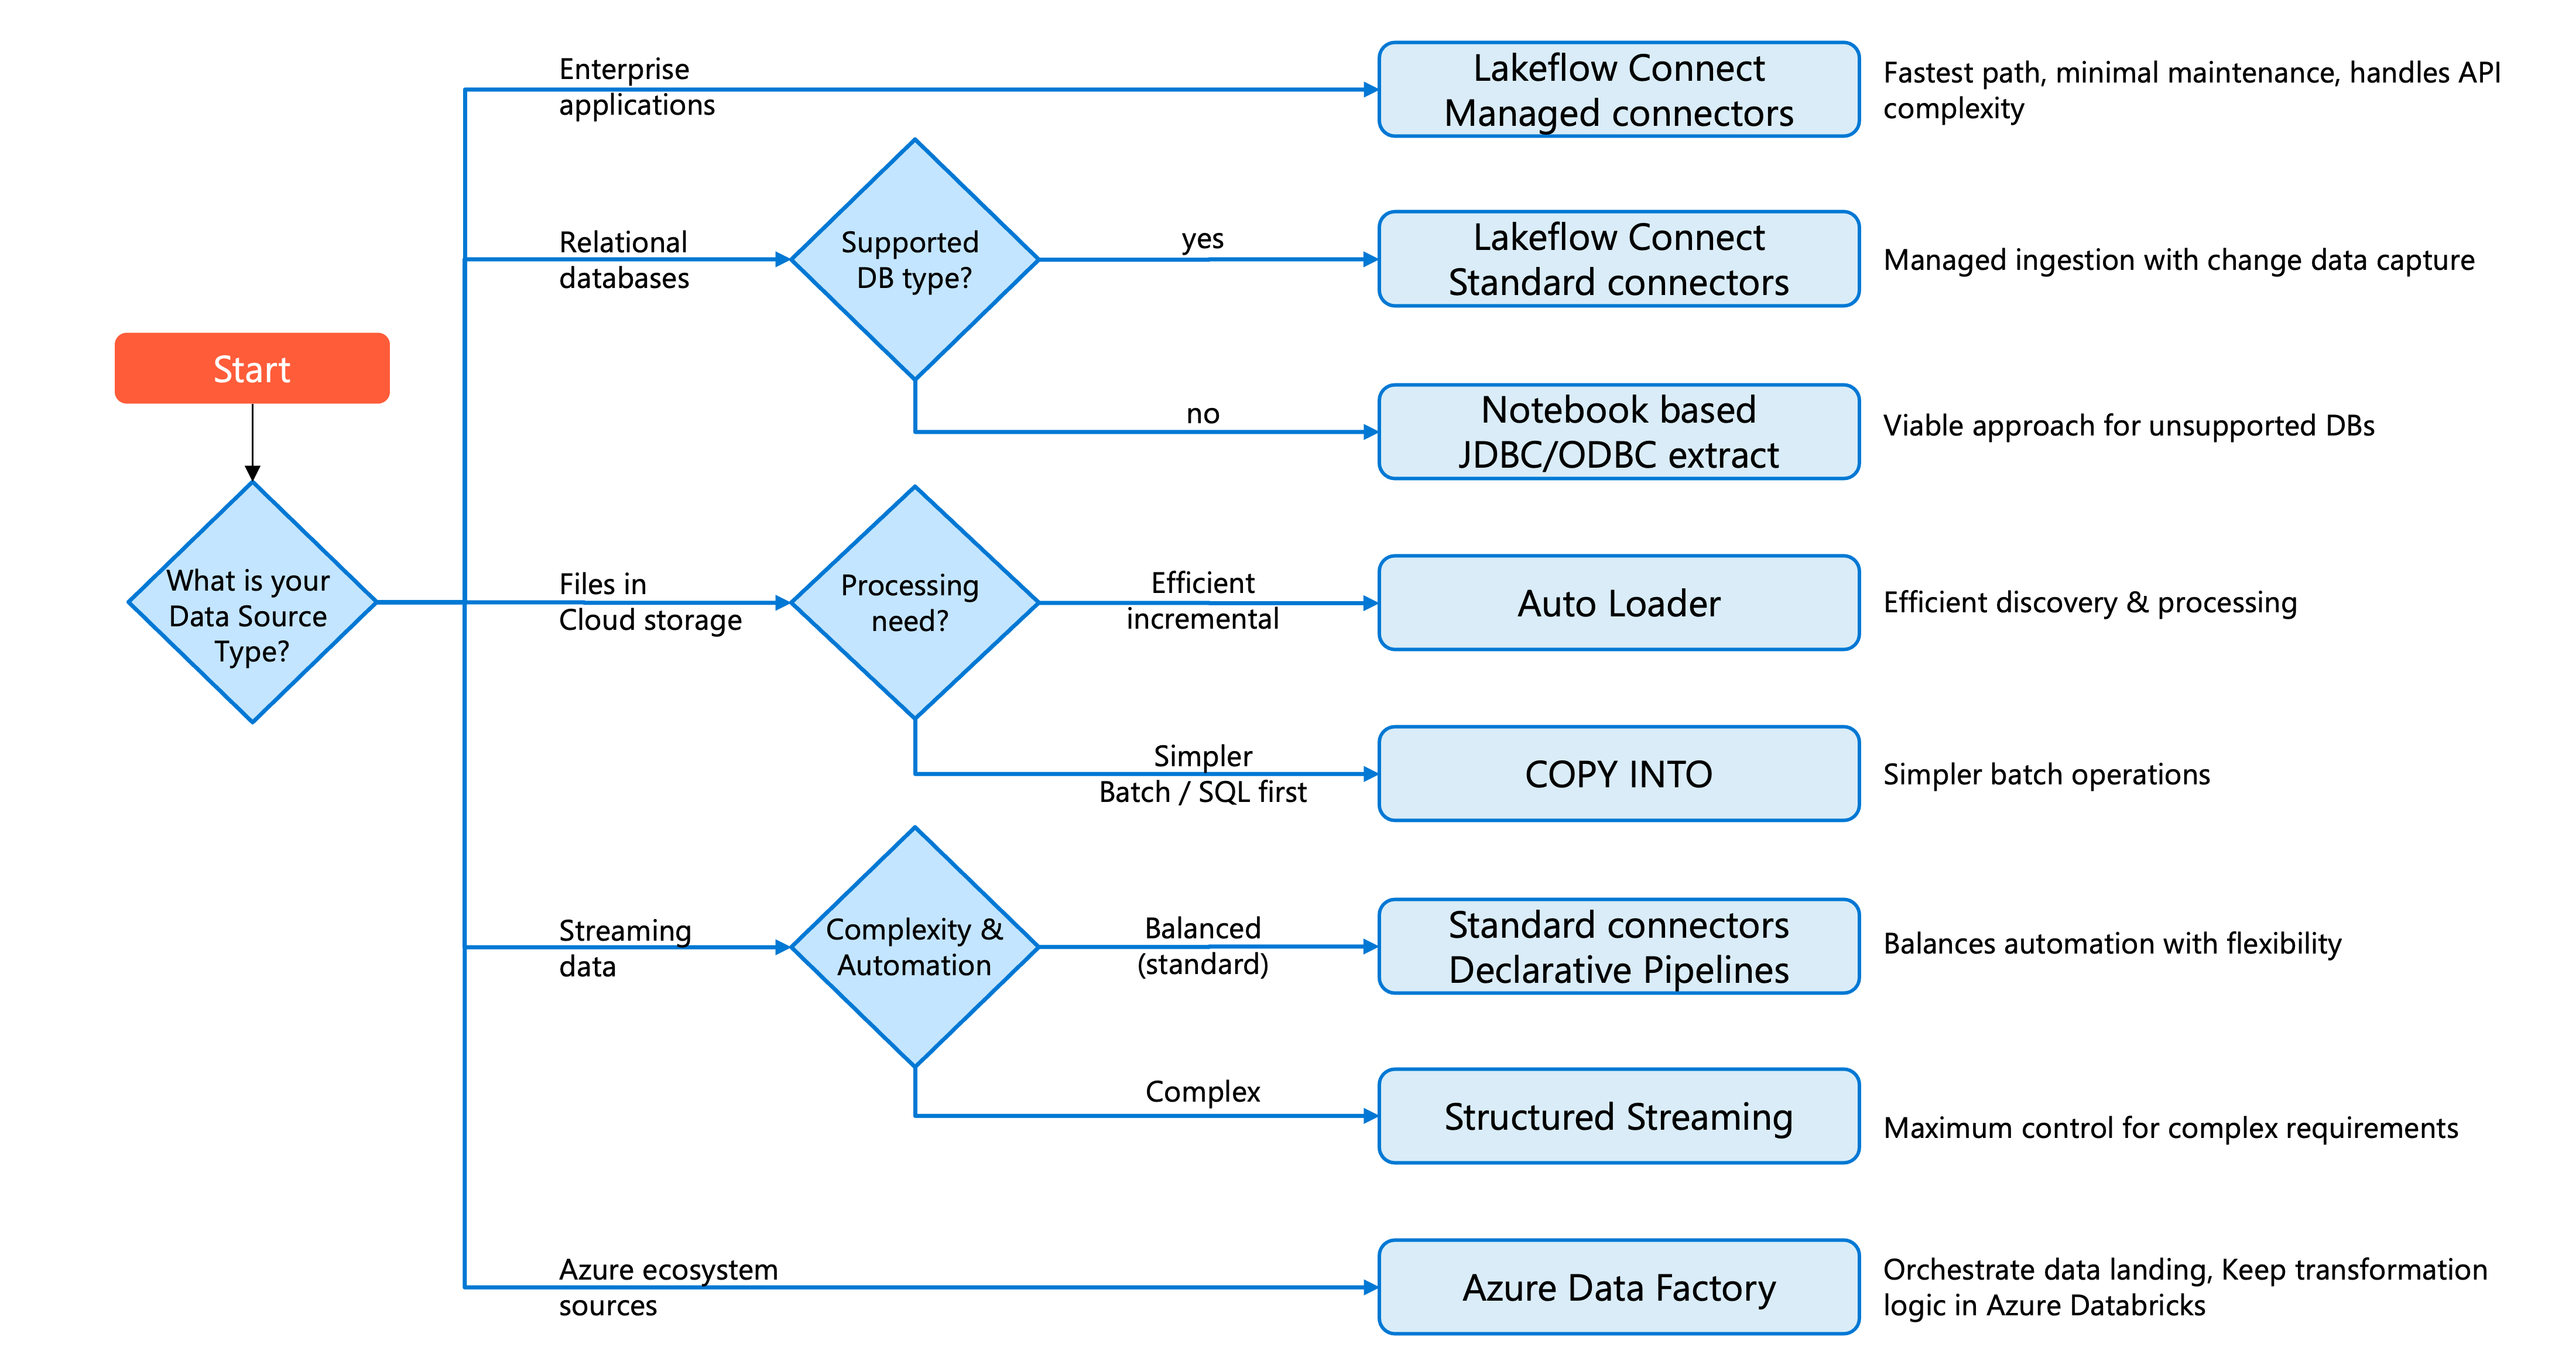
まず、データ ソースの種類を特定してから、運用要件と組織のコンテキストを検討します。
エンタープライズ アプリケーション (Salesforce、ServiceNow、SharePoint) の場合、Lakeflow Connect マネージド コネクタは最小限のメンテナンスで運用環境への最速のパスを提供します。 これらのコネクタは、API 統合、レート制限、変更追跡の複雑さを処理します。
サポートされている種類の リレーショナル データベース の場合、Lakeflow Connect には、継続的な変更キャプチャ用 のデータベース コネクタ (CDC ベース、ゲートウェイが必要) と、カーソル列を使用したより簡単なスケジュールされたインジェストのための クエリ ベースのコネクタ という 2 つの管理パスが用意されています。 サポートされていないデータベースの場合、ノートブックベースの JDBC/ODBC 抽出は引き続き実行可能なアプローチです。
クラウド ストレージ内のファイルの場合、自動ローダーは効率的な増分検出と処理を提供します。 より単純なバッチ シナリオ、または SQL 優先ワークフローを使用する場合は、COPY INTO を使用します。
メッセージ バス (Kafka、Event Hubs、Pub/Sub) から データをストリーミング する場合、Lakeflow パイプラインを備えた標準コネクタは、自動化と柔軟性のバランスを取ります。 複雑なストリーミング要件の場合、構造化ストリーミングは最大制御を提供します。
他のサービスとの連携を必要とする Azure エコシステム ソース の場合、Azure Data Factory では、Lakehouse へのデータランディングを調整できます。 ADF データ フローではなく、Azure Databricks 内に変換ロジックを保持します。
ヒント
要件を満たす最も管理されたオプションから始めます。 マネージド コネクタにより、開発時間とメンテナンスの負担が軽減されます。 特定の要件がより高度な抽象化によって満たされない場合にのみ、よりカスタマイズ可能なアプローチに移行します。
選択は、チームのスキルと組織の標準によっても異なります。 将来のチーム メンバーがパイプライン アーキテクチャを理解できるように、意思決定とその背後にある理由を文書化します。