Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Featuretabellen kunnen op twee manieren worden aangeboden:
- Model serving: Rol een model uit dat is getraind op feature tables. Hetzelfde eindpunt wordt gebruikt voor zowel feature-lookup als modelinferentie. Het eindpunt zoekt featurewaarden automatisch op of berekent deze, met behulp van de afstamming die werd gevolgd toen het model werd gelogd. Gebruik dit om modelvoorspellingen te leveren.
-
Feature Serving: Rol een
FeatureSpecuit die direct naar featuretabellen verwijst, zonder model. Het eindpunt geeft de gevraagde feature-uitvoer terug. Gebruik deze optie wanneer een toepassing functiewaarden nodig heeft in plaats van modelvoorspellingen. Als je uiteindelijk features gebruikt voor modelinferentie, raadt Databricks aan om direct model serving te gebruiken.
Beide benaderingen ondersteunen vooraf berekende en on-demand functies.
Eisen
- Databricks Runtime 14.2 ML of hoger.
- Als u de Python-API wilt gebruiken, vereist Feature Serving
databricks-feature-engineeringversie 0.1.2 of hoger, die is ingebouwd in Databricks Runtime 14.2 ML. Voor eerdere Versies van Databricks Runtime ML moet u de vereiste versie handmatig installeren met behulp van%pip install databricks-feature-engineering>=0.1.2. Als u een Databricks-notebook gebruikt, moet u de Python kernel opnieuw starten door deze opdracht uit te voeren in een nieuwe cel:dbutils.library.restartPython(). - Als u de Databricks SDK wilt gebruiken, is voor Feature Serving versie 0.18.0 of hoger vereist
databricks-sdk. Als u de vereiste versie handmatig wilt installeren, gebruikt u%pip install databricks-sdk>=0.18.0. Als u een Databricks-notebook gebruikt, moet u de Python kernel opnieuw starten door deze opdracht uit te voeren in een nieuwe cel:dbutils.library.restartPython().
Databricks Feature Serving biedt een gebruikersinterface en verschillende programmatische opties voor het maken, bijwerken, opvragen en verwijderen van eindpunten. Dit artikel bevat instructies voor elk van de volgende opties:
- Databricks-gebruikersinterface
- REST-API
- PYTHON-API
- Databricks SDK
Als u de REST API of MLflow Deployments SDK wilt gebruiken, moet u een Databricks API-token hebben.
Belangrijk
Als best practice voor beveiliging voor productiescenario's raadt Databricks u aan om OAuth-tokens voor machine-naar-machine te gebruiken voor verificatie tijdens de productie.
Voor testen en ontwikkelen raadt Databricks aan om een persoonlijk toegangstoken te gebruiken dat hoort bij service-principals in plaats van werkruimtegebruikers. Zie Tokens voor een service-principal beheren om tokens voor service-principals te maken.
Authenticatie voor functielevering
Zie Toegang tot Azure Databricks resources verifiëren voor meer informatie over verificatie.
Maak een FeatureSpec
Een FeatureSpec is een door de gebruiker gedefinieerde set kenmerken en functies. U kunt kenmerken en functies combineren in een FeatureSpec.
FeatureSpecs worden opgeslagen in en beheerd door Unity Catalog en worden weergegeven in Catalog Explorer.
De tabellen die zijn opgegeven in een FeatureSpec moeten worden gepubliceerd in een online feature store of in een onlinewinkel van derden. Zie Databricks Online Feature Stores.
u moet het databricks-feature-engineering pakketje gebruiken om een FeatureSpec te maken.
Definieer eerst de functie:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
Vervolgens kun je de functie in een FeatureSpec gebruiken:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Standaardwaarden opgeven
Als u standaardwaarden voor functies wilt opgeven, gebruikt u de default_values parameter in de FeatureLookup. Zie het volgende voorbeeld:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Als de functiekolommen worden hernoemd met behulp van de rename_outputs-parameter, moet default_values de nieuwe namen van de kenmerken gebruiken.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Voeg Python-afhankelijkheden toe
Als een door de gebruiker gedefinieerde functie (UDF) Python-pakketten importeert, declareer ze dan wanneer je de FeatureSpecaanmaakt. De extra_pip_requirements parameter vereist databricks-feature-engineering versie 0.17.0 of hoger. Feature Serving installeert de MLflow en databricks-feature-lookup pakketten automatisch.
Als bijvoorbeeld een UDF in je feature-specificatie NumPy importeert, voeg dan de vereiste toe aan de specificatie:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Gebruik main.default.customer_features_with_dependencies deze als specificatienaam wanneer je het eindpunt aanmaakt.
Elke invoer in extra_pip_requirements moet een PyPI-vereistesstring zijn, zoals numpy==1.26.4, of een pad naar een .whl bestand in een Unity Catalog-volume. Gebruik bijvoorbeeld /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl voor een wiel dat je hebt geüpload. De maker van het eindpunt moet USE CATALOG hebben op het volume en USE SCHEMA en READ VOLUME op de bovenliggende catalogus en het bovenliggende schema.
Voor pakketten uit een privérepository configureer je de standaardpakketrepository van de werkruimte. Plaats geen pip-commando-opties, zoals --index-url, in extra_pip_requirements.
Afhankelijkheden in de clausule ENVIRONMENT van een Unity Catalog UDF zijn van toepassing op offline SQL-uitvoering. Feature Serving kopieert ze niet automatisch. Declareer elk pakket dat nodig is voor de UDFs, inclusief UDFs in bovenliggende features, in de vereisten van de featurespecificatie.
Als de uitrol van een endpoint mislukt, controleer dan de buildlogboeken op fouten bij de pakketinstallatie, versieconflicten of toegangsfouten tot wheels. Zie De kwaliteit en eindpuntstatus van het model bewaken.
Voor een voorbeeld met CustomUDF en FeatureViewSource, zie Serve CustomUDF-functies en hun afhankelijkheden. Voor model serving dependencies, zie Custom UDF dependencies.
Een eindpunt maken
Het FeatureSpec eindpunt wordt gedefinieerd. Zie Create custom model serving endpoints, the Python API documentation, or the Databricks SDK documentation voor meer informatie.
Notitie
Voor workloads die latentiegevoelig zijn of hoge query's per seconde vereisen, biedt Model Serving routeoptimalisatie voor aangepaste eindpunten voor het leveren van modellen, zie Routeoptimalisatie voor het leveren van eindpunten.
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
PYTHON-API
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST-API
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Als u het eindpunt wilt zien, klikt u op Serveren in de linkerzijbalk van de Databricks-gebruikersinterface. Wanneer de status Gereed is, is het eindpunt klaar om te reageren op query's. Zie Model serving voor meer informatie over Model serving.
Het aangevulde DataFrame opslaan in de inferentietabel
Voor eindpunten die zijn gemaakt vanaf februari 2025, kunt u het model voor het eindpunt configureren om het uitgebreide DataFrame te registreren dat de opzoekfunctiewaarden en retourwaarden voor de functie bevat. Het DataFrame wordt opgeslagen in de inferentietabel voor het aangeboden model.
Zie voor instructies voor het instellen van deze configuratie Log-functie-opzoek-DataFrames naar inference-tabellen.
Voor informatie over inferentietabellen, zie Logverzoeken en antwoorden voor serving endpoints (legacy).
Een eindpunt verkrijgen
U kunt de Databricks SDK of de Python-API gebruiken om de metagegevens en status van een eindpunt op te halen.
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
PYTHON-API
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Het schema van een eindpunt ophalen
U kunt de Databricks SDK of de REST API gebruiken om het schema van een eindpunt op te halen. Zie Een model voor het eindpunt-schema ophalen voor meer informatie over het eindpuntschema.
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
REST-API
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Een query uitvoeren op een eindpunt
U kunt de REST API, de MLflow Deployments SDK of de gebruikersinterface van de server gebruiken om een query uit te voeren op een eindpunt.
De volgende code laat zien hoe u referenties instelt en de client maakt wanneer u de MLflow Deployments SDK gebruikt.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Notitie
Als best practice voor beveiliging, wanneer u zich verifieert met geautomatiseerde hulpprogramma's, systemen, scripts en apps, raadt Databricks u aan om persoonlijke toegangstokens te gebruiken die behoren tot service-principals in plaats van werkruimtegebruikers. Zie Tokens voor een service-principal beheren om tokens voor service-principals te maken.
Een query uitvoeren op een eindpunt met behulp van API's
Deze sectie bevat voorbeelden van het uitvoeren van query's op een eindpunt met behulp van de REST API of de MLflow Deployments SDK.
MLflow Deployments SDK
Belangrijk
In het volgende voorbeeld wordt de predict() API van de MLflow Deployments SDK gebruikt. Deze API is experimenteel en de API-definitie kan veranderen.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST-API
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Een eindpunt opvragen met behulp van de gebruikersinterface
U kunt rechtstreeks vanuit de bedieningsinterface een query uitvoeren op een bedienings-eindpunt. De gebruikersinterface bevat gegenereerde codevoorbeelden die u kunt gebruiken om een query uit te voeren op het eindpunt.
Klik in de linkerzijbalk van de werkruimte Azure Databricks op Serving.
Klik op het eindpunt waarop u een query wilt uitvoeren.
Klik in de rechterbovenhoek van het scherm op Query-eindpunt.
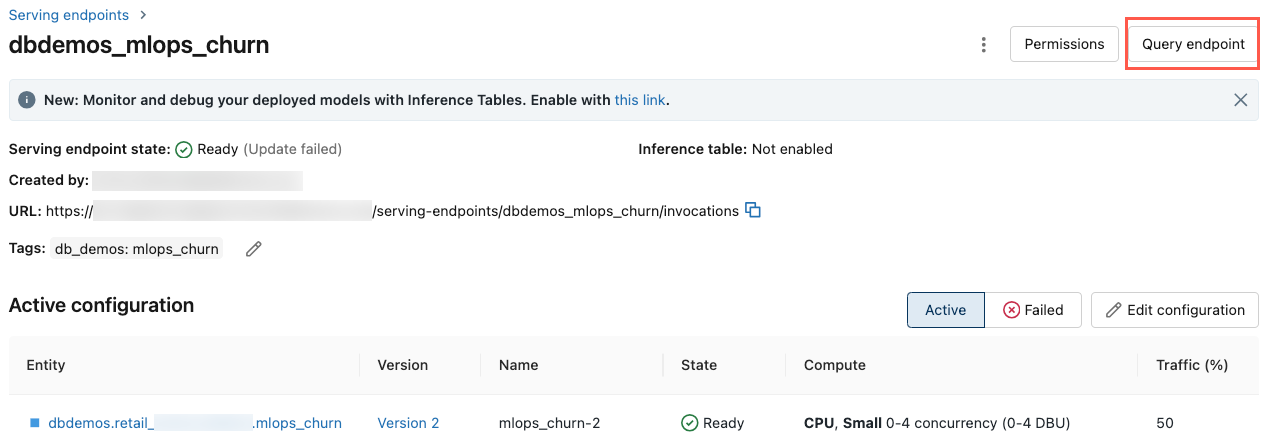
Typ in het vak Aanvraag de hoofdtekst van de aanvraag in JSON-indeling.
Klik op Aanvraag verzenden.
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
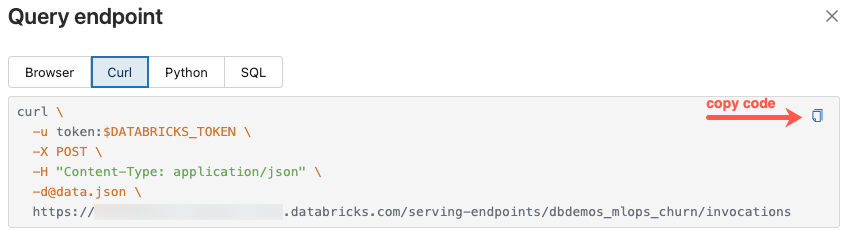
Het dialoogvenster Query-eindpunt bevat gegenereerde voorbeeldcode in curl, Python en SQL. Klik op de tabbladen om de voorbeeldcode weer te geven en te kopiëren.

Als u de code wilt kopiëren, klikt u op het kopieerpictogram in de rechterbovenhoek van het tekstvak.
Een eindpunt bijwerken
Belangrijk
Gebruik altijd de update-API's die in deze sectie worden beschreven om de configuratie van een feature serving-eindpunt (zoals het wijzigen van de FeatureSpec of de grootte van de werkbelasting) te wijzigen. Verwijder het eindpunt niet en maak het opnieuw om wijzigingen toe te passen. Het verwijderen van een live-eindpunt veroorzaakt onmiddellijke downtime en onderbreekt alle toepassingen die er query's op uitvoeren.
U kunt een eindpunt bijwerken met behulp van de REST API, de Databricks SDK of de gebruikersinterface van de server.
Een eindpunt bijwerken met behulp van API's
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST-API
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Een eindpunt bijwerken met behulp van de gebruikersinterface
Volg deze stappen om de gebruikersinterface van de server te gebruiken:
- Klik in de linkerzijbalk van de werkruimte Azure Databricks op Serving.
- Klik in de tabel op de naam van het eindpunt dat u wilt bijwerken. Het eindpuntscherm wordt weergegeven.
- Klik in de rechterbovenhoek van het scherm op Eindpunt bewerken.
- Bewerk in het Dialoogvenster Eindpunt Bewerken de instellingen voor het eindpunt indien nodig.
- Klik op Bijwerken om uw wijzigingen op te slaan.

Werk de afhankelijkheden van een live Feature Serving-endpoint bij
Een Feature Serving endpoint lost zijn afhankelijkheden op wanneer het voor het eerst wordt gebouwd en geïmplementeerd: de rechten die zijn service principal nodig heeft om de online tabel (USE CATALOG, SELECT, en EXECUTE) te lezen, en FeatureSpec op de Unity Catalog UDF die in de USE SCHEMA ervan wordt beschreven. Het endpoint legt deze machtigingen vast tijdens de bouw en lost ze niet opnieuw op bij een gewone heruitrol of herstart. Als je de online tabel of UDF opnieuw aanmaakt, verliest het eindpunt de rechten erop. Als je de UDF direct bijwerkt, blijft het endpoint de originele versie draaien. Feature-opzoekopdrachten kunnen falen, of de oude UDF-logica stilletjes gebruiken, zelfs terwijl het eindpunt Ready blijft rapporteren.
Voor zowel online tabellen als on-demand UDF's raadt Databricks een versiegebonden migratie aan: maak een nieuwe versie van de afhankelijkheid aan, maak een nieuw eindpunt aan en migreer verkeer naar het nieuwe eindpunt. Dit helpt je downtime en de in deze sectie beschreven faalmodi te vermijden.
Maak een online tabel opnieuw aan
Waarschuwing
Verwijder een online tabel onder een live Feature Serving-endpoint niet en maak deze niet opnieuw aan.
Wanneer je een endpoint aanmaakt, kent Model Serving de serviceprincipal USE CATALOG van het endpoint toe op de catalogus van de online tabel, USE SCHEMA op het schema en SELECT op de online tabel. Het verwijderen en opnieuw aanmaken van de tabel, zelfs met dezelfde naam, maakt een nieuwe securable in Unity Catalog, zodat de SELECT machtiging niet wordt overgenomen. De service-principal verliest de toegang tot de tabel, OAuth-tokenminting faalt en de verbinding met de online winkel valt terug op wachtwoordauthenticatie en faalt. Feature-opzoekingen mislukken vervolgens met fouten zoals KeyError: 'OAUTH_TOKEN' of password authentication failed.
Deze fouten zijn makkelijk te missen: het eindpunt geeft nog steeds Ready aan en de synchronisatiepijplijn toont nog steeds succesvolle runs, terwijl opzoekopdrachten falen. Het wijzigen van de synchronisatiemodus van een online tabel (bijvoorbeeld tussen CONTINUOUS en SNAPSHOT) kan niet ter plaatse worden gedaan en vereist het opnieuw aanmaken van de tabel, wat dit probleem ook kan veroorzaken.
Een endpoint leest geen specifieke online tabel. Het zoekt features op via de offline featuretabel die in zijn FeatureSpec wordt genoemd, en wanneer een featuretabel wordt gepubliceerd in meer dan één online tabel, gebruikt het eindpunt de oudste. Het publiceren van dezelfde featuretabel naar een tweede online tabel verplaatst geen eindpunt naar de nieuwe online tabel. Zie beperkingen in de Online Feature Store.
Om downtime te minimaliseren, versioneer de offline-featuretabel evenals de online tabel:
- Maak een nieuwe offline featuretabel aan en neem de versie op in de naam (bijvoorbeeld
customer_features_v2). - Publiceer de nieuwe featuretabel als een nieuwe online tabel. Zie Een featuretabel publiceren.
- Maak een nieuwe
FeatureSpecaan die de nieuwe featuretabel gebruikt, en maak een nieuw Feature Serving endpoint aan dat deze bedient. - Migreer verkeer naar het nieuwe endpoint. Nadat het oude eindpunt geen verkeer meer ontvangt, verwijder het en de online tabel.
Werk een on-demand UDF bij
Waarschuwing
Pas een Unity Catalog UDF die door een FeatureSpec wordt gebruikt niet rechtstreeks aan.
De on-demand UDF van FeatureSpec is ingebouwd in het serving-endpoint bij de implementatie. Een gewone refresh of redeploy gebruikt dezelfde UDF opnieuw in dat serverende image. Een in-place update van de UDF onder dezelfde naam heeft geen effect. Als je de UDF verwijdert en opnieuw aanmaakt, verliest het eindpunt ook EXECUTE, dus zoekopdrachten die de UDF gebruiken mislukken.
FeatureSpecs en UDF's hebben geen versieveld, dus versie op naam: maak een nieuwe UDF aan en maak een nieuwe FeatureSpec, maak een nieuw eindpunt dat de nieuwe FeatureSpecgebruikt en migreer verkeer ernaartoe. Zie Maak een FeatureSpec.
Zie On-demand feature computation.
Herstel een eindpunt na een in-place wijziging
Als je al ter plekke een afhankelijkheid hebt gewijzigd, bouw dan het eindpunt opnieuw op zodat het zijn afhankelijkheden opnieuw oplost. Maak een nieuw FeatureSpec (of, voor een Model Serving endpoint, registreer een nieuwe modelversie) en werk het endpoint bij om dit te serveren. Het wijzigen van wat het endpoint levert, bouwt het endpoint opnieuw op, waardoor een nieuwe service-principal wordt ingericht en de machtigingsconfiguratie opnieuw wordt uitgevoerd. Geen van deze handelingen bouwt het eindpunt betrouwbaar opnieuw op: stoppen en starten, een simpele heruitrol of het wijzigen van een omgevingsvariabele.
Een eindpunt verwijderen
Waarschuwing
Deze actie kan niet ongedaan worden genomen. Het verwijderen van een functieverdieningseindpunt zorgt voor onmiddellijke downtime voor toepassingen die er query's op uitvoeren. Als u de configuratie van het eindpunt wilt wijzigen, gebruikt u Een eindpunt bijwerken in plaats van het eindpunt te verwijderen en opnieuw te maken.
U kunt een eindpunt verwijderen met behulp van de REST API, de Databricks-SDK, de Python-API of de gebruikersinterface van de server.
Een eindpunt verwijderen met behulp van API's
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
PYTHON-API
fe.delete_feature_serving_endpoint(name="customer-features")
REST-API
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
Een eindpunt verwijderen met behulp van de gebruikersinterface
Volg deze stappen om een eindpunt te verwijderen vanuit de Serving-UI:
- Klik in de linkerzijbalk van de werkruimte Azure Databricks op Serving.
- Klik in de tabel op de naam van het eindpunt dat u wilt verwijderen. Het eindpuntscherm wordt weergegeven.
- Klik in de rechterbovenhoek van het scherm op het
 en selecteer Verwijderen.

De status van een eindpunt bewaken
Zie Modelkwaliteit en eindpuntstatus bewaken voor informatie over de beschikbare logboeken en metrische gegevens voor Feature Serving-eindpunten.
Toegangsbeheer
Zie Machtigingen beheren op een model serving-eindpunt voor informatie over machtigingen op functie-serving-eindpunten.
Voorbeeld van notebook
In dit notebook ziet u hoe u de Databricks SDK gebruikt om een eindpunt voor functieverdeling te maken met databricks Online Feature Store.