Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Adaptieve queryuitvoering (AQE) is het opnieuw optimaliseren van query's die plaatsvinden tijdens het uitvoeren van query's.
Voordat een query wordt uitgevoerd, kiest de optimizer een queryplan op basis van schattingen van de datagrootte. Die schattingen kunnen onjuist zijn als tabelstatistieken ontbreken of verouderd zijn, als de data scheef is, of voor latere stappen in een complexe query. Een plan dat gebaseerd is op verkeerde schattingen kan een slow join-strategie gebruiken, te veel kleine taken creëren na een shuffle, of een paar te grote taken creëren die de hele fase vertragen. AQE lost deze problemen op door het plan te heroptimaliseren terwijl de query loopt, gebaseerd op de werkelijke grootte van de data.
Aan het einde van elke shuffle of broadcast-uitwisseling heeft Azure Databricks nauwkeurige statistieken voor de tot nu toe geproduceerde data. AQE gebruikt deze statistieken om een betere fysieke strategie te kiezen, een optimaal aantal en grootte van post-shuffle partities te kiezen, of optimalisaties toe te passen die anders queryhints vereisen, zoals skew join-behandeling.
AQE is standaard ingeschakeld. Je hoeft je zoekopdrachten niet te veranderen om ervan te profiteren. Controleer of AQE een queryplan heeft gewijzigd wanneer je een langzame query oplost. Pas de AQE-instellingen alleen aan als de standaardinstellingen niet bij je werklast passen. Zie Query-plannen en Configuratie.
Mogelijkheden
AQE heeft vier hoofdkenmerken:
- Wijzigt dynamisch de samenvoegbewerking in een broadcast-hash-join.
- Partities worden dynamisch samengevoegd (kleine partities combineren tot een redelijk formaat) na een shuffle-uitwisseling. Zeer kleine taken hebben slechtere I/O-doorvoer en hebben meestal meer last van planningsoverhead en overhead voor het instellen van taken. Door kleine taken te combineren, bespaart men middelen en verbetert men de doorvoer van het cluster.
- Verwerkt dynamisch scheefheid in sort merge-join en shuffle hash-join door scheefgetrokken taken te splitsen (en indien nodig te repliceren) in ongeveer even grote taken.
- Detecteert en propageert dynamisch lege relaties, die onderdelen zijn van een query die geen rijen teruggeven.
Ondersteunde queries
AQE is van toepassing op zoekopdrachten die aan beide voorwaarden voldoen:
- De query is geen streaming-query.
- De query bevat ten minste één exchange (meestal vanuit een join, aggregate of window), ten minste één subquery, of beide.
AQE optimaliseert elke ondersteunde query opnieuw, maar het resultaat kan hetzelfde plan zijn dat de optimizer heeft samengesteld voordat de query werd uitgevoerd. Om te controleren of AQE het plan van een query heeft gewijzigd, zie Queryplannen.
Queryplannen
AQE-toegepaste queries bevatten een of meerdere AdaptiveSparkPlan knooppunten, meestal als de hoofdnode van elke hoofdquery of subquery. Elke AdaptiveSparkPlan node heeft een isFinalPlan vlag. De vlag staat false voor en tijdens de uitvoering van de query, en verandert naar true wanneer de query is afgerond.
Om een queryplan te bekijken, gebruik je de Spark UI, DataFrame.explain(), of SQL EXPLAIN. Elk daarvan toont verschillende informatie over hoe AQE het plan verandert.
Spark-gebruikersinterface
Het queryplandiagram in de Spark UI toont het meest actuele plan en werkt zich bij terwijl de query draait. Nodes die al zijn uitgevoerd en metrics hebben, veranderen niet. Nodes die nog niet zijn uitgevoerd, kunnen veranderen naarmate AQE het plan opnieuw optimaliseert.
Dit voorbeeld toont een queryplandiagram:

DataFrame.explain()
DataFrame.explain() toont twee plannen onder elke AdaptiveSparkPlan knoop: het initiële plan, voordat AQE enige optimalisaties toepast, en het huidige plan. Het huidige plan verandert terwijl de query draait en wordt het definitieve plan wanneer de query is afgerond.
De output bevat datastatistieken voor elke shuffle- en broadcastfase. De statistieken hangen ervan af of de etappe al is uitgevoerd:
- Voor en tijdens de stage run is
isRuntimefalseen de statistieken schattingen tijdens het compileren. Bijvoorbeeld:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Nadat de stage is uitgevoerd, zijn
isRuntimedetruestatistieken runtime-metingen. Bijvoorbeeld:Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Deze screenshots tonen DataFrame.explain() de output vóór, tijdens en na de uitvoering:
Vóór uitvoering

Tijdens de uitvoering

Na uitvoering

SQL EXPLAIN
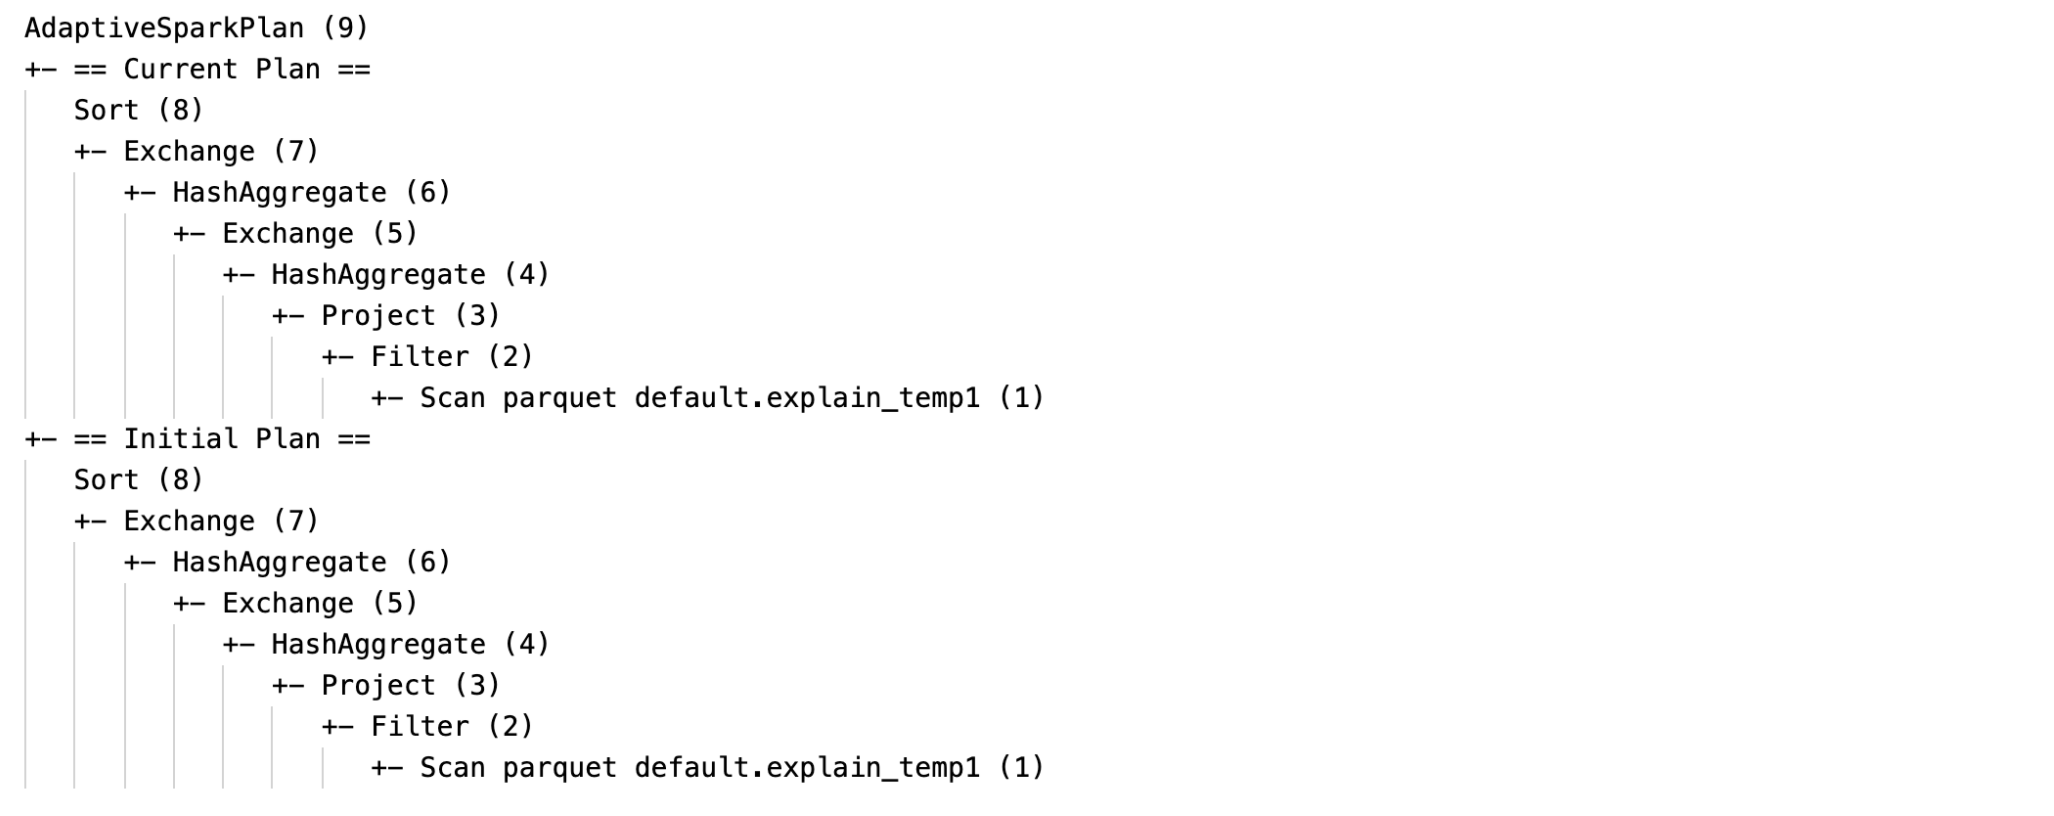
SQL EXPLAIN voert de query niet uit, dus AQE kan deze niet opnieuw optimaliseren. De output toont alleen het oorspronkelijke plan, dat kan verschillen van het plan dat AQE uitvoert.
Dit voorbeeld toont SQL EXPLAIN output:
Identificeer toegepaste optimalisaties in een queryplan
Wanneer AQE een optimalisatie toepast, verandert het queryplan. Om te bepalen welke optimalisaties zijn doorgevoerd, vergelijk het huidige of definitieve plan met het oorspronkelijke plan. Elke optimalisatie verandert het plan op een specifieke manier:
Wijziging van de joinstrategie Het huidige of definitieve plan heeft een andere fysieke join-node dan het initiële plan.

Partities samenvoegen. Het plan bevat een
CustomShuffleReaderknooppunt met deCoalescedeigenschap.

Afhandeling van skew joins. Het plan bevat een
SortMergeJoinnode met hetisSkewveld ingesteld optrue.

Propagatie van lege relaties. Een
LocalTableScanknoop met een leeg relatieveld vervangt een deel of geheel van het plan.

Configuratie
Deze configuratie-eigenschappen van Apache Spark regelen AQE. Voor de meeste workloads hoeven de standaardinstellingen niet te worden gewijzigd.
Schakel AQE in en stem individuele optimalisaties af
Gebruik deze eigenschappen om AQE aan of uit te zetten en om auto-geoptimaliseerde shuffle, broadcast join switching en empty relation-propagatie af te stemmen:
| Eigenschap | Type | Default | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Zet adaptieve query-uitvoering aan of uit. |
spark.sql.shuffle.partitions |
Integer |
200 |
Het standaardaantal partities dat moet worden gebruikt bij het opsnipperen van gegevens voor joins of aggregaties. Stel het in op auto om automatisch geoptimaliseerde shuffle in te schakelen, die dit getal instelt op basis van het queryplan en de grootte van de query-invoerdata.Voor Structured Streaming kun je deze waarde niet wijzigen tussen het opnieuw starten van query's vanaf dezelfde checkpointlocatie. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
De groottedrempel voor het wisselen van een sort-merge join naar een broadcast hash join tijdens runtime. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Zet de dynamische lege relatiepropagatie aan of uit. |
Dynamisch samenvoegen van partities
| Eigenschap | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Hiermee schakelt u het samenvoegen van partities in of uit. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
De doelgrootte na het samenvoegen. Samengevoegde partities zijn dicht bij, maar niet groter dan, deze grootte. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
De minimale grootte van partities na het samenvoegen. Samengevoegde partities zijn niet kleiner dan deze grootte. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Twee keer het aantal clusterkernen | Het minimale aantal partities na het samenvoegen. Stel deze eigenschap niet in, want het instellen ervan overschrijft spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Scheefheidsdeelname dynamisch verwerken
| Eigenschap | Type | Default | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Zet skew join-handling aan of uit. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
De vermenigvuldigingsfactor voor de mediane partitiegrootte die een partitie moet overschrijden om als scheef wordt beschouwd. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
De minimale grootte die een partitie moet overschrijden om als scheef verdeeld te worden beschouwd. |
AQE behandelt een partitie als scheef alleen wanneer beide voorwaarden waar zijn: (partition size > skewedPartitionFactor * median partition size) en (partition size > skewedPartitionThresholdInBytes).
Veelgestelde vragen (FAQ)
Waarom heeft AQE geen kleine join-tabel verstuurd?
Als de tabel kleiner is dan spark.databricks.adaptive.autoBroadcastJoinThreshold maar AQE het niet uitzendt, controleer dan de volgende mogelijke oorzaken:
- Het join-type ondersteunt geen broadcast. Sommige join-types kunnen niet één zijde broadcasten. Bijvoorbeeld, AQE kan de linkerkant van een
LEFT OUTER JOINniet doorgeven. - De tabel heeft veel lege partities. De meeste taken in de sort merge join zijn snel afgerond, of skew join handling optimaliseert de join. AQE verandert een sort merge join niet in een broadcast hash join als het percentage niet-lege partities lager is dan
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Moet ik nog steeds een broadcast join hint gebruiken met AQE ingeschakeld?
Ja, als je je query goed kent. Een broadcast-join die de optimizer plant voordat de query wordt uitgevoerd, presteert meestal beter dan een die AQE tijdens runtime plant. AQE schakelt mogelijk pas over naar een broadcast join nadat het beide zijden van de join heeft geshuffeld, wanneer het de daadwerkelijke tabelgroottes leert.
AQE respecteert query hints op dezelfde manier als statische optimalisatie, en past nog steeds de dynamische optimalisaties toe waarop de hints geen invloed hebben.
Moet ik de skew join hint gebruiken of AQE-skew-join-afhandeling?
Gebruik AQE skew join handling. Het is automatisch en presteert meestal beter dan de skew join hint.
Waarom heeft AQE mijn joins niet opnieuw geordend?
AQE herschikt joins niet tijdens runtime. Om de join-volgorde te verbeteren, verzamel tabelstatistieken zodat de kostengebaseerde optimizer een beter plan kan kiezen. Zie kostengebaseerde optimalisator.
Waarom heeft AQE mijn gegevens scheeftrekken niet gedetecteerd?
AQE behandelt een partitie als scheef alleen wanneer beide voorwaarden waar zijn:
- De partitie is groter dan
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(standaard256MB). - De partitie is groter dan
spark.sql.adaptive.skewJoin.skewedPartitionFactor(standaard5) maal de mediane partitiegrootte.
AQE behandelt ook skew alleen in shuffle-gebaseerde joins, dat zijn sort merge- en shuffle-hash-joins. Het optimaliseert nooit scheefheid in broadcast joins. Voor shuffle-gebaseerde joins bepaalt het join-type welke kant AQE kan optimaliseren:
| Soort join | Scheefstand geoptimaliseerd aan de linkerzijde | Scheefstand geoptimaliseerd aan de rechterzijde |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | Nee. |
RIGHT OUTER |
Nee. | Yes |
LEFT SEMI |
Yes | Nee. |
LEFT ANTI |
Yes | Nee. |
FULL OUTER |
Nee. | Nee. |
Nalatenschap
Spark 1.6 introduceerde een functie genaamd adaptive execution, maar AQE in Spark 3.0 is een andere functie. Spark 1.6 adaptieve query-uitvoering voegt partities alleen dynamisch samen. AQE is een framework dat queries plant en herplant op basis van runtime-statistieken, en het ondersteunt alle optimalisaties op deze pagina.