Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Van toepassing op: SQL Server op Linux
In dit artikel wordt uitgelegd hoe u een exemplaar van een SQL Server-failovercluster (FCI) uitvoert in Linux. Om een SQL Server FCI op Linux te maken, zie Configure failover cluster instance on Linux (RHEL).
Beschrijving van architectuur
De clusterlaag is gebaseerd op de Red Hat Enterprise (RHEL) HA-add-on die bovenop Pacemaker is gebouwd. Corosync en Pacemaker coördineren clustercommunicatie en resourcebeheer. De SQL Server-instantie is actief op één node tegelijk.
In het volgende diagram ziet u de onderdelen in een Linux-cluster met SQL Server.
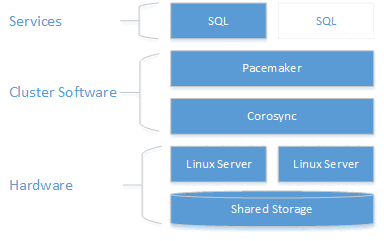
Voor meer informatie over clusterconfiguratie, resource agent-opties en beheer, bezoek de RHEL-referentiedocumentatie.
Failover
Failover voor FCI's is vergelijkbaar met een Windows Server-failovercluster (WSFC). Als het clusterknooppunt dat als host fungeert voor de FCI een fout ondervindt, moet de FCI automatisch een failover naar een ander knooppunt uitvoeren. In tegenstelling tot een WSFC is er geen manier om voorkeurseigenaren in te stellen, dus Pacemaker kiest het knooppunt dat de nieuwe host voor de FCI is.
Soms wil je misschien handmatig een failover van de FCI naar een andere node uitvoeren. Het proces verloopt anders dan bij FCI's op een WSFC. In een WSFC voert u een failover uit van resources op rolniveau. In Pacemaker kies je een resource om te verplaatsen, en als alle beperkingen kloppen, beweegt de rest ook.
De manier om failover te maken hangt af van de Linux-distributie. Volg de instructies voor je Linux-distributie.
Handmatige failover (RHEL of Ubuntu)
Voer de volgende stappen uit om een handmatige failover uit te voeren op Red Hat Enterprise Linux -servers (RHEL) of Ubuntu-servers.
Geef de volgende opdracht uit:
sudo pcs resource move <FCIResourceName> <NewHostNode><FCIResourceName>is de naam van de Pacemaker-resource voor de SQL Server FCI, en<NewHostNode>is de naam van het clusterknooppunt waarop u de FCI wilt hosten.Tijdens een handmatige failover maakt Pacemaker een locatieconstraint voor de resource die is gekozen om handmatig te verplaatsen. Als u deze beperking wilt zien, voert u
sudo pcs constraintuit.Nadat de failover is voltooid, verwijder je de beperking:
sudo pcs resource clear <FCIResourceName>
Handmatige failover (SLES)
Note
Vanaf SQL Server 2025 (17.x) wordt SUSE Linux Enterprise Server (SLES) niet ondersteund. Voor SQL Server 2022 (16.x) en eerdere versies wordt alleen SLES 15 ondersteund.
Gebruik in SUSE Linux Enterprise Server (SLES) de opdracht migrate om handmatig een failover uit te voeren voor een SQL Server-FCI. Voorbeeld:
crm resource migrate <FCIResourceName> <NewHostNode>
<FCIResourceName> is de resourcenaam van de failover-clusterinstantie, en <NewHostNode> is de naam van de nieuwe bestemmingshost.
Monitor een failover-cluster
De huidige clusterstatus weergeven:
sudo pcs status
Bekijk de live status van de cluster en de bronnen:
sudo crm_mon
Bekijk de resource agent-logs op /var/log/cluster/corosync.log.
Een knooppunt toevoegen aan een cluster
Controleer het IP-adres voor elk knooppunt. In het volgende script ziet u het IP-adres van uw huidige knooppunt.
ip addr showDe nieuwe node heeft een unieke naam nodig die 15 tekens of minder is. Stel de computernaam in door deze toe te voegen aan
/etc/hosts. Met het volgende script kunt u/etc/hostsbewerken metvi.sudo vi /etc/hostsIn het volgende voorbeeld ziet u
/etc/hostsmet toevoegingen voor drie knooppunten genaamdsqlfcivm1,sqlfcivm2, ensqlfcivm3.127.0.0.1 localhost localhost4 localhost4.localdomain4 ::1 localhost localhost6 localhost6.localdomain6 10.128.18.128 sqlfcivm1 10.128.16.77 sqlfcivm2 10.128.14.26 sqlfcivm3Het bestand moet op elk knooppunt hetzelfde zijn.
Stop de SQL Server-service op het nieuwe knooppunt.
Volg de instructies om de databasemap te mounten op de gedeelde locatie.
Vanaf de NFS-server, installeer
nfs-utils:sudo yum -y install nfs-utilsOpen de firewall voor clients en NFS-server.
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
Bewerk het
/etc/fstabbestand om de koppelingsopdracht op te nemen:<IP OF NFS SERVER>:<shared_storage_path> <database_files_directory_path> nfs timeo=14,intrVoer
mount -auit om de wijzigingen van kracht te laten worden.Maak op het nieuwe knooppunt een bestand voor het opslaan van de gebruikersnaam en het wachtwoord van SQL Server voor de pacemaker-aanmelding. Met de volgende opdracht wordt dit bestand gemaakt en ingevuld:
sudo touch /var/opt/mssql/secrets/passwd
echo "<loginName>" | sudo tee -a /var/opt/mssql/secrets/passwd
echo "<password>" | sudo tee -a /var/opt/mssql/secrets/passwd
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 600 /var/opt/mssql/secrets/passwd
Caution
Uw wachtwoord moet het SQL Server standaardbeleid voor password volgen. Standaard moet het wachtwoord ten minste acht tekens lang zijn en tekens bevatten uit drie van de volgende vier sets: hoofdletters, kleine letters, basis-10 cijfers en symbolen. Wachtwoorden mogen maximaal 128 tekens lang zijn. Gebruik wachtwoorden die zo lang en complex mogelijk zijn.
Open op het nieuwe knooppunt de pacemaker-firewallpoorten. Voer de volgende opdracht uit om deze poorten te openen met
firewalld:sudo firewall-cmd --permanent --add-service=high-availability sudo firewall-cmd --reloadAls je een andere firewall gebruikt die geen ingebouwde high-availability-configuratie heeft, open dan de volgende poorten zodat Pacemaker kan communiceren met andere nodes in de cluster:
- TCP: poorten 2224, 3121, 21064
- UDP: poort 5405
Installeer Pacemaker-pakketten op het nieuwe knooppunt.
sudo yum install pacemaker pcs fence-agents-all resource-agentsStel het wachtwoord in voor de standaardgebruiker die wordt gemaakt bij het installeren van Pacemaker- en Corosync-pakketten. Gebruik hetzelfde wachtwoord als de bestaande knooppunten.
sudo passwd haclusterSchakel
pcsdservice en Pacemaker in en start deze. De nieuwe node kan na een herstart weer bij de cluster aansluiten. Voer de volgende opdracht uit op het nieuwe knooppunt.sudo systemctl enable pcsd sudo systemctl start pcsd sudo systemctl enable pacemakerInstalleer de FCI-resourceagent voor SQL Server. Voer de volgende opdracht uit op het nieuwe knooppunt.
sudo yum install mssql-server-haAuthenticeer op een bestaande node in de cluster de nieuwe node en voeg deze toe aan de cluster:
sudo pcs cluster auth <nodeName3> -u hacluster
sudo pcs cluster node add <nodeName3>
Knooppunten verwijderen uit een cluster
Voer de volgende opdracht uit om een knooppunt uit een cluster te verwijderen:
sudo pcs cluster node remove <nodeName>
Wijzig de frequentie voor het monitoren van resources.
sudo pcs resource op monitor interval=<interval>s <sqlResourceName>
Het volgende voorbeeld stelt het monitoringsinterval voor de mssqlha bron op 2 seconden:
sudo pcs resource op monitor interval=2s mssqlha
Troubleshoot
Wanneer u problemen met het cluster oplost, is het handig om te begrijpen hoe de drie daemons samenwerken om clusterresources te beheren.
| Daemon | Description |
|---|---|
| Corosync | Biedt quorumlidmaatschap en berichten tussen clusterknooppunten. |
| Hartstimulator | Bevindt zich boven op Corosync en biedt statusmachines voor resources. |
| PCSD | Beheert zowel Pacemaker als Corosync via de pcs-hulpprogramma's. |
PCSD moet draaien om pcs-hulpprogramma's te kunnen gebruiken.
Huidige clusterstatus
sudo pcs status retourneert basisinformatie over het cluster, quorum, knooppunten, resources en daemonstatus voor elk knooppunt.
Het volgende voorbeeld toont een gezonde Pacemaker-quorumoutput:
Cluster name: MyAppSQL
Last updated: Wed Oct 31 12:00:00 2024  Last change: Wed Oct 31 11:00:00 2024 by root via crm_resource on sqlvmnode1
Stack: corosync
Current DC: sqlvmnode1  (version 1.1.13-10.el7_2.4-44eb2dd) - partition with quorum
3 nodes and 1 resource configured

Online: [ sqlvmnode1 sqlvmnode2 sqlvmnode3 ]

Full list of resources:

mssqlha (ocf::sql:fci): Started sqlvmnode1

PCSD Status:
sqlvmnode1: Online
sqlvmnode2: Online
sqlvmnode3: Online

Daemon Status:
corosync: active/disabled
pacemaker: active/enabled
In dit voorbeeld betekent dat partition with quorum een meerderheid quorum van nodes online is. Als het cluster een meerderheidsquorum van knooppunten verliest, retourneert pcs statuspartition WITHOUT quorum en worden alle resources gestopt.
Online: [sqlvmnode1 sqlvmnode2 sqlvmnode3] retourneert de naam van alle knooppunten die momenteel deelnemen aan het cluster. Als er geen knooppunten deelnemen, retourneert pcs statusOFFLINE: [<nodename>].
PCSD Status toont de clusterstatus voor elk knooppunt.
Redenen waarom een knooppunt mogelijk offline is
Controleer de volgende items wanneer een knooppunt offline is.
Firewall
Open de volgende poorten op alle knooppunten zodat de Pacemaker kan communiceren:
- TCP: poorten 2224, 3121, 21064
- UDP: poort 5405
Pacemaker- of Corosync-services draaien
knooppuntcommunicatie
Naamtoewijzingen voor knooppunten