Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Van toepassing op: SQL Server 2016 (13.x) en latere versies Azure SQL DatabaseAzure SQL Managed InstanceSQL database in Microsoft Fabric
Met gegevensvirtualisatie kunt u Transact-SQL (T-SQL)-query's uitvoeren op externe gegevens zonder deze in uw database te laden. U definieert een externe gegevensbron, optionele bestandsindeling en externe tabel en voert vervolgens een query uit op de externe tabel met SELECT net als elke andere tabel.
Deze handleiding helpt u bij het volgende:
- Begrijpen welke PolyBase functies biedt voor uw SQL-platform en versieondersteuning.
- Kies tussen
OPENROWSET, externe tabellen enBULK INSERTvoor het opvragen of opnemen van gegevens. - Volg stapsgewijze koppelingen voor veelvoorkomende scenario's.
- Bekijk de prestaties, probleemoplossing en aanbevolen procedures voor productieworkloads.
Platformondersteuning
- PolyBase is een functie van Microsoft SQL Database Engine die datavirtualisatie implementeert.
- PolyBase wordt ondersteund in SQL Server 2016 en latere versies op Windows en in SQL Server 2019 en latere versies op Linux.
- PolyBase wordt niet ondersteund in SQL Server 2017 op Linux.
- PolyBase wordt niet ondersteund in Azure SQL Database, maar Azure SQL Database biedt gerelateerde virtualisatiemogelijkheden via
OPENROWSETen externe tabellen. Zie Gegevensvirtualisatie met Azure SQL Database (preview) voor meer informatie. - PolyBase is geen functie in Azure SQL Managed Instance bij naam, maar Azure SQL Managed Instance heeft datavirtualisatiefuncties die vergelijkbaar werken. Zie Gegevensvirtualisatie met Azure SQL Managed Instance voor meer informatie.
- PolyBase wordt niet ondersteund in SQL-databases in Fabric, maar SQL-database in Fabric biedt zijn eigen datavirtualisatiemogelijkheden voor data in OneLake. Voor meer informatie, zie Datavirtualisatie in SQL-database in Fabric.
- PolyBase is geen functie in Fabric Data Warehouse. Voor datavirtualisatie in Fabric Data Warehouse kunt u Fabric OneLake Shortcuts overwegen. Voor artikelen over het laden van gegevens in Fabric Data Warehouse, zie Data ingestion with T-SQL en Dimensional modeling: Load tables.
Veelvoorkomende gebruiksvoorbeelden
In de volgende tabel worden mogelijke gebruiksscenario's beschreven.
| Scenario | Gebruik |
|---|---|
| Ad-hoc bestandsverkenning | OPENROWSET(BULK ...) |
| Herbruikbare bestandsquery's voor BI of rapportage | Externe tabellen op basis van bestanden |
| Query's op meerdere databases (SQL Server, Oracle, Teradata, MongoDB, ODBC) | PolyBase connectors met externe tabellen |
| Queryresultaten exporteren naar bestanden |
CREATE EXTERNAL TABLE AS SELECT (CETAS) |
| Bulk verzenden naar tabellen |
BULK INSERT of OPENROWSET(BULK ...) met INSERT ... SELECT |
- Voor ad-hoc bestandsverkenning, gebruik
OPENROWSET(BULK ...)om bestanden te inspecteren zonder een herbruikbare tabel te maken. - Voor herbruikbare bestandsquerys in BI of rapportagescenario's gebruik je externe tabellen over bestanden om een schema te behouden en resultaten te delen over queries.
- Voor cross-database query's gebruik je PolyBase-connectoren met externe tabellen om toegang te krijgen tot SQL Server, Oracle, Teradata, MongoDB of ODBC-bronnen.
- Voor het exporteren van zoekresultaten naar bestanden, gebruik
CREATE EXTERNAL TABLE AS SELECT(CETAS) om Parquet- of CSV-uitvoer buiten de database te schrijven. - Voor het bulksgewijs laden in tabellen gebruik je
BULK INSERTofOPENROWSET(BULK ...)metINSERT ... SELECTom bestandsgegevens in databasetabellen te laden.
Welke functies zijn beschikbaar waar?
De volgende tabel toont welke kernfuncties van PolyBase en datavirtualisatie beschikbaar zijn op elk SQL-platform, beginnend met SQL Server 2019. Voor functionaliteitsbeschikbaarheid in SQL Server 2016 en SQL Server 2017 op Windows, zie PolyBase-functies en beperkingen. Gebruik deze tabel om te bepalen wat u op uw platform kunt doen voordat u de gedetailleerde handleidingen gebruikt.
| Feature | SQL Server 2019 | SQL Server 2022 | SQL Server 2025 | Azure SQL Database | Azure SQL Managed Instance (een beheerde database-instantie van Azure) | SQL-database in Microsoft Fabric |
|---|---|---|---|---|---|---|
| Externe tabellen | Ja | Ja | Ja | Ja | Ja | Ja |
| OPENROWSET (BULK) | Ja 1 | Ja | Ja | Ja | Ja | Ja |
| CETAS (export) | No | Ja | Ja | No | Ja | No |
| CSV-/gescheiden bestanden | Ja 2 | Ja | Ja | Ja | Ja | Ja |
| Parquet-bestanden | No | Ja | Ja | Ja | Ja | Ja |
| Delta Lake-tabellen | No | Ja | Ja | No | No | No |
| Verbinding maken met een andere SQL Server | Ja | Ja | Ja | No | No | No |
| Verbinding maken met Azure SQL Database of Azure SQL Managed Instance | Ja 3 | Ja 3 | Ja 3 | No | No | No |
| Verbinding maken met Oracle/Teradata/MongoDB | Ja | Ja | Ja | No | No | No |
| Verbinding maken met Azure Blob Storage | Ja | Ja | Ja | Ja | Ja | No |
| Verbinding maken met ADLS Gen2 | Ja 5 | Ja | Ja | Ja | Ja | No |
| Verbinding maken met S3-compatibele opslag | No | Ja | Ja | No | No | No |
| Verbinding maken met OneLake (Fabric) | No | No | No | No | No | Ja |
| Pushdownberekening | Ja | Ja | Ja | No | No | No |
| beheerde identiteitverificatie | No | No | Ja 4 | Ja | Ja | No |
1 SQL Server 2019 (15.x) ondersteunt OPENROWSET(BULK...) voor lokale en netwerkbestandspaden. In SQL Server 2022 (16.x) en latere versies wordt OPENROWSET(BULK...) ook het lezen vanuit cloudopslag ondersteund met FORMAT = 'PARQUET', FORMAT = DELTAen FORMAT = 'CSV'.
2 CSV-ondersteuning in SQL Server 2019 (15.x) vereist Hadoop. In SQL Server 2022 (16.x) en latere versies wordt CSV systeemeigen ondersteund zonder Hadoop.
3 Maakt gebruik van de SQL Server-connector (sqlserver://). De database-scoped credential richt zich op het SQL-eindpunt. Gebruik dezelfde stappen als bij het verbinden met een andere SQL Server-instantie.
4 Verificatie van beheerde identiteit wordt ondersteund voor het maken van verbinding met Azure Blob Storage (ABS) en ADLS Gen2. Hiervoor is SQL Server of SQL Server met Azure Arc vereist op een Azure-VM voor on-premises SQL Server. Het is systeemeigen beschikbaar in Azure SQL Database en Azure SQL Managed Instance.
5 SQL Server 2019 CU11 en latere versies ondersteunen Azure Data Lake Storage Gen2 met het abfs voorvoegsel orabfss. In SQL Server 2022 en latere versies gebruik je het adls voorvoegsel.
- Externe tabellen worden ondersteund in SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance en SQL Database in Microsoft Fabric.
-
OPENROWSET (BULK)wordt ondersteund in SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance en de SQL-database in Microsoft Fabric. SQL Server 2019 ondersteunt lokale en netwerkbestandspaden, terwijl SQL Server 2022 en latere versies ook het lezen van cloudopslag ondersteunen metFORMAT = 'PARQUET',FORMAT = DELTA, enFORMAT = 'CSV'. - CETAS-export wordt niet ondersteund in SQL Server 2019, Azure SQL Database of SQL-database in Microsoft Fabric. CETAS-export wordt ondersteund in SQL Server 2022, SQL Server 2025 en Azure SQL Managed Instance.
- CSV- en gescheiden bestanden worden ondersteund in SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance en SQL Database in Microsoft Fabric. SQL Server 2019 vereist Hadoop voor CSV-ondersteuning, terwijl SQL Server 2022 en latere versies CSV native ondersteunen zonder Hadoop.
- Parquet-bestanden worden niet ondersteund in SQL Server 2019. Parquetbestanden worden ondersteund in SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance en SQL Database in Microsoft Fabric.
- Delta Lake-tabellen worden niet ondersteund in SQL Server 2019, Azure SQL Database, Azure SQL Managed Instance of SQL database in Microsoft Fabric. Delta Lake-tabellen worden ondersteund in SQL Server 2022 en SQL Server 2025.
- Verbinding maken met een andere SQL Server-instantie wordt ondersteund in SQL Server 2019, SQL Server 2022 en SQL Server 2025. Verbinden met een andere SQL Server-instantie wordt niet ondersteund door Azure SQL Database, Azure SQL Managed Instance of SQL Database in Microsoft Fabric.
- Verbinding maken met Azure SQL Database of Azure SQL Managed Instance wordt ondersteund door SQL Server 2019, SQL Server 2022 en SQL Server 2025 via de SQL Server connector. De database-scoped credential richt zich op het Azure SQL Database- of Azure SQL Managed Instance-endpoint, en de configuratiestappen zijn hetzelfde als voor het verbinden met een andere SQL Server-instantie. Deze verbindingen worden niet ondersteund door Azure SQL Database, Azure SQL Managed Instance of SQL Database in Microsoft Fabric.
- Verbinding maken met Oracle, Teradata of MongoDB wordt ondersteund door SQL Server 2019, SQL Server 2022 en SQL Server 2025. Deze verbindingen worden niet ondersteund door Azure SQL Database, Azure SQL Managed Instance of SQL Database in Microsoft Fabric.
- Verbinding met Azure Blob Storage wordt ondersteund door SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database en Azure SQL Managed Instance. Verbinding maken met Azure Blob Storage wordt niet ondersteund vanuit de SQL-database in Microsoft Fabric.
- Verbinding maken met ADLS Gen2 wordt niet ondersteund in SQL Server 2019-releases vóór CU11 of vanuit de SQL-database in Microsoft Fabric. Verbinding met ADLS Gen2 wordt ondersteund vanaf SQL Server 2019 CU11, en in SQL Server 2022, SQL Server 2025, Azure SQL Database en Azure SQL Managed Instance.
- Verbinding maken met S3-compatibele opslag wordt niet ondersteund door SQL Server 2019, Azure SQL Database, Azure SQL Managed Instance of SQL Database in Microsoft Fabric. Verbinding maken met S3-compatibele opslag wordt ondersteund door SQL Server 2022 en SQL Server 2025.
- Verbinding met OneLake wordt ondersteund vanuit een SQL-database in Microsoft Fabric. Verbinding maken met OneLake wordt niet ondersteund in SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database of Azure SQL Managed Instance.
- Pushdown-berekening wordt ondersteund in SQL Server 2019, SQL Server 2022 en SQL Server 2025. Pushdown-berekening wordt niet ondersteund in Azure SQL Database, Azure SQL Managed Instance of SQL Database in Microsoft Fabric.
- Beheerde identiteitsauthenticatie wordt niet ondersteund in SQL Server 2019 of SQL Server 2022. Managed Identity-authenticatie wordt ondersteund in SQL Server 2025 voor verbindingen met Azure Blob Storage en ADLS Gen2, en vereist Azure Arc-geschikte SQL Server of SQL Server op een Azure virtuele machine. Managed Identity-authenticatie wordt ook ondersteund in Azure SQL Database en Azure SQL Managed Instance, maar niet in SQL Database in Microsoft Fabric.
Opmerking
Vanaf SQL Server 2025 (17.x) is het uitvoeren van query's op gegevensbestanden (CSV, Parquet en Delta) in Azure Blob Storage, ADLS Gen2 of S3-compatibele opslag een systeemeigen enginemogelijkheid en hoeft u geen PolyBase-services meer te installeren of uit te voeren. VOOR RDBMS-connectors (SQL Server, Oracle, Teradata, MongoDB, ODBC) moeten PolyBase-services nog steeds worden geïnstalleerd en uitgevoerd. SQL Server 2025 (17.x) voegt ook Linux-ondersteuning toe voor deze connectors, die eerder alleen beschikbaar waren in Windows.
Query's uitvoeren op externe gegevens
Voordat u een specifiek scenario kiest, moet u de drie manieren begrijpen waarop u externe gegevens kunt opvragen:
| Methode | Syntaxis | Gebruik wanneer | Authentication | PolyBase-installatie vereist |
|---|---|---|---|---|
| ad-hocqueries van OLE DB | OPENROWSET(provider, connection, query) |
U wilt een snelle eenmalige query zonder permanente objecten of microsoft Entra ID-verificatie nodig hebben | SQL-verificatie, Windows-verificatie, Microsoft Entra ID (MSOLEDBSQL) | No |
| Ad hoc queries op bestanden | OPENROWSET(BULK ...) |
U wilt bestandsgegevens snel verkennen of schema's testen voordat u een tabel maakt | SAS-token, toegangssleutel, Beheerde identiteit, Microsoft Entra-id | SQL Server 2022: Ja 1 SQL Server 2025 en latere versies: Nee Azure SQL Database, Azure SQL Managed Instance en SQL-database in Fabric: Ingebouwd |
| Permanente gegevensconnectors |
CREATE EXTERNAL TABLE met sqlserver://, oracle://, teradata://, enz. |
U hebt terugkerende toegang, governance, statistieken en pushdownberekeningen voor productie nodig | Alleen SQL-verificatie | Ja |
1 Voor cloud-bestandstoegang in SQL Server 2022 (16.x) moet je de PolyBase-functie installeren, maar de Azure Blob Storage-, ADLS Gen2- en S3-compatibele opslagconnectors zijn niet afhankelijk van PolyBase-diensten. SQL Server 2025 (17.x) en latere versies bieden native ondersteuning voor CSV, Parquet en Delta zonder het installeren of uitvoeren van PolyBase-diensten.
- OLE DB ad hoc queries worden gebruikt
OPENROWSET(provider, connection, query)voor snelle eenmalige toegang tot een externe databron zonder persistente objecten aan te maken. Ze kunnen SQL-authenticatie, Windows authentication of Microsoft Entra ID gebruiken met MSOLEDBSQL. Dit scenario vereist geen installatie van PolyBase. - Ad-hoc queries op bestanden worden gebruikt
OPENROWSET(BULK ...)om snel bestandsgegevens te verkennen of een schema te testen voordat een tabel wordt aangemaakt. Ze kunnen SAS-tokens, toegangssleutels, Managed Identity of Microsoft Entra ID gebruiken. SQL Server 2022 vereist de installatie van de PolyBase-functie voor cloudbestanden, maar vereist geen PolyBase-services. SQL Server 2025 en latere versies vereisen geen PolyBase voor cloudbestanden. File ad hoc queries zijn ingebouwd in Azure SQL Database, Azure SQL Managed Instance en SQL Database in Fabric. - Persistente gegevensconnectors gebruiken
CREATE EXTERNAL TABLEmetsqlserver://,oracle://,teradata://en vergelijkbare locaties voor herhaalde toegang, governance, statistieken en pushdown-bewerkingen in productieworkloads. Ze vereisen SQL-authenticatie en PolyBase-diensten.
Beslissingshandleiding
| Scenario | Aanbeveling |
|---|---|
| Je hebt Microsoft Entra ID-authenticatie nodig voor remote SQL, of wilt PolyBase-diensten vermijden. | Gebruik OPENROWSET(MSOLEDBSQL, ...) (ad hoc, geen persistente objecten). |
| Je hebt persistente tabellen, statistieken of pushdown-berekeningen naar externe databases nodig. | Gebruik CREATE EXTERNAL TABLE met PolyBase-connectors (sqlserver://, oracle://, teradata://, mongodb://, odbc://).
OPENROWSET Ondersteunt geen connectoren. |
| Je onderzoekt een nieuw bestand of test een schema. | Gebruik OPENROWSET(BULK ...) (snelle iteratie, geen persistente objecten). |
| Je verwerkt bestandsgegevens in een tabel met transformaties. | Gebruik INSERT ... SELECT van OPENROWSET(BULK ...). |
| Je hebt governance of gedeelde toegang nodig voor veel gebruikers of applicaties. | Gebruik CREATE EXTERNAL TABLE het zodat permissies en metadata gecentraliseerd zijn. |
| Je werkt in SQL-databases in Fabric. | Gebruik OPENROWSET(BULK ...) voor ad-hoc OneLake-queries of externe tabellen voor herbruikbare toegang; voor externe opslag gebruik je OneLake-snelkoppelingen. |
- Als je Microsoft Entra ID-authenticatie nodig hebt voor remote SQL of PolyBase-diensten wilt vermijden, gebruik
OPENROWSET(MSOLEDBSQL, ...)dan voor ad hoc remote queries zonder persistente objecten. - Als je persistente tabellen, statistieken of pushdown-berekeningen naar externe databases nodig hebt, gebruik
CREATE EXTERNAL TABLEdan PolyBase-connectoren zoalssqlserver://,oracle://,teradata://, ,mongodb://enodbc://.OPENROWSETOndersteunt deze connectoren niet. - Als je een nieuw bestand onderzoekt of een schema test, gebruik
OPENROWSET(BULK ...)het dan voor snelle iteratie en geen persistente objecten. - Als je bestandsgegevens invoert in een tabel met transformaties, gebruik
INSERT ... SELECTdan vanOPENROWSET(BULK ...). - Als je governance of gedeelde toegang nodig hebt voor veel gebruikers of applicaties, gebruik
CREATE EXTERNAL TABLEdan zodat permissies en metadata gecentraliseerd zijn. - Als je werkt in een SQL-database in Fabric, gebruik
OPENROWSET(BULK ...)dan ad-hoc OneLake-queries of externe tabellen voor herbruikbare toegang, en gebruik OneLake-snelkoppelingen voor externe opslag.
Kies uw scenario
Nu u de drie benaderingen begrijpt, gebruikt u een van de volgende handleidingen om uw specifieke use-case te implementeren.
Querybestanden (Parquet, CSV of Delta)
Als uw gegevens zich in Parquet-, CSV- of Delta-bestanden bevinden in Azure Blob Storage, ADLS Gen2, S3-compatibele opslag of OneLake, volgt u een van deze handleidingen:
| Scenario | Aanbevolen handleiding | Platforms |
|---|---|---|
| Snelle ad-hocvraag voor een Parquet- of CSV-bestand | Gebruik OPENROWSET. Er is geen externe tabel nodig |
SQL Server 2022 (16.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Herhaalde query's op Parquet-bestanden met een permanent schema | Een externe tabel maken via Parquet | SQL Server 2022 (16.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Query's uitvoeren op CSV-bestanden met een externe tabel | Een externe tabel maken met een bestandstype voor door scheidingstekens gescheiden tekst | SQL Server 2019 (15.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Queries uitvoeren op Delta Lake-tabellen | Een externe tabel maken met FILE_FORMAT = DeltaLakeFileFormat |
SQL Server 2022 (16.x) en latere versies |
| Queryresultaten exporteren naar Parquet- of CSV-bestanden (CETAS) | Gebruik CREATE EXTERNAL TABLE AS SELECT |
SQL Server 2022 (16.x) en latere versies, Azure SQL Managed Instance |
- Voor een snelle ad hoc-query op een Parquet- of CSV-bestand, gebruik
OPENROWSET. Deze methode vereist geen externe tafel. SQL Server 2022 (16.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance en SQL database in Fabric ondersteunen dit patroon. - Voor herhaalde queries op Parquet-bestanden met een persistent schema gebruik je een externe tabel over Parquet. SQL Server 2022 (16.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance en SQL database in Fabric ondersteunen dit patroon.
- Voor een query op CSV-bestanden gebruik je een externe tabel met een bestandsformaat voor gescheiden tekst. SQL Server 2019 (15.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance en SQL database in Fabric ondersteunen dit patroon.
- Voor een query op Delta Lake-tabellen gebruik je een externe tabel met
FILE_FORMAT = DeltaLakeFileFormat. SQL Server 2022 (16.x) en latere versies ondersteunen dit patroon. - Voor het exporteren van zoekresultaten naar Parquet- of CSV-bestanden, gebruik
CREATE EXTERNAL TABLE AS SELECT. SQL Server 2022 (16.x) en latere versies en Azure SQL Managed Instance ondersteunen dit patroon.
U kunt ook een van deze stapsgewijze zelfstudies volgen:
| Handleiding | Beschrijving |
|---|---|
| Aan de slag met PolyBase in SQL Server 2022 | Omvat OPENROWSET met Parquet en CSV, externe tabellen en bestandsmapnavigatie. |
| Parquet-bestand virtualiseren in een met S3 compatibele objectopslag met PolyBase | Zelfstudie voor SQL Server 2022 (16.x) en latere versies. |
| CSV-bestand virtualiseren met PolyBase | Zelfstudie voor SQL Server 2022 (16.x) en latere versies. |
| Deltatabel virtualiseren met PolyBase | Zelfstudie voor SQL Server 2022 (16.x) en latere versies. |
| Gegevensvirtualisatie met Azure SQL Database (preview) | Azure SQL Database-gids voor Parquet en CSV. |
| Gegevensvirtualisatie met Azure SQL Managed Instance | Handleiding voor Azure SQL Managed Instance voor Parquet, CSV en CETAS. |
| Datavirtualisatie in SQL-database binnen Fabric | SQL Database in Fabric-handleiding voor OneLake-bestanden. |
Verbinding maken met een ander SQL Server-exemplaar, Azure SQL Database of SQL Managed Instance
In SQL Server 2019 (15.x) en latere versies kan PolyBase query's uitvoeren op tabellen in een ander SQL Server-exemplaar, Azure SQL Database of Azure SQL Managed Instance, zonder gekoppelde servers te gebruiken.
Belangrijk
De sqlserver:// connector wordt niet ondersteund in SQL Database in Fabric. PolyBase RDBMS-connectors gebruiken SQL-verificatie via CREATE DATABASE SCOPED CREDENTIAL en bieden geen ondersteuning voor Microsoft Entra ID, Managed Identity of service-principalverificatie. Omdat voor SQL-database in Fabric Microsoft Entra-verificatie is vereist, kunt u er geen verbinding mee maken via PolyBase.
| Stap | Wat u moet doen |
|---|---|
| 1. PolyBase installeren | PolyBase installeren in Windows of PolyBase installeren op Linux |
| 2. Een referentie maken |
CREATE DATABASE SCOPED CREDENTIAL met de doelaanmelding |
| 3. Een externe gegevensbron maken | CREATE EXTERNAL DATA SOURCE ... WITH (LOCATION = 'sqlserver://<server>') |
| 4. Een externe tabel maken | CREATE EXTERNAL TABLE ... WITH (LOCATION = '<db>.<schema>.<table>') |
| 5. Opzoeking | SELECT * FROM <external_table> |
-
- Installeer PolyBase op Windows of Linux door Install PolyBase on Windows te gebruiken of PolyBase op Linux te installeren voordat je toegang tot externe SQL-data configureert.
-
- Maak een database-scoped credential aan met de doellogin door te gebruiken
CREATE DATABASE SCOPED CREDENTIALzodat de engine kan authenticeren bij de externe server.
- Maak een database-scoped credential aan met de doellogin door te gebruiken
-
- Maak een externe databron aan voor de externe SQL Server door gebruik te maken van
CREATE EXTERNAL DATA SOURCE ... WITH (LOCATION = 'sqlserver://<server>').
- Maak een externe databron aan voor de externe SQL Server door gebruik te maken van
-
- Maak een externe tabel aan door te gebruiken
CREATE EXTERNAL TABLE ... WITH (LOCATION = '<db>.<schema>.<table>')om de externe tabel te representeren.
- Maak een externe tabel aan door te gebruiken
-
- Raadpleeg de externe tabel met behulp van
SELECT * FROM <external_table>.
- Raadpleeg de externe tabel met behulp van
Aanbeveling
De SQL Server-connector (sqlserver://) werkt ook voor Azure SQL Database en Azure SQL Managed Instance. Gebruik dezelfde stappen en stel LOCATION in op het Azure SQL Database- of Azure SQL Managed Instance-eindpunt (bijvoorbeeld sqlserver://myserver.database.windows.net).
Zie PolyBase configureren voor toegang tot externe gegevens in SQL Server voor een gedetailleerde handleiding.
Verbinding maken met Oracle, Teradata of MongoDB
SQL Server 2019 (15.x) en latere versies kunnen query's uitvoeren op Oracle, Teradata, MongoDB en Cosmos DB via PolyBase ODBC-connectors.
| Gegevensbron | Guide | Requirements |
|---|---|---|
| Oracle | PolyBase configureren voor toegang tot externe gegevens in Oracle | SQL Server 2019 (15.x) en latere versies, Oracle-clientstuurprogramma's |
| Teradata | PolyBase configureren voor toegang tot externe gegevens in Teradata | SQL Server 2019 (15.x) en latere versies, Teradata ODBC-stuurprogramma |
| MongoDB/Cosmos DB | PolyBase configureren voor toegang tot externe gegevens in MongoDB | SQL Server 2019 (15.x) en latere versies, MongoDB ODBC-stuurprogramma |
| Elke ODBC-bron | PolyBase configureren voor toegang tot externe gegevens met algemene ODBC-typen | SQL Server 2019 (15.x) en latere versies (Windows) (Linux beginnend met SQL Server 2025 (17.x)) |
- Oracle-databronnen gebruiken de Configure PolyBase om externe data in de Oracle-gids te benaderen en vereisen SQL Server 2019 (15.x) en latere versies en Oracle-clientdrivers.
- Teradata-databronnen gebruiken de Configure PolyBase om externe data te benaderen in de Teradata-gids en vereisen SQL Server 2019 (15.x) en latere versies en de Teradata ODBC-driver.
- MongoDB- of Cosmos DB-databronnen gebruiken de Configure PolyBase om externe data in de MongoDB-gids te benaderen en vereisen SQL Server 2019 (15.x) en latere versies en de MongoDB ODBC-driver.
- Elke ODBC-bron kan de Configure PolyBase gebruiken om externe data te benaderen met de ODBC generieke types-gids en vereist SQL Server 2019 (15.x) en latere versies op Windows of SQL Server 2025 (17.x) en latere versies op Linux.
Verbinding maken met Azure Blob Storage of ADLS Gen2
| SQL-platform | Verificatieopties | Guide |
|---|---|---|
| SQL Server 2022 (16.x) en latere versies | SAS-token, toegangssleutel, beheerde identiteit (vanaf SQL Server 2025 (17.x)) | PolyBase configureren voor toegang tot externe gegevens in Azure Blob Storage |
| SQL Server 2019 (15.x) | Toegangssleutel (via Hadoop-connector) | PolyBase configureren voor toegang tot externe gegevens in Azure Blob Storage |
| Azure SQL Database | SAS-token, Beheerde identiteit, Microsoft Entra pass-through | Gegevensvirtualisatie met Azure SQL Database (preview) |
| Azure SQL Managed Instance (een beheerde database-instantie van Azure) | SAS-token, beheerde identiteit | Gegevensvirtualisatie met Azure SQL Managed Instance |
- SQL Server 2022 en latere versies ondersteunen Azure Blob Storage- of ADLS Gen2-authenticatie door gebruik te maken van SAS-tokens, toegangssleutels of Managed Identity vanaf SQL Server 2025 (17.x). Zie PolyBase configureren voor toegang tot externe gegevens in Azure Blob Storage voor meer informatie.
- SQL Server 2019 ondersteunt Azure Blob Storage of ADLS Gen2 door gebruik te maken van een toegangssleutel via de Hadoop-connector. Zie PolyBase configureren voor toegang tot externe gegevens in Azure Blob Storage voor meer informatie.
- Azure SQL Database ondersteunt Azure Blob Storage of ADLS Gen2 door gebruik te maken van SAS-tokens, Managed Identity of Microsoft Entra pass-through authenticatie. Zie Gegevensvirtualisatie met Azure SQL Database (preview) voor meer informatie.
- Azure SQL Managed Instance ondersteunt Azure Blob Storage of ADLS Gen2 door gebruik te maken van SAS-tokens of Managed Identity. Zie Gegevensvirtualisatie met Azure SQL Managed Instance voor meer informatie.
In SQL Server 2022 (16.x) zijn de URI-voorvoegsels gewijzigd. Wanneer u migreert vanuit SQL Server 2019 (15.x) of eerdere versies:
-
Azure Blob Storage: wijzigen
wasb[s]://inabs:// -
ADLS Gen2: wijzigen
abfs[s]://inadls://
Zie PolyBase configureren voor toegang tot externe gegevens in Azure Blob Storage voor meer informatie.
Verbinding maken met S3-compatibele objectopslag
SQL Server 2022 (16.x) en latere versies ondersteunen S3-compatibele opslag, zoals Amazon S3, MinIO en Ceph.
Zie PolyBase configureren voor toegang tot externe gegevens in S3-compatibele objectopslag voor meer informatie.
Gegevens exporteren met CREATE EXTERNAL TABLE AS SELECT (CETAS)
CETAS voert de export uit van queryresultaten naar externe bestanden (Parquet of CSV) in Azure Blob Storage, ADLS Gen2 of S3-compatibele opslag.
| SQL-platform | Ondersteund | Exportformaten | Aantekeningen |
|---|---|---|---|
| SQL Server 2022 (16.x) en latere versies. Export naar ADLS Gen2 met CETAS vereist SQL Server 2022 CU5 of een nieuwere versie. | Ja | Parket, CSV | Vereist serverconfiguratie: laat polybase-export toe. |
| Azure SQL Managed Instance (een beheerde database-instantie van Azure) | Ja | Parket, CSV | Standaard uitgeschakeld |
| Azure SQL Database | No | Geen | Niet beschikbaar |
| Een SQL-database in Fabric | No | Geen | Niet beschikbaar |
- SQL Server 2022 en latere versies ondersteunen CETAS en exporteren Parquet- en CSV-bestanden. De serverconfiguratie: polybase export-instelling toestaan is vereist. CETAS-export naar ADLS Gen2 is niet beschikbaar in SQL Server 2022-releases vóór CU5.
- Azure SQL Managed Instance ondersteunt CETAS en exporteert Parquet- en CSV-bestanden. De standaard Uitgeschakelde richtlijn beschrijft de standaardtoestand.
- Azure SQL Database ondersteunt CETAS niet.
- De SQL-database in Fabric ondersteunt CETAS niet.
Zie (CETAS) voor de Transact-SQL-verwijzingCREATE EXTERNAL TABLE AS SELECT.
Voorbeelden van snel starten
Voorbeeld 1: Ad-hoc-query voor een Parquet-bestand (OPENROWSET)
Er is geen externe tabel nodig. Werkt op SQL Server 2022 (16.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance en SQL Database in Fabric.
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet',
    FORMAT = 'PARQUET'
) AS [result];
Voorbeeld 2: Externe tabel via CSV in Azure Blob Storage
Dit voorbeeld werkt op alle SQL-platforms die externe tabellen ondersteunen over CSV-bestanden.
Stap 1: Een databasehoofdsleutel (DMK) maken. Deze stap is vereist omdat met de referentie een SAS-tokengeheim wordt opgeslagen. Je kunt deze stap echter overslaan als je Managed Identity of Microsoft Entra-authenticatie gebruikt.
CREATE MASTER KEY ENCRYPTION BY PASSWORD = '<password>';Stap 2: Maak een referentie met een SAS-token. Laat de voorafgaande
?weg.CREATE DATABASE SCOPED CREDENTIAL MyStorageCred WITH IDENTITY = 'SHARED ACCESS SIGNATURE', SECRET = '<your_SAS_token>'; -- omit the leading '?'Stap 3: Een externe gegevensbron maken.
CREATE EXTERNAL DATA SOURCE MyAzureStorage
WITH (
    LOCATION = 'abs://mycontainer@mystorageaccount.blob.core.windows.net',
    CREDENTIAL = MyStorageCred
);
Stap 4: Maak een bestandsindeling voor het CSV-bestand.
CREATE EXTERNAL FILE FORMAT CsvFormat
WITH (
    FORMAT_TYPE = DELIMITEDTEXT,
    FORMAT_OPTIONS (
        FIELD_TERMINATOR = ',',
        STRING_DELIMITER = '"',
        FIRST_ROW = 2
    )
);
Stap 5: Maak de externe tabel.
CREATE EXTERNAL TABLE dbo.SalesExternal
(
    OrderId INT,
    OrderDate DATE,
    Amount DECIMAL (18, 2),
    Customer NVARCHAR (100)
)
WITH (
    DATA_SOURCE = MyAzureStorage,
    LOCATION = '/data/sales/',
    FILE_FORMAT = CsvFormat
);
Stap 6: Voer een query uit op de externe tabel.
SELECT *
FROM dbo.SalesExternal
WHERE OrderDate >= '2025-01-01';
Voorbeeld 3: Een query uitvoeren op een tabel in een andere SQL Server
Dit voorbeeld werkt in SQL Server 2019 (15.x) en latere versies.
Stap 1: Maak een databasehoofdsleutel (vereist omdat de referentie een wachtwoord opslaat).
CREATE MASTER KEY ENCRYPTION
BY PASSWORD = '<password>';
Stap 2: Maak een referentie voor het externe SQL Server-exemplaar.
CREATE DATABASE SCOPED CREDENTIAL RemoteSqlCred
WITH IDENTITY = 'remote_user',
     SECRET = '<password>';
Stap 3: Maak de externe gegevensbron.
CREATE EXTERNAL DATA SOURCE RemoteSqlServer
WITH (
    LOCATION = 'sqlserver://remote-server.contoso.com',
    PUSHDOWN = ON,
    CREDENTIAL = RemoteSqlCred
);
Stap 4: Maak de externe tabel aan (met de driedelige naam in
LOCATION).CREATE EXTERNAL TABLE dbo.RemoteCustomers ( CustomerId INT, CustomerName NVARCHAR (200) COLLATE SQL_Latin1_General_CP1_CI_AS ) WITH ( DATA_SOURCE = RemoteSqlServer, LOCATION = 'SalesDB.dbo.Customers' );Stap 5: Query uitvoeren op servers.
SELECT c.CustomerName,
       s.Amount
FROM dbo.RemoteCustomers AS c
     INNER JOIN dbo.LocalSales AS s
         ON c.CustomerId = s.CustomerId;
Voorbeeld 4: Resultaten exporteren naar Parquet met CETAS
Werkt op SQL Server 2022 (16.x) en latere versies, Azure SQL Managed Instance.
Stap 1: CETAS inschakelen (alleen SQL Server).
EXECUTE sp_configure 'allow polybase export', 1;
RECONFIGURE;
Stap 2: Referentie en gegevensbron maken (hergebruik uit eerdere voorbeelden).
Stap 3: Maak een bestandsindeling voor Parquet-export.
CREATE EXTERNAL FILE FORMAT ParquetFormat
WITH (
    FORMAT_TYPE = PARQUET
);
Stap 4: Queryresultaten exporteren.
CREATE EXTERNAL TABLE dbo.Sales2025Export
WITH (
    DATA_SOURCE = MyAzureStorage,
    LOCATION = '/exports/sales_2025.parquet',
    FILE_FORMAT = ParquetFormat
) AS
SELECT *
FROM Sales.Orders
WHERE OrderDate >= '2025-01-01';
T-SQL-bouwstenen voor PolyBase
Voordat u een scenario implementeert, moet u inzicht hebben in de T-SQL-kernobjecten die PolyBase gebruikt en hoe ze bij elkaar passen:
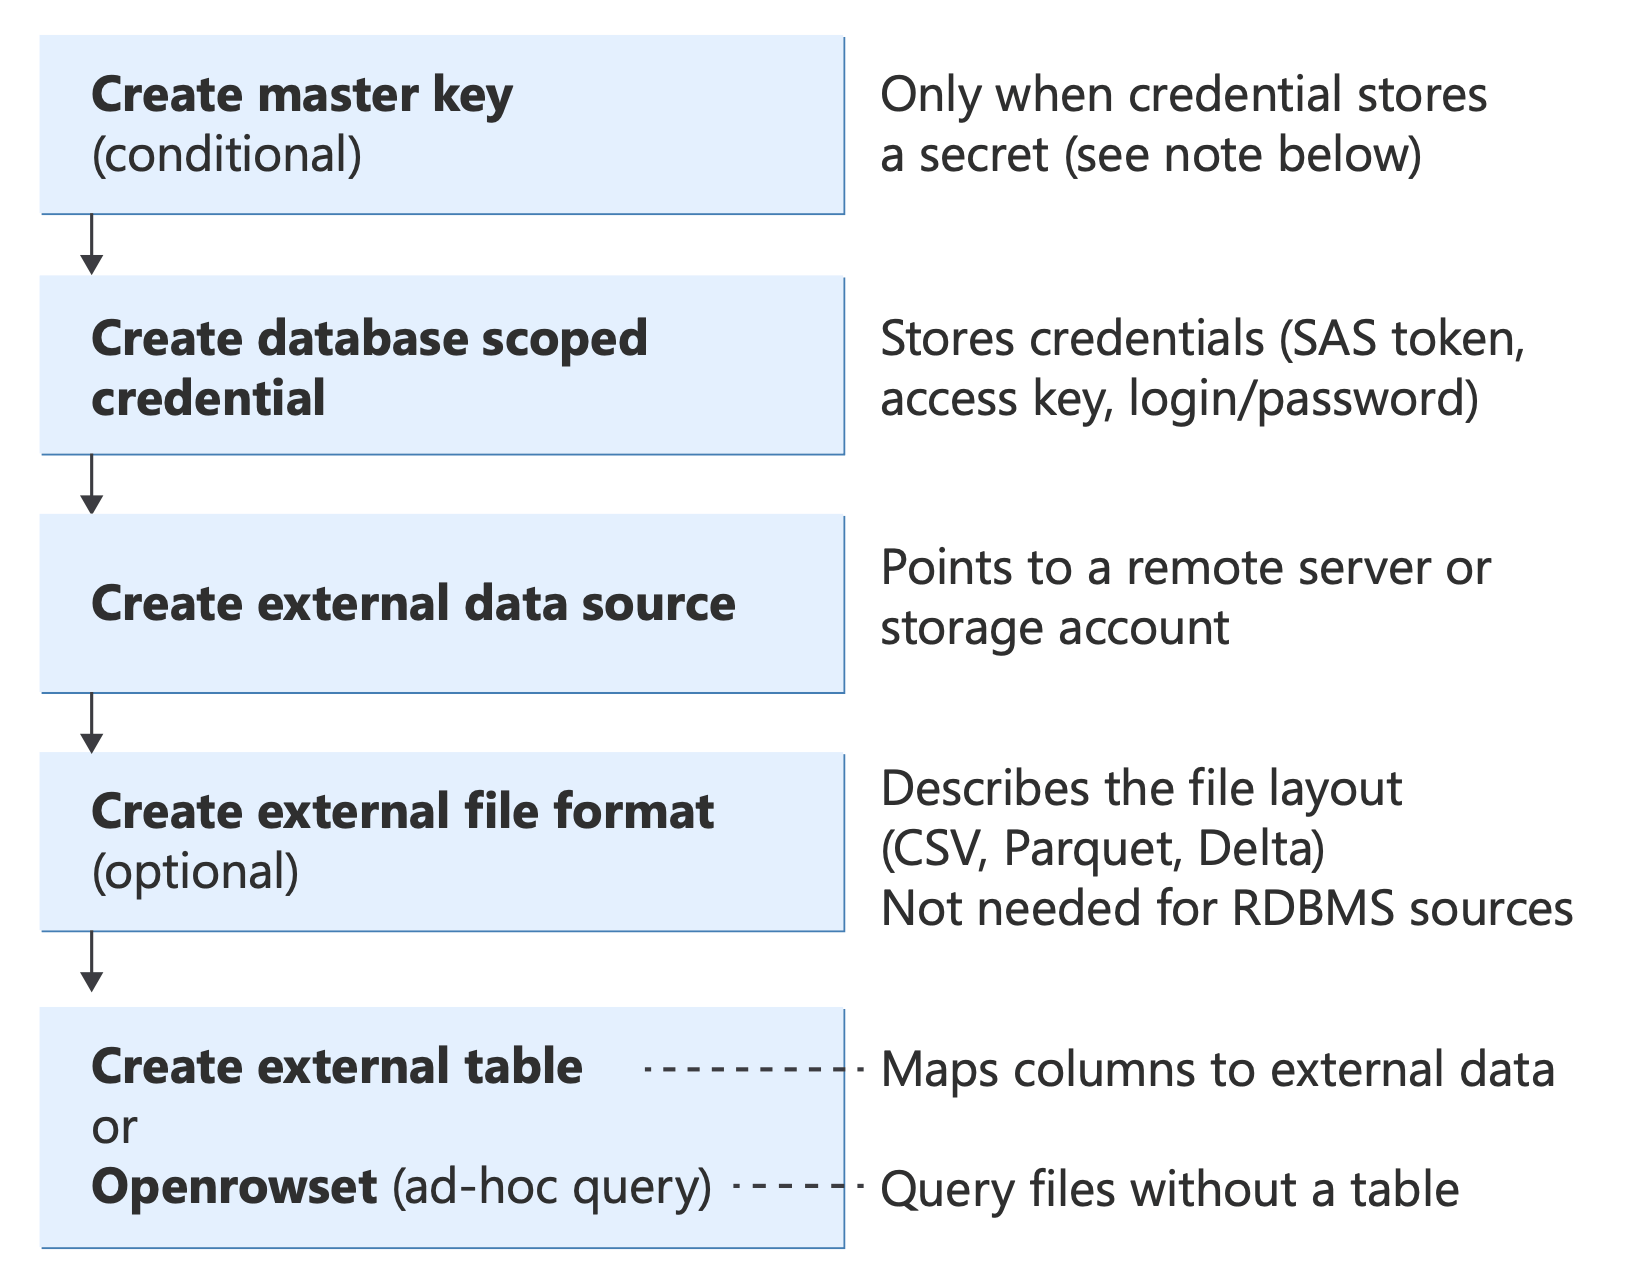
Diagram met PolyBase T-SQL-objecten en hun relaties, van verificatie (databasehoofdsleutel, referenties) via gegevensbronnen en bestandsindelingen tot querymethoden (externe tabel, OPENROWSET, BULK INSERTCETAS).
- Voor syntaxis van externe databronnen, zie CREATE EXTERNAL DATA SOURCE.
- Voor syntaxis van externe bestandsformaat, zie CREATE EXTERNAL FILE FORMAT.
- Voor externe tabelsyntaxis, zie CREATE EXTERNAL TABLE.
- Voor ad-hoc data-toegangssyntaxis, zie OPENROWSET.
- Voor CETAS-syntaxis, zie CREATE EXTERNAL TABLE AS SELECT (CETAS).
Zie voor een volledige Transact-SQL-referentie voor alle objecten de PolyBase Transact-SQL naslaginformatie.
Belangrijk
Controleer de toewijzing van het gegevenstype voor uw externe bestandsindeling. Wanneer u een externe bestandsindeling maakt of query's uitvoert op bestanden met behulp van OPENROWSETPolyBase, worden brongegevenstypen (Parquet, CSV, Delta, Oracle, Teradata, MongoDB) automatisch toegewezen aan SQL Server-gegevenstypen. Ongelijksoortige typen kunnen onopgemerkte afkorting, precisieverlies of queryfouten veroorzaken. Een Parquet DECIMAL(38,18) komt bijvoorbeeld overeen met DECIMAL(18,0). Controleer de toewijzingstabellen voordat u externe tabelkolommen of een WITH clausule definieert. Zie Typetoewijzing met PolyBase voor de volledige referentie.
Wanneer heb je het nodig CREATE MASTER KEY?
Er wordt een DMK (Database Master Key) gemaakt met behulp van CREATE MASTER KEY de syntaxis. De DMK versleutelt de geheimen die zijn opgeslagen in database-specifieke inloggegevens. Dit is alleen vereist wanneer de referentie een geheime waarde bevat, dat wil gezegd, wanneer een wachtwoord, token of toegangssleutel wordt opgeslagen.
DMK is vereist (authenticatiereferenties bevatten een geheim):
Verificatietype IDENTITYwaardeHeeft geheim DMK SAS-token 'SHARED ACCESS SIGNATURE'Ja Verplicht S3-toegangssleutel 'S3 ACCESS KEY'Ja Verplicht SQL-aanmelding/basisverificatie '<username>'Ja Verplicht Toegangssleutel voor opslagaccount '<storage_account_name>'Ja Verplicht - Een SAS-tokencredential gebruikt
IDENTITY = 'SHARED ACCESS SIGNATURE'en slaat een geheime waarde op, dus het vereist een database-hoofdsleutel. - Een S3-toegangssleutelcredential gebruikt
IDENTITY = 'S3 ACCESS KEY'en slaat een geheime waarde op, dus het vereist een database-hoofdsleutel.- Een SQL-login of een basisauthenticatiecredential gebruikt
IDENTITY = '<username>'en slaat een geheime waarde op, dus het vereist een database-hoofdsleutel.
- Een SQL-login of een basisauthenticatiecredential gebruikt
- Het toegangssleutel-credential van een opslagaccount gebruikt
IDENTITY = '<storage_account_name>'en slaat een geheime waarde op, dus het vereist een database-hoofdsleutel.
- Een SAS-tokencredential gebruikt
DMK is niet vereist (geen geheim opgeslagen):
Verificatietype IDENTITYwaardeHeeft geheim DMK Beheerde identiteit 'Managed Identity'No Niet vereist Microsoft Entra ID 'User Identity'of'Managed Identity'No Niet vereist - Een Managed Identity-credential gebruikt
IDENTITY = 'Managed Identity'en slaat geen geheim op, dus het vereist geen database-hoofdsleutel. - Een Microsoft Entra ID-credential gebruikt
IDENTITY = 'User Identity'ofIDENTITY = 'Managed Identity'en slaat geen geheim op, dus het vereist geen database-hoofdsleutel.
- Een Managed Identity-credential gebruikt
Aanbeveling
Als je CREATE DATABASE SCOPED CREDENTIAL-statement geen geheim bevat, heb je geen DMK nodig. Managed Identity en Microsoft Entra ID-verificatie delegeren vertrouwen aan het platform. In de database worden geen wachtwoorden of tokens opgeslagen.
Voorbeelden:
In deze voorbeeldquery is de DMK vereist (de inloggegevens slaan een SAS-token op).
CREATE MASTER KEY ENCRYPTION BY PASSWORD = '<password>';

CREATE DATABASE SCOPED CREDENTIAL SasCred
WITH IDENTITY = 'SHARED ACCESS SIGNATURE',
     SECRET = '<your_SAS_token>';
In deze voorbeeldquery is de DMK niet vereist (Beheerde identiteit, geen geheim).
CREATE DATABASE SCOPED CREDENTIAL ManagedIdentityCred
WITH IDENTITY = 'Managed Identity';
In deze voorbeeldquery is de DMK niet vereist (Microsoft Entra pass-through, geen geheim).
CREATE DATABASE SCOPED CREDENTIAL EntraIdCred
WITH IDENTITY = 'User Identity';
Externe gegevenstoegang met OPENROWSET en externe tabellen
SQL Server biedt drie verschillende benaderingen voor het uitvoeren van query's op externe gegevens. U kunt de juiste benadering kiezen wanneer u de verschillen in syntaxis, verificatie en architectuur begrijpt.
| Methode | Syntaxis | Verbinding maken met | Authentication | PolyBase-services | Platforms |
|---|---|---|---|---|---|
| OLE DB-query's | OPENROWSET(provider, connection, query) |
Een OLE DB-bron via MSOLEDBSQL, SQLOLEDB of andere providers | SQL-verificatie, Windows-verificatie, Microsoft Entra ID (MSOLEDBSQL) | No | SQL Server (alle ondersteunde versies) |
| Query's op bestanden in SQL Server 2022 (16.x) en SQL Server 2019 (15.x) | OPENROWSET(BULK ...) |
Bestanden op lokale schijf, netwerk of cloud (Azure Blob, ADLS, S3, OneLake) | SAS-token, toegangssleutel, Beheerde identiteit, Microsoft Entra-id | Ja voor cloud 1; Nee voor lokaal | SQL Server 2022 (16.x) en SQL Server 2019 (15.x) |
| Bestandsqueries in SQL Server 2025 (17.x) en latere versies | OPENROWSET(BULK ...) |
Bestanden op lokale schijf, netwerk of cloud (Azure Blob, ADLS, S3, OneLake) | SAS-token, toegangssleutel, Beheerde identiteit, Microsoft Entra-id | No | SQL Server 2022 (16.x) en latere versies, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| PolyBase-connectoren |
CREATE EXTERNAL TABLE met CREATE EXTERNAL DATA SOURCE door gebruik te maken van sqlserver://, oracle://, teradata://, mongodb://, odbc:// |
Externe SQL Server, Oracle, Teradata, MongoDB, ODBC-bronnen | Alleen SQL-verificatie | Ja | SQL Server 2019 (15.x) en latere versies (Windows); SQL Server 2025 (17.x) en latere versies (Linux) |
1 Voor toegang tot cloudbestanden in SQL Server 2022 (16.x) moet de PolyBase-functie worden geïnstalleerd.
- OLE DB-queries worden gebruikt
OPENROWSET(provider, connection, query)om verbinding te maken met elke OLE DB-bron via MSOLEDBSQL, SQLOLEDB of een andere provider op alle ondersteunde versies van SQL Server. Ze ondersteunen SQL-authenticatie, Windows authentication en Microsoft Entra ID met MSOLEDBSQL, en ze vereisen geen installatie van PolyBase-diensten. - Bestandsquery's gebruiken
OPENROWSET(BULK ...)om bestanden te lezen vanaf een lokale schijf, netwerkshares of cloudopslag, zoals Azure Blob Storage, ADLS, S3 of OneLake, met een SAS-token, toegangssleutel, Managed Identity of Microsoft Entra ID. Ze worden ondersteund voor lokale en netwerkbestanden in SQL Server 2005 en latere versies, voor cloudbestanden in SQL Server 2022 (16.x) en latere versies, en in Azure SQL Database, Azure SQL Managed Instance en SQL database in Fabric. Bestandsquery's vereisen geen PolyBase-diensten voor lokale bestanden of voor bestanden in de cloud in SQL Server 2022 (16.x) en latere versies. - PolyBase-connectoren gebruiken
CREATE EXTERNAL TABLEmetCREATE EXTERNAL DATA SOURCEen desqlserver://,oracle://,teradata://,mongodb://, ofodbc://locatie om verbinding te maken met externe SQL Server, Oracle, Teradata, MongoDB of ODBC-bronnen. Ze vereisen SQL-authenticatie en PolyBase-diensten in SQL Server 2019 (15.x) en latere versies op Windows en SQL Server 2025 (17.x) en latere versies op Linux. Voor meer informatie, zie CREATE EXTERNAL DATA SOURCE (Transact-SQL).
Wanneer moet u elke benadering gebruiken
OLE DB OPENROWSET gebruiken voor:
- Gebruik OLE DB
OPENROWSETvoor snelle, eenmalige ad hoc queries zonder persistente objecten aan te maken. - Gebruik OLE DB
OPENROWSETvoor Microsoft Entra ID of Managed Identity-authenticatie via MSOLEDBSQL. - Gebruik OLE DB
OPENROWSETom afhankelijkheden van PolyBase-diensten te voorkomen. - Gebruik OLE DB
OPENROWSETom verbinding te maken met elke databron die een OLE DB-provider heeft.
Gebruik File OPENROWSET(BULK) voor:
- Gebruik het bestand
OPENROWSET(BULK ...)voor ad-hoc bestandsverkenning en schema-ontdekking. - Gebruik het bestand
OPENROWSET(BULK ...)voor snelle transformaties en previews voordat je een tabeldefinitie maakt. - Gebruik het bestand
OPENROWSET(BULK ...)voor flexibele inline kolomtransformaties zoals casting, filtering en berekende kolommen. - Gebruik een bestand
OPENROWSET(BULK ...)voor data die niet vaak verandert en geen persistente metadata nodig heeft.
Gebruik PolyBase-connectors met CREATE EXTERNAL TABLE voor:
- Gebruik PolyBase-connectors met
CREATE EXTERNAL TABLEvoor permanente, herbruikbare tabeldefinities die door meerdere gebruikers of toepassingen worden geopend. - Gebruik PolyBase-connectoren met
CREATE EXTERNAL TABLEvoor productieworkloads die statistieken en optimalisatie van queryplannen vereisen. - Gebruik PolyBase-connectoren
CREATE EXTERNAL TABLEvoor pushdown-berekeningen naar externe bronnen zoals Oracle en SQL Server. - Gebruik PolyBase-connectoren met
CREATE EXTERNAL TABLEvoor gedeeld beheer en beveiliging; nadat de tabel is gemaakt, hebben gebruikers alleen de machtigingSELECTnodig. - Gebruik PolyBase-connectoren wanneer
CREATE EXTERNAL TABLESQL-authenticatie beschikbaar is voor de externe bron.
OPENROWSET (OLE DB) - ad hoc externe queries (geen PolyBase-services vereist)
De OLE DB-vorm van OPENROWSET verbindt met een externe gegevensbron via een OLE DB-provider, voert een passthrough-query uit en retourneert de resultaten als een gegevensset. Het is een eenmalig ad-hoc alternatief voor een gekoppelde server. Er worden geen permanente metagegevens gemaakt. Voor deze syntaxis zijn geen PolyBase-services vereist en worden geen cloudbestanden of externe gegevensbronnen ondersteund.
Deze voorbeeldquery maakt verbinding met een externe SQL Server via OLE DB (niet PolyBase).
SELECT *
FROM OPENROWSET (
    'MSOLEDBSQL',
    'Server=remote-server;Database=AdventureWorks;Trusted_Connection=yes;',
    'SELECT TOP 10 * FROM AdventureWorks.Sales.SalesOrderHeader'
);
OPENROWSET(BULK) - bestandgebaseerde queries (PolyBase)
De BULK vorm van OPENROWSET leest gegevens rechtstreeks uit bestanden. In SQL Server 2019 (15.x) en eerdere versies wordt het gelezen uit lokale of UNC-bestandspaden en is een indelingsbestand vereist. In SQL Server 2022 (16.x) en latere versies kunt u lezen uit cloudopslag met behulp van de DATA_SOURCE en FORMAT parameters. Deze benadering is de geïntegreerde PolyBase-versie die wordt gebruikt voor gegevensvirtualisatie.
In de context van PolyBase en gegevensvirtualisatie betekent deze handleiding dat wanneer wordt verwezen naar OPENROWSET, het gaat om de syntaxis OPENROWSET(BULK ...) met een clausule FORMAT voor het uitvoeren van query's op externe bestanden.
Voorbeelden:
Deze voorbeeldquery leest een Parquet-bestand uit Azure Blob Storage (SQL Server 2022 en latere versies).
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'data/sales/*.parquet',
    DATA_SOURCE = 'MyAzureStorage',
    FORMAT = 'PARQUET'
) AS [result];
Deze voorbeeldquery leest een Parquet-bestand met een inlinepad (Azure SQL Database, Azure SQL Managed Instance).
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet',
    FORMAT = 'PARQUET'
) AS [result];
Wanneer gebruikt u OPENROWSET versus externe tabellen
Met beide OPENROWSET(BULK ...) en externe tabellen kunt u query's uitvoeren op externe gegevens met T-SQL, maar ze zijn ontworpen voor verschillende gebruiksvoorbeelden. De volgende tabel bevat een overzicht van de belangrijkste verschillen waarmee u kunt bepalen welke benadering past bij uw scenario.
| Vermogen | OPENROWSET(BULK ...) |
Externe tabel |
|---|---|---|
| Purpose | Ad-hoconderzoek en eenmalige query's | Permanente, herbruikbare tabeldefinitie |
| Metagegevens die zijn opgeslagen in database | Nee. Er wordt niets opgeslagen nadat de query is uitgevoerd | Ja. De tabeldefinitie, gegevensbron en bestandsindeling worden opgeslagen als databaseobjecten |
| Schemadefinitie | Automatisch afgeleid uit het bestand (Parquet) of opgegeven inline met een WITH clausule |
Expliciet gedefinieerd in de CREATE EXTERNAL TABLE instructie |
| toestemmingen | Vereist ADMINISTER BULK OPERATIONS of ADMINISTER DATABASE BULK OPERATIONS |
Zodra de tabel is gemaakt, is de standaardmachtiging SELECT voor de tabel voldoende |
| Berekende kolommen | Ja. Voeg expressies en berekende kolommen toe in de SELECT lijst; metagegevensfuncties zoals filename() en filepath() zijn hier alleen beschikbaar. |
Nee. Vaste kolomlijst; transformaties uitvoeren in een weergave of in de query die de externe tabel leest |
| statistieken | Azure SQL Managed Instance: handmatige statistieken met één kolom via sys.sp_create_openrowset_statistics. Zie handmatige statistieken van OPENROWSET. SQL Server 2022 (16.x) en latere versies, Azure SQL Database, SQL-database in Fabric: statistieken automatisch maken voor predicaten. Handmatige OPENROWSET statistieken worden niet ondersteund op SQL Server. |
Volledige CREATE STATISTICS ondersteuning op alle platforms, plus automatisch maken in SQL Server 2022 (16.x) en nieuwere versies. Zie Handmatige statistieken voor externe tabellen maken. |
| Pushdown | Beperkte ondersteuning. De engine kan filters naar beneden pushen naar de bestandsscan, maar er is geen pushdown naar externe RDBMS-bronnen | Ja. Ondersteunt pushdownberekeningen voor RDBMS-connectors (SQL Server, Oracle, Teradata, MongoDB) |
| Het beste voor | Gegevensverkenning, schemadetectie, prototypequery's, eenmalige gegevensbelastingen, flexibele transformaties | Productieworkloads, herhaalde query's, gedeelde toegang voor gebruikers, dashboards en rapportage |
-
OPENROWSET(BULK ...)is het beste voor ad-hoc verkenning en eenmalige queries, terwijl een externe tabel beter is voor persistente, herbruikbare tabeldefinities. -
OPENROWSET(BULK ...)slaat metadata niet op in de database nadat de query is uitgevoerd, terwijl een externe tabel de tabeldefinitie, gegevensbron en bestandsformaat als databaseobjecten opslaat. -
OPENROWSET(BULK ...)leidt het schema automatisch af uit een Parquet-bestand of definieert het schema inline met eenWITHclausule, terwijl een externe tabel het schema expliciet in deCREATE EXTERNAL TABLEinstructie definieert. -
OPENROWSET(BULK ...)vereistADMINISTER BULK OPERATIONSofADMINISTER DATABASE BULK OPERATIONS, terwijl een externe tabel kan worden bevraagd door gebruikers die alleen standaardtoestemmingSELECTnodig hebben zodra de tabel bestaat. -
OPENROWSET(BULK ...)ondersteunt berekende kolommen in de query- en metadatafuncties zoalsfilename()enfilepath(), terwijl een externe tabel een vaste kolomlijst heeft en transformaties vereist in een weergave of in de query die de externe tabel leest. -
OPENROWSET(BULK ...)heeft beperkte ondersteuning voor statistiek: Azure SQL Managed Instance kan worden gebruiktsys.sp_create_openrowset_statisticsvoor statistieken met één kolom, maar SQL Server 2022 (16.x) en latere versies, Azure SQL Database en SQL Database in Fabric creëren automatisch statistieken op predicaten. HandmatigeOPENROWSETstatistieken worden niet ondersteund op SQL Server, Azure SQL Database en SQL Database in Fabric. Een externe tabel ondersteunt volledigeCREATE STATISTICSfunctionaliteit op alle platforms plus automatische statistieken in SQL Server 2022 (16.x) en latere versies, Azure SQL Database en SQL database in Fabric. Zie handmatige statistieken voor OPENROWSET en handmatige statistieken voor externe tabellen maken. -
OPENROWSET(BULK ...)ondersteunt beperkte pushdown en geen pushdown naar remote RDBMS-bronnen, terwijl een externe tabel pushdown-verwerking voor RDBMS-connectoren ondersteunt. -
OPENROWSET(BULK ...)Is het beste voor data-exploratie, schema-ontdekking, prototyping, eenmalige ladingen en flexibele transformaties, terwijl een externe tabel het beste is voor productieworkloads, herhaalde queries, gedeelde toegang, dashboards en rapportage.
OPENROWSET gebruiken wanneer u flexibiliteit nodig hebt
Gebruik OPENROWSET dit om een bestand te verkennen, verschillende schema's te testen of berekende kolommen en transformaties toe te voegen zonder permanente objecten te maken. U kunt bijvoorbeeld het bestandspad extraheren als een kolom, gegevenstypen inline casten of filteren op berekende expressies in één query.
Deze voorbeeldquery bevat berekende kolommen en transformaties:
SELECT result.filename() AS [FileName],
       result.filepath(1) AS [Year],
       result.filepath(2) AS [Month],
       CAST (OrderDate AS DATE) AS OrderDate,
       Amount,
       OrderDate
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*/*/*/*.parquet',
    FORMAT = 'PARQUET'
) AS result
WHERE result.filepath(1) = '2025';
Aanbeveling
De filepath() en filename() functies zijn beschikbaar in Azure SQL Database, Azure SQL Managed Instance en SQL Server 2022 (16.x) en latere versies. Hiermee kunt u filteren op delen van het bestandspad (partitie-verwijdering) en de naam van het bronbestand beschikbaar maken als een kolom, wat niet rechtstreeks mogelijk is met externe tabellen.
Externe tabellen gebruiken wanneer u persistentie en governance nodig hebt
Gebruik externe tabellen wanneer meerdere gebruikers of toepassingen herhaaldelijk dezelfde externe gegevens moeten opvragen. U definieert het schema, de gegevensbron en de referenties eenmaal en slaat deze op in de database. Gebruikers hebben alleen SELECT toestemming nodig voor de tabel.
Externe tabellen ondersteunen ook statistieken, die de queryoptimalisatie gebruikt om betere uitvoeringsplannen te maken. U kunt statistieken handmatig maken of de engine deze automatisch laten maken (SQL Server 2022 (16.x) en latere versies).
Met deze voorbeeldquery worden statistieken voor een externe tabel gemaakt voor betere queryplannen.
CREATE STATISTICS Stats_OrderDate
ON dbo.SalesExternal(OrderDate)
WITH FULLSCAN;
Zie PolyBase-prestatieoverwegingen - Statistieken voor meer informatie over statistieken voor beide benaderingen.
BULK INSERT vs. OPENROWSET(BULK): Welke moet ik gebruiken?
Zowel BULK INSERT als OPENROWSET(BULK ...) importeren gegevens uit bestanden in SQL Server met behulp van dezelfde onderliggende bulk-loading engine. Ze verschillen echter in syntaxis, flexibiliteit en wat u met de resultaten kunt doen. De volgende tabel bevat een overzicht van de belangrijkste verschillen:
Opmerking
De standalone BULK INSERT statement wordt niet ondersteund in de SQL-database in Fabric. Gebruik INSERT ... SELECT met OPENROWSET(BULK ...) voor OneLake om gegevens op te nemen.
| Vermogen | BULK INSERT |
OPENROWSET(BULK ...) |
|---|---|---|
| Basisdoel | Gegevens uit een bestand rechtstreeks in een doeltabel laden | Retourneert een rijenset die je in een SELECT- of INSERT ... SELECT-instructie gebruikt |
| Gebruikspatroon | Zelfstandige uitspraak: BULK INSERT <table> FROM '<file>' |
Moet worden gebruikt in een query: SELECT * FROM OPENROWSET(BULK ...) of INSERT INTO <table> SELECT * FROM OPENROWSET(BULK ...) |
| Is er een doeltabel nodig? | Ja. Schrijft altijd rechtstreeks naar een tabel | Nee. U kunt SELECT direct gebruiken zonder ergens in te voegen, of in een tabel of tijdelijke tabel invoegen. |
| Kolomtransformaties tijdens het laden | Beperkte ondersteuning. De gegevens stromen zonder wijziging van bestand naar tabel (toewijzing beheerd door indelingsbestand of kolomvolgorde) | Volledige ondersteuning. U kunt expressies, CASTWHERE filters, JOIN andere tabellen en berekende kolommen toevoegen in de omgevingSELECT |
| Tafeltips | De WITH component bevat ondersteuning voor BATCHSIZE, CHECK_CONSTRAINTS, FIRE_TRIGGERS, KEEPIDENTITY, , KEEPNULLS, , en TABLOCKmeer |
Ondersteunt tabelhints via de INSERT ... SELECT * FROM OPENROWSET(BULK ...) WITH (TABLOCK, IGNORE_CONSTRAINTS, ...) syntaxis |
| Import van één waarde voor groot object (LOB) | Niet ondersteund | Ja. Ondersteunt SINGLE_BLOB, SINGLE_CLOB, SINGLE_NCLOB om een volledig bestand te importeren als één varbinary(max), varchar(max), of nvarchar(max) waarde |
| Bestanden formatteren | Ja. Ondersteund via (XML en niet-XML) | Ja. Ondersteund (XML en niet-XML) |
| Cloud-bestandstoegang |
DATA_SOURCEondersteunt Azure Blob Storage in SQL Server 2017 (14.x) en latere versies, Azure SQL Database en Azure SQL Managed Instance. SQL Server 2019 CU11 en latere updates ondersteunen ook ADLS Gen2. S3-compatibele opslag wordt niet ondersteund. |
DATA_SOURCEondersteunt Azure Blob Storage in SQL Server 2017 (14.x) en latere versies, ADLS Gen2 in SQL Server 2019 CU11 en latere versies, en S3-compatibele opslag in SQL Server 2022 (16.x) en latere versies. Azure SQL Database en Azure SQL Managed Instance ondersteunen Azure Blob Storage en ADLS Gen2. SQL-database in Fabric ondersteunt OneLake en externe opslag via OneLake-snelkoppelingen. |
| Parquet- of Delta-bestanden | Wordt niet ondersteund. Alleen CSV-/gescheiden tekstbestanden | Ja. SQL Server 2022 (16.x) en latere versies, Azure SQL Managed Instance en Azure SQL Database ondersteunen FORMAT = 'PARQUET' en FORMAT = 'DELTA'; ondersteuning voor SQL database in Fabric FORMAT = 'PARQUET' maar niet DELTA. Zie OPENROWSET BULK (Transact-SQL)voor meer informatie. |
| Machtiging vereist |
ADMINISTER BULK OPERATIONS of ADMINISTER DATABASE BULK OPERATIONS, plus INSERT op de doeltabel |
ADMINISTER BULK OPERATIONS of ADMINISTER DATABASE BULK OPERATIONS |
| Minimale logboekregistratie | Ja. Ondersteund onder eenvoudige of bulksgewijs vastgelegde herstelmodellen met TABLOCK |
Ja. Ondersteund bij gebruik met INSERT ... SELECT en TABLOCK |
-
BULK INSERTlaadt gegevens uit een bestand rechtstreeks in een doeltabel, terwijlOPENROWSET(BULK ...)een resultatenset retourneert die je in eenSELECT- ofINSERT ... SELECT-instructie kunt gebruiken. -
BULK INSERTis een zelfstandige stelling, terwijlOPENROWSET(BULK ...)moet worden gebruikt binnen een query zoalsSELECT * FROM OPENROWSET(BULK ...)ofINSERT INTO <table> SELECT * FROM OPENROWSET(BULK ...). -
BULK INSERTschrijft altijd direct naar een doeltabel, terwijlOPENROWSET(BULK ...)vanuit een bestandSELECTkan uitvoeren zonder ergens gegevens in te voegen of in een tabel of tijdelijke tabel in te voegen. -
BULK INSERTBiedt beperkte ondersteuning voor kolomtransformaties omdat data van het bestand naar de tabel stroomt as-is, waarbij mapping wordt geregeld door een bestands- of kolomvolgorde.OPENROWSET(BULK ...)ondersteunt expressies,CAST,WHEREfilters,JOINs en berekende kolommen in de omliggendeSELECT. -
BULK INSERTgebruikt eenWITHclausule voorBATCHSIZE,CHECK_CONSTRAINTS,FIRE_TRIGGERS, ,KEEPIDENTITY,KEEPNULLS,TABLOCK, en andere hints.OPENROWSET(BULK ...)ondersteunt tabelhints viaINSERT ... SELECT * FROM OPENROWSET(BULK ...) WITH (TABLOCK, IGNORE_CONSTRAINTS, ...). -
BULK INSERTondersteunt geen import van grote objecten met één waarde.OPENROWSET(BULK ...)SINGLE_BLOBondersteunt ,SINGLE_CLOB, enSINGLE_NCLOBom een heel bestand respectievelijk als één varbinary(max), varchar(max) of nvarchar(max) waarde te importeren. - Beide
BULK INSERTOPENROWSET(BULK ...)ondersteunen XML- en niet-XML-formaat bestanden. - Voor toegang tot cloudbestanden met
BULK INSERT, ondersteunt deDATA_SOURCEparameter Azure Blob Storage in SQL Server 2017 (14.x) en latere versies, Azure SQL Database en Azure SQL Managed Instance. SQL Server 2019 CU11 en latere updates ondersteunen ook ADLS Gen2, maarBULK INSERTgeen S3-compatibele opslag. VoorOPENROWSET(BULK ...), ondersteuntDATA_SOURCEAzure Blob Storage in SQL Server 2017 (14.x) en latere versies, ADLS Gen2 in SQL Server 2019 CU11 en latere versies, en S3-compatibele opslag in SQL Server 2022 (16.x) en latere versies. Azure SQL Database en Azure SQL Managed Instance ondersteunen Azure Blob Storage en ADLS Gen2. SQL-database in Fabric ondersteunt OneLake en externe opslag via OneLake-snelkoppelingen. -
BULK INSERTondersteunt geen Parquet- of Delta-bestanden en ondersteunt alleen CSV of gescheiden tekst.OPENROWSET(BULK ...)ondersteuntFORMAT = 'PARQUET'enFORMAT = 'DELTA'in SQL Server 2022 (16.x) en latere versies, Azure SQL Database en Azure SQL Managed Instance. SQL-databases in Fabric ondersteunenFORMAT = 'PARQUET'maar nietFORMAT = 'DELTA'. Zie OPENROWSET BULK (Transact-SQL)voor meer informatie. -
BULK INSERTvereistADMINISTER BULK OPERATIONSofADMINISTER DATABASE BULK OPERATIONSplusINSERTtoestemming op de doel-tabel, terwijlOPENROWSET(BULK ...)vereistADMINISTER BULK OPERATIONSofADMINISTER DATABASE BULK OPERATIONS. -
BULK INSERTondersteunt minimale logboekregistratie in de eenvoudige of bulkgewijs gelogde herstelmodus metTABLOCK.OPENROWSET(BULK ...)ondersteunt minimale logging wanneer het wordt gebruikt metINSERT ... SELECTenTABLOCK.
Wanneer moet u kiezen BULK INSERT
Gebruik BULK INSERT wanneer u een eenvoudige bestand-naar-tabel laden heeft en geen gegevens hoeft te transformeren, filteren of samenvoegen tijdens het importeren. Er wordt gebruikgemaakt van eenvoudigere syntaxis voor CSV- of andere bestanden met scheidingstekens:
In dit voorbeeld wordt een CSV-bestand vanuit Azure Blob Storage rechtstreeks in een tabel geladen.
BULK INSERT Sales.Invoices
FROM 'invoices/inv-2025-01.csv'
WITH (
    DATA_SOURCE = 'MyAzureBlobStorage',
    FORMAT = 'CSV',
    FIRSTROW = 2,
    FIELDTERMINATOR = ',',
    ROWTERMINATOR = '\n'
);
In dit voorbeeld wordt een lokaal bestand geladen met een formaatbestand voor kolomtoewijzing.
BULK INSERT dbo.Products
FROM 'C:\Data\products.csv'
WITH (
    FORMATFILE = 'C:\Data\products.fmt',
    FIRSTROW = 2,
    TABLOCK
);
Wanneer moet u OPENROWSET(BULK) kiezen
Gebruik OPENROWSET(BULK ...) deze optie wanneer u een of meer van de volgende voorwaarden nodig hebt:
- Gebruik
OPENROWSET(BULK ...)deze om bestandsgegevens op te vragen of te bekijken zonder eerst een tabel aan te maken. - Gebruik
OPENROWSET(BULK ...)om data te transformeren, filteren of joinen tijdens import. - Ik gebruik
OPENROWSET(BULK ...)om Parquet- of Delta-bestanden te laden omdatBULK INSERTze deze formaten niet ondersteunen. - Gebruik
OPENROWSET(BULK ...)om een heel bestand als één enkele LOB-waarde te importeren metSINGLE_BLOB,SINGLE_CLOB, ofSINGLE_NCLOB.
In dit voorbeeldquery wordt een CSV-bestand uit Azure Blob Storage weergegeven zonder de gegevens ergens in te voegen.
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'invoices/inv-2025-01.csv',
    DATA_SOURCE = 'MyAzureBlobStorage',
    FORMAT = 'CSV',
    FIRSTROW = 2,
    FIELDTERMINATOR = ','
) AS src;
Met deze voorbeeldquery worden gegevens ingevoegd met transformatie en filteren.
INSERT INTO Sales.Invoices (InvoiceDate, Amount, Customer)
SELECT CAST (InvoiceDate AS DATE),
       Amount * 1.1, -- Apply a 10% markup
       UPPER(Customer)
FROM OPENROWSET (
    BULK 'invoices/inv-2025-01.csv',
    DATA_SOURCE = 'MyAzureBlobStorage',
    FORMAT = 'CSV',
    FIRSTROW = 2
) WITH (
    InvoiceDate VARCHAR (10),
    Amount DECIMAL (18, 2),
    Customer VARCHAR (100)
) AS src
WHERE Amount IS NOT NULL;
Met deze voorbeeldquery wordt een Parquet-bestand geladen (niet mogelijk met BULK INSERT).
INSERT INTO Sales.Invoices
SELECT *
FROM OPENROWSET (
    BULK 'data/invoices/*.parquet',
    DATA_SOURCE = 'MyAzureStorage',
    FORMAT = 'PARQUET') AS src;
Met deze voorbeeldquery wordt een heel XML-bestand geïmporteerd als één varbinary(max) -waarde.
INSERT INTO dbo.XmlDocuments (DocContent)
SELECT BulkColumn
FROM OPENROWSET (
    BULK 'C:\Data\catalog.xml',
    SINGLE_BLOB
) AS x;
Aanbeveling
Een benadering is om te beginnen met OPENROWSET(BULK ...) in een SELECT om bestandsgegevens te verkennen en te valideren, en vervolgens over te schakelen naar BULK INSERT voor de definitieve productielading als u geen transformaties nodig hebt. Als u parquet- of Delta-ondersteuning of inlinefiltering nodig hebt, moet u bij OPENROWSET blijven.
Zie de volgende gerelateerde handleidingen voor meer informatie:
- Het artikel Gebruik BULK INSERT of OPENROWSET(BULK...) om gegevens in SQL Server te importeren biedt een gedetailleerde vergelijkende handleiding met beveiligingsoverwegingen.
- Het artikel Bulk Import and Export of Data (SQL Server) geeft een overzicht van alle bulkgegevensverplaatsingsmethoden, waaronder bcp,
BULK INSERT, enOPENROWSET. - Het BULK INSERT artikel (Transact-SQL) geeft de volledige T-SQL-referentie voor
BULK INSERT. - Het artikel OPENROWSET BULK (Transact-SQL) geeft de volledige T-SQL-referentie voor
OPENROWSET(BULK ...). - Het artikel Voorbeelden van bulktoegang tot data in Azure Blob Storage biedt naast elkaar voorbeelden die beide methoden gebruiken met Azure Storage.
- Het artikel Bulk import van grote objectgegevens met OPENROWSET Bulk Rowset Provider (SQL Server) biedt
SINGLE_BLOB,SINGLE_CLOB, enSINGLE_NCLOBvoorbeelden. - Het artikel 'Gebruik een formaat bestand om data in bulk te importeren' (SQL Server) legt het gebruik van formateerbestanden met beide methoden uit.
- Voor richtlijnen over het behouden van nulls of het toepassen van standaardwaarden tijdens bulkimport, zie Keep nulls of default values during bulk import (SQL Server).
- Voor richtlijnen over het behouden van identiteitswaarden tijdens bulkimport, zie Behoud identiteitswaarden bij bulkimport van data (SQL Server).
Nuttige metagegevensfuncties
Wanneer je externe bestanden opvraagt met OPENROWSET of externe tabellen, gebruik dan de ingebouwde functies en procedures om bestandsmetadata te inspecteren, schema's te ontdekken en partitiebewuste queries te implementeren.
filepath() en bestandsnaam()
De filepath() en filename() functies retourneren delen van de bestandsnaam of het bestandspad voor elke rij in de resultatenset. Ze zijn vooral handig voor:
Partitie-verwijdering: Filter op mapsegmenten (bijvoorbeeld jaar-/maand-/dagpartities) zodat de engine alleen de overeenkomende bestanden leest in plaats van alles te scannen.
Metagegevens van bron beschikbaar maken: neem de oorspronkelijke bestandsnaam of het oorspronkelijke pad op als een kolom in de queryresultaten. Dit is handig voor controle of foutopsporing.
| Function | Retouren | Voorbeeld |
|---|---|---|
filename() |
De bestandsnaam (inclusief extensie) van het bronbestand voor elke rij | sales_2025_01.parquet |
filepath(N) |
Het Nde mapsegment van het jokerteken () in het * pad, waarbij BULK begint bij 1 |
Bij het pad sales/2025/01/*.parquet, geeft filepath(1)2025 terug en geeft filepath(2)01 terug |
Van toepassing op: Azure SQL Database, Azure SQL Managed Instance, SQL Server 2022 (16.x) en latere versies, SQL Database in Fabric.
In deze voorbeeldquery wordt filepath() gebruikgemaakt van partitie-verwijdering en filename() om bronbestanden te identificeren. Het leest alleen bestanden onder de /2025/ map en leest alleen bestanden onder de /06/ submap.
SELECT result.filename() AS SourceFile,
       result.filepath(1) AS [Year],
       result.filepath(2) AS [Month],
       *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*/*/*.parquet',
    FORMAT = 'PARQUET'
) AS result
WHERE result.filepath(1) = '2025'
      AND result.filepath(2) = '06';
Aanbeveling
Plaats filepath() filters in de WHERE component in plaats van in een subquery of CTE. Wanneer het filter zich in de WHERE component bevindt, kan de engine partitie-verwijdering uitvoeren op het niveau van de bestandsscan, wat de I/O aanzienlijk vermindert.
sp_describe_first_result_set - het ontdekken van OPENROWSET-kolomtypen
Wanneer u OPENROWSET met Parquet-bestanden gebruikt, worden kolomgegevenstypen automatisch afgeleid (schema-afleiding). De afgeleide typen kunnen groter zijn dan nodig is. Tekenkolommen worden bijvoorbeeld vaak afgeleid als varchar(8000), omdat Parquet-metagegevens geen maximale lengte bevatten. Deze keuze kan de prestaties verminderen en meer geheugen verbruiken.
Gebruik sp_describe_first_result_set om het afgeleide schema te inspecteren voordat u de query afrondt. Nadat u de afgeleide typen hebt bekeken, specificeert u smallere typen in een WITH clausule om de prestaties te verbeteren.
Stap 1: Inspecteer het uitgestelde schema.
EXECUTE sp_describe_first_result_set N'
SELECT *
FROM OPENROWSET(
    BULK ''abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet'',
    FORMAT = ''PARQUET''
) AS result';
De uitvoer toont de naam van elke kolom, afgeleid gegevenstype, maximale lengte, precisie en schaal. Als je varchar(8000) ziet waar een varchar(100) voldoende is, overschrijf die dan.
Stap 2: Gebruik expliciete typen voor betere prestaties.
SELECT TOP 100 *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet',
    FORMAT = 'PARQUET'
) WITH (
    OrderId INT,
    OrderDate DATE,
    Amount DECIMAL (18, 2),
    Customer VARCHAR (100) -- much narrower than the inferred varchar(8000)
) AS result;
Schemadeductie werkt alleen met Parquet-bestanden. Geef voor CSV-bestanden altijd kolomdefinities op in een WITH component (voor OPENROWSET) of in de CREATE EXTERNAL TABLE instructie.
sp_describe_first_result_setis een algemene SQL Server, Azure SQL Database, Azure SQL Managed Instance en SQL database in Fabric-procedure, maar het is vooral nuttig voor OPENROWSET queries. Voor meer informatie, zie sp_describe_first_result_set.
Prestaties, probleemoplossing en aanbevolen procedures
Nadat u gegevensvirtualisatie hebt geïmplementeerd, gebruikt u deze handleidingen om prestaties te optimaliseren, problemen te diagnosticeren en de gereedheid van de productie te garanderen:
| Oppervlak | Artikel | Details |
|---|---|---|
| PolyBase-prestaties | Prestatieoverwegingen in PolyBase voor SQL Server- | Statistieken, pushdown, parallellisme en geheugenbeheer |
| Pushdownberekening | Pushdown-berekeningen in PolyBase | Hiermee geeft u op welke bewerkingen naar de externe bron worden gepusht |
| Hoe te herkennen of er een pushdown heeft plaatsgevonden | Hoe kunt u zien of er een externe pushdown is opgetreden | Queryplannen en DMV's |
| Troubleshooting | PolyBase- bewaken en problemen oplossen | Veelvoorkomende fouten en oplossingen |
| Kerberos-connectiviteit | Problemen met PolyBase Kerberos-connectiviteit oplossen | |
| Veelgestelde vragen | Veelgestelde vragen over PolyBase | |
| Fouten en oplossingen | PolyBase-fouten en mogelijke oplossingen |