Profielgegevens
Voordat u gegevens opschoont of transformeert, moet u weten wat er in uw tabellen staat. Profileringsgegevens betekenen dat u uw gegevenssets bekijkt om samenvattingsstatistieken te genereren, zoals aantallen, gemiddelden, waardedistributies en null-percentages, waarmee de kwaliteit en structuur van uw gegevens worden weergegeven. Dit fundament helpt u bij het identificeren van problemen zoals ontbrekende waarden, uitbijters en onverwachte patronen voordat ze verderop in het proces problemen veroorzaken.
In deze les leert u hoe u samenvattingsstatistieken genereert met behulp van SQL-opdrachten en de functie voor gegevensprofilering in Azure Databricks.
Samenvattingsstatistieken genereren met BEHULP van SQL
Azure Databricks biedt SQL-opdrachten waarmee statistieken over uw tabellen worden verzameld en weergegeven. Deze statistieken helpen de optimalisatie van query's om efficiënte uitvoeringsplannen te kiezen en u inzicht te geven in de kenmerken van uw gegevens.
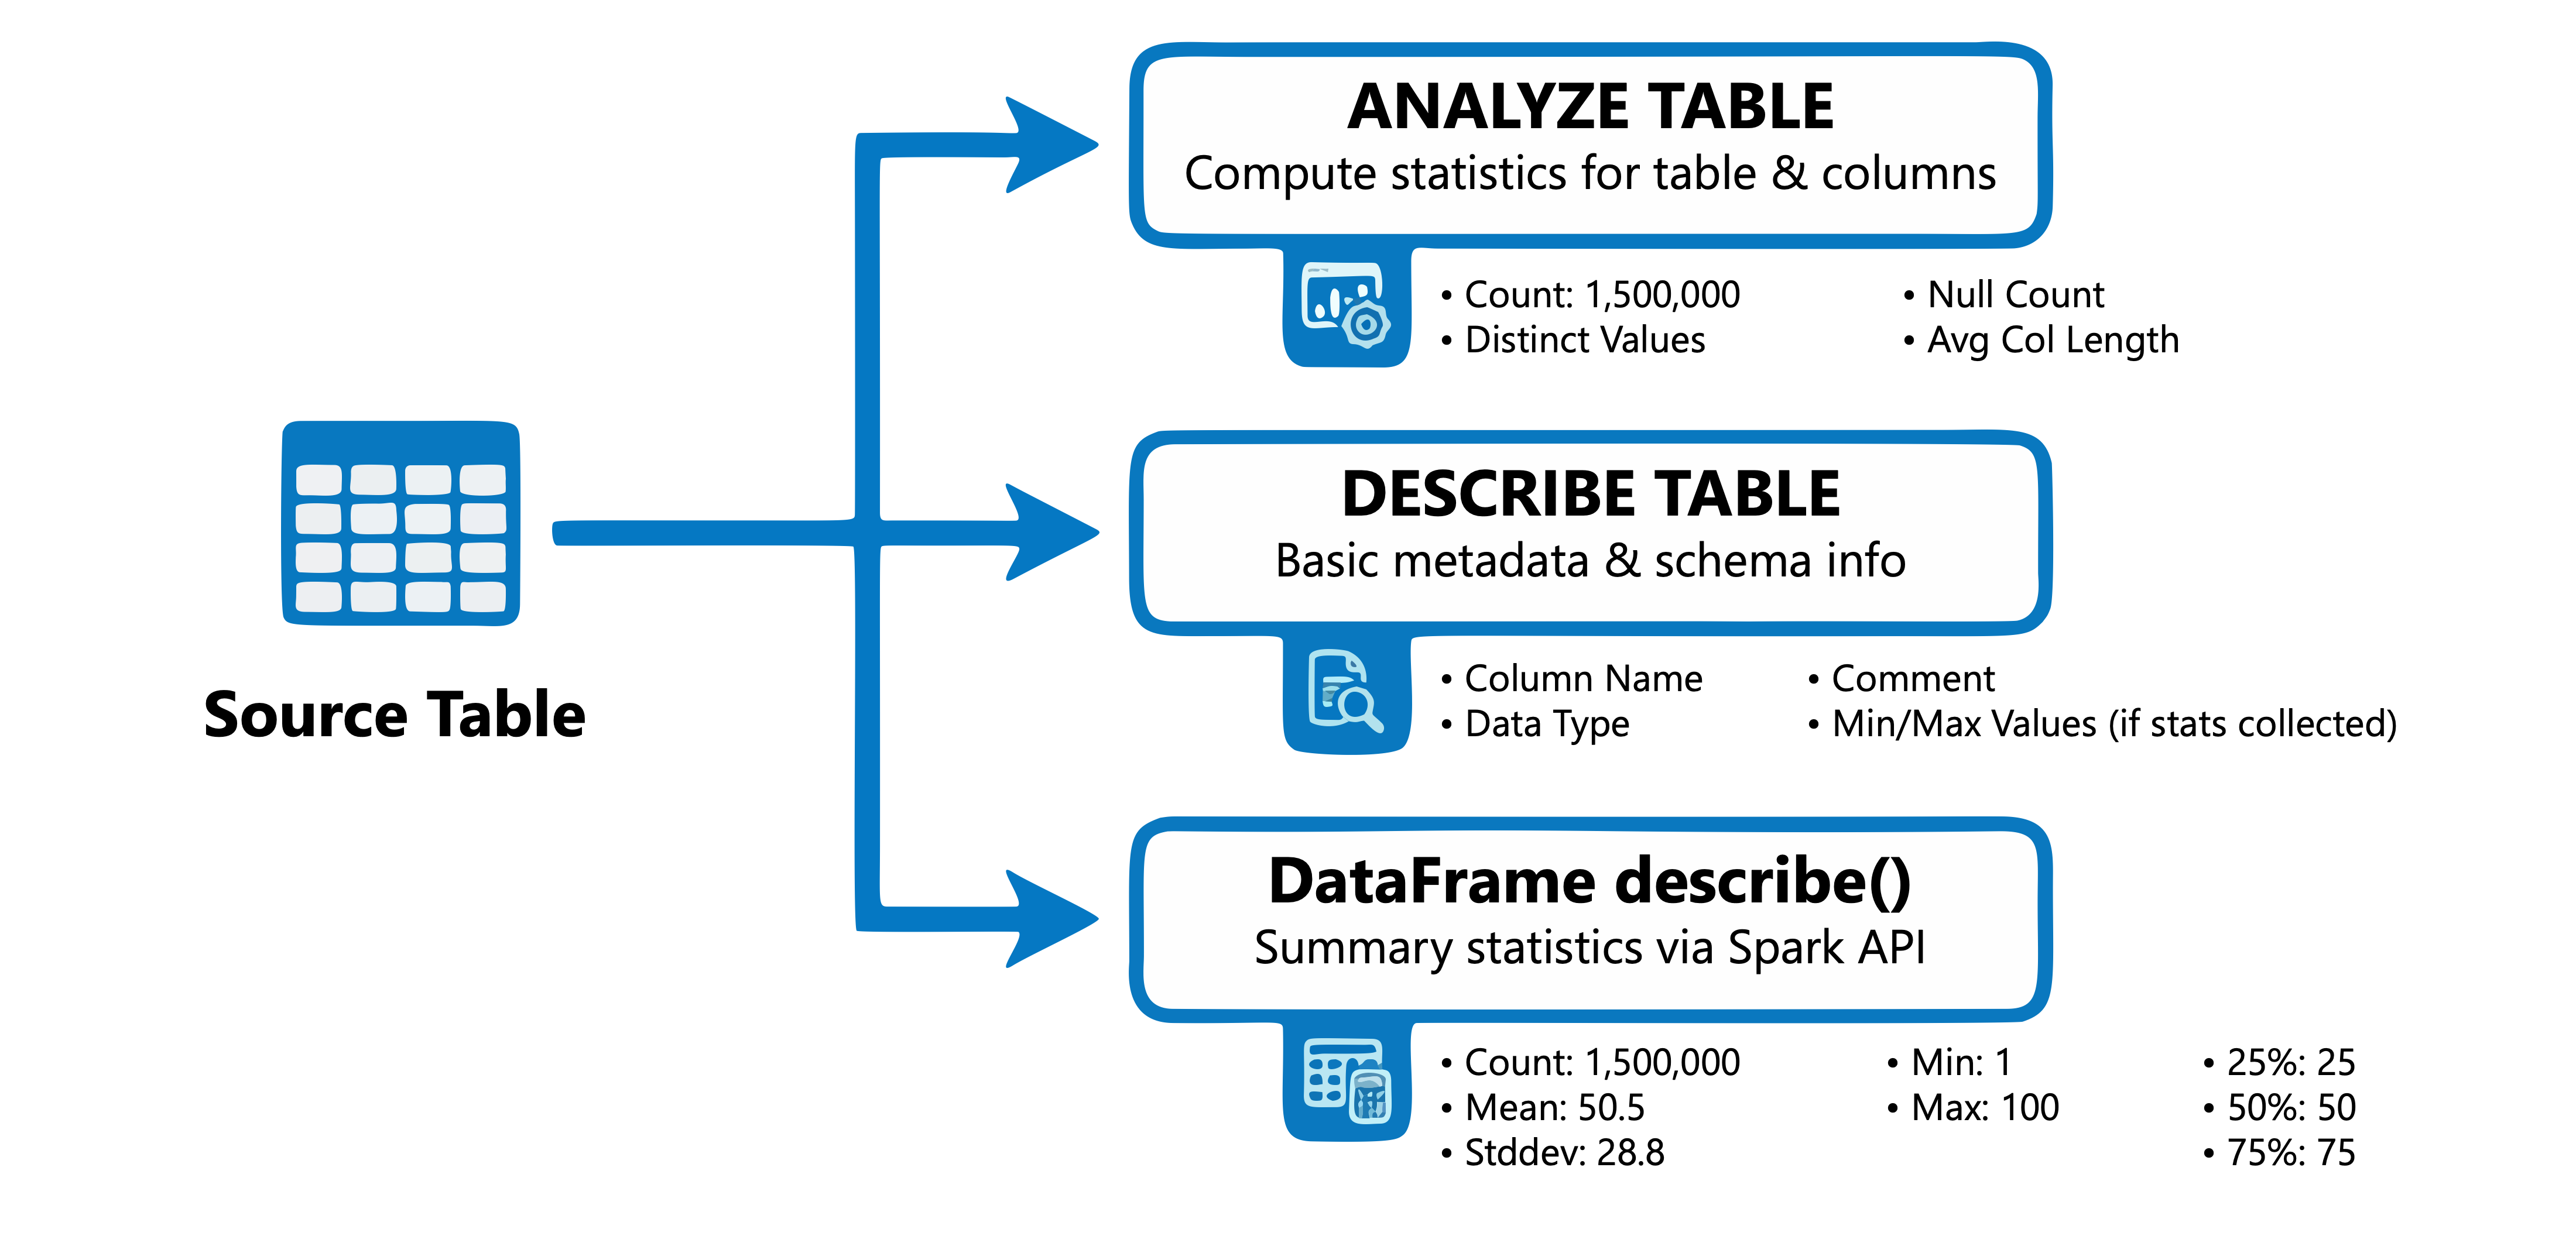
Statistieken verzamelen met ANALYZE TABLE
Met de ANALYZE TABLE opdracht worden statistieken berekend voor een tabel of specifieke kolommen. Deze statistieken omvatten het aantal rijen, metrische gegevens op kolomniveau, zoals minimum- en maximumwaarden, null-aantallen en afzonderlijke waarden.
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
Wanneer u een specifieke kolom analyseert, krijgt u gedetailleerde metrische gegevens:
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
Dit retourneert metrische gegevens, waaronder minimumwaarde, maximumwaarde, aantal nullen, uniek aantal, gemiddelde kolomlengte en maximale kolomlengte.
Statistieken weergeven met DESCRIBE TABLE
Met de DESCRIBE TABLE EXTENDED opdracht worden verzamelde statistieken weergegeven naast tabelmetagegevens:
DESCRIBE TABLE EXTENDED sales.transactions;
U kunt pySpark ook gebruiken om metagegevens van tabellen op te halen en overzichtsstatistieken te genereren:
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
De describe() methode retourneert het aantal, gemiddelde, standaarddeviatie, min en max voor numerieke en tekenreekskolommen.
De DESCRIBE TABLE EXTENDED uitvoer bevat een Statistics rij met de grootte van de tabel in bytes en, nadat u ANALYZE TABLE ... COMPUTE STATISTICS hebt uitgevoerd, het aantal rijen. Voor beheerde tabellen van Unity Catalog wordt voorspellende optimalisatie automatisch uitgevoerd ANALYZE om statistieken actueel te houden.
Aanbeveling
Voer ANALYZE TABLE uit nadat bulkgegevens zijn geladen of belangrijke wijzigingen zijn doorgevoerd om ervoor te zorgen dat de query-optimizer over nauwkeurige statistieken beschikt bij het plannen van efficiënte query's.
Gegevensprofilering gebruiken in Unity Catalog
Naast SQL-opdrachten biedt Azure Databricks bewaking van gegevenskwaliteit in Unity Catalog, een paraplu die betrekking heeft op twee verschillende mogelijkheden:
- Anomaliedetectie (openbare preview) bewaakt automatisch alle tabellen in een schema. Het analyseert historische patronen om de versheid van elke tabel te evalueren (hoe recent deze is bijgewerkt) en volledigheid (of het verwachte aantal rijen is aangekomen). U schakelt deze eenmaal in op schemaniveau in Catalog Explorer en Azure Databricks bepaalt hoe vaak elke tabel moet worden gescand. Gebruik anomaliedetectie voor brede, geautomatiseerde dekking voor al uw tabellen zonder configuratie per tabel.
- Gegevensprofilering biedt uitgebreide statistische analyse per tabel: het bijhouden van distributies, null-percentages, driftgegevens en modelprestaties in de loop van de tijd. U configureert deze afzonderlijk voor elke tabel. Gebruik gegevensprofilering voor uw meest kritieke tabellen waar u gedetailleerde historische trends nodig hebt.
Voor data engineering werk gericht op opschoning en kwaliteit, gebruikt u beide: anomaliedetectie als een vroegtijdig waarschuwingssysteem voor alle tabellen en gegevensprofilering voor uitgebreide bewaking van belangrijke tabellen.

Profieltypen begrijpen
Gegevensprofilering ondersteunt drie analysetypen, die elk geschikt zijn voor verschillende scenario's:
| Profieltype | Gebruiksituatie | Belangrijkste kenmerken |
|---|---|---|
| Snapshot | Tabellen voor algemeen gebruik | Berekent metrische gegevens over de hele tabel met elke vernieuwing |
| Tijdreeksen | Tabellen met tijdstempelkolommen | Houdt metrische gegevens bij in tijdvensters om trends te detecteren |
| Gevolgtrekking | ML-inferentietabellen | Bewaakt modelinvoer, voorspellingen en nauwkeurigheid in de loop van de tijd |
Voor data engineering-taken die zijn gericht op gegevenskwaliteit, zijn de momentopname- en tijdreeksprofielen het meest relevant.
Een profiel maken met behulp van de gebruikersinterface
Een profiel maken in Catalog Explorer:
- Navigeer naar de tabel in Catalog Explorer.
- Selecteer het tabblad Kwaliteit .
- Als anomaliedetectie niet is ingeschakeld voor het schema, selecteert u Inschakelen. Als anomaliedetectie al is ingeschakeld, selecteert u Configureren.
- Selecteer Configureren in het dialoogvenster Bewaking van gegevenskwaliteit in het veld Gegevensprofilering.
- Kies uw profieltype en configureer opties zoals granulariteit en planning.
Het profiel genereert een tabel met metrische profielgegevens met samenvattingsstatistieken en een tabel met metrische driftgegevens waarmee distributiewijzigingen in de loop van de tijd worden bijgehouden. Azure Databricks vult de tabel met metrische driftgegevens wanneer er een basislijntabel of een opeenvolgend tijdvenster beschikbaar is.
Een profiel maken met behulp van de API
Gebruik de Databricks SDK voor programmatische toegang. Installeer of upgrade de SDK om de huidige API op te halen:
%pip install "databricks-sdk>=0.68.0"
Maak vervolgens een momentopnameprofiel voor een tabel:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
Het profiel vernieuwen en metrische gegevens bijwerken:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
Profileringsresultaten interpreteren
Profilering genereert metrische gegevens waarmee u gegevenskwaliteit kunt beoordelen en problemen kunt identificeren die aandacht vereisen.
Belangrijke metrische gegevens die moeten worden onderzocht
De tabel met metrische profielgegevens bevat statistieken voor elke kolom:
| Metrische gegevens | Wat het onthult |
|---|---|
count en num_nulls |
Volledigheid van gegevens: hoge null-percentages kunnen duiden op opnameproblemen |
distinct_count |
Kardinaliteit: onverwachte waarden kunnen problemen met gegevenskwaliteit voorstellen |
min,max,avg,stddev |
Distributiekenmerken: uitschieters of scheve distributies |
frequent_items |
Meest voorkomende waarden: helpt dominante categorieën of duplicaten te identificeren |
quantiles |
Waardeverdeling, handig voor het detecteren van scheefheid |
Problemen met gegevenskwaliteit detecteren
Wanneer u profileringsresultaten bekijkt, zoekt u naar deze algemene indicatoren:
- Hoge null-percentages in kolommen die waarden zouden moeten hebben
- Onverwachte unieke aantallen, zoals unieke id's die niet uniek zijn
- Waardebereiken buiten de verwachte grenzen, zoals negatieve bedragen waarbij alleen positieven geldig zijn
- Distributiewijzigingen in de loop van de tijd, wat kan duiden op gegevensdrift
De tabel met metrische driftgegevens berekent statistische tests zoals de KS-test (Kolmogorov-Smirnov) voor numerieke kolommen en chi-kwadraattest voor categorische kolommen. Deze tests kwantificeren hoeveel distributies zijn gewijzigd.
Als u deze patronen begrijpt, kunt u de juiste opschonings- en validatieregels voor uw gegevenspijplijnen ontwerpen.