Een hulpprogramma voor gegevensopname kiezen
Aanbeveling
Zie het tabblad Tekst en afbeeldingen voor meer informatie.
Wanneer u gegevenspijplijnen ontwerpt in Azure Databricks, heeft het selecteren van het juiste opnamehulpprogramma rechtstreeks invloed op de betrouwbaarheid van pijplijnen, onderhoud en kosten op de lange termijn. Elk hulpprogramma heeft betrekking op verschillende scenario's, gegevensbronnen en operationele vereisten. Als u deze verschillen begrijpt, kunt u weloverwogen beslissingen nemen die aansluiten bij de behoeften van uw organisatie.
Inzicht in het gegevensinvoerlandschap
Azure Databricks biedt meerdere opnameopties die een spectrum omvatten van volledig beheerde services tot zeer aanpasbare frameworks. De hulpprogramma's die u kiest, zijn afhankelijk van factoren zoals uw gegevensbrontype, latentievereisten en hoeveel controle u nodig hebt over het opnameproces.

Aan het meest beheerde einde biedt Lakeflow Connect kant-en-klare connectors voor bedrijfstoepassingen en -databases. Deze connectors verwerken automatisch verificatie, wijzigingen bijhouden, foutherstel en schemaontwikkeling. Aan het aanpasbare einde biedt Spark Structured Streaming u volledige controle over de wijze waarop gegevens via uw pijplijn stromen, hoewel er meer ontwikkelings- en onderhoudswerkzaamheden nodig zijn.
Tussen deze extremen vindt u hulpprogramma's zoals Automatisch laden voor cloudopslagbestanden, COPY INTO voor batchlaadbewerkingen op basis van SQL en methoden op basis van notebooks met behulp van JDBC-/ODBC-verbindingen . Daarnaast fungeert Azure Data Factory als een indelingslaag die de verplaatsing van gegevens naar Azure Databricks kan coördineren vanuit het bredere Azure-ecosysteem.
Lakeflow Connect
Lakeflow Connect vertegenwoordigt de moderne benadering van gegevensopname in Azure Databricks. Het biedt zowel volledig beheerde connectors als standaardconnectors die kunnen worden geïntegreerd met Lakeflow-pijplijnen voor een gestroomlijnde ervaring.
Beheerde connectors zijn ingedeeld in drie typen:
SaaS-connectors bieden standaardintegratie met bedrijfstoepassingen zoals Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk en nog veel meer. Deze connectors verwerken bronspecifieke verificatie, incrementele leesbewerkingen, API-frequentiebeperking, schemaontwikkeling en geautomatiseerde nieuwe pogingen. Ze worden uitgevoerd op serverloze berekeningen en schrijven naar streamingtabellen die worden beheerd door Unity Catalog.
Databaseconnectors gegevens opnemen uit relationele databases, waaronder MySQL, PostgreSQL en SQL Server met behulp van change data capture (CDC). Omdat CDC-connectors uit databasetransactielogboeken lezen in plaats van rechtstreeks query's uit te voeren op tabellen, vereisen ze een opnamegateway die is geïmplementeerd in uw netwerk en een faseringsopslagvolume om vastgelegde wijzigingen te bufferen.
Communityconnectors zijn opensource-connectors die zijn gebouwd en onderhouden door de community. Ze breiden Lakeflow Connect uit naar bronnen die nog geen beheerde connector hebben. U kunt een bestaande communityconnector gebruiken of uw eigen connector bijdragen.
Opmerking
Het connectorecosysteem groeit snel. Raadpleeg de documentatie voor beheerde connectors voor de huidige volledige lijst met ondersteunde bronnen.
Standaardconnectors verlengen Lakeflow Connect met cloudobjectopslag en berichtenbussen. U kunt gegevens opnemen uit Amazon S3, Azure Data Lake Storage of Google Cloud Storage met behulp van automatisch laden. Voor realtime gegevens ondersteunen standaardconnectors Apache Kafka, Google Pub/Sub en Apache Pulsar.

Overweeg Lakeflow Connect wanneer u betrouwbare opname met weinig onderhoud van ondersteunde bronnen nodig hebt. De beheerde connectors verkorten de ontwikkelingstijd en doorlopend onderhoud aanzienlijk in vergelijking met aangepaste oplossingen. Als uw gegevensbron echter niet wordt ondersteund of als u een zeer gespecialiseerde opnamelogica nodig hebt, moet u mogelijk andere opties verkennen.
Lakeflow Connect ondersteunt zowel geplande opname (elk uur, dagelijks, wekelijks) als on-demand triggers, waardoor deze geschikt zijn voor normale gegevensvernieuwingscycli en ad-hoc laadscenario's.
Op querygebaseerde connectors
Op query's gebaseerde connectors zijn een lichtgewicht alternatief voor CDC-databaseconnectors voor geplande opname van relationele databases. In plaats van transactielogboeken te lezen, voeren ze rechtstreeks een query uit op de brontabel met behulp van een cursorkolom , een monotonisch toenemend tijdstempel of geheel getal waarmee wordt bijgehouden welke rijen nieuw of bijgewerkt zijn sinds de laatste pijplijnuitvoering.
Omdat ze rechtstreeks de bron bevragen, hebben op query's gebaseerde connectors geen verwerkingsgateway of tussenopslag nodig. Bij elke geplande uitvoering haalt de connector alle rijen op met een cursorkolomwaarde die groter is dan de bovengrens van de vorige uitvoering en schrijft de resultaten vervolgens naar streamingtabellen in Unity Catalog.
Ondersteunde bronnen zijn Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL en alle Lakehouse Federation-gegevensbronnen.
Connectors op basis van query's ondersteunen drie geschiedenistraceringsmodi voor doeltabellen:
- SCD Type 1: Hiermee wordt de bestaande rij overschreven met de meest recente bronrij. Er blijft geen geschiedenis behouden.
- SCD Type 2: behoudt de volledige geschiedenis door nieuwe rijen met versiemetagegevens toe te voegen.
- Alleen toevoegen: elke opgenomen rij toevoegen zonder samenvoegen of overschrijven.
Kies voor query-gebaseerde connectors in plaats van voor CDC-databaseconnectors wanneer de CDC- of binlog-infrastructuur niet beschikbaar is, maar er wel een betrouwbare cursorkolom in de bron aanwezig is. Kies CDC-connectors wanneer u elke tussenliggende rijstatus tussen pijplijnprocessen nodig hebt of wanneer het bijhouden van soft-delete essentieel is. De afweging is dat query-gebaseerde connectors meer belasting op brontabellen leggen vergeleken met CDC-connectors, die uit de binlog lezen.
Automatische lader
Auto Loader biedt incrementele bestandsverwerking voor gegevens die binnenkomen in de cloudopslag. In plaats van volledige mappen te scannen om nieuwe bestanden te vinden, houdt Auto Loader efficiënt bij welke bestanden zijn verwerkt en worden alleen nieuwe aankomsten opgenomen.
Automatisch laadprogramma werkt door de status te onderhouden op een controlepuntlocatie waarmee verwerkte bestanden worden bijgehouden. Wanneer nieuwe bestanden in uw cloudopslag terechtkomen, detecteert Auto Loader deze via de mappenlijst of de meldingsmodus voor bestanden. Directorylisting scant regelmatig op nieuwe bestanden, terwijl de bestandsnotificatiemodus gebruikmaakt van cloud-native gebeurtenissen voor onmiddellijke detectie.

De belangrijkste mogelijkheden van het automatisch laadprogramma zijn onder andere:
- Schemadeductie en evolutie: detecteert automatisch het schema van binnenkomende bestanden en verwerkt schemawijzigingen correct.
- Exactly-once verwerking: Garandeert dat elk bestand eenmaal wordt verwerkt, zelfs bij fouten en opnieuw opstarten.
- Schaalbaarheid: verwerkt efficiënt miljarden bestanden voor backfills of migraties.
- Indelingsondersteuning: Verwerkt JSON-, CSV-, Parquet-, Avro-, ORC-, XML-, tekst- en binaire bestanden.
Auto Loader past bij scenario's waarin gegevens binnenkomen als bestanden in cloudopslag. Algemene patronen zijn logboekbestanden, exports van upstream-systemen en landingszones voor gegevens. U kunt Auto Loader met Lakeflow-pijplijnen gebruiken voor een beheerde ervaring of met Structured Streaming voor meer controle.
KOPIEER NAAR
Met de COPY INTO SQL-opdracht worden gegevens uit cloudopslag in Delta-tabellen geladen. In tegenstelling tot Auto Loader, dat continu als een stroom draait, wordt COPY INTO uitgevoerd als een batchbewerking die u handmatig kunt plannen of activeren.
COPY INTO houdt bij welke bestanden het al heeft verwerkt, waardoor de bewerking idempotent wordt. Als u dezelfde opdracht meerdere keren uitvoert, worden er geen gegevens gedupliceerd omdat eerder geladen bestanden worden overgeslagen. Dit kenmerk maakt COPY INTO nuttig voor geplande batchtaken waar u voorspelbaar, herhaalbaar gedrag wilt.
Opmerking
De trackingmetagegevens worden opgeslagen als onderdeel van het transactielogboek van de Delta-tabel (de _delta_log map)

Veelvoorkomende scenario's voor COPY INTO omvatten eenmalige gegevensmigraties, geplande batchverwerkingen vanuit landingszones en SQL-first-werkstromen waarbij men de voorkeur geeft aan declaratieve syntaxis boven streaming-API's.
Kies COPY INTO boven Auto Loader wanneer u een eenmalige batchverwerking van een grote gegevensset uitvoert.
COPY INTO biedt een eenvoudiger configuratiemodel zonder streaming-infrastructuur, waardoor het ideaal is voor het laden van honderden gigabytes of zelfs terabytes aan gegevens in één bewerking. Het model voor continue verwerking en controlepuntbeheer van het automatisch laadprogramma zorgen voor onnodige complexiteit wanneer u slechts eenmaal gegevens hoeft te laden.
Voor continue incrementele opname op schaal biedt Auto Loader echter betere prestaties en krachtigere bestandsdetectie.
Spark Structured Streaming (gestructureerde streaming van Spark)
Spark Structured Streaming biedt de basis voor realtime gegevensverwerking in Azure Databricks. Het maakt continue opname vanuit verschillende streamingbronnen mogelijk met exactly-once verwerkingsgaranties.
Ondersteunde streamingbronnen zijn:
- Apache Kafka en Azure Event Hubs: voor gebeurtenisgestuurde architecturen en verwerking van berichtenwachtrijen.
- Delta Lake-wijzigingenfeeds: Voor het doorgeven van wijzigingen tussen Delta-tabellen.
- Cloud storage via Auto Loader: voor bestandsgebaseerde streaminginvoer.
- Socket- en aangepaste bronnen: voor gespecialiseerde gegevensinvoerscenario's.
Kies Gestructureerd streamen wanneer u gedetailleerde controle nodig hebt over streaminggedrag, aangepaste watermerken of vensterlogica, of wanneer u werkt met bronnen die niet worden ondersteund door abstracties op een hoger niveau.
JDBC- en ODBC-verbindingen
Notebook-gebaseerde datainname met JDBC of ODBC blijft een praktische benadering voor het halen van gegevens uit relationele databases. U schrijft code die rechtstreeks verbinding maakt met brondatabases, query's uitvoert en resultaten laadt in Delta-tabellen.
Deze benadering ondersteunt vrijwel elke database met een JDBC- of ODBC-stuurprogramma: SQL Server, Oracle, PostgreSQL, MySQL en vele andere. U implementeert volledige of incrementele belastingen door de juiste query's te schrijven, vaak met behulp van watermerkkolommen om de voortgang van extractie bij te houden.
Hoewel de beheerde connectors van Lakeflow Connect JDBC/ODBC voor veel scenario's vervangen, blijven op notebooks gebaseerde verbindingen waardevol wanneer:
- Uw database wordt niet ondersteund door beheerde Connectors van Lakeflow Connect.
- U hebt aangepaste extractielogica nodig die beheerde connectors niet kunnen gebruiken.
- U onderhoudt bestaande pijplijnen die dit patroon gebruiken.
- U hebt specifieke pushdown-optimalisaties voor query's nodig voor grote tabellen.
Wanneer u JDBC/ODBC gebruikt, slaat u referenties veilig op met behulp van Databricks-geheimen in plaats van ze in notebooks te coderen. Houd rekening met de impact op de prestaties van bronsystemen en implementeer de juiste beperking of planning om transactionele databases niet te overbelasten.
Voor on-premises databases is extra netwerkinfrastructuur vereist: Azure ExpressRoute/VPN voor directe JDBC-connectiviteit vanuit Databricks of Azure Data Factory met een Self-Hosted Integration Runtime om eerst gegevens in cloudopslag te landen.
Azure Data Factory
Azure Data Factory (ADF) fungeert als een indelings- en gegevensverplaatsingsplatform binnen het Azure-ecosysteem. Het excelleert bij het coördineren van werkstromen die meerdere services omvatten en gegevens van diverse bronnen in de cloudopslag plaatsen waar Azure Databricks deze kan verwerken.
ADF kan uitgebreid worden geïntegreerd met Microsoft-services zoals Dynamics 365, Azure SQL Database en Microsoft Fabric. Wanneer uw gegevens afkomstig zijn van deze bronnen, biedt ADF eenvoudige connectiviteit en kan deze gegevens in Azure Data Lake Storage landen voor volgende Databricks-verwerking.
Het is belangrijk om inzicht te krijgen in de juiste rol van ADF. ADF gebruiken voor:
- Orchestratie: werkstromen coördineren die betrekking hebben op meerdere Azure-services.
- Eerste gegevenslanding: gegevens verplaatsen van Azure-bronnen naar cloudopslag.
- Bedrijfsintegratie: wanneer bedrijfsbeleid ADF verplicht stelt voor gegevensverplaatsing.

Vermijd het gebruik van ADF voor etl-kerntransformaties in Databricks. Het uitvoeren van transformaties via ADF-activiteiten introduceert onnodige complexiteit en presteert minder efficiënt dan databricks-systeemeigen verwerking. Laat ADF gegevensverplaatsing verwerken in uw lakehouse en gebruik dan de Azure Databricks-tools voor transformatielogica.
Een beslissingskader toepassen
Het selecteren van een opnamehulpprogramma wordt duidelijker wanneer u uw scenario evalueert op basis van belangrijke beslissingscriteria.
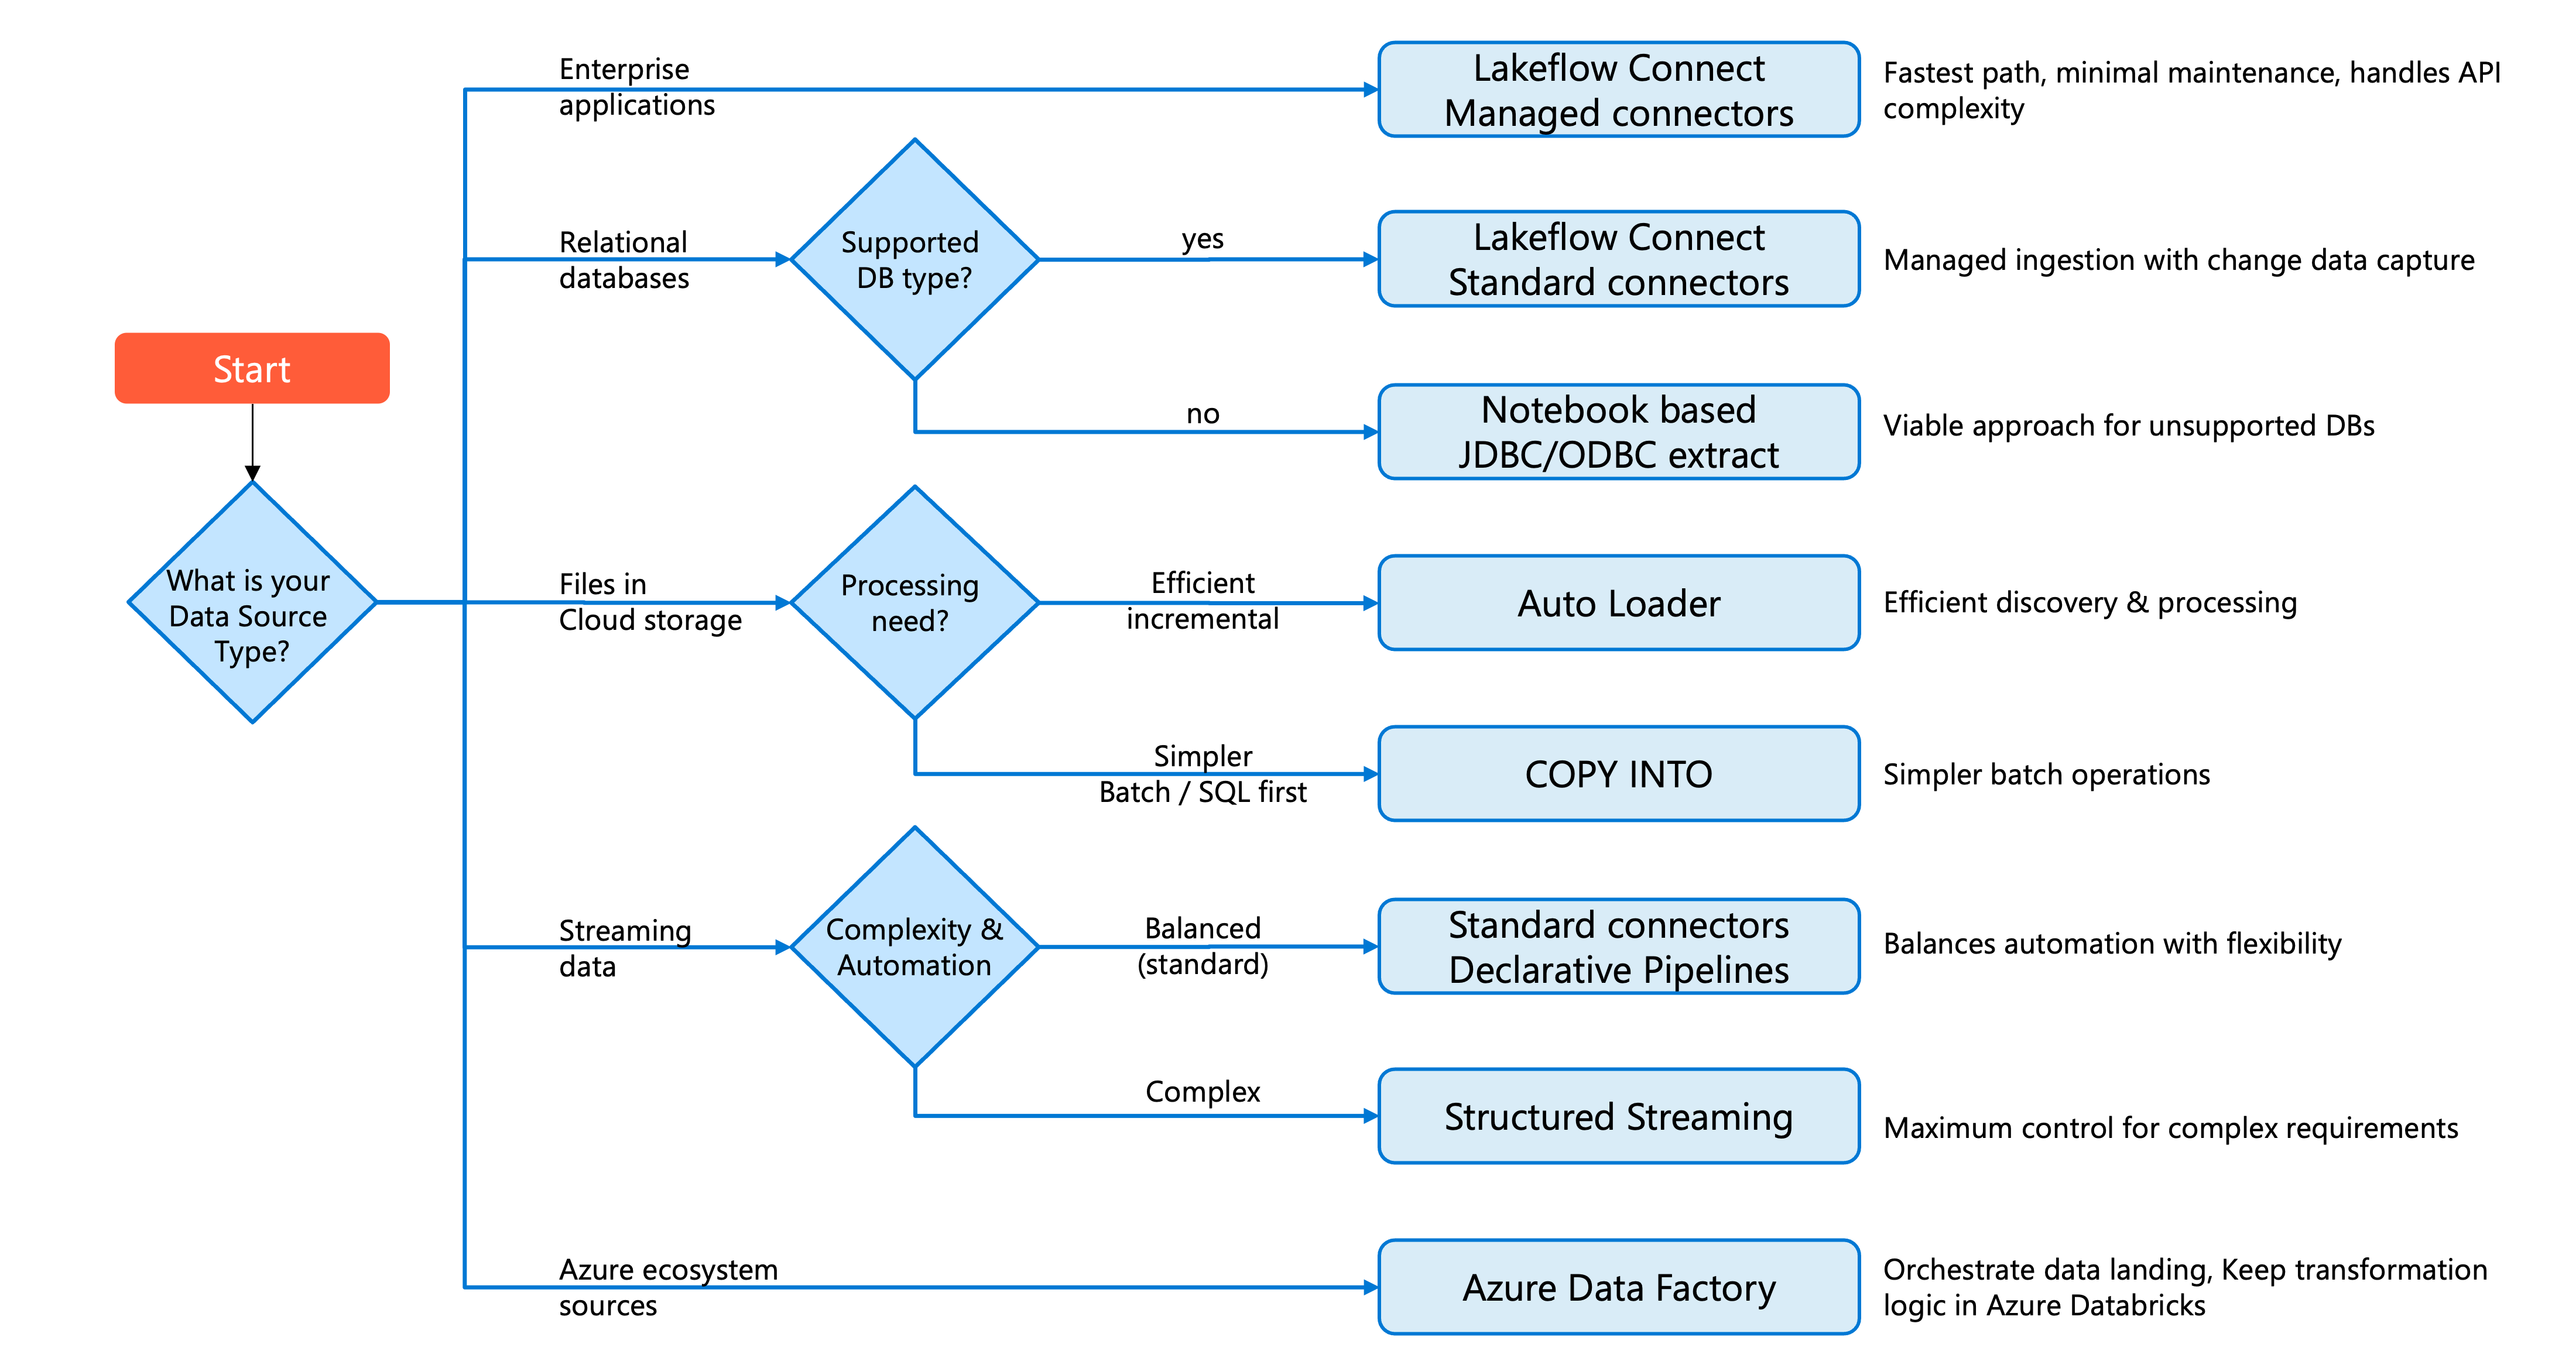
Begin met het identificeren van uw gegevensbrontype en overweeg vervolgens operationele vereisten en organisatiecontext.
Voor bedrijfstoepassingen (Salesforce, ServiceNow, SharePoint) bieden Lakeflow Connect beheerde connectors het snelste pad naar productie met minimaal onderhoud. Deze connectors verwerken de complexiteit van API-integratie, snelheidsbeperking en wijzigingen bijhouden.
Voor relationele databases met ondersteunde typen biedt Lakeflow Connect twee beheerde paden: databaseconnectors (op CDC gebaseerd, vereist gateway) voor continue wijzigingsopname en connectors op basis van query's voor eenvoudigere geplande opname met behulp van een cursorkolom. Voor niet-ondersteunde databases blijft JDBC-/ODBC-extractie op basis van notebooks een haalbare benadering.
Voor bestanden in cloudopslag biedt Auto Loader efficiënte incrementele detectie en verwerking. Gebruik COPY INTO voor eenvoudigere batchscenario's of wanneer u liever SQL-first-werkstromen gebruikt.
Voor het streamen van gegevens van berichtbussen (Kafka, Event Hubs, Pub/Sub), standaardconnectors met Lakeflow-pijplijnen balanceren automatisering met flexibiliteit. Voor complexe streamingvereisten biedt Structured Streaming maximale controle.
Voor Azure-ecosysteembronnen waarvoor coördinatie met andere services is vereist, kan Azure Data Factory gegevenslanding in uw Lakehouse organiseren. Behoud transformatielogica in Azure Databricks in plaats van in ADF-gegevensstromen.
Aanbeveling
Begin met de meest beheerde optie die voldoet aan uw vereisten. Beheerde connectors verminderen de ontwikkelingstijd en onderhoudslast. Verplaats alleen naar meer aanpasbare benaderingen wanneer niet aan specifieke vereisten kan worden voldaan door abstracties op een hoger niveau.
Uw keuze is ook afhankelijk van teamvaardigheden en organisatiestandaarden. Documenteer uw beslissingen en de redenering erachter om toekomstige teamleden inzicht te geven in de pijplijnarchitectuur.