Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Ta zawartość ma zastosowanie do:🟩Wersja 4.0 (ogólna dostępność) | Poprzednie wersje:🟦Wersja 3.1 (ogólna dostępność)🟥Wersja 3.0 (wycofanie)🟥Wersja 2.1 (wycofanie)
Ta zawartość ma zastosowanie do:🟩Wersja 3.1 (ogólna dostępność) | Najnowsza wersja:🟪Wersja 4.0 (ogólna dostępność) | Poprzednie wersje:🟦Wersja 3.0🟦Wersja 2.1
Ta zawartość ma zastosowanie do:🟥Wersja 3.0 (wycofanie) | Najnowsze wersje:🟪Wersja 4.0 (ogólna dostępność)🟪Wersja 3.1 (ogólna dostępność) | Poprzednia wersja:🟥Wersja 2.1 (wycofanie)
Ta zawartość ma zastosowanie do:🟥Wersja 2.1 | Najnowsza wersja:🟪Wersja 4.0 (ogólna dostępność)
Model analizy faktur Inteligencji Dokumentów korzysta z zaawansowanych funkcji optycznego rozpoznawania znaków (OCR), aby analizować i wyodrębniać kluczowe pola oraz elementy liniowe z faktur sprzedaży, rachunków za media i zamówień zakupu. Faktury mogą mieć różne formaty i jakość, w tym obrazy przechwycone przez telefon, zeskanowane dokumenty i cyfrowe pliki PDF. Interfejs API analizuje tekst faktury; Wyodrębnia kluczowe informacje, takie jak nazwa klienta, adres rozliczeniowy, data ukończenia i kwota należna; funkcja zwraca ustrukturyzowaną reprezentację danych JSON. Model obsługuje obecnie faktury w 27 językach.
Obsługiwane typy dokumentów:
- Faktury
- Rachunki za usługi użyteczności publicznej
- Zamówienia sprzedaży
- Zamówienia zakupu
Automatyczne przetwarzanie faktur
Automatyczne przetwarzanie faktur to proces wyodrębniania pól kluczy accounts payable z dokumentów konta rozliczeniowego. Wyodrębnione dane obejmują pozycje z faktur zintegrowanych z przepływami pracy działu zobowiązań (AP) na potrzeby przeglądów i płatności. W przeszłości proces płatności jest wykonywany ręcznie, a zatem bardzo czasochłonny. Dokładne wyodrębnianie kluczowych danych z faktur jest zazwyczaj pierwszym i jednym z najważniejszych kroków w procesie automatyzacji faktur.
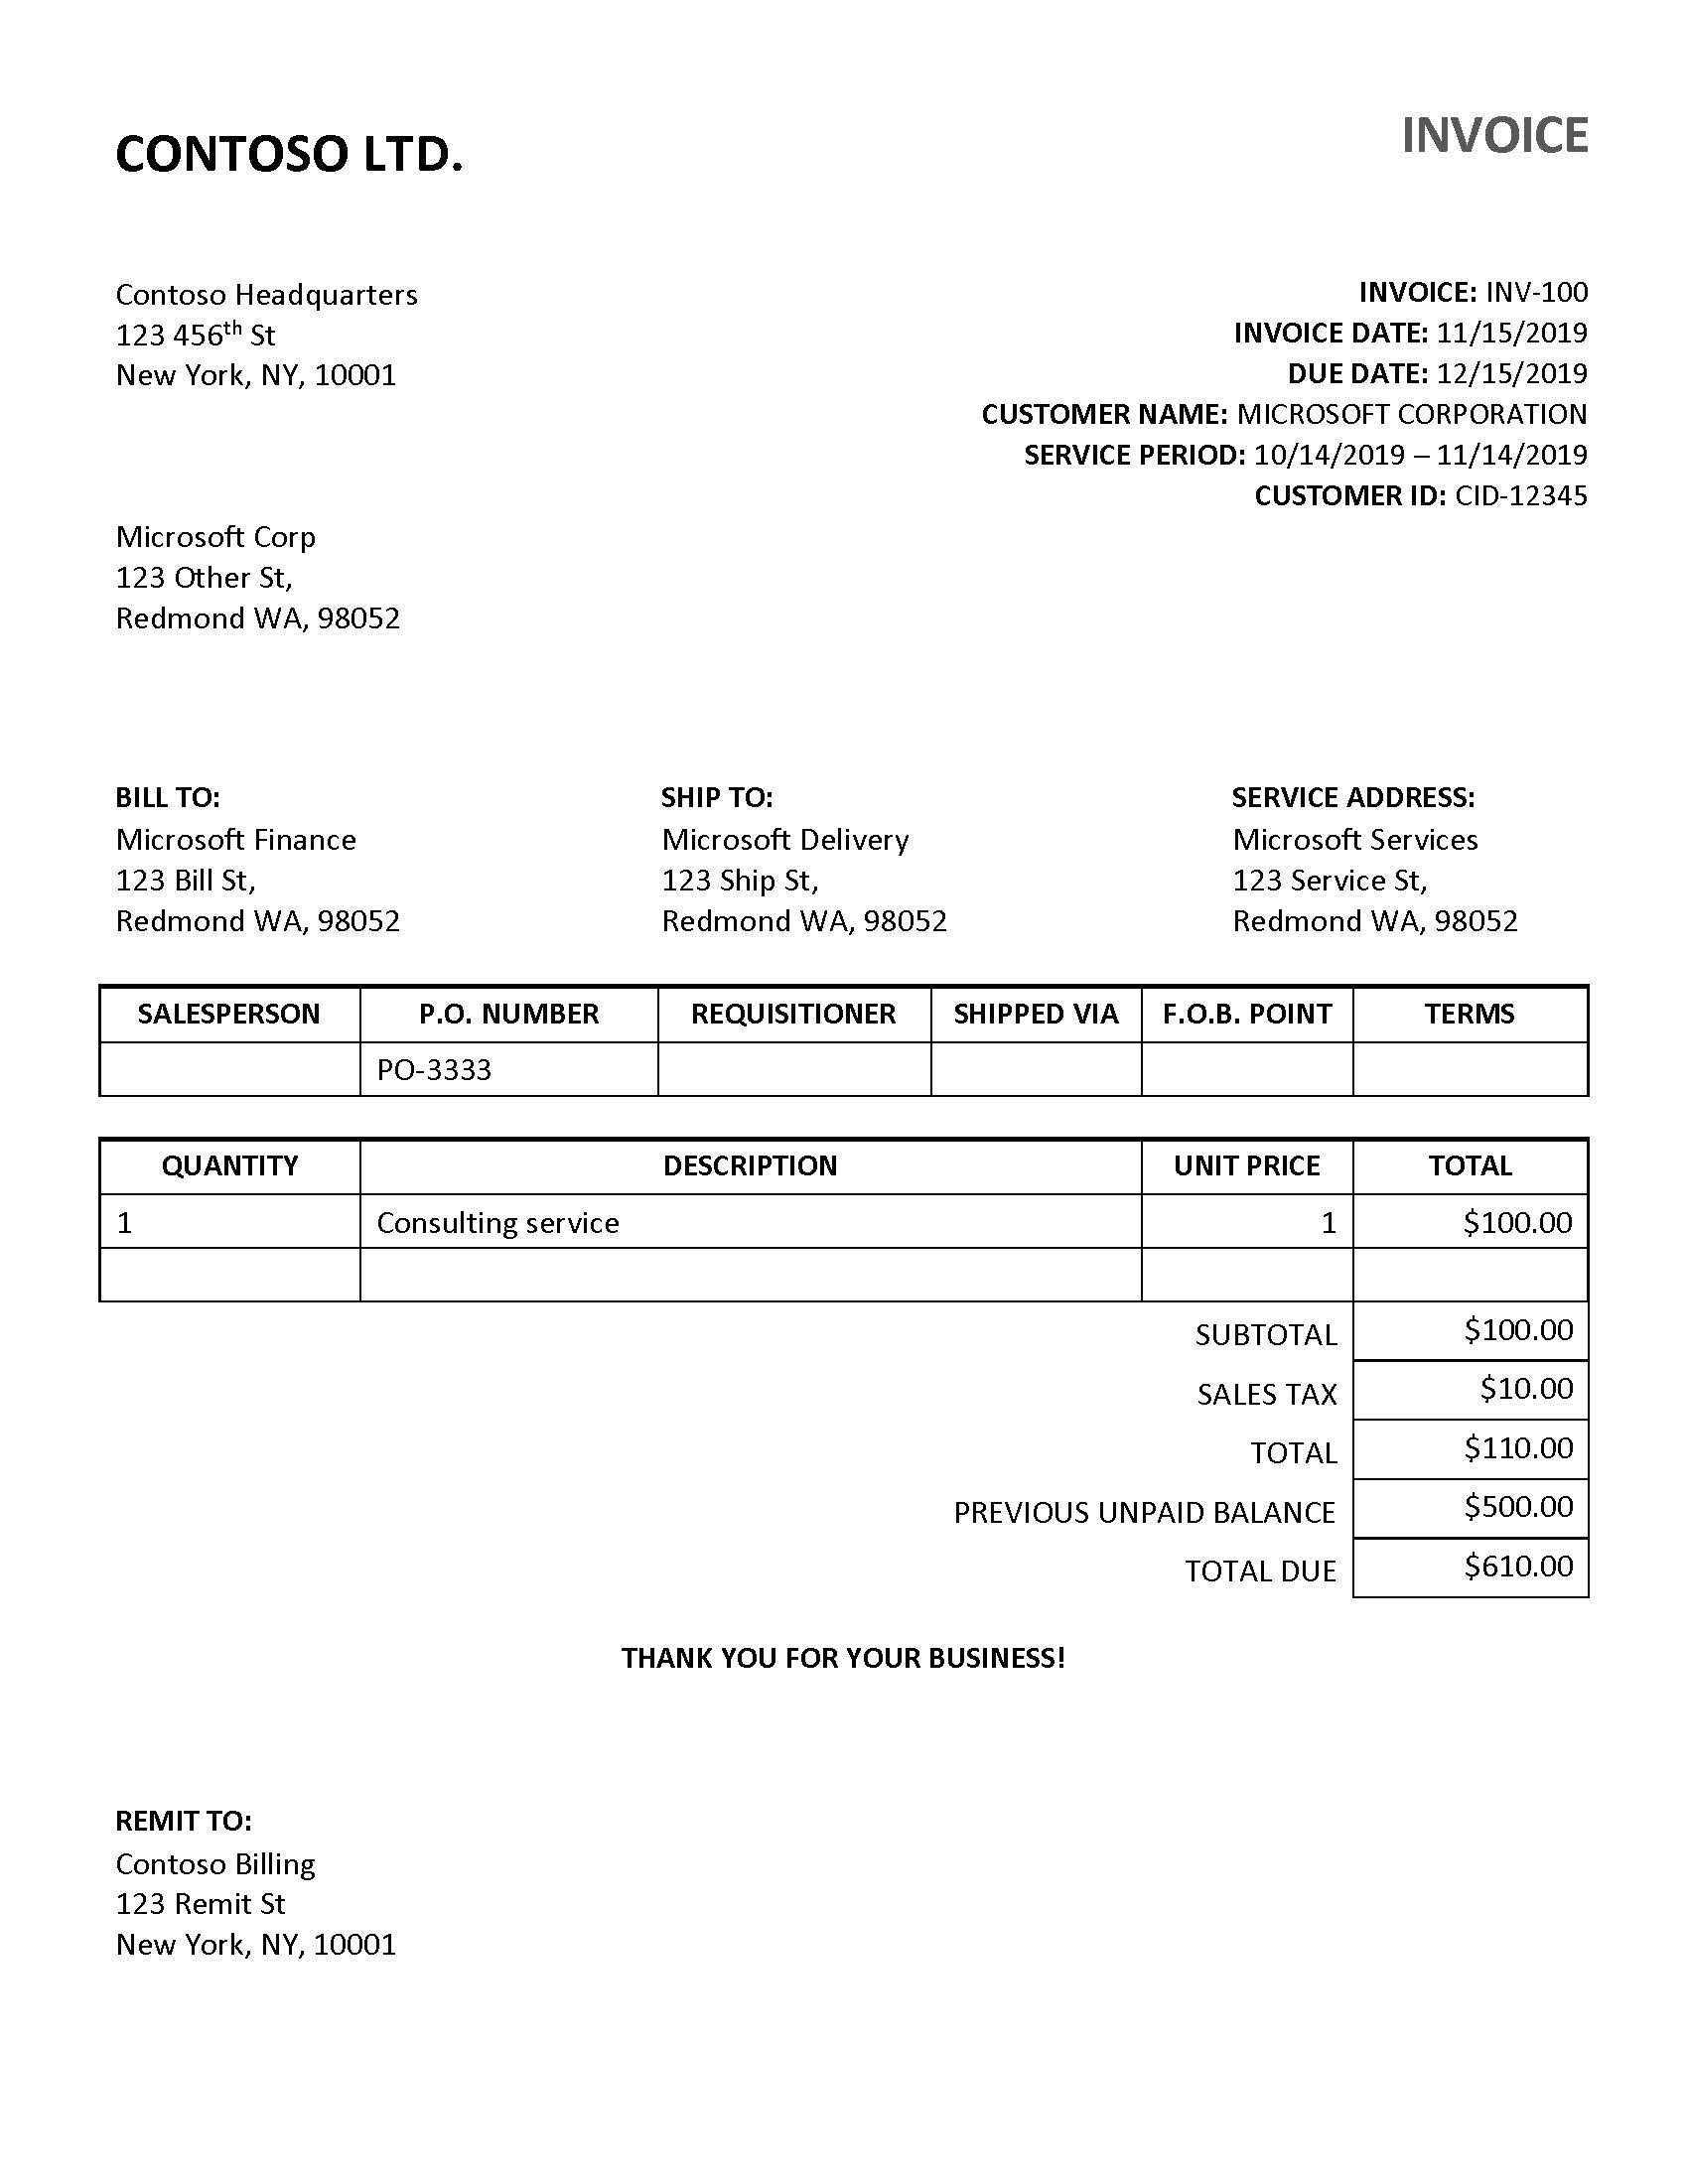
Przykładowa faktura przetworzona za pomocą programu Document Intelligence Studio:

Przykładowa faktura przetworzona za pomocą narzędzia do etykietowania próbek analizy dokumentów:

Opcje programowania
Analiza dokumentów w wersji 4.0: 2024-11-30 (GA) obsługuje następujące narzędzia, aplikacje i biblioteki:
| Funkcja | Zasoby | Identyfikator modelu |
|---|---|---|
| Model faktury | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
wstępnie utworzona faktura |
Narzędzie Document Intelligence w wersji 3.1 obsługuje następujące narzędzia, aplikacje i biblioteki:
| Funkcja | Zasoby | Identyfikator modelu |
|---|---|---|
| Model faktury | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
wstępnie utworzona faktura |
Narzędzie Document Intelligence w wersji 3.0 obsługuje następujące narzędzia, aplikacje i biblioteki:
| Funkcja | Zasoby | Identyfikator modelu |
|---|---|---|
| Model faktury | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
wstępnie utworzona faktura |
Narzędzie Document Intelligence w wersji 2.1 obsługuje następujące narzędzia, aplikacje i biblioteki:
| Funkcja | Zasoby |
|---|---|
| Model faktury | • Narzędzie do etykietowania w ramach analizy dokumentów• REST API• SDK biblioteki klienckiej• Kontener Docker dla analizy dokumentów |
Wymagania dotyczące danych wejściowych
Obsługiwane są następujące formaty plików.
| Model | Obraz: JPEG/JPG, PNG, BMP, TIFF, HEIF |
Office: Word (DOCX), Excel (XLSX), PowerPoint (PPTX), HTML |
|
|---|---|---|---|
| Odczytu | ✔ | ✔ | ✔ |
| Układ | ✔ | ✔ | ✔ |
| Dokument ogólny | ✔ | ✔ | |
| Prekompilowanych | ✔ | ✔ | |
| Wyodrębnianie niestandardowe | ✔ | ✔ | |
| Klasyfikacja niestandardowa | ✔ | ✔ | ✔ |
- Zdjęcia i skanowania: Aby uzyskać najlepsze wyniki, podaj jedno jasne zdjęcie lub wysokiej jakości skanowanie na dokument.
- Pliki PDF i pliki TIFF: w przypadku plików PDF i plików TIFF można przetworzyć maksymalnie 2000 stron. (W przypadku subskrypcji w warstwie Bezpłatna przetwarzane są tylko dwie pierwsze strony).
- Rozmiar pliku: rozmiar pliku do analizowania dokumentów wynosi 500 MB dla warstwy płatnej (S0) i 4 MB dla warstwy bezpłatnej (F0).
- Wymiary obrazu: Wymiary muszą mieć od 50 pikseli x 50 pikseli do 10 000 pikseli x 10 000 pikseli.
- Blokady haseł: jeśli pliki PDF są zablokowane hasłem, należy usunąć blokadę przed przesłaniem.
- Wysokość tekstu: minimalna wysokość tekstu do wyodrębnienia wynosi 12 pikseli dla obrazu 1024 x 768 pikseli. Ten wymiar odpowiada około 8-punktowemu tekstowi na 150 kropek na cal.
- Trenowanie modelu niestandardowego: maksymalna liczba stron dla danych szkoleniowych to 500 dla niestandardowego modelu szablonu i 50 000 dla niestandardowego modelu neuronowego.
- Trenowanie niestandardowego modelu wyodrębniania: całkowity rozmiar danych treningowych wynosi 50 MB dla modelu szablonowego i 1 GB dla modelu neuronowego.
- Trenowanie niestandardowego modelu klasyfikacyjnego: całkowity rozmiar danych treningowych wynosi 1 GB z maksymalnie 10 000 stron. W przypadku wersji 2024-11-30 (GA) całkowity rozmiar danych treningowych wynosi 2 GB z maksymalnie 10 000 stron.
- Typy plików pakietu Office (DOCX, XLSX, PPTX): Maksymalny limit długości ciągu wynosi 8 milionów znaków.
- Obsługiwane formaty plików: JPEG, PNG, PDF i TIFF.
- Obsługiwane pliki PDF i TIFF, przetwarzane są maksymalnie 2000 stron. W przypadku subskrybentów warstwy Bezpłatna przetwarzane są tylko dwie pierwsze strony.
- Obsługiwany rozmiar pliku musi być mniejszy niż 50 MB i wymiary co najmniej 50 x 50 pikseli i maksymalnie 10 000 x 10 000 pikseli.
Wyodrębnianie danych modelu faktury
Zobacz, jak dane, w tym informacje o kliencie, dane dostawcy i pozycje faktury, są wyodrębniane z faktur. Potrzebne są następujące zasoby:
Subskrypcja Azure — możesz utworzyć ją bezpłatnie.
Instancja Document Intelligence w portalu Azure. Aby wypróbować usługę, możesz użyć bezpłatnej warstwy cenowej (
F0). Po wdrożeniu zasobu wybierz pozycję Przejdź do zasobu , aby uzyskać klucz i punkt końcowy.

Na stronie głównej Document Intelligence Studio wybierz pozycję Faktury.
Możesz przeanalizować przykładową fakturę lub przekazać własne pliki.
Wybierz przycisk Run analysis (Uruchom analizę ), a w razie potrzeby skonfiguruj opcje Analizuj :

Narzędzie do etykietowania przykładów z analizą dokumentów
Przejdź do Narzędzia Przykładowego Inteligencji Dokumentów.
Na stronie głównej przykładowego narzędzia wybierz kafelek Użyj wstępnie utworzonego modelu w celu pobrania danych.

Wybierz typ formularza do przeanalizowania z menu rozwijanego.
Wybierz adres URL pliku, który chcesz przeanalizować z poniższych opcji:
W polu Źródło wybierz pozycję Adres URL z menu rozwijanego, wklej wybrany adres URL i wybierz przycisk Pobierz .

W polu Punkt końcowy usługi Analizy dokumentów wklej punkt końcowy uzyskany w ramach subskrypcji analizy dokumentów.
W polu klucza wklej klucz uzyskany z zasobu analizy dokumentów.

Wybierz pozycję Uruchom analizę. Narzędzie do etykietowania próbek dokumentów w systemie inteligentnej analizy wywołuje API analizy wstępnie zbudowanych i analizuje dokument.
Wyświetl wyniki — zobacz wyodrębnione pary klucz-wartość, elementy wiersza, wyróżniony tekst wyodrębniony i wykryte tabele.

Uwaga
Przykładowe narzędzie etykietowania nie obsługuje formatu pliku BMP. Jest to ograniczenie narzędzia, a nie usługi analizy dokumentów.
Obsługiwane języki i ustawienia regionalne
Aby uzyskać pełną listę obsługiwanych języków, zobacz naszą wstępnie utworzoną stronę obsługi języka modelu .
Wyodrębnianie pól
Dla obsługiwanych pól wyodrębniania dokumentów zobacz na stronie invoice model schema w naszym przykładowym repozytorium GitHub.
Pary klucz-wartość faktury i wyodrębnione elementy wiersza znajdują się w
documentResultssekcji danych wyjściowych JSON.
Pary klucz-wartość
Wstępnie utworzony model faktury obsługuje opcjonalne zwracanie par klucz-wartość. Domyślnie zwracanie par klucz-wartość jest wyłączone. Pary klucz-wartość są określonymi zakresami na fakturze, które identyfikują etykietę lub klucz oraz skojarzona odpowiedź lub wartość. Na fakturze te pary mogą być etykietą i wartością wprowadzoną przez użytkownika dla tego pola lub numeru telefonu. Model sztucznej inteligencji jest trenowany w celu wyodrębniania możliwych do zidentyfikowania kluczy i wartości w oparciu o szeroką gamę typów dokumentów, formatów i struktur.
Klucze mogą również istnieć w izolacji, gdy model wykryje, że klucz istnieje, bez skojarzonej wartości lub podczas przetwarzania pól opcjonalnych. Na przykład pole nazwy środkowej może być puste w formularzu w niektórych przypadkach. Pary klucz-wartość są zawsze zakresami tekstu zawartego w dokumencie. W przypadku dokumentów, w których ta sama wartość jest opisana na różne sposoby, na przykład klient/użytkownik, skojarzony klucz przyjmuje wartość "klient" lub "użytkownik", w zależności od kontekstu.
Dane wyjściowe JSON
Dane wyjściowe JSON mają trzy części:
-
"readResults"węzeł zawiera cały rozpoznany tekst i znaczniki wyboru. Tekst jest uporządkowany za pomocą strony, a następnie według wierszy, a następnie według pojedynczych wyrazów. -
"pageResults"węzeł zawiera tabele i komórki wyodrębnione z ich ramkami ograniczającymi, poziomem ufności oraz odniesienia do linii i wyrazów w readResults. -
"documentResults"węzeł zawiera wartości specyficzne dla faktury i elementy wiersza odnalezione przez model. W tym miejscu można znaleźć wszystkie pola z faktury, takie jak identyfikator faktury, wysyłka do, rachunek, klient, suma, elementy wiersza i wiele innych.
Przewodnik migracji
- Postępuj zgodnie z naszym przewodnikiem migracji do analizy dokumentów w wersji 3.1 , aby dowiedzieć się, jak używać wersji 3.0 w aplikacjach i przepływach pracy.
::: koniec pseudonimu
Następne kroki
Spróbuj przetwarzać własne formularze i dokumenty za pomocą programu Document Intelligence Studio.
Ukończ przewodnik szybkiego startu dotyczący analizy dokumentów i zacznij tworzyć aplikację do przetwarzania dokumentów w wybranym języku programowania.
Spróbuj przetwarzać własne formularze i dokumenty za pomocą narzędzia etykietowania próbek Dokument Intelligence.
Ukończ przewodnik szybkiego startu dotyczący analizy dokumentów i zacznij tworzyć aplikację do przetwarzania dokumentów w wybranym języku programowania.