Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Ta dokumentacja obejmuje Workspace Feature Store. Databricks zaleca korzystanie z inżynierii funkcji w Unity Catalog. Magazyn funkcji obszaru roboczego w przyszłości będzie zlikwidowany.
Aby uzyskać informacje na temat pracy z tabelami cech w Unity Catalog, zobacz Tabele cech w Unity Catalog.
Na tej stronie opisano sposób tworzenia tabel cech i pracy z nimi w magazynie funkcji obszaru roboczego.
Uwaga
Jeśli obszar roboczy jest włączony dla Unity Catalogu, każda tabela zarządzana przez Unity Catalog, która ma klucz podstawowy, jest automatycznie feature table, której można użyć do trenowania i wnioskowania modelu. Wszystkie możliwości Unity Catalog, takie jak zabezpieczenia, rodowód, tagowanie i dostęp między obszarami roboczymi, są automatycznie dostępne dla tabeli cech. Aby uzyskać informacje o pracy z tabelami cech w obszarze roboczym z włączonym Unity Catalog, zobacz Tabele cech w Unity Catalog.
Aby uzyskać informacje na temat śledzenia pochodzenia cech oraz ich świeżości, zobacz Eksplorowanie cech i pochodzenia (starsza wersja).
Uwaga
Nazwy tabel baz danych i funkcji mogą zawierać tylko znaki alfanumeryczne i podkreślenia (_).
Tworzenie bazy danych dla tabel funkcji
Przed utworzeniem tabel funkcji należy utworzyć bazę danych, aby je przechowywać.
%sql CREATE DATABASE IF NOT EXISTS <database-name>
Tabele funkcji są przechowywane jako tabele delty. Podczas tworzenia tabeli funkcji z create_table programem (klient magazynu funkcji w wersji 0.3.6 lub nowszej) lub create_feature_table (w wersji 0.3.5 lub starszej) należy określić nazwę bazy danych. Na przykład ten argument tworzy tabelę delty o nazwie customer_features w bazie danych recommender_system.
name='recommender_system.customer_features'
Podczas publikowania tabeli funkcji w sklepie online domyślna nazwa tabeli i bazy danych to te określone podczas tworzenia tabeli; Można określić różne nazwy przy użyciu publish_table metody .
Interfejs użytkownika magazynu funkcji usługi Databricks zawiera nazwę tabeli i bazy danych w magazynie online wraz z innymi metadanymi.
Tworzenie tabeli feature w Databricks Feature Store
Uwaga
Możesz również zarejestrować istniejącą tabelę delty jako tabelę funkcji. Zobacz Rejestrowanie istniejącej tabeli Delta jako tabeli funkcji.
Podstawowe kroki tworzenia tabeli funkcji to:
- Napisz funkcje języka Python, aby obliczyć funkcje. Dane wyjściowe każdej funkcji powinny być ramką danych platformy Apache Spark z unikatowym kluczem podstawowym. Klucz podstawowy może składać się z co najmniej jednej kolumny.
- Utwórz tabelę funkcji, tworząc wystąpienie elementu
FeatureStoreClienti przy użyciucreate_table(w wersji 0.3.6 lub nowszej) lubcreate_feature_table(w wersji 0.3.5 lub starszej). - Wypełnij tabelę funkcji przy użyciu polecenia
write_table.
Aby uzyskać szczegółowe informacje na temat poleceń i parametrów używanych w poniższych przykładach, zobacz Feature Store Python API reference.
Wersja 0.3.6 lub nowsze
from databricks.feature_store import feature_table

def compute_customer_features(data):
  ''' Feature computation code returns a DataFrame with 'customer_id' as primary key'''
  pass

# create feature table keyed by customer_id
# take schema from DataFrame output by compute_customer_features
from databricks.feature_store import FeatureStoreClient

customer_features_df = compute_customer_features(df)

fs = FeatureStoreClient()

customer_feature_table = fs.create_table(
  name='recommender_system.customer_features',
  primary_keys='customer_id',
  schema=customer_features_df.schema,
  description='Customer features'
)

# An alternative is to use `create_table` and specify the `df` argument.
# This code automatically saves the features to the underlying Delta table.

# customer_feature_table = fs.create_table(
#  ...
#  df=customer_features_df,
#  ...
# )

# To use a composite key, pass all keys in the create_table call

# customer_feature_table = fs.create_table(
#   ...
#   primary_keys=['customer_id', 'date'],
#   ...
# )

# Use write_table to write data to the feature table
# Overwrite mode does a full refresh of the feature table

fs.write_table(
  name='recommender_system.customer_features',
  df = customer_features_df,
  mode = 'overwrite'
)
Wersja 0.3.5 i niższe
from databricks.feature_store import feature_table

def compute_customer_features(data):
  ''' Feature computation code returns a DataFrame with 'customer_id' as primary key'''
  pass

# create feature table keyed by customer_id
# take schema from DataFrame output by compute_customer_features
from databricks.feature_store import FeatureStoreClient

customer_features_df = compute_customer_features(df)

fs = FeatureStoreClient()

customer_feature_table = fs.create_feature_table(
  name='recommender_system.customer_features',
  keys='customer_id',
  schema=customer_features_df.schema,
  description='Customer features'
)

# An alternative is to use `create_feature_table` and specify the `features_df` argument.
# This code automatically saves the features to the underlying Delta table.

# customer_feature_table = fs.create_feature_table(
#  ...
#  features_df=customer_features_df,
#  ...
# )

# To use a composite key, pass all keys in the create_feature_table call

# customer_feature_table = fs.create_feature_table(
#   ...
#   keys=['customer_id', 'date'],
#   ...
# )

# Use write_table to write data to the feature table
# Overwrite mode does a full refresh of the feature table

fs.write_table(
  name='recommender_system.customer_features',
  df = customer_features_df,
  mode = 'overwrite'
)
Rejestrowanie istniejącej tabeli delty jako tabeli funkcji
W wersji 0.3.8 lub nowszej można zarejestrować istniejącą tabelę delty jako tabelę funkcji. Tabela Delta musi istnieć w magazynie metadanych.
Uwaga
Aby zaktualizować zarejestrowaną tabelę cech, należy użyć magazynu funkcji języka Python API.
fs.register_table(
  delta_table='recommender.customer_features',
  primary_keys='customer_id',
  description='Customer features'
)
Kontrolowanie dostępu do tabel funkcji
Zobacz Kontrola dostępu (starsza wersja).
Aktualizowanie tabeli funkcji
Tabelę funkcji można zaktualizować, dodając nowe funkcje lub modyfikując określone wiersze na podstawie klucza podstawowego.
Nie można zaktualizować następujących metadanych tabeli funkcji:
- Klucz podstawowy
- Klucz partycji
- Nazwa lub typ istniejącej funkcji
Dodawanie nowych funkcji do istniejącej tabeli funkcji
Nowe funkcje można dodać do istniejącej tabeli funkcji na jeden z dwóch sposobów:
- Zaktualizuj istniejącą funkcję obliczania cech i uruchom
write_tableze zwróconą ramką danych. Spowoduje to zaktualizowanie schematu tabeli funkcji i scalanie nowych wartości funkcji na podstawie klucza podstawowego. - Utwórz nową funkcję obliczeniową funkcji, aby obliczyć nowe wartości funkcji. Ramka danych zwracana przez tę nową funkcję obliczeniową musi zawierać klucze podstawowe tabel funkcji i klucze partycji (jeśli zdefiniowano). Uruchom
write_tablez DataFrame, aby zapisać nowe cechy w istniejącej tabeli cech przy użyciu tego samego klucza podstawowego.
Aktualizowanie tylko określonych wierszy w tabeli funkcji
Użyj mode = "merge" w write_table. Wiersze, których klucz podstawowy nie istnieje w ramce danych przesłanej w wywołaniu write_table, pozostają niezmienione.
fs.write_table(
  name='recommender.customer_features',
  df = customer_features_df,
  mode = 'merge'
)
Planowanie zadania w celu zaktualizowania tabeli funkcji
Aby zapewnić, że funkcje w tabelach funkcji zawsze mają najnowsze wartości, usługa Databricks zaleca utworzenie zadania, które regularnie, na przykład codziennie, uruchamia notatnik w celu aktualizowania tabeli funkcji. Jeśli masz już utworzone nieplanowane zadanie, możesz przekonwertować je na zaplanowane zadanie, aby upewnić się, że wartości funkcji są zawsze aktualne. Zobacz Zadania lakeflow.
Kod aktualizowania tabeli funkcji używa metody mode='merge', jak pokazano w poniższym przykładzie.
fs = FeatureStoreClient()

customer_features_df = compute_customer_features(data)

fs.write_table(
  df=customer_features_df,
  name='recommender_system.customer_features',
  mode='merge'
)
Przechowywanie poprzednich wartości codziennych funkcji
Zdefiniuj tabelę funkcji przy użyciu złożonego klucza podstawowego. Uwzględnij datę w kluczu podstawowym. Na przykład w przypadku tabeli store_purchases funkcji można użyć złożonego klucza podstawowego (date, user_id) i klucza date partycji do wydajnego odczytu.
fs.create_table(
  name='recommender_system.customer_features',
  primary_keys=['date', 'customer_id'],
  partition_columns=['date'],
  schema=customer_features_df.schema,
  description='Customer features'
)
Następnie możesz utworzyć kod do odczytu z tabeli cech filtrowanej do okresu zainteresowania.
Tabelę funkcji szeregów czasowych można również utworzyć, określając date kolumnę jako klucz znacznika czasu przy użyciu argumentu timestamp_keys .
fs.create_table(
  name='recommender_system.customer_features',
  primary_keys=['date', 'customer_id'],
  timestamp_keys=['date'],
  schema=customer_features_df.schema,
  description='Customer time series features'
)
Umożliwia to wyszukiwanie punktowe w czasie podczas używania create_training_set lub score_batch. System wykonuje sprzężenie z wykorzystaniem znacznika czasu przy użyciu określonego elementu timestamp_lookup_key.
Aby zachować aktualność tabeli funkcji, skonfiguruj regularnie zaplanowane zadanie pisania funkcji lub przesyłaj strumieniowo nowe wartości funkcji do tabeli funkcji.
Tworzenie potoku obliczeń funkcji przesyłania strumieniowego w celu zaktualizowania funkcji
Aby utworzyć potok obliczeniowy dla funkcjonalności przesyłania strumieniowego, przekaż strumieniowanie DataFrame jako argument do elementu write_table. Ta metoda zwraca StreamingQuery obiekt.
def compute_additional_customer_features(data):
  ''' Returns Streaming DataFrame
  '''
  pass  # not shown

customer_transactions = spark.readStream.load("dbfs:/events/customer_transactions")
stream_df = compute_additional_customer_features(customer_transactions)

fs.write_table(
  df=stream_df,
  name='recommender_system.customer_features',
  mode='merge'
)
Odczytywanie z tabeli funkcji
Użyj read_table do odczytania wartości funkcji.
fs = feature_store.FeatureStoreClient()
customer_features_df = fs.read_table(
  name='recommender.customer_features',
)
Wyszukiwanie i przeglądanie tabel funkcji
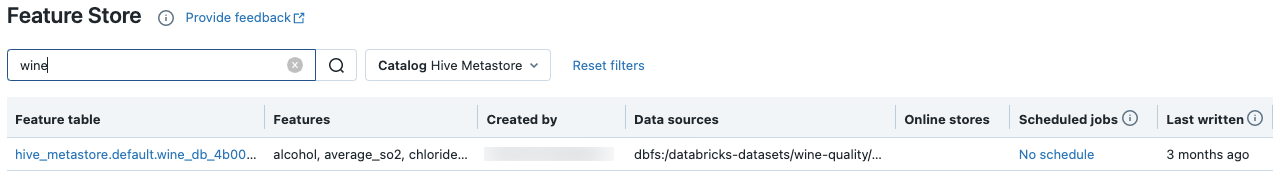
Użyj interfejsu użytkownika repozytorium cech, aby wyszukać lub przeglądać tabele cech.
Na pasku bocznym w obszarze Sztuczna inteligencja/uczenie maszynowe kliknij pozycję Funkcje , aby wyświetlić interfejs użytkownika magazynu funkcji.
W polu wyszukiwania wprowadź całą lub część nazwy tabeli funkcji, funkcji lub źródła danych używanego do obliczeń funkcji. Możesz również wprowadzić wszystkie lub część klucza lub wartości tagu. Tekst wyszukiwania jest niewrażliwy na wielkość liter.
Uzyskaj metadane tabeli funkcji
Interfejs API do pobierania metadanych tabeli funkcji zależy od używanej wersji środowiska uruchomieniowego usługi Databricks. W przypadku wersji 0.3.6 lub nowszej użyj polecenia get_table. W przypadku wersji 0.3.5 lub starszej użyj polecenia get_feature_table.
# this example works with v0.3.6 and above
# for v0.3.5, use `get_feature_table`
from databricks.feature_store import FeatureStoreClient
fs = FeatureStoreClient()
fs.get_table("feature_store_example.user_feature_table")
Praca z tagami tabeli funkcji
Tagi to pary klucz-wartość, które można utworzyć i użyć do wyszukiwania tabel funkcji. Tagi można tworzyć, edytować i usuwać za pomocą interfejsu użytkownika Feature Store lub Feature Store Python API.
Praca z tagami tabeli funkcji w interfejsie użytkownika
Użyj interfejsu użytkownika repozytorium cech, aby wyszukać lub przeglądać tabele cech. Aby uzyskać dostęp do interfejsu użytkownika, na pasku bocznym w obszarze AI/ML kliknij pozycję Funkcje.
Dodaj tag przy użyciu interfejsu użytkownika Feature Store
Kliknij
 , jeśli nie jest już otwarta. Zostanie wyświetlona tabela tagów.

Kliknij pola Nazwa i Wartość, a następnie wprowadź klucz i wartość tagu.
Kliknij przycisk Dodaj.
Edytuj lub usuń tag, korzystając z interfejsu użytkownika Feature Store
Aby edytować lub usunąć istniejący tag, użyj ikon w kolumnie Akcje .

Obsługa tagów tabeli funkcji przy użyciu interfejsu API Python Feature Store
Na klastrach działających w wersji 0.4.1 lub nowszej można tworzyć, edytować i usuwać tagi przy użyciu API języka Python Feature Store.
Wymagania
Klient Feature Store w wersji 0.4.1 lub nowszej
Tworzenie tabeli cech z tagiem przy użyciu interfejsu API magazynu cech w języku Python
from databricks.feature_store import FeatureStoreClient
fs = FeatureStoreClient()

customer_feature_table = fs.create_table(
  ...
  tags={"tag_key_1": "tag_value_1", "tag_key_2": "tag_value_2", ...},
  ...
)
Dodawanie, aktualizowanie i usuwanie tagów przy użyciu Python API Feature Store
from databricks.feature_store import FeatureStoreClient
fs = FeatureStoreClient()

# Upsert a tag
fs.set_feature_table_tag(table_name="my_table", key="quality", value="gold")

# Delete a tag
fs.delete_feature_table_tag(table_name="my_table", key="quality")
Aktualizowanie źródeł danych dla tabeli funkcji
Magazyn funkcji automatycznie śledzi źródła danych używane do obliczania funkcji. Możesz również ręcznie zaktualizować źródła danych, korzystając z interfejsu API języka Python Feature Store.
Wymagania
Klient Feature Store w wersji 0.5.0 lub nowszej
Dodaj źródła danych przy użyciu interfejsu API Python Feature Store
Poniżej przedstawiono kilka przykładowych poleceń. Aby uzyskać szczegółowe informacje, zobacz dokumentację interfejsu API.
from databricks.feature_store import FeatureStoreClient
fs = FeatureStoreClient()

# Use `source_type="table"` to add a table in the metastore as data source.
fs.add_data_sources(feature_table_name="clicks", data_sources="user_info.clicks", source_type="table")

# Use `source_type="path"` to add a data source in path format.
fs.add_data_sources(feature_table_name="user_metrics", data_sources="dbfs:/FileStore/user_metrics.json", source_type="path")

# Use `source_type="custom"` if the source is not a table or a path.
fs.add_data_sources(feature_table_name="user_metrics", data_sources="user_metrics.txt", source_type="custom")
Usuwanie źródeł danych za pomocą Python API Feature Store
Aby uzyskać szczegółowe informacje, zobacz dokumentację interfejsu API.
Uwaga
Następujące polecenie usuwa źródła danych wszystkich typów ("table", "path" i "custom"), które są zgodne z nazwami źródłowymi.
from databricks.feature_store import FeatureStoreClient
fs = FeatureStoreClient()
fs.delete_data_sources(feature_table_name="clicks", sources_names="user_info.clicks")
Usuwanie tabeli funkcji
Tabelę funkcji można usunąć za pomocą interfejsu użytkownika Feature Store lub interfejsu API języka Python Feature Store.
Uwaga
- Usunięcie tabeli funkcji może prowadzić do nieoczekiwanych błędów u producentów nadrzędnych i odbiorców podrzędnych (modeli, punktów końcowych i zaplanowanych zadań). Musisz usunąć opublikowane sklepy online u dostawcy usług w chmurze.
- Gdy usuniesz tabelę funkcji przy użyciu interfejsu API, bazowa tabela Delta również zostaje usunięta. Po usunięciu tabeli funkcji z interfejsu użytkownika należy oddzielnie usunąć podstawową tabelę delty.
Usuwanie tabeli funkcji przy użyciu interfejsu użytkownika
Na stronie tabeli funkcji kliknij
 po prawej stronie nazwy tabeli funkcji i wybierz pozycję Usuń. Jeśli nie masz uprawnień CAN MANAGE dla tabeli funkcji, ta opcja nie będzie widoczna.

W oknie dialogowym Usuwanie tabeli funkcji kliknij przycisk Usuń , aby potwierdzić.
Jeśli chcesz również usunąć podstawową tabelę Delta, uruchom następujące polecenie w notebooku.
%sql DROP TABLE IF EXISTS <feature-table-name>;
Usuwanie tabeli cech za pomocą interfejsu API Pythona magazynu funkcji
W przypadku klienta Feature Store w wersji 0.4.1 lub nowszej można użyć polecenia drop_table, aby usunąć tabelę funkcji. Usunięcie tabeli z tabelą drop_tablepowoduje również usunięcie bazowej tabeli delty.
fs.drop_table(
  name='recommender_system.customer_features'
)