Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Te funkcje i ulepszenia platformy Azure Databricks zostały wydane w lipcu 2019 r.
Uwaga
Wydania są etapowe. Twoje konto usługi Azure Databricks może nie zostać zaktualizowane do tygodnia po początkowej dacie wydania.
Wkrótce: usługa Databricks 6.0 nie będzie obsługiwać języka Python 2
W oczekiwaniu na zbliżający się koniec życia języka Python 2 ogłoszony na 2020 r. środowisko Python 2 nie będzie obsługiwane w środowisku Databricks Runtime 6.0. Wcześniejsze wersje środowiska Databricks Runtime będą nadal obsługiwać język Python 2. Spodziewamy się wydania środowiska Databricks Runtime 6.0 w wersji nowszej w 2019 roku.
Przygotowanie wersji środowiska Databricks Runtime na bezczynnych instancjach puli
30 lipca — 6 sierpnia 2019 r.: Wersja 2.103
Teraz możesz przyspieszyć uruchamianie klastra opartego na puli, poprzez wybranie wersji środowiska Databricks Runtime, która będzie załadowana na bezczynnych instancjach w puli. Pole w interfejsie użytkownika puli jest nazywane wstępnie załadowaną wersją platformy Spark.

Niestandardowe tagi klastrów i tagi pul lepiej ze sobą współpracują.
30 lipca — 6 sierpnia 2019 r.: Wersja 2.103
Wcześniej w tym miesiącu usługa Azure Databricks wprowadziła pule, zbiór bezdziałających wystąpień, które ułatwiają szybkie uruchamianie klastrów. W oryginalnej wersji klastry obsługiwane przez pule dziedziczyły domyślne i niestandardowe tagi z konfiguracji puli, a użytkownicy nie mogli modyfikować tych tagów na poziomie klastra. Teraz możesz skonfigurować niestandardowe tagi specyficzne dla klastra z obsługą puli; wszystkie niestandardowe tagi zostaną zaaplikowane, niezależnie od tego, czy są dziedziczone z puli, czy przypisane do konkretnego klastra. Nie można dodać tagu niestandardowego specyficznego dla klastra o tej samej nazwie klucza co tag niestandardowy dziedziczony z puli (czyli nie można zastąpić tagu niestandardowego dziedziczonego z puli). Aby uzyskać szczegółowe informacje, zobacz Tagi puli.
Platforma MLflow 1.1 oferuje kilka ulepszeń interfejsu użytkownika i interfejsu API
30 lipca — 6 sierpnia 2019 r.: Wersja 2.103
MLflow 1.1 wprowadza kilka nowych funkcji w celu zwiększenia użyteczności interfejsu użytkownika i interfejsu API:
Interfejs użytkownika przeglądu przebiegów umożliwia teraz przeglądanie wielu stron przebiegów, jeśli liczba przebiegów przekracza 100. Po wykonaniu 100. przebiegu kliknij przycisk Załaduj więcej, aby załadować następne 100 przebiegów.

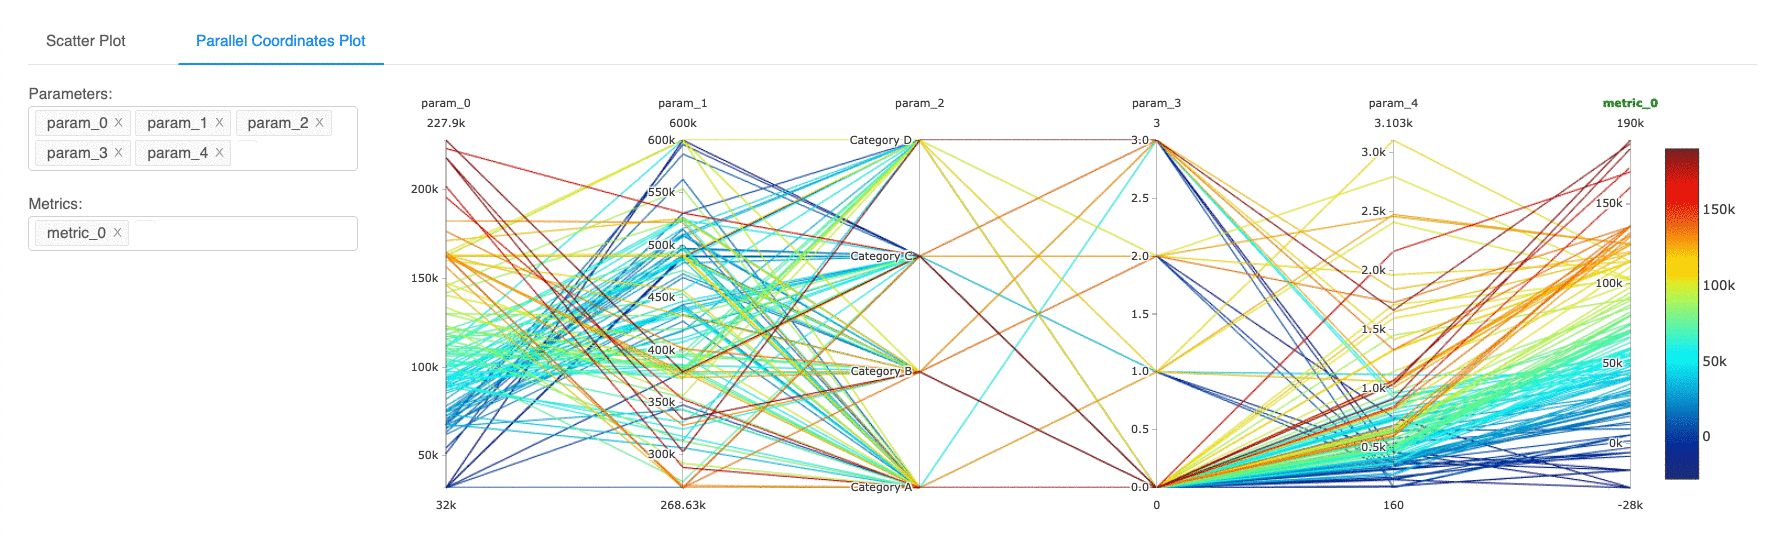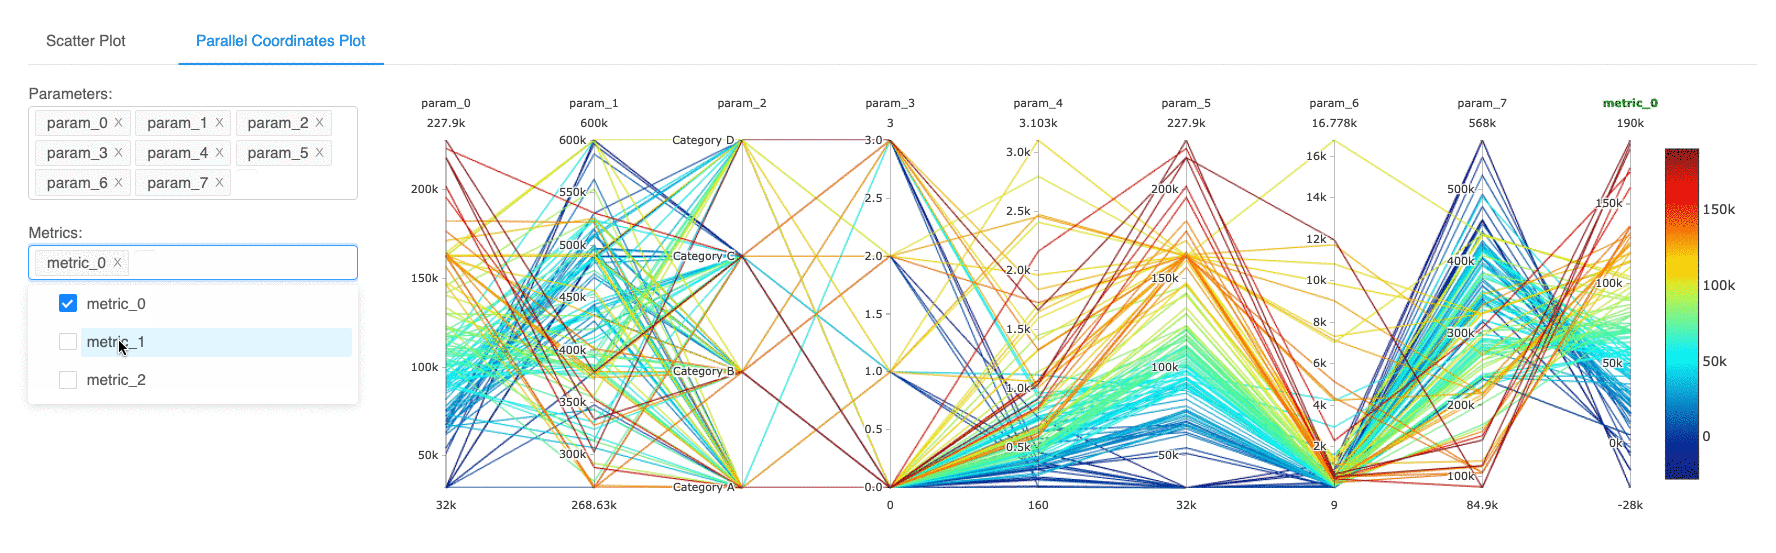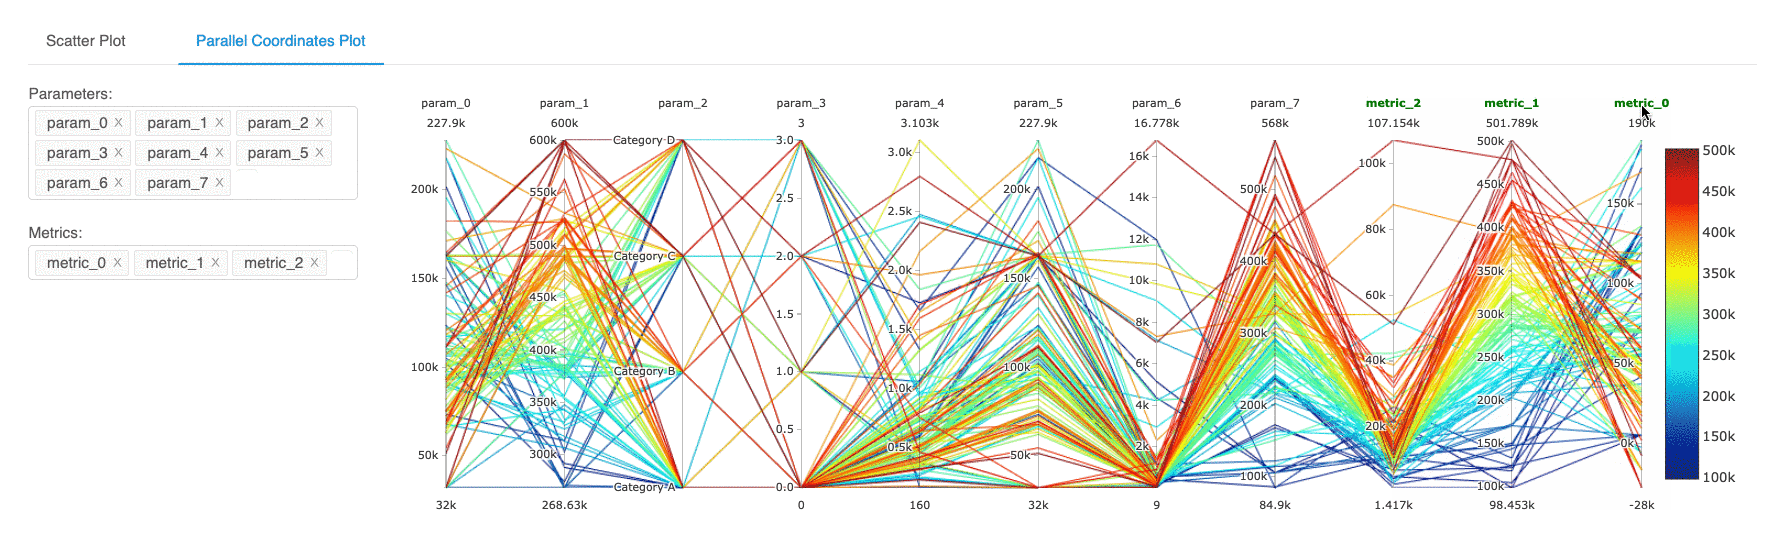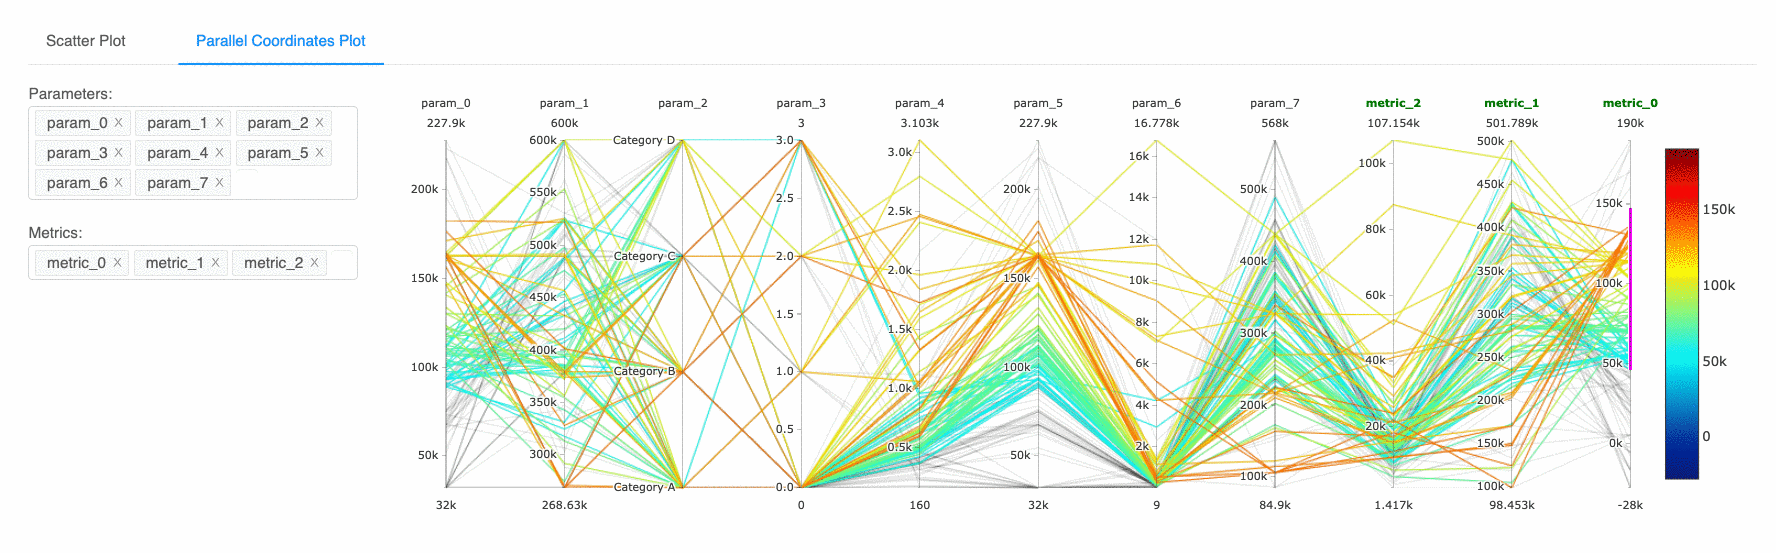
UI porównań przebiegów teraz udostępnia wykres współrzędnych równoległych. Wykres umożliwia obserwowanie relacji między nwymiarowym zestawem parametrów i metryk. Wizualizuje wszystkie przebiegi jako linie, które są oznaczone kolorem na podstawie wartości metryki (na przykład dokładności) i pokazuje wartości parametrów, na których uruchomiono każde uruchomienie.
Teraz możesz dodawać i edytować tagi z poziomu interfejsu użytkownika przeglądu przebiegu i wyświetlać tagi w widoku wyszukiwania eksperymentów.
Nowy interfejs API MLflowContext umożliwia tworzenie i rejestrowanie przebiegów w sposób podobny do interfejsu API języka Python. Ten interfejs API kontrastuje z istniejącym interfejsem API niskiego poziomu
MlflowClient, który po prostu opakowuje interfejsy API REST.Teraz można usuwać tagi z przebiegów MLflow przy użyciu API DeleteTag.
Aby uzyskać szczegółowe informacje, zobacz wpis w blogu MLflow 1.1. Aby uzyskać pełną listę funkcji i poprawek, zobacz changelog MLflow.
Ramka danych biblioteki Pandas jest renderowana tak jak w środowisku Jupyter
30 lipca — 6 sierpnia 2019 r.: Wersja 2.103
Teraz, gdy wywołasz ramkę danych biblioteki pandas, będzie ona renderowana tak samo jak w programie Jupyter.

Nowe regiony
30 lipca 2019 r.
Usługa Azure Databricks jest teraz dostępna w następujących dodatkowych regionach:
- Korea Środkowa
- Północna Republika Południowej Afryki
Zaktualizowano limit połączeń magazynu metadanych
16 lipca – 23, 2019: Wersja 2.102
Nowe obszary robocze usługi Azure Databricks w regionie eastus, eastus2, centralus, westus2, westeurope, northeurope będą miały wyższy limit połączenia magazynu metadanych o wartości 250. Istniejące obszary robocze będą nadal używać obecnego magazynu metadanych bez zakłóceń i będą nadal miały limit 100 połączeń.
Ustawianie uprawnień w pulach (publiczna wersja zapoznawcza)
16 lipca – 23, 2019: Wersja 2.102
Interfejs użytkownika puli obsługuje teraz ustawianie uprawnień do tego, kto może zarządzać pulami i kto może dołączać klastry do pul.
Aby uzyskać szczegółowe informacje, zobacz Uprawnienia puli zadań.
Databricks Runtime 5.5 na potrzeby uczenia maszynowego
15 lipca 2019 r.
Środowisko Databricks Runtime 5.5 ML jest oparte na środowisku Databricks Runtime 5.5 LTS. Zawiera wiele popularnych bibliotek uczenia maszynowego, w tym TensorFlow, PyTorch, Keras i XGBoost oraz zapewnia rozproszone trenowanie TensorFlow przy użyciu frameworku Horovod.
Ta wersja zawiera następujące nowe funkcje i ulepszenia:
- Dodano pakiet języka Python MLflow 1.0
- Uaktualnione biblioteki uczenia maszynowego
- TensorFlow uaktualniono z wersji 1.12.0 do 1.13.1
- Program PyTorch został uaktualniony z wersji 0.4.1 do wersji 1.1.0
- Program scikit-learn został uaktualniony z wersji 0.19.1 do wersji 0.20.3
- Operacja z jednym węzłem w HorovodRunner
Środowisko uruchomieniowe Databricks 5.5
15 lipca 2019 r.
Środowisko Databricks Runtime 5.5 jest teraz dostępne. Środowisko Databricks Runtime 5.5 obejmuje platformę Apache Spark 2.4.3, uaktualnione biblioteki Python, R, Java i Scala oraz następujące nowe funkcje:
- Usługa Delta Lake w usłudze Azure Databricks Auto Optimize (Ogólna Dostępność)
- Usługa Delta Lake w usłudze Azure Databricks poprawiła wydajność zapytań agregacji minimum, maksimum i liczby
- Szybsze potoki przetwarzania wnioskowania modelu dzięki ulepszonemu źródłu danych plików binarnych i funkcji UDF z iteratorem skalarnym biblioteki pandas (wersja zapoznawcza publiczna)
- Interfejs API dla danych poufnych w notatnikach R
Utrzymywanie rezerwowej puli wystąpień do szybkiego uruchamiania klastrów (wersja zapoznawcza)
9 lipca 2019 r. — 11 lipca 2019 r.: Wersja 2.101
Aby skrócić czas uruchamiania klastra, usługa Azure Databricks obsługuje teraz dołączanie klastra do wstępnie zdefiniowanej puli bezczynnych wystąpień. Po dołączeniu do puli klaster przydziela swoje węzły sterujące i robocze z puli. Jeśli pula nie ma wystarczających zasobów bezczynnych, aby obsłużyć żądanie klastra, pula rozszerza się, przydzielając nowe instancje od dostawcy chmury. Po zakończeniu działania dołączonego klastra używane wystąpienia są zwracane do puli i mogą być ponownie używane przez inny klaster.
Usługa Azure Databricks nie nalicza opłaty za DBUs, gdy wystąpienia w puli pozostają bezczynne. Rozliczenia dostawcy wystąpień mają zastosowanie. Zobacz cennik.
Aby uzyskać szczegółowe informacje, zobacz Dokumentacja konfiguracji puli.
Wskaźniki Ganglia
9 lipca 2019 r. — 11 lipca 2019 r.: Wersja 2.101
Ganglia to skalowalny rozproszony system monitorowania, który jest teraz dostępny w klastrach usługi Azure Databricks. Metryki Ganglia ułatwiają monitorowanie wydajności i kondycji klastra. Metryki Ganglia można uzyskać na stronie szczegółów klastra:

Aby uzyskać szczegółowe informacje na temat używania i konfigurowania metryk, zobacz Ganglia metrics.
Kolor serii globalnej
9 lipca 2019 r. — 11 lipca 2019 r.: Wersja 2.101
Teraz możesz określić, że kolory serii powinny być spójne we wszystkich wykresach w notesie. Zobacz Spójność kolorów na wykresach.
