Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Important
Trenowanie interakcyjne wymaga jawnego zatwierdzenia dostępu. Zażądaj dostępu za pośrednictwem formularza rejestracji w wersji zapoznawczej i poczekaj na zatwierdzenie przed utworzeniem sesji szkoleniowej.
Użyj tego ściągawka, aby zamapować pętlę trenowania na funkcje i parametry zestawu SDK Python w usłudze Microsoft Foundry. Przykłady koncentrują się na synchronicznym FineTuningSession interfejsie API wygody. Klienci asynchroniczne i otoki podręczników używają różnych interfejsów i wzorców uzupełniania.
Prerequisites
- Ukończ instalację, uwierzytelnianie i konfigurację dostępu.
- Użyj programu
azure-ai-finetuningsessions==1.0.0b1, publicznej wersji zapoznawczej zainstalowanej przez podręcznik. - Rola Użytkownika usługi Foundry na potrzeby trenowania lub roli Właściciel rozwiązania Foundry , jeśli wdrożysz również dostosowany model. Zobacz Kontrola dostępu oparta na rolach, aby uzyskać Microsoft Foundry.
- Wybierz kwalifikujący się model i obsługiwaną konfigurację adaptera. Przygotuj tokeny przy użyciu zgodnego tokenizatora i szablonu czatu.
- Ustaw
AZURE_AI_PROJECT_ENDPOINTi potwierdź zatwierdzony budżet szkoleniowy. Tworzenie sesji i uruchamianie operacji trenowania lub próbkowania może spowodować naliczanie opłat.
Metody trenowania, próbkowania i wygody punktu kontrolnego oczekują na wyniki operacji. Operacje pierwotne i pomocniki asynchroniczne mają różne typy zwracanych i zachowanie uzupełniania; użyj pełnej dokumentacji zestawu SDK dla tych interfejsów.
W przykładach użyto synchronicznego zestawu SDK, chyba że oznaczono inaczej. Przygotuj funkcje pomocnika raz, a następnie uruchom operacje wewnątrz with open_session() as session:elementu . Użyj rzeczywistych danych tokenizowanych; fragmenty kodu nie dostarczają zestawu danych ani nie implementują kompletnego algorytmu trenowania.
Nadzorowane dostrajanie
Nadzorowane dostrajanie (SFT) trenuje w monitach i żądanych odpowiedziach.
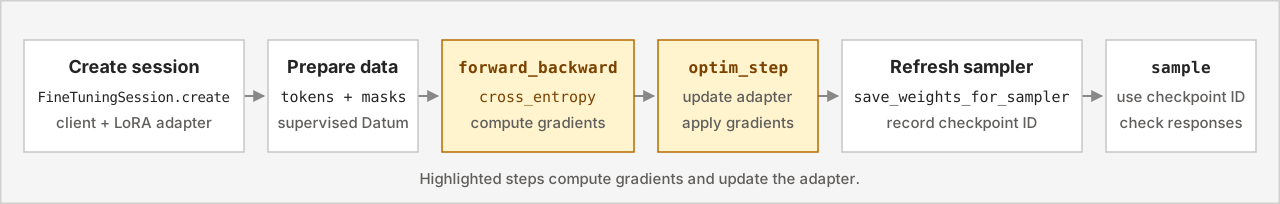
Sekwencja umożliwia przygotowanie > nadzorowanych danych > do przodu/kroku optymalizatora > wstecznego > oceny > punktu kontrolnego. Próbkowanie nie jest wymagane dla każdej nadzorowanych partii.
Uczenie przez wzmacnianie
Uczenie wzmacniania (RL) trenuje na podstawie ocenianych odpowiedzi modelu.

Sekwencja to tworzenie > próbkatora > odświeżania zbiera nagrody obliczeniowe > i zalety > kroku optymalizatora do przodu/do tyłu>. Powtórz odświeżanie z próbkatora, aby zebrać odpowiedzi ze zaktualizowanych zasad.
Grupowanie, klasyfikacja i obliczenia przewagi należą do sterownika, a nie do automatycznego algorytmu trenowania zestawu SDK. Aby zapoznać się z kompletnymi przykładami trenowania, zapoznaj się z repozytorium przykładów dostrajania.
Tworzenie sesji
FineTuningSessionClient nawiązuje połączenie z projektem przy użyciu elementu endpoint i credential.
FineTuningSession.create Inicjuje model i kartę i uruchamia puls sesji.
Ten pomocnik uwierzytelnia się za pomocą DefaultAzureCredentialpolecenia , tworzy sesję i zwalnia ją po zakończeniu kontekstu. Użyj zatwierdzonego modelu i rangi LoRA. Jawny zakres poświadczeń dotyczy uwierzytelniania Microsoft Entra.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Dokumentacja: FineTuningSession.create, FineTuningSessionClient i DefaultAzureCredential.
Po zakończeniu ładowania modelu należy oczekiwać identyfikatora sesji. Zachowaj otwartą sesję dla poniższych operacji; zamknięcie kontekstu zatrzymuje puls i przesyła żądanie zwolnienia.
| Parametr | Meaning |
|---|---|
base_model |
Dokładny obsługiwany identyfikator modelu trenowania. |
lora_config |
Jawnie LoRAConfig z obsługiwanym rankelementem . |
type |
Typ sesji; użyj polecenia training. Próbkowanie odbywa się za pośrednictwem sesji szkoleniowej, a nie oddzielnego typu sesji wnioskowania. |
timeout_sec |
Maksymalny czas oczekiwania na ładowanie modelu. Limit czasu nie potwierdza zdalnego czyszczenia. |
from_checkpoint |
Opcjonalnie FromCheckpoint ze źródłem source_session_id i checkpoint_id. Użyj zgodnego zapisanego stanu trenowania. |
user_metadata |
Opcjonalny słownik metadanych przebiegu do skojarzenia z sesją. |
training_type |
Opcjonalny selektor warstwy; znane wartości to GlobalStandard, DatazoneStandardi DeveloperTier. Uprawnienia nadal zależą od modelu i projektu. |
Rejestruj session.session_id , gdy używasz zestawu SDK bezpośrednio. Aby uruchomić kompleksową receptę szkoleniową, zobacz Wprowadzenie.
Przygotowywanie danych nadzorowanych
Datum grupy model_input i loss_fn_inputs na jeden przykład.
| Typ lub pole | Meaning |
|---|---|
ModelInput |
Uporządkowano fragmenty danych wejściowych modelu. |
ModelInputChunk.tokens |
Identyfikatory tokenów tekstowych z tokenizatora modelu. |
LossFnInputs.target_tokens |
Miejsca docelowe następnego tokenu są wyrównane do pozycji wejściowych. |
LossFnInputs.weights |
Jawne wagi na token; zero wyklucza cel z trenowania między entropiami. |
TensorData.data |
Liczba całkowita jest przeznaczona dla obiektów docelowych lub sygnałów uczenia zmiennoprzecinkowego. |
Przenieś dane wejściowe i docelowe według jednego tokenu i wyrównaj wagi do elementów docelowych. Trenowanie na zamierzonych tokenach asystenta, a nie monity ani obserwacje. Zobacz Funkcje straty i wagi tokenów.
Przekaż tokeny monitu i ukończenia z tego samego modułu renderowania czatu specyficznego dla modelu do tego pomocnika. Tworzy pojedynczy przykład SFT i maskuje elementy docelowe monitów.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Dokumentacja: Datum, LossFnInputs i ModelInput.
Utwórz batch jako listę tych Datum wartości. Tablice danych wejściowych, docelowych i wagowych mają taką samą długość. W przypadku danych wieloetrowych zachowaj maski modułu renderowania zamiast traktować każdy token po pierwszym wyświetleniu monitu jako token asystenta.
Przygotowywanie danych listy RL
W przypadku listy RL użyj przykładowych odpowiedzi i sygnałów uczenia opartego na nagrodach:
| Pole | Meaning |
|---|---|
SampledSequence.tokens |
Wygenerowane identyfikatory tokenów. |
SampledSequence.logprobs |
Prawdopodobieństwo dziennika tokenów z zasad, które wygenerowały odpowiedź, po podaniu. |
LossFnInputs.logprobs |
Prawdopodobieństwa dzienników wprowadzania dostosowane do celów szkoleniowych. |
LossFnInputs.advantages |
Zalety poszczególnych tokenów; zero wyklucza pozycje monitu i obserwacji z sygnału RL. |
Zachowaj wyrównanie między elementami docelowymi, prawdopodobieństwo dziennika i zalety. Nie zamieniaj prawdopodobieństwa wdrożenia na te z nowo zaktualizowanego modelu.
LossFnInputs konstruktor Python również wymaga jawnego weights; Maskowanie listy RL wykorzystuje zalety.
W przypadku wdrożenia jednokrotnego przekaż próbkę sequence i obliczoną advantage przez sterownik. Ten pomocnik stawia zerowe korzyści i prawdopodobieństwo rejestrowania w pozycjach monitu docelowego.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Dokumentacja: SampledSequence i LossFnInputs.
W przypadku wywołań narzędzi lub wprowadzania w wielu etapach użyj modułu renderującego przepis, aby odróżnić przykładowe tokeny akcji od obserwacji środowiska.
Gradienty obliczeniowe
session.forward_backward(batch, loss_fn=...) oblicza cel i gromadzi gradienty. Nie aktualizuje wag adapterów.
batch zawiera Datum wartości.
loss_fnwybiera cross_entropy, , importance_sampling, ppocispo, lub sapo. Opcjonalnie loss_fn_config używa modelu zestawu SDK LossFnConfig ; nie wywnioskuj akceptowanych kluczy konfiguracji z papieru algorytmu.
Ukończ obliczenia gradientu przed aktualizacją optymalizatora. Zachowaj spójność utraty podczas gromadzenia kilku wywołań.
W przypadku dynamicznego session i niewymkrotnego protokołu SFT batchmożna obliczyć gradienty i sprawdzić dane wyjściowe na przykład:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Dokumentacja: FineTuningSession.forward_backward i LossFn.
W przypadku przygotowanej partii listy RL użyj LossFn.IMPORTANCE_SAMPLING lub innej obsługiwanej utraty zasad.
LossFn Elementy członkowskie wyliczenia i ich wartości ciągów wybierają tę samą utratę.
Stosowanie kroku optymalizatora
session.optim_step(adam_params) stosuje skumulowane gradienty.
AdamParams Python wymaga wszystkich pięciu pól:
| Pole | Meaning |
|---|---|
learning_rate |
Rozmiar aktualizacji optymalizatora. |
beta1 |
Współczynnik rozkładu pierwszego momentu. |
beta2 |
Współczynnik rozpadu sekundy. |
eps |
Termin stabilności liczbowej. |
weight_decay |
Ustawienie rozkładu wagi. |
Wybierz wartości dla eksperymentu, a nie przy założeniu uniwersalnych wartości domyślnych.
Ten pomocnik dostarcza każde wymagane pole i czeka na aktualizację. Wartości są przykładowymi ustawieniami, a nie zaleceniami niezależnymi od modelu.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Dokumentacja: FineTuningSession.optim_step i AdamParams.
Przekompiluj learning_rate ponownie, gdy sterownik używa harmonogramu. Nie zakładaj, że jedna konfiguracja optymalizatora ma zastosowanie w całym przebiegu.
Przykładowy tekst
session.save_weights_for_sampler(seq_id, ...) przygotowuje wagi i zwraca identyfikator punktu kontrolnego próbkatora. Odśwież wagi próbkatora po aktualizacji przed wygenerowaniem ze zaktualizowanej karty.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) generuje odpowiedzi na podstawie wybranych wag próbkatora.
| Parametr lub wynik | Meaning |
|---|---|
prompt_tokens |
Monit z tokenem lub obsługiwany ModelInput. |
checkpoint_id |
Ukończono identyfikator punktu kontrolnego przykładu dla tej sesji, a nie ścieżki punktu kontrolnego ani nazwy wdrożenia. |
num_samples |
Liczba odpowiedzi dla monitu. |
SamplingParams.max_tokens |
Budżet tokenu ukończenia. |
temperature, top_p, top_k |
Ustawienia dystrybucji próbkowania. |
stop_criteria |
Lista ciągów zatrzymania lub lista identyfikatorów tokenów, a nie obu. |
response_format |
Opcjonalne żądanie w formacie odpowiedzi; pomoc techniczna zależy od modelu i dostawcy próbkowania. |
result.sequences |
SampledSequence Wygenerowane wartości. |
SamplingParams Python wymaga max_tokens, temperature, top_pi top_k. Ustaw to samo seq_id dla odświeżania i próbkowania próbkowania próbek. Podaj wagę path próbkatora lub sampling_session_seq_id podczas zapisywania wag próbek.
Po jednej aktualizacji optymalizatora odśwież próbkator i wygeneruj odpowiedź. Użyj tokenizowanego prompt_tokens i zgodnego tokenizer modelu ze sterownika.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Dokumentacja: FineTuningSession.save_weights_for_sampler, FineTuningSession.sample i SamplingParams.
Wynik zawiera jedną sekwencję próbek. Zwiększ identyfikator kroku wraz z aktualizacjami i odświeżaj wagi próbek przed próbkowaniem zaktualizowanych zasad.
Przygotowywanie wag próbek nie jest takie samo jak zapisywanie wznawianego stanu trenowania.
Utrwalanie lub odświeżanie wag próbek
Metoda synchroniczna używa sampling_session_seq_id metody do odróżnienia odświeżania w pamięci od utrwalonego punktu kontrolnego próbkatora.
| Purpose | Wywołanie synchroniczne |
|---|---|
| Odświeżanie wag próbek bez trwałości | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Utrwalanie punktu kontrolnego próbkatora |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), bez sampling_session_seq_id. |
Oba wywołania zwracają identyfikator punktu kontrolnego próbkatora. Zachowaj go przy użyciu własnego identyfikatora sesji. Trwałe zapisywanie przykładów nie ustanawia trwałego przechowywania ani nie nadaje punktu kontrolnego do użytku w innej sesji.
Uruchamianie przekazywania tylko do przodu
session.forward(batch, loss_fn=...) zwraca dane wyjściowe funkcji utraty bez gromadzenia gradientów. Służy do inspekcji przygotowanej partii lub obliczania metryk oceny.
Jego wynik nie wypełnia tylko total_losstrenowania . Sprawdź loss_fn_outputs; nie traktuj brakującej agregacji jako zerowej utraty.
Po utworzeniu danych na żywo session i przygotowaniu batchsprawdź dane wyjściowe dla poszczególnych przykładów bez zmiany skumulowanych gradientów:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Odwołanie: FineTuningSession.forward.
Zapisywanie i wznawianie trenowania
session.save_weights(path) Oszczędza wagi adaptera i stan optymalizatora. Zarejestruj odwołanie do punktu kontrolnego przy użyciu jego sesji źródłowej i stanu sterownika.
Po zakończeniu aktualizacji zapisz stan trenowania i zapisz jego odwołanie do sesji źródłowej/punktu kontrolnego:
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Dokumentacja: FineTuningSession.save_weights.
Metoda zwraca tylko po zakończeniu zapisywania. Przed zamknięciem sesji przechowaj checkpoint_path pozycję zestawu danych i inny stan sterownika.
FineTuningSession.create_from_checkpoint przywraca stan trenowania w nowej sesji:
| Parametr | Meaning |
|---|---|
checkpoint_path |
Zapisano odwołanie do punktu kontrolnego trenowania w <source-session-id>/<checkpoint-name> formularzu. |
base_model |
Model podstawowy zgodny z oryginalnym punktem kontrolnym. |
lora_config |
Zgodna konfiguracja adaptera z jawną rangą. |
Punkt kontrolny próbkatora nie jest punktem kontrolnym trenowania pełnego stanu. Przywróć położenie zestawu danych i planowanie oddzielnie w sterowniku. Zobacz Punkty kontrolne.
Ten pomocnik przywraca zapisany stan trenowania za pomocą uwierzytelnionego clientelementu . Przekaż zarejestrowane szkolenie checkpoint_pathi zachowaj zgodność modelu podstawowego i klasy LoRA z sesją źródłową.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Dokumentacja: FineTuningSession.create_from_checkpoint.
Zwrócona sesja ma nowy identyfikator sesji i uruchamia własny puls. Zamknij wznowionej sesji, gdy jej pętla zakończy działanie, tak samo jak podczas zamykania nowo utworzonej sesji.
Używanie operacji asynchronicznych
Asynchroniczne otoki zestawu SDK i książki kucharskiej nie są wymienne. Zaimportuj klienta asynchronicznego z azure.ai.finetuningsessions.aioprogramu ; typy modeli nadal pochodzą z azure.ai.finetuningsessions.modelsklasy .
| Interface | Wzorzec ukończenia |
|---|---|
Synchroniczny FineTuningSession |
Metoda zwraca ukończony wynik operacji. |
Nieprzetworzone metody wygody zestawu SDK asynchronicznego, takie jak save_weights_for_sampler_async |
Poczekaj na przesłanie, a następnie poczekaj na powrót asyncio.Task do ukończenia. |
Metody otoki szkoleniowej książki kucharskiej, takie jak save_state_async |
Poczekaj na przesłanie, a następnie poczekaj na przyszłość result_async(). |
W przypadku sesji na żywo należącej do asynchronicznego clientpomocnik utrwala wagi próbek i zwraca ukończony identyfikator punktu kontrolnego:
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Dokumentacja: FineTuningSessionClient.save_weights_for_sampler_async asynchroniczne.
Zamiast tego należy używać save_weights_and_get_sampling_client_async do odświeżania efemerycznego próbkatora. Na nieprzetworzonym kliencie zestawu SDK ta metoda nadal zwraca zadanie z wynikiem operacji, a nie klientem próbkowania podręcznika.
Przed zwolnieniem sesji poczekaj na wymagane zapisy. Argument zgodności książki kucharskiej ttl_seconds nie jest przekazywany do tych zapisów zestawu SDK; nie traktuj go jako wymuszonego ustawienia przechowywania.
W przypadku celów niestandardowych książka forward_backward_custom_async kucharka komponuje dane wyjściowe usługi z różnymi obliczeniami strat po stronie klienta. Nie jest to metoda w metodzie FineTuningSession, a parametr zestawu SDK loss_fn nie akceptuje dowolnych Python wywoływanych.
Zamykanie zasobów
session.close() zatrzymuje puls i przesyła żądanie zwolnienia. Wywołaj ją, gdy pętla kończy się, w tym w przypadku awarii; następnie zamknij klienta HTTP i poświadczenia.
Zamknięcie nie potwierdza ukończenia oczyszczania zdalnego ani usuwania punktów kontrolnych.
session.delete() może kaskadowo zapisywać zasoby. Zobacz Inspekcja i zwalnianie sesji.
open_session Użyj menedżera kontekstu, aby uruchomić pojedynczą aktualizację SFT i zapisać stan trenowania. Zdefiniuj open_session i apply_optimizer_step z wcześniejszych przykładów i przekaż nieistnienie renderowany protokół SFT batch.
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Odwołanie: FineTuningSession.close i FineTuningSession.save_weights.
Pomocnik zwraca odwołanie do punktu kontrolnego trenowania. Jego kontekst przesyła żądanie zwolnienia, nawet jeśli operacja trenowania zgłasza wyjątek, a następnie zamyka klienta i poświadczenia.
Referencja SDK
Użyj pełnej dokumentacji dla przykładów wykonywalnych, sygnatur metod, asynchronicznych interfejsów API, typów wyników i błędów: