Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
W tym artykule wyjaśniono, jak przeprowadzić uaktualnienie środowiska uruchomieniowego dla klastra Operator Nexus.
Wymagania wstępne
- Zainstaluj najnowszą wersję odpowiednich rozszerzeń CLI.
- Subskrypcja dostępu do uruchamiania poleceń rozszerzenia interfejsu wiersza polecenia sieci szkieletowej Azure Operator Nexus (NF) oraz chmury sieciowej (NC).
- Zbierz następujące informacje:
- Identyfikator subskrypcji (
SUBSCRIPTION) - Nazwa klastra (
CLUSTER) - Grupa zasobów (
CLUSTER_RG)
- Identyfikator subskrypcji (
- Stan szczegółowy klastra musi mieć wartość
Running. - Łączność z menedżerem Cluster-to-Cluster musi wynosić
Connected. - Azure wymagania wstępne (obszar roboczy usługi Log Analytics, konto Storage, Key Vault) muszą zostać zweryfikowane. Te zasoby są sprawdzane przed rozpoczęciem uaktualniania. Zobacz Tożsamość zarządzana klastra i zasoby udostępnione przez użytkownika.
- Serwery obliczeniowe klastra obciążenia >>
- Wymagania dotyczące kondycji węzła płaszczyzny sterowania przed uaktualnieniem są następujące:
- Jeśli nie istnieje zapasowy węzeł płaszczyzny sterowania, wszystkie węzły płaszczyzny sterowania muszą być w dobrym stanie: stan zasilania
On, status odizolowaniaUncordoned, stan gotowościYesi stan degradacjiNo. - Jeśli istnieje zapasowy węzeł płaszczyzny sterowania, tylko ten zapasowy węzeł może być w stanie zasilania
Off, w stanie gotowościNoi w stanie obniżonej sprawnościNo. Każdy inny węzeł płaszczyzny sterowania musi być sprawny: stan zasilaniaOn, status CordonUncordoned, stan gotowościYesi stan degradacjiNo.
Uwaga / Notatka
Jeśli zapasowa maszyna płaszczyzny sterowania została wcześniej poddana aprowizacji, powinna mieć status Cordon
Cordoned. Jeśli tak nie jest, powinien mieć stanUncordonedCordon . - Jeśli nie istnieje zapasowy węzeł płaszczyzny sterowania, wszystkie węzły płaszczyzny sterowania muszą być w dobrym stanie: stan zasilania
- Serwery płaszczyzny zarządzania są podzielone na dwie grupy umieszczone na regałach o nieparzystych i parzystych numerach. W każdej grupie ponad 50% serwerów musi być sprawnych: stan zasilania
On, stan odizolowaniaUncordoned, stan gotowościYesi stan degradacjiNo.- W obu grupach płaszczyzn zarządzania co najmniej 75% maszyn zarządzania musi być w dobrej kondycji.
- Liczby serwerów płaszczyzny obliczeniowej różnią się w zależności od poszczególnych ustawień progu środowiska uruchomieniowego klastra. Klienci muszą określić minimalną liczbę na podstawie ustawień, szukając stanu
Onzasilania, stanuUncordonedcordonu, stanuYesgotowości oraz stanuNoobniżonej wydajności.
- Wymagania dotyczące kondycji węzła płaszczyzny sterowania przed uaktualnieniem są następujące:
- W obszarze Grupa zasobów zarządzanych przez klaster > wybierz nazwę grupy, aby przejść do strony grupy zasobów.
- W grupie zasobów wyszukaj
Kubernetes - Azure Arc, aby zidentyfikować informacje o Azure Arc i wybrać je. Stan powinien mieć wartośćConnected.- Na stronie Azure Arc wybierz pozycję Ustawienia: > Rozszerzenia.
-
nc-platform-extensionpowinien mieć stanSucceeded. -
nc-platform-runtime-extensionpowinien mieć stanSucceeded.
-
- Na stronie Azure Arc wybierz pozycję Ustawienia: > Rozszerzenia.
- W grupie zasobów wyszukaj
Uwaga / Notatka
Te same testy należy również wykonać po uaktualnieniu, aby upewnić się, że klaster jest w dobrej kondycji.
Sprawdzanie bieżącej wersji środowiska uruchomieniowego
Przed uaktualnieniem sprawdź bieżącą wersję środowiska uruchomieniowego klastra: zobacz Jak sprawdzić bieżącą wersję środowiska uruchomieniowego klastra.
Znajdowanie dostępnych wersji środowiska uruchomieniowego
Za pośrednictwem witryny Azure Portal
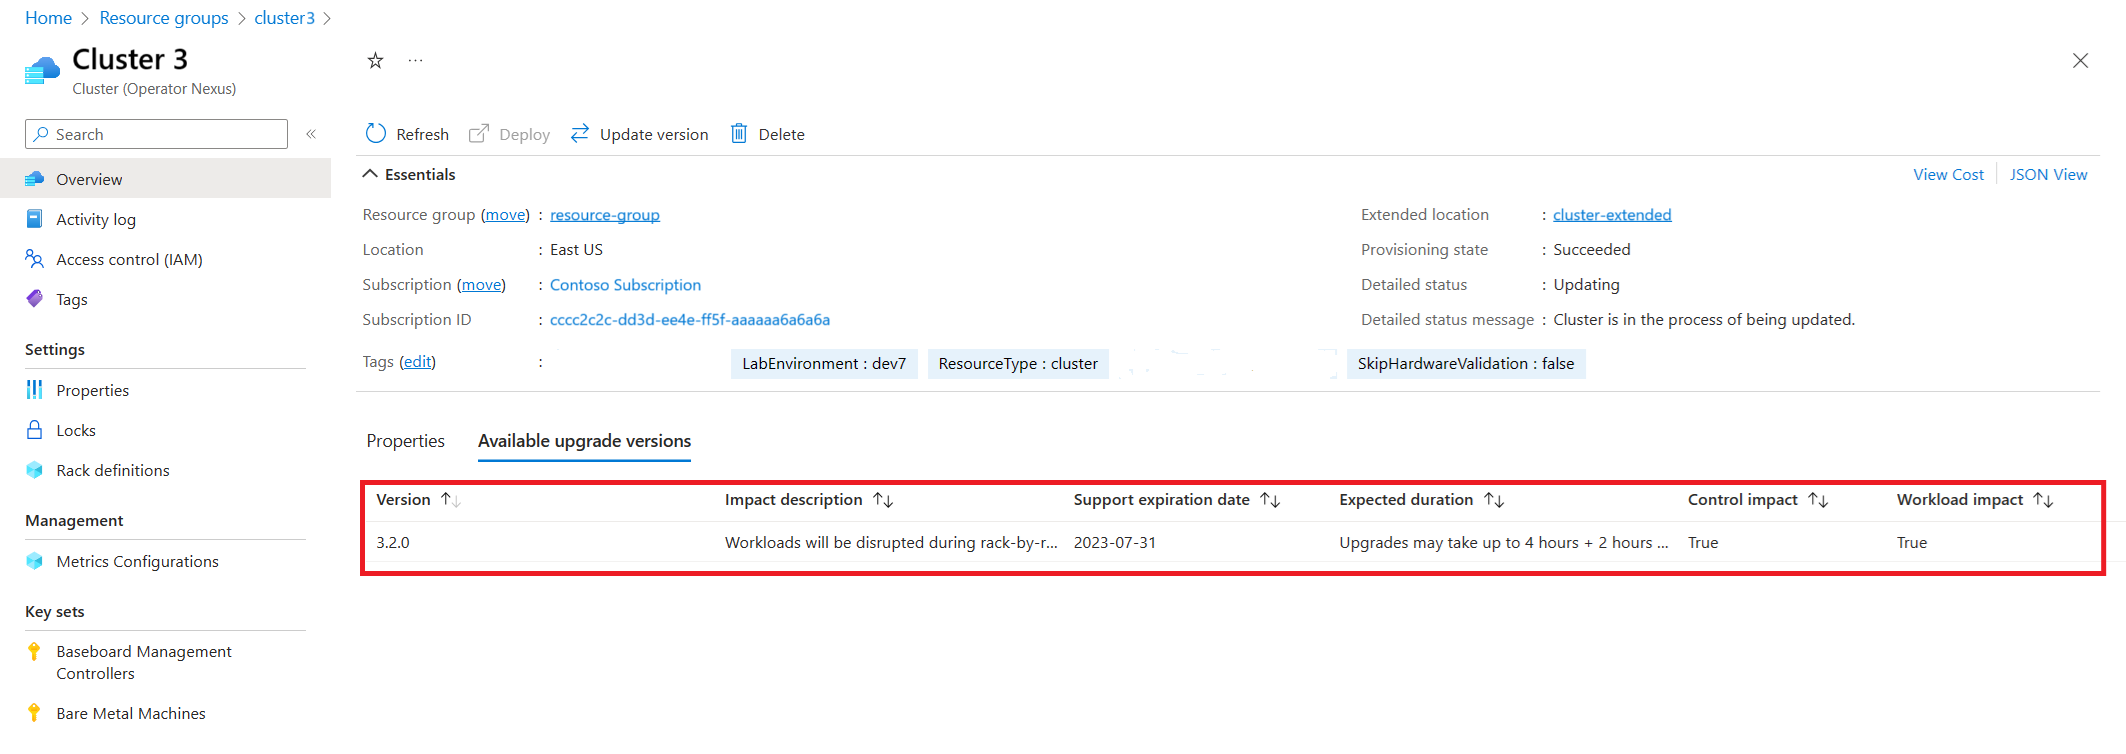
Aby znaleźć dostępne wersje środowiska uruchomieniowego z możliwością uaktualnienia, przejdź do docelowego klastra w Azure portal. W okienku Przegląd klastra przejdź do karty Dostępne wersje uaktualnienia .

Na karcie Dostępne wersje uaktualnienia można zobaczyć różne wersje klastra dostępne do uaktualnienia. Wybierz docelową wersję środowiska uruchomieniowego z listy, a następnie kontynuuj uaktualnianie klastra.
Za pośrednictwem Azure CLI
Dostępne uaktualnienia można pobierać za pośrednictwem Azure CLI:
az networkcloud cluster show --name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--subscription "<SUBSCRIPTION>" | grep -A8 availableUpgradeVersions
W danych wyjściowych możesz znaleźć availableUpgradeVersions właściwość i spojrzeć na targetClusterVersion pole:
  "availableUpgradeVersions": [
    {
      "controlImpact": "True",
      "expectedDuration": "Upgrades may take up to 4 hours + 2 hours per rack",
      "impactDescription": "Workloads will be disrupted during rack-by-rack upgrade",
      "supportExpiryDate": "2023-07-31",
      "targetClusterVersion": "3.3.0",
      "workloadImpact": "True"
    }
  ],
Jeśli nie ma dostępnych uaktualnień klastra, lista jest pusta.
Skonfiguruj parametry progu obliczeniowego w celu uaktualnienia środowiska uruchomieniowego przy użyciu klastra updateStrategy
Następujące polecenie Azure CLI służy do konfigurowania parametrów progu obliczeniowego dla uaktualnienia środowiska uruchomieniowego:
az networkcloud cluster update \
--name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--subscription "<SUBSCRIPTION>" \
--update-strategy strategy-type="<strategyType>" threshold-type="<thresholdType>" \
threshold-value="<thresholdValue>" max-unavailable="<maxNodesOffline>" \
wait-time-minutes="<waitTimeBetweenRacks>"
Wymagane parametry:
- typ strategii: definiuje strategię aktualizacji. Używane ustawienia to
Rack(rack-by-rack) LUBPauseAfterRack(wstrzymywanie użytkownika przed rozpoczęciem każdego stojaka). Wartość domyślna toRack. Aby przeprowadzić uaktualnienie środowiska uruchomieniowego klastra przy użyciuPauseAfterRackstrategii, wykonaj kroki opisane w temacie Upgrade Cluster Runtime with PauseAfterRack Strategy (Uaktualnianie środowiska uruchomieniowego klastra za pomocą strategii PauseAfterRack). - typ progu: określa sposób obliczania progu w jednostkach zdefiniowanych przez strategię. Używane ustawienia to
PercentSuccessLUBCountSuccess. Wartość domyślna toPercentSuccess. - threshold-value: wartość progowa liczbowa używana do oceny aktualizacji. Wartość domyślna to
80.
Parametry opcjonalne:
- maksymalna niedostępność: maksymalna liczba węzłów roboczych, które mogą być w trybie offline, czyli szafa serwerowa uaktualniana jednocześnie. Wartość domyślna to
32767. - czas-oczekiwania-minuty: Opóźnienie lub okres oczekiwania przed aktualizacją stojaka. Wartość domyślna to
15.
Zachowanie uaktualniania na podstawie typu progu PercentSuccess
Poniższy przykład dotyczy klienta korzystającego ze strategii Rack-by-Rack z Procentem Sukcesu 60% i 1-minutową przerwą.
az networkcloud cluster update --name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--update-strategy strategy-type="Rack" threshold-type="PercentSuccess" \
threshold-value=60 wait-time-minutes=1 \
--subscription "<SUBSCRIPTION>"
Sprawdź aktualizację:
az networkcloud cluster show --name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--subscription "<SUBSCRIPTION>" | grep -A5 updateStrategy

  "updateStrategy": {
    "maxUnavailable": 32767,
      "strategyType": "Rack",
      "thresholdType": "PercentSuccess",
      "thresholdValue": 60,
      "waitTimeMinutes": 1
W tym przykładzie, gdy 60% maszyn w stojaku zostanie pomyślnie uaktualnionych, system uznaje próg za osiągnięty i przechodzi do uaktualnienia następnego stojaka, podczas gdy kontynuuje przygotowywanie pozostałych maszyn w bieżącym stojaku. Jeśli próg nie zostanie osiągnięty — to znaczy, że mniej niż 60% maszyn w szafie serwerowej zdołało przeprowadzić aktualizację, a pozostałe zakończyły ją niepowodzeniem — aktualizacja klastra zostanie wstrzymana. Po wstrzymaniu uaktualnienia system udostępnia szczegółowy komunikat o stanie w klastrze wyjaśniający przyczynę. W tym momencie problematyczne maszyny w stojaku muszą zostać naprawione, a aby wznowić i ukończyć uaktualnienie, należy wyzwolić operację kontynuacji aktualizacji klastra.
Aby wyświetlić stan uaktualnienia za pośrednictwem Azure portal, przejdź do docelowego zasobu klastra. Na ekranie Przegląd klastra wyświetlany jest szczegółowy stan wraz ze szczegółowym komunikatem o stanie.
Uaktualnianie klastra jest w toku, gdy parametr detailedStatus jest ustawiony na Updating, a szczegółowy status pokazuje postęp aktualizacji. Niektóre przykłady postępu uaktualniania pokazanego w szczegółowychStatusMessage to Waiting for control plane upgrade to complete..., Waiting for nodepool "<rack-id>" to finish upgrading..., i itp.
Uaktualnianie klastra zostało ukończone, gdy parametr detailedStatus jest ustawiony na Running , a element detailedStatusMessage wyświetla komunikat Cluster is up and running
Jeśli komunikat o szczegółowym stanie pokazuje, że uaktualnienie zostało wstrzymane, komunikat wygląda następująco: Cluster is deployed but the upgrade has been paused. Machines in rack "<rack-id>" are unhealthy. Fix the machines and perform cluster continue-update-version action to finish the upgrade

Aby wznowić uaktualnianie środowiska uruchomieniowego, wykonaj następujące polecenie az networkcloud cli.
az networkcloud cluster continue-update-version --cluster-name "<CLUSTER>" \
--resource-group="<CLUSTER_RG>" \
--subscription="<SUBSCRIPTION>" \
--safeguard-mode <SAFEGUARD_MODE>
Parametry opcjonalne:
-
--safeguard-mode: określa, jak zabezpieczenia są stosowane podczas operacji continue-update-version. UżyjAllpolecenia , aby uruchomić wszystkie testy sprawdzania poprawności przedoperacyjnej. Użyj poleceniaNone, aby pominąć zabezpieczenia blokujące uaktualnienie podczas wykrywania problemów. Wartość domyślna toAll.
Ważne
Domyślny tryb All ochrony blokuje wznowienie uaktualniania, jeśli walidacje określają, że nie można ukończyć uaktualnienia bez rozwiązywania wykrytych problemów. Aby dowiedzieć się więcej, zobacz Weryfikacje wstępne uaktualnienia środowiska uruchomieniowego klastra.
Zachowanie aktualizacji oparte na typie progu CountSuccess
Poniższy przykład dotyczy klienta używającego strategii "rack-by-rack" z typem progu wynoszącym 10 węzłów na każdy stojak oraz 1-minutową przerwą.
az networkcloud cluster update --name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--update-strategy strategy-type="Rack" threshold-type="CountSuccess" \
threshold-value=10 wait-time-minutes=1 \
--subscription "<SUBSCRIPTION>"
Sprawdź aktualizację:
az networkcloud cluster show --name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--subscription "<SUBSCRIPTION>" | grep -A5 updateStrategy

  "updateStrategy": {
    "maxUnavailable": 32767,
      "strategyType": "Rack",
      "thresholdType": "CountSuccess",
      "thresholdValue": 10,
      "waitTimeMinutes": 1
W tym przykładzie, jeśli co najmniej 10 węzłów zostało pomyślnie uaktualnionych, uaktualnienie przechodzi do następnego regału, jednocześnie kontynuując aprowizację pozostałych maszyn w bieżącym regale. Jeśli uaktualnienie co najmniej 10 maszyn w stojaku nie powiedzie się, uaktualnienie klastra zostanie wstrzymane. W takim przypadku wymagany sprzęt należy naprawić przed uruchomieniem akcji kontynuuj-aktualizację-wersji, aby wznowić i zakończyć aktualizację.
Aby rozwiązać problemy z maszynami bez systemu operacyjnego, zobacz Rozwiązywanie problemów z serwerem Azure Operator Nexus
Uwaga / Notatka
Nie można zmienić update-strategy po uruchomieniu uaktualnienia środowiska uruchomieniowego klastra.
Walidacje, które mogą blokować uaktualnianie środowiska uruchomieniowego klastra
Po zainicjowaniu uaktualnienia środowiska wykonawczego klastra proces uruchamia serię kontroli przed uaktualnieniem, zanim rozpocznie się uaktualnianie środowiska wykonawczego na fizycznych maszynach klastra. Te walidacje potwierdzają, że uaktualnienie środowiska uruchomieniowego może zakończyć się pomyślnie, biorąc pod uwagę bieżący stan klastra. Aby uzyskać więcej informacji, zobacz Kontrole wstępne aktualizacji środowiska uruchomieniowego klastra.
Uaktualnianie środowiska uruchomieniowego klastra przy użyciu interfejsu wiersza polecenia
Aby uaktualnić wersję środowiska uruchomieniowego klastra, użyj następującego polecenia Azure CLI:
az networkcloud cluster update-version\
--cluster-name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--subscription "<SUBSCRIPTION>" \
--target-cluster-version "<versionNumber>" \
--safeguard-mode "<SAFEGUARD_MODE>"
Wymagane parametry:
-
--target-cluster-version: wersja, która ma być stosowana do klastra podczas aktualizacji.
Parametry opcjonalne:
-
--safeguard-mode: określa sposób stosowania zabezpieczeń podczas operacji aktualizacji wersji. UżyjAllpolecenia , aby uruchomić wszystkie testy sprawdzania poprawności przedoperacyjnej. Użyj poleceniaNone, aby pominąć zabezpieczenia blokujące uaktualnienie podczas wykrywania problemów. Wartość domyślna toAll.
Ważne
Domyślny tryb All ochrony blokuje uaktualnianie systemu operacyjnego i rozszerzeń przed rozpoczęciem, jeśli walidacje określają, że nie można ukończyć uaktualnienia bez rozwiązywania wykrytych problemów. Aby dowiedzieć się więcej, zobacz Weryfikacje wstępne uaktualnienia środowiska uruchomieniowego klastra.
To polecenie inicjuje proces uaktualniania środowiska uruchomieniowego dla określonego klastra. Samo polecenie zwykle kończy się w ciągu około pięciu minut, ale uruchamia proces uaktualniania tylko po pomyślnym zakończeniu walidacji. Rzeczywista aktualizacja środowiska uruchomieniowego jest nadal wykonywana w tle i może potrwać kilka godzin, ponieważ aktualizuje węzły stojak po stojaku i instaluje nową wersję systemu operacyjnego.
Szczegółowe informacje o stanie i diagnostyce dla kroku inicjowania są dostępne w portalu Azure w JSON View zasobu Klaster (Operator Nexus). Poniższe informacje znajdują się we wpisie updateVersion pola, gdy używana jest wersja API properties.actionStates lub nowsza.
- Godzina rozpoczęcia i zakończenia akcji.
- Bieżący stan (
Succeeded,Failed, lubInProgress). - Dowolny dodatkowy kontekst lub komunikat o błędzie skojarzony z bieżącym stanem.
- Identyfikator korelacji dla oryginalnej operacji
cluster update-version, jak pokazano również w dzienniku aktywności Azure. - Uporządkowana lista poszczególnych kroków i ich stan — na przykład
Validate Cluster conditions and upgrade versions, iInitiate Platform Runtime Extension update.
Ważne
Wpis properties.actionStates dla elementu updateVersion odzwierciedla tylko krótką fazę inicjowania (inicjowanie weryfikacji i żądania, które zwykle kończy się w ciągu około 5 minut).
Nie śledzi postępu uaktualniania głównego stojaka po stojaku.
Aby monitorować pełne uaktualnienie, użyj szczegółowego stanu i szczegółowego komunikatu o stanie klastra w sekcji Przegląd zasobu lub wykonaj zapytanie za pośrednictwem polecenia az networkcloud cluster show.
Przykładowy JSON View wynik dla zasobu klastra (Operator Nexus):
{
  "properties": {
    "actionStates": [
      {
        "correlationId": "aaaa0000-bb11-2222-33cc-444444dddddd",
        "status": "Completed",
        "actionType": "Microsoft.NetworkCloud/clusters/updateVersion",
        "endTime": "2025-08-01T03:46:13Z",
        "message": "Cluster upgrade to 4.6.0 successfully initiated - monitor progress via cluster detailed status",
        "startTime": "2025-08-01T03:42:08Z",
        "stepStates": [
          {
            "status": "Completed",
            "endTime": "2025-08-01T03:42:08Z",
            "message": "Cluster validation and version checks passed",
            "startTime": "2025-08-01T03:42:08Z",
            "stepName": "Validate Cluster conditions and upgrade versions"
          },
          {
            "status": "Completed",
            "endTime": "2025-08-01T03:46:11Z",
            "message": "Platform Runtime Extension deployment initiated",
            "startTime": "2025-08-01T03:42:39Z",
            "stepName": "Initiate Platform Runtime Extension update"
          },
          {
            "status": "Completed",
            "endTime": "2025-08-01T03:46:11Z",
            "message": "Platform Runtime Extension installation completed",
            "startTime": "2025-08-01T03:46:11Z",
            "stepName": "Monitor Platform Runtime Extension readiness"
          },
          {
            "status": "Completed",
            "endTime": "2025-08-01T03:46:13Z",
            "message": "Platform Cluster version updated successfully",
            "startTime": "2025-08-01T03:46:13Z",
            "stepName": "Update Platform Cluster version specification"
          }
        ]
      }
    ]
  }
}
Po zakończeniu tego polecenia rozpocznie się pełny proces uaktualniania środowiska uruchomieniowego. Ten proces może potrwać kilka godzin, w zależności od liczby stojaków w klastrze i liczby węzłów roboczych w każdym stojaku.
- Proces aktualizacji najpierw aktualizuje węzły płaszczyzny sterowania, następnie węzły zarządzania, a potem — w przypadku węzłów roboczych — sekwencyjnie, szafa po szafie.
- Serwery zarządzania są podzielone na dwie grupy, które są uaktualniane oddzielnie. Takie podejście umożliwia korzystanie ze składników działających na serwerach zarządzania w celu zapewnienia odporności podczas uaktualniania środowiska uruchomieniowego przez zastosowanie reguł koligacji.
- Sieci usług w chmurze (CSN) używają również tej funkcji, umieszczając jedno wystąpienie w każdej grupie zarządzania.
- Nie ma interakcji klienta z tą funkcją. Jednak w węzłach zarządzania mogą być widoczne inne etykiety identyfikujące grupy.
Uaktualnienie jest uznawane za zakończone po osiągnięciu progów skonfigurowanych przez klaster updateStrategy dla stojaków węzłów roboczych, a co najmniej 50% węzłów zarządzania w każdej grupie zostanie pomyślnie uaktualnionych.
Obciążenia mogą zostać objęte wpływem podczas uaktualniania węzłów roboczych w jednej szafie, ale obciążenia we wszystkich pozostałych szafach nie są objęte wpływem. Zachęcamy do rozważenia umieszczania obciążeń w świetle tego projektu implementacji.
Monitoruj postęp przy użyciu szczegółowego stanu klastra dostępnego za pośrednictwem portalu Azure lub Azure CLI.
Aby wyświetlić stan uaktualnienia za pośrednictwem Azure CLI, użyj az networkcloud cluster show.
az networkcloud cluster show --cluster-name "<CLUSTER>" \
--resource-group "<CLUSTER_RG>" \
--subscription "<SUBSCRIPTION>"
Dane wyjściowe zawierają informacje o docelowym klastrze wraz ze szczegółowym stanem i szczegółowym komunikatem o stanie. Aby uzyskać bardziej szczegółowe informacje na temat postępu uaktualniania, poszczególne węzły w każdym stojaku można sprawdzić pod kątem stanu. Przykład znajduje się w sekcji referencyjnej w obszarze Role maszyny BareMetal.
Aby wyświetlić stan uaktualnienia za pośrednictwem portalu Azure, przejdź do docelowego zasobu klastra. Na ekranie Przegląd klastra można wyświetlić szczegółowy stan wraz ze szczegółowym komunikatem o stanie.
Aktualizacja klastra jest w toku, gdy detailedStatus jest ustawione na Updating, a detailedStatusMessage pokazuje postęp aktualizacji. Oto kilka przykładów postępu aktualizacji pokazanych w detailedStatusMessage: Waiting for control plane upgrade to complete... i Waiting for nodepool "<rack-id>" to finish upgrading....
Aktualizacja klastra jest zakończona, gdy detailedStatus jest ustawione na Running, a detailedStatusMessage wyświetla Cluster is up and running.

Aktualizacja klastra jest wstrzymana, gdy detailedStatus jest ustawione na Updating, a detailedStatusMessage wskazuje przyczynę lub komponent, który spowodował wstrzymanie aktualizacji.
Wstrzymane uaktualnianie środowiska uruchomieniowego klastra
Uaktualnienie jest wstrzymywane, gdy wystąpi dowolny z następujących:
- Nie można pomyślnie uaktualnić wszystkich maszyn płaszczyzny sterowania, a maszyny te nie są aprowizowane ani gotowe.
- Ponad 50% maszyn w grupie warstwy zarządzania nie można zaktualizować i nie są one aprowizowane ani gotowe. Serwery płaszczyzny zarządzania są podzielone na dwie grupy umieszczone na regałach o nieparzystych i parzystych numerach.
- Maszyn obliczeniowych ani maszyn węzłów roboczych skonfigurowanych zgodnie z progiem nie można zaktualizować, a także nie są one prowizowane ani gotowe do użycia.
Uwaga / Notatka
Jeśli istnieje zapasowa płaszczyzna sterowania, to normalne, że zapasowa płaszczyzna sterowania znajduje się w stanie zasilania off, stanie gotowości No, stanie Obniżony No, szczegółowym stanie Available. Uaktualnienie klastra jest wstrzymywane tylko wtedy, gdy proces uaktualniania określa, że powyższe warunki nie mogą być spełnione. Samo to, że rezerwowa płaszczyzna sterowania jest w stanie Dostępny (nie Gotowy), nie powoduje wstrzymania aktualizacji.
Przejrzyj szczegółowy komunikat o stanie klastra, aby ustalić, który składnik spowodował przejście aktualizacji w stan wstrzymania. W poniższych przykładach przedstawiono szczegółowe komunikaty o stanie dla każdego składnika.
Szczegółowy komunikat o stanie awarii płaszczyzny sterowania (KCP)
- Klaster został wdrożony, ale aktualizacja została wstrzymana. Uaktualnienie płaszczyzny sterowania nie powiodło się, ponieważ capiCluster <clusterName> jest w nieprawidłowym stanie. Narzędzie MachineHealthCheck może zastępować niesprawne maszyny KCP maszynami płaszczyzny zarządzania w celu przywrócenia kworum. Poczekaj na zakończenie korygowania, a następnie uruchom akcję continue-update-version, aby ukończyć uaktualnienie.
Szczegółowy komunikat o stanie awarii grupy obliczeniowej lub grupy zarządzania
- Klaster jest wdrożony, ale aktualizacja została wstrzymana. Maszyny w szafie "<rack-id>" są w nieprawidłowym stanie. Napraw maszyny i wykonaj akcję continue-update-version dla klastra, aby zakończyć aktualizację.
Uwaga / Notatka
Jeśli nie uda się udostępnić maszyny płaszczyzny sterowania, a aktualizacja zostanie wstrzymana, maszyny mogą być automatycznie naprawiane w tle.
actionStates Sprawdź maszyny bez systemu operacyjnego objętej płaszczyzną sterowania, aby sprawdzić, czy autoremediation rozwiązał ten problem i przyniósł maszyny do stanu aprowizowanego.
Po zidentyfikowaniu składnika objętego problemem (płaszczyzny sterowania, zarządzania lub obliczeń) wykonaj następujące czynności:
Krok 1. Sprawdź stan poszczególnych maszyn typu bare metal dla komponentu, którego dotyczy problem.
Przykład znajduje się w sekcji referencyjnej w obszarze Role maszyny BareMetal.
Po zidentyfikowaniu maszyn fizycznych dla komponentu, którego dotyczy problem, sprawdź stan każdej z nich i wykonaj następujące działania w zależności od ich stanu.
| Szczegółowy stan maszyny bare metal | Node Ready | Szczegóły i ograniczanie ryzyka |
|---|---|---|
Deprovisioning |
No |
Przejrzyj dzienniki TSR. Następnie wykonaj następne kroki, aby sprawdzić dzienniki akcji dla programu BMM |
Available |
No |
Jeśli BMM jest zapasową maszyną płaszczyzny kontrolnej, Available jest oczekiwanym stanem. W przeciwnym razie sprawdź dzienniki stanu akcji. |
Provisioning |
No |
Przejrzyj dzienniki TSR. Następnie wykonaj następne kroki, aby sprawdzić dzienniki akcji dla programu BMM |
Provisioned |
No |
Sprawdź dzienniki cloud-init w usłudze Shoebox. |
Provisioned |
Yes |
Jest to oczekiwany stan dobrej kondycji. Przejdź do wznawiania aktualizacji za pomocą akcji cluster continue-update-version |
Krok 2. Sprawdzanie dzienników stanu akcji dla programu BMM.
Aby sprawdzić dzienniki stanu działań dla BMM, przejdź do zasobu BMM >Operacje>Dziennik akcji.
| Szczegóły dziennika akcji | Mitigation |
|---|---|
| Nie istnieje dziennik akcji | Usuń problemy, korzystając z przewodnika rozwiązywania problemów z maszyną fizyczną. |
machineHealthCheckRemediation działanie w toku |
Poczekaj na zakończenie korygowania. Jeśli się to nie powiedzie, rozwiąż problemy, korzystając z przewodnika rozwiązywania problemów z maszyną bare metal. |
machineHealthCheckRemediation ukończono akcję |
Jeśli węzeł nie jest gotowy, sprawdź dzienniki cloud-init w usłudze Shoebox. |
Po rozwiązaniu problemu, gdy maszyna Bare Metal zostanie wdrożona i będzie gotowa, uruchom akcję klastra continue-update-version, aby wznowić i ukończyć aktualizację.
az networkcloud cluster continue-update-version \
-g <CLUSTER_RG> \
-n <CLUSTER_NAME> \
--subscription <CUSTOMER_SUB_ID> \
--safeguard-mode <SAFEGUARD_MODE>
Parametry opcjonalne:
-
--safeguard-mode: określa, jak zabezpieczenia są stosowane podczas operacji continue-update-version. UżyjAllpolecenia , aby uruchomić wszystkie testy sprawdzania poprawności przedoperacyjnej. Użyj poleceniaNone, aby pominąć zabezpieczenia blokujące uaktualnienie podczas wykrywania problemów. Wartość domyślna toAll.
Ważne
Domyślny tryb All ochrony blokuje wznowienie uaktualniania, jeśli walidacje określają, że nie można ukończyć uaktualnienia bez rozwiązywania wykrytych problemów. Aby dowiedzieć się więcej, zobacz Weryfikacje wstępne uaktualnienia środowiska uruchomieniowego klastra.
Ważne
Uruchomienie continue-update-version przed osiągnięciem progu węzła roboczego (zgodnie z konfiguracją klastra updateStrategy) powoduje przejście aktualizacji do stanu wstrzymania. Zawsze najpierw napraw maszyny, których dotyczy problem, a następnie uruchom continue-update-version akcję.
Często zadawane pytania
Rozpoznawanie utknięcia/zatrzymania uaktualnienia klastra
Podczas uaktualniania środowiska uruchomieniowego klaster przechodzi w stan wstrzymania, gdy proces uaktualniania ustali, że uaktualnienie nie może kontynuować bez ręcznej interwencji. Jednak proces aktualizacji może czasami utknąć, podczas gdy szczegółowy status nadal wskazuje, że aktualizacja trwa. Ponieważ ukończenie uaktualnienia środowiska uruchomieniowego może zająć bardzo dużo czasu, obecnie nie określono ustawionej długości limitu czasu. Okresowo sprawdzaj szczegółowy stan klastra i dzienniki, aby ustalić, czy aktualizacja bez końca próbuje się wykonać.
Możesz zidentyfikować aktualizację, która utknęła na nieokreślony czas, sprawdzając dzienniki klastra, szczegółowy komunikat i szczegółowy komunikat o stanie. Jeśli dojdzie do takiej sytuacji, obserwujesz, że klaster nieustannie doprowadza do tego samego stanu, nie robiąc przy tym żadnych postępów. Sprawdź dzienniki klastra lub skonfigurowany obszar roboczy usługi Log Analytics (LAW), aby ustalić, czy wystąpił błąd lub czy brak postępu jest spowodowany przez określony krok.
Identyfikacja zatrzymanej/zablokowanej aktualizacji układu bare metal
Przewodnik po identyfikowaniu problemów z aprowizowaniem węzłów procesu roboczego znajduje się w części Rozwiązywanie problemów z aprowizowaniem maszyn bez systemu operacyjnego.
Awaria sprzętowa nie wymaga ponownego wykonania uaktualnienia
Jeśli wystąpi awaria sprzętowa podczas uaktualniania, uaktualnienie środowiska uruchomieniowego będzie kontynuowane tak długo, jak są spełnione określone progi dla węzłów obliczeniowych i zarządzania/sterowania. Po naprawieniu lub zastąpieniu maszyny zostanie ona aprowizowana przy użyciu systemu operacyjnego bieżącego środowiska uruchomieniowego platformy, który zawiera docelową wersję środowiska uruchomieniowego. Jeśli szafa została zaktualizowana przed awarią, zaktualizowana wersja środowiska wykonawczego zostanie użyta przy ponownej aprowizacji węzłów. Jeśli specyfikacja stojaka nie została zaktualizowana do uaktualnionej wersji środowiska uruchomieniowego przed awarią sprzętu, maszyna aprowizuje poprzednią wersję środowiska uruchomieniowego po naprawie sprzętu. Maszyna jest uaktualniana wraz z stojakiem, gdy stojak rozpocznie uaktualnianie.
Po uaktualnieniu środowiska uruchomieniowego klaster wyświetla stan "Niepowodzenie" w trakcie wdrażania.
Podczas uaktualniania środowiska uruchomieniowego klaster wprowadza stan Upgrading. Jeśli uaktualnienie środowiska uruchomieniowego zakończy się niepowodzeniem, klaster przejdzie w stan przygotowania. Składniki infrastruktury (na przykład urządzenie magazynu) mogą powodować błędy podczas uaktualniania. W niektórych scenariuszach może być konieczne zdiagnozowanie błędu z obsługą Microsoft.
Maszyna Bare Metal pokazuje zdegradowany stan po aktualizacji środowiska wykonawczego
Niektóre sytuacje mogą spowodować powrót węzła do stanu Degraded. Ten stan występuje, jeśli zostaną spełnione jakiekolwiek warunki znalezione w artykule Rozwiązywanie problemów z błędami stanu obniżonej wydajności . Stan obniżonej wydajności oznacza, że węzeł jest automatycznie kordonowany, aby zapobiec zaplanowaniu nowych obciążeń w węźle do momentu rozwiązania podstawowego problemu.