Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Microsoft Fabric to rozwiązanie analityczne typu "wszystko w jednym" dla przedsiębiorstw, które obejmuje wszystko, od przenoszenia danych do nauki o danych, analizy w czasie rzeczywistym i analizy biznesowej. Oferuje kompleksowy pakiet usług, w tym usług typu data lake, inżynierii danych i integracji danych, w jednym miejscu. Więcej informacji znajdziesz w artykule Co to jest Fabric?
Ten samouczek przeprowadzi Cię przez całościowy scenariusz od pozyskiwania danych do ich wykorzystania. Pomaga to w tworzeniu podstawowego zrozumienia Fabric, w tym różnych doświadczeń i ich integracji, jak również doświadczeń profesjonalnych i obywatelskich twórców aplikacji, które towarzyszą pracy na tej platformie. Ten samouczek nie ma na celu służyć jako architektura referencyjna, wyczerpująca lista funkcji i możliwości, ani rekomendacja konkretnych najlepszych praktyk.
Kompleksowy scenariusz Lakehouse
Tradycyjnie organizacje budowały nowoczesne magazyny danych na potrzeby transakcyjnej i ustrukturyzowanej analizy danych. Usługa Data Lakehouses na potrzeby analizy danych big data (częściowo/bez struktury). Te dwa systemy działały równolegle, tworząc silosy, duplikowanie danych i zwiększając całkowity koszt posiadania.
Platforma Fabric dzięki integracji magazynu danych i ujednoliceniu formatu Delta Lake pozwala wyeliminować silosy, usunąć duplikowanie danych i znacząco zmniejszyć całkowity koszt posiadania.
Dzięki elastyczności oferowanej przez usługę Fabric można zaimplementować architekturę typu lakehouse lub magazynu danych albo połączyć je razem, aby uzyskać to, co najlepsze z obu rozwiązań w prosty sposób. W tym samouczku przyjrzysz się przykładowi organizacji handlu detalicznego i utworzysz jej lakehouse od początku do końca. Używa architektury medalonu, w której warstwa z brązu ma nieprzetworzone dane, warstwa srebra ma zweryfikowane i deduplikowane dane, a warstwa złota ma wysoce wyrafinowane dane. Możesz zastosować takie samo podejście, aby wdrożyć rozwiązanie lakehouse dla każdej organizacji z każdej branży.
W tym samouczku wyjaśniono, jak deweloper w fikcyjnej firmie Wide World Importers z domeny detalicznej wykonuje następujące kroki:
Zaloguj się na swoje konto Power BI i zapisz się na darmowy okres próbny Fabric. Jeśli nie masz licencji usługi Power BI, zarejestruj się, aby uzyskać bezpłatną licencję usługi Fabric, a następnie możesz rozpocząć wersję próbną Fabric.
Tworzenie i implementowanie kompleksowej bazy danych typu lakehouse dla organizacji:
- Utwórz obszar roboczy Fabric.
- Utwórz jezioro.
- Pozyskiwanie danych, przekształcanie danych i ładowanie ich do lakehouse. Możesz również eksplorować OneLake, korzystając z jednej kopii danych dostępnej w trybie lakehouse oraz w trybie punktu końcowego analizy SQL.
- Połącz się ze swoim domem nad jeziorem za pomocą endpointu analityki SQL i stwórz model semantyczny oraz raport analizujący dane sprzedażowe w różnych wymiarach.
- Opcjonalnie można organizować i planować przepływ pozyskiwania i przekształcania danych za pomocą potoku. Potoki obejmują działania związane z usługą Lakehouse, takie jak działanie Konserwacja usługi Lakehouse (umożliwiające automatyzację konserwacji tabel Delta za pomocą poleceń OPTIMIZE i VACUUM) oraz działanie odświeżania punktu końcowego analizy SQL (aby zachować synchronizację punktu końcowego analizy SQL po załadowaniu danych). Konstruktor wyrażeń potoku obejmuje również pomoc Copilot, co umożliwia szybsze i dokładniejsze tworzenie wyrażeń. Aby uzyskać szczegółowe informacje, zapoznaj się z Działaniem konserwacji Lakehouse.
Wyczyść zasoby , usuwając obszar roboczy i inne elementy.
Architektura
Na poniższej ilustracji przedstawiono kompleksową architekturę typu lakehouse. Składniki, które są zaangażowane, zostały opisane na poniższej liście.

Źródła danych: sieć szkieletowa umożliwia szybkie i łatwe łączenie się z usługami Azure Data Services, a także z innymi platformami opartymi na chmurze i lokalnymi źródłami danych w celu usprawnienia pozyskiwania danych.
Pozyskiwanie: możesz szybko tworzyć szczegółowe informacje dla organizacji przy użyciu ponad 200 łączników natywnych. Te łączniki są zintegrowane z potokiem Fabric i pozwalają na łatwą transformację danych metodą przeciągania i upuszczania w przepływach danych. Ponadto za pomocą funkcji Skrót w sieci szkieletowej można nawiązać połączenie z istniejącymi danymi bez konieczności kopiowania ani przenoszenia. Skróty OneLake mogą również odwoływać się do produktów danych u różnych dzierżawców za pośrednictwem zewnętrznego udostępniania danych usługi OneLake, zapewniając dostęp do zarządzanych danych operacyjnych na żywo bez konieczności ich kopiowania lub tworzenia potoków ETL. Platforma Fabric obejmuje również wydajne, wektoryzowane czytniki plików dla typowych formatów, takich jak CSV, a wsparcie dla JSON w przygotowaniu, w celu redukcji opóźnień przy pozyskiwaniu.
Przekształcanie i przechowywanie: Fabric standaryzuje format Delta Lake. Oznacza to, że wszystkie silniki Fabric mogą uzyskiwać dostęp do tego samego zestawu danych przechowywanego w usłudze OneLake i manipulować nim bez duplikowania danych. Ujednolicony model zarządzania w usłudze OneLake zapewnia, że dane dostępne za pomocą skrótów podlegają tym samym zasadom zabezpieczeń i zgodności co lokalnie przechowywane dane, zapewniając spójną wersję prawdy w całej organizacji. Ten system magazynowania zapewnia elastyczność tworzenia magazynów typu lakehouse przy użyciu architektury medalionu lub siatki danych, w zależności od wymagań organizacji. Możesz wybrać środowisko przekształcania danych z małą ilością kodu lub bez kodu, korzystając z potoków/przepływów danych lub notesu/platformy Spark w celu uzyskania środowiska opartego na kodzie. Tabele usługi Lakehouse obsługują również optymalizacje wydajności, takie jak uporządkowanie Z i klastrowanie Liquid, aby zwiększyć wydajność zapytań i zarządzać układem danych na dużą skalę. Ponadto zmaterializowane widoki jeziorne są dostępne do wstępnego wyliczenia i buforowania wyników za pośrednictwem danych w lakehouse, co przyspiesza powtarzające się analizy. Operacjonalizacja może obejmować automatyczną konserwację tabel Delta Lakehouse za pośrednictwem działania konserwacji Lakehouse w potokach i wyzwalanie odświeżania punktu końcowego SQL Analytics w ramach kroków po załadowaniu — zobacz opcjonalny krok orkiestracji potoku w powyższym scenariuszu, aby uzyskać szczegóły.
Korzystanie: usługa Power BI może korzystać z danych z usługi Lakehouse na potrzeby raportowania i wizualizacji. Każda usługa Lakehouse ma wbudowany punkt końcowy TDS, punkt końcowy analizy SQL, umożliwiający łatwą łączność i wykonywanie zapytań dotyczących danych w tabelach usługi Lakehouse z innych narzędzi raportowania. Orkiestracja potoku może zawierać krok odświeżania punktu końcowego analityki SQL w usłudze Lakehouse, aby upewnić się, że schemat i metadane są aktualne dla narzędzi raportowania po załadowaniu danych — zobacz opcjonalny krok orkiestracji potoku w przedstawionym powyżej scenariuszu, aby uzyskać szczegółowe informacje.
Dzięki współużytkowaniu danych między dzierżawami, raporty, modele semantyczne oraz obciążenia sztucznej inteligencji i nauki o danych mogą również korzystać z udostępnionych danych OneLake przez granice organizacyjne, umożliwiając współpracę bez duplikowania danych.
Przykładowy zestaw danych
W tym samouczku użyto przykładowej bazy danych Wide World Importers (WWI), którą zaimportujesz do lakehouse w następnym samouczku. W przypadku kompleksowego scenariusza usługi Lakehouse zestaw danych zawiera wystarczające dane, aby zapoznać się z możliwościami skalowania i wydajności platformy Fabric.
Wide World Importers (WWI) to hurtowy importer towarów nowości i dystrybutor działający z obszaru Zatoki San Francisco. Jako hurtownik, WWI ma klientów, którzy głównie obejmują firmy odsprzedające osobom fizycznym. WWI sprzedaje klientom detalicznym w całych Stanach Zjednoczonych, w tym sklepy specjalistyczne, supermarkety, sklepy komputerowe, sklepy przy atrakcjach turystycznych i niektóre osoby. WWI sprzedaje również innym hurtowniom za pośrednictwem sieci agentów, którzy promują produkty w imieniu WWI. Aby dowiedzieć się więcej na temat profilu i operacji firmy, zobacz Przykładowe bazy danych Wide World Importers dla usługi Microsoft SQL.
Ogólnie rzecz biorąc, dane są przesyłane z systemów transakcyjnych lub aplikacji biznesowych do lakehouse. Jednak dla uproszczenia w tym samouczku użyjesz modelu wymiarowego dostarczonego przez WWI jako początkowego źródła danych. Pozyskujesz dane w lakehouse i przekształcasz je na różnych etapach (Brązowe, Srebrne i Złote) architektury medalonu.
Model danych
Chociaż model wymiarowy WWI zawiera wiele tabel faktów, w tym samouczku użyto tabeli faktów Sprzedaż i skorelowanych wymiarów. Poniższy przykład ilustruje model danych WWI:

Przepływ danych i transformacji
Jak opisano wcześniej, w tym samouczku użyto przykładowych danych z przykładowych danych wide world importers (WWI) w celu utworzenia kompleksowej bazy danych typu lakehouse. W tej implementacji przykładowe dane są przechowywane na koncie usługi Azure Data Storage w formacie pliku Parquet dla wszystkich tabel. Jednak w rzeczywistych scenariuszach dane zazwyczaj pochodzą z różnych źródeł i w różnych formatach.
Na poniższej ilustracji przedstawiono przekształcenie źródła, miejsca docelowego i danych:

Źródło danych: dane źródłowe są w formacie pliku Parquet i w strukturze niepartycyjnej. Jest on przechowywany w folderze dla każdej tabeli. W tym samouczku skonfigurujesz przepływ danych, aby zaimportować pełne historyczne lub jednorazowe dane do lakehouse.
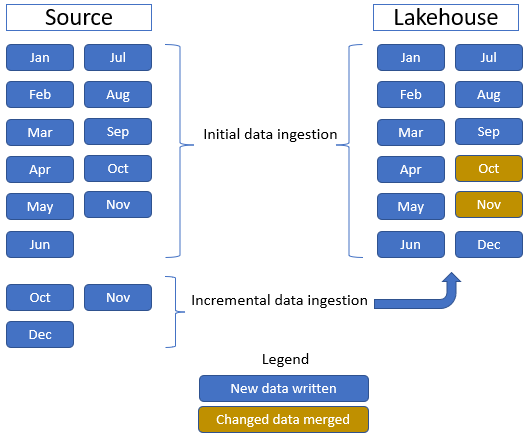
W tym samouczku użyjesz tabeli faktów Sprzedaż , która zawiera jeden folder nadrzędny z danymi historycznymi przez 11 miesięcy (z jednym podfolderem dla każdego miesiąca) i innym folderem zawierającym dane przyrostowe przez trzy miesiące (jeden podfolder dla każdego miesiąca). Podczas początkowego pozyskiwania danych 11 miesięcy danych jest ładowane do tabeli lakehouse. Po nadejściu danych przyrostowych zaktualizowane dane z października i listopada zostaną scalone z istniejącymi danymi, a nowe dane z grudnia zostaną zapisane w tabeli lakehouse, jak pokazano na poniższej ilustracji:
Lakehouse: W tym samouczku tworzysz lakehouse, wprowadzasz dane do sekcji plików domku nad jeziorem, a następnie tworzysz tabele Delta Lake w sekcji Tabele domku nad jeziorem.
Przekształcanie: W przypadku przygotowywania i przekształcania danych w tym samouczku omówiono dwa różne podejścia: notebooki i Spark dla środowiska opartego na kodzie oraz pipeline'y i przepływy danych dla środowiska z małą ilością kodu lub bez kodu. Najnowsze środowisko uruchomieniowe Fabric zawiera natywny aparat wykonywania, który oferuje znaczną poprawę wydajności w porównaniu z open-source'ową wersją Spark dla obciążeń związanych z notatnikami i zadaniami Spark. Konstruktor wyrażeń potoku zawiera asystenta Copilot, aby ułatwić tworzenie wyrażeń i budowanie logiki potoku, co pozwala na szybsze i dokładniejsze generowanie wyrażeń.
Korzystanie: usługa Power BI może korzystać z danych z usługi Lakehouse na potrzeby raportowania i wizualizacji. Każdy magazyn typu lakehouse ma wbudowany punkt końcowy TDS nazywany punktem końcowym analizy SQL , który umożliwia łatwą łączność i wykonywanie zapytań dotyczących danych w tabelach lakehouse z innych narzędzi raportowania. Możesz również użyć usługi Direct Lake za pośrednictwem usługi OneLake, aby umożliwić usłudze Power BI wykonywanie zapytań o tabele typu lakehouse bezpośrednio bez importowania lub dedykowanego cyklu odświeżania modelu semantycznego. Ponadto możesz udostępnić dane narzędziom do raportowania firm innych niż Microsoft przy użyciu punktu końcowego TDS/SQL Analytics w celu nawiązania połączenia i uruchomienia zapytań SQL na potrzeby analizy.
W szczególności w przypadku obciążeń Spark SQL klienci zgodni z ODBC mogą łączyć się przy użyciu sterownika Microsoft ODBC dla usługi Microsoft Fabric Data Engineering (wersja zapoznawcza) z uwierzytelnianiem Microsoft Entra ID (interaktywnym, Azure CLI, tożsamością aplikacji, certyfikatem lub tokenem dostępu).
